
 مشاركة


لقد فتحت نماذج توليد الصور مفتوحة المصدر عالمًا جديدًا بالكامل للمبدعين والمطورين والشركات. يمكنك الآن تحويل النص إلى صور، وتعديل الصور، وإنتاج مقاطع الفيديو، وإنشاء كائنات ثلاثية الأبعاد، دون إنفاق ثروة على البرامج. لقد نما هذا المجال بسرعة، مع وجود أكثر من 90,000 نموذج لتحويل النص إلى صورة متاح على Hugging Face وحده. الانتقال إلى المصدر المفتوح يعني عدم وجود اشتراكات، والتحكم الكامل في بياناتك، والحرية في تعديل الأشياء بالطريقة التي تحتاجها. يغطي هذا الدليل أفضل النماذج المتاحة وكل شيء آخر تحتاجه للبدء بقوة.
ما هي نماذج توليد الصور مفتوحة المصدر؟
نماذج توليد الصور مفتوحة المصدر هي برامج كمبيوتر تقوم بإنشاء صور من الأوصاف المكتوبة. تكتب ما تريد رؤيته، لنقل غروب الشمس فوق الجبال، أو نموذجًا تجريبيًا لمنتج، أو شخصية كرتونية، ويقوم النموذج بإنتاجها كصورة.
فكر في الأمر كما لو كنت توظف فنانًا درس ملايين اللوحات والصور والرسوم التوضيحية طوال حياته. تصف ما تريد، ويرسمه لك في ثوانٍ. باستثناء أن هذا الفنان لا ينام أبدًا، ولا يتقاضى أجرًا مقابل كل مشروع، ويعيش على جهاز الكمبيوتر الخاص بك.
ما يجعلها "مفتوحة المصدر" هو أن الكود متاح للعامة. يمكن لأي شخص تنزيلها أو استخدامها أو تعديلها أو البناء عليها مجانًا. يختلف هذا عن الأدوات المدفوعة مثل Midjourney أو Adobe Firefly، حيث تدفع مقابل الوصول إلى البرنامج ولا تملك أي تحكم في كيفية عمله من الداخل.
يتم تدريب هذه النماذج على ملايين الصور، مما يعلمها فهم العلاقة بين الكلمات والمرئيات. بمرور الوقت، أصبحت جيدة بما يكفي لإنتاج نتائج بجودة احترافية، وأفضلها الآن ينافس الخيارات التجارية المكلفة.
لماذا تختار المصدر المفتوح على نماذج الصور المغلقة؟
إن نماذج الصور المدفوعة مريحة، لكنها تأتي مع قيود حقيقية. أنت تدفع مقابل كل صورة، وتسلم بياناتك لخوادم جهات خارجية، وليس لك رأي في كيفية عمل البرنامج. تحل النماذج مفتوحة المصدر كل ذلك. إليك سبب قيام المزيد من المبدعين والمطورين بالانتقال إليها.
- التحكم الكامل في المخرجات
مع الأدوات المغلقة، تقرر المنصة ما يمكنك وما لا يمكنك توليده. تعمل النماذج مفتوحة المصدر على إعداداتك الخاصة، لذا أنت من يضع القواعد. تحصل على ما تطلبه بالضبط، دون أن تقف فلاتر المحتوى أو قيود المنصة في طريقك.
- القدرة على ضبط النماذج بدقة
النماذج المغلقة مقفلة ولا يمكن تغييرها لتناسب احتياجاتك الخاصة. ومع ذلك، يمكنك تدريب النماذج مفتوحة المصدر بشكل أكبر على صورك أو أساليبك أو إرشادات علامتك التجارية الخاصة. هذا يعني أن المخرجات ستبدأ في الظهور والشعور وكأنها ملكك، وليس مثل أي شخص آخر يستخدم نفس الأداة.
- لا توجد تكلفة لكل صورة
تفرض عليك معظم الأدوات التجارية رسومًا مقابل كل صورة تقوم بتوليدها، وهو ما يتراكم بسرعة. ولكن مع النماذج مفتوحة المصدر، تقوم بتشغيل كل شيء على أجهزتك الخاصة وتوليد أي عدد تريده من الصور. التكلفة الوحيدة هي الكهرباء والأجهزة التي تقوم بالعمل.
- الخصوصية والاستخدام دون اتصال بالإنترنت
عندما تستخدم أداة قائمة على السحابة، تمر مطالباتك وصورك عبر خوادم شخص آخر. يمكن للنماذج مفتوحة المصدر العمل بالكامل دون اتصال بالإنترنت، لذلك لا يغادر أي شيء جهازك. هذا يهم كثيرًا الشركات التي تتعامل مع مشاريع حساسة أو محتوى مملوك لها.
- دعم مجتمعي كبير
تحظى النماذج مفتوحة المصدر بدعم آلاف المطورين والباحثين والمبدعين حول العالم. إنهم يشاركون النسخ المضبوطة بدقة، والبرامج التعليمية، والمكونات الإضافية، والإصلاحات بشكل يومي. إذا واجهت مشكلة، فمن المحتمل أن يكون شخص ما في المجتمع قد حلها بالفعل.
أفضل 7 نماذج لتوليد الصور مفتوحة المصدر
تركز مولدات الصور بالذكاء الاصطناعي مفتوحة المصدر المختلفة على نقاط قوة مختلفة مثل الواقعية، أو السرعة، أو التحكم في الهيكل، أو دقة النص. فيما يلي سبعة نماذج مستخدمة على نطاق واسع، ولكل منها غرض واضح.
| النموذج | البنية | الحد الأدنى لذاكرة الفيديو (VRAM) | الترخيص | نقاط القوة الرئيسية | الأفضل لـ |
| Stable Diffusion 3.5 | الانتشار الكامن (DiT) | 8 جيجابايت+ | تجاري | نظام بيئي كبير، دعم LoRA، مجتمع نشط | العمل الإبداعي العام، المبتدئين، سير العمل القائم على المكونات الإضافية |
| ControlNet 1.1 | إضافة SD مشروطة | 8 جيجابايت+ | Apache 2.0 | التحكم في الوضعية، خرائط العمق، توجيه الحواف | اتساق الشخصية، مخططات الهندسة المعمارية، التوليد الموجه |
| FLUX.2 | محول مطابقة التدفق (4B–32B) | 13 جيجابايت (4B) / 24 جيجابايت (32B) | BFL تجاري | مرجع متعدد الصور، دقة قوية في فهم المطالبات، مخرجات سريعة جدًا | مرئيات عالية الجودة، أصول العلامة التجارية، محتوى التسويق |
| GLM-Image | هجين AR + DiT (9B + 7B) | ~16 جيجابايت | بحثي / مخصص | عرض قوي للنصوص، يدعم الطباعة الصينية، التعديل + التوليد في تدفق واحد | الملصقات، النماذج التجريبية لواجهة المستخدم، التصاميم ثنائية اللغة، الإنفوجرافيك |
| Qwen-Image-2512 | نموذج الانتشار + لغة الرؤية (20B) | ~16 جيجابايت | Apache 2.0 | نصوص متعددة اللغات، تحرير RGBA متعدد الطبقات، دعم ControlNet | سير العمل التجاري، التحرير المتقدم، المحتوى متعدد اللغات |
| Waifu Diffusion | Stable Diffusion مضبوط بدقة (مجموعة بيانات الأنمي) | 6 جيجابايت+ | CreativeML OpenRAIL | أسلوب الأنمي، مرئيات المانجا، مخرجات تركز على الشخصيات | الألعاب، الروايات المرئية، الأعمال الفنية بأسلوب الأنمي |
| Z-Image-Turbo | محول الانتشار المقطر (6B) | 16 جيجابايت | Apache 2.0 | زمن انتقال منخفض للغاية، يدعم الإنجليزية + الصينية، المعالجة الدفعية | تطبيقات الوقت الفعلي، خطوط الأنابيب واسعة النطاق، النشر على الحافة |
- Stable Diffusion 3.5
إن Stable Diffusion 3.5 هو نموذج لتحويل النص إلى صورة يعتمد على محول الانتشار متعدد الوسائط (MMDiT) وتم تطويره بواسطة Stability AI. وهو يعمل على تحسين جودة الصورة، والطباعة، وفهم المطالبات، والأداء العام. يأتي النموذج بثلاثة أحجام، مصممة لإعدادات الأجهزة وحالات الاستخدام المختلفة. يظل هذا النموذج الأفضل لتوليد الصور واحدًا من أكثر نماذج توليد الصور المفتوحة استخدامًا على نطاق واسع، بدعم من مجتمع كبير من المطورين و صناع المحتوى.
الميزات الرئيسية:
- ثلاثة أحجام للنموذج: Large (8B من المعلمات)، وLarge Turbo، وMedium (~2.5B من المعلمات)، كل منها مناسب لاحتياجات الأداء والأجهزة المختلفة
- مخرجات عالية الدقة: يدعم نموذج Large توليد صور عالية الجودة بدقة تقارب 1 ميجابكسل
- نسخة التوليد السريع: ينتج Large Turbo نتائج عالية الجودة في عدد قليل من الخطوات
- دعم الضبط الدقيق: مصمم للتخصيص مع اتساق محسّن للمطالبات
- ترخيص استخدام مرن: مجاني للأفراد والشركات الصغيرة، مع ترخيص للمؤسسات الكبرى
- ControlNet 1.1
إن ControlNet عبارة عن بنية شبكة عصبية تتحكم في نماذج الانتشار عن طريق إضافة شروط إضافية. وهي تنسخ أوزان كتل الشبكة العصبية إلى نسخة مغلقة ونسخة قابلة للتدريب. تتعلم النسخة القابلة للتدريب شرطك، بينما تحافظ النسخة المغلقة على النموذج الأصلي. تم إصداره بواسطة الباحث lllyasviel، وهو لا يولد صورًا بمفرده. بدلاً من ذلك، فإن أفضل نموذج صور يعمل فوق Stable Diffusion ويمنحك تحكمًا هيكليًا دقيقًا في ما يتم توليده.
الميزات الرئيسية:
- أنواع شروط متعددة: يدعم ControlNet التحكم عبر كشف الحواف بطريقة canny، وتقدير العمق بطريقة Midas، وكشف الحواف الناعمة بطريقة HED، وكشف الخطوط بطريقة M-LSD، والخرائط الطبيعية (normal maps)، وكشف وضعية الجسم البشري بطريقة OpenPose، والتجزئة الدلالية (semantic segmentation).
- عناصر تحكم قابلة للتركيب: يدعم ControlNet دمج عدة نماذج ControlNet في وقت واحد. تم اختبار جميع النماذج الجاهزة للإنتاج بشكل مكثف مع دمج عدة نماذج ControlNet، ويتوفر دعم رسمي لـ Multi-ControlNet من خلال المكون الإضافي A1111.
- متانة محسنة في الإصدار 1.1: يضيف ControlNet 1.1 معالجة جديدة للحواف الناعمة، والعديد من المعالجات المسبقة الجديدة مثل Canny وDepth وInpaint، ويعزز المتانة العامة للنموذج وجودة الصورة مقارنة بالإصدار 1.0.
- التعديل القائم على التعليمات: يتضمن ControlNet 1.1 نموذجًا تم تدريبه على مجموعة بيانات Instruct Pix2Pix، وتم تدريبه باستخدام كل من مطالبات التعليمات ومطالبات الوصف.
- سلسلة FLUX
تم تطوير سلسلة FLUX بواسطة Black Forest Labs وتركز على توليد صور عالية الجودة مع محاذاة قوية للمطالبات. وهي تتضمن نماذج متعددة مصممة لكل من سير عمل التجريب والإنتاج.
الميزات الرئيسية:
- متغيرات متعددة: تتضمن FLUX.1 [schnell] و[dev] وأدوات متخصصة للتعديل والتكييف.
- تعديل الصور في السياق: يسمح بإجراء تغييرات على الصور باستخدام تعليمات نصية دون الحاجة لإعادة التدريب.
- أدوات تعديل مخصصة: تتضمن دعمًا لـ ترميم الصور (image inpainting)، والتوسيع الخارجي (outpainting)، والتوجيه الهيكلي.
- توفر الأوزان المفتوحة: يتيح النشر المحلي والتخصيص.
- خيارات نشر مرنة: يدعم واجهات برمجة التطبيقات (APIs)، والإعدادات المحلية، وبيئات الاختبار.
- GLM-Image
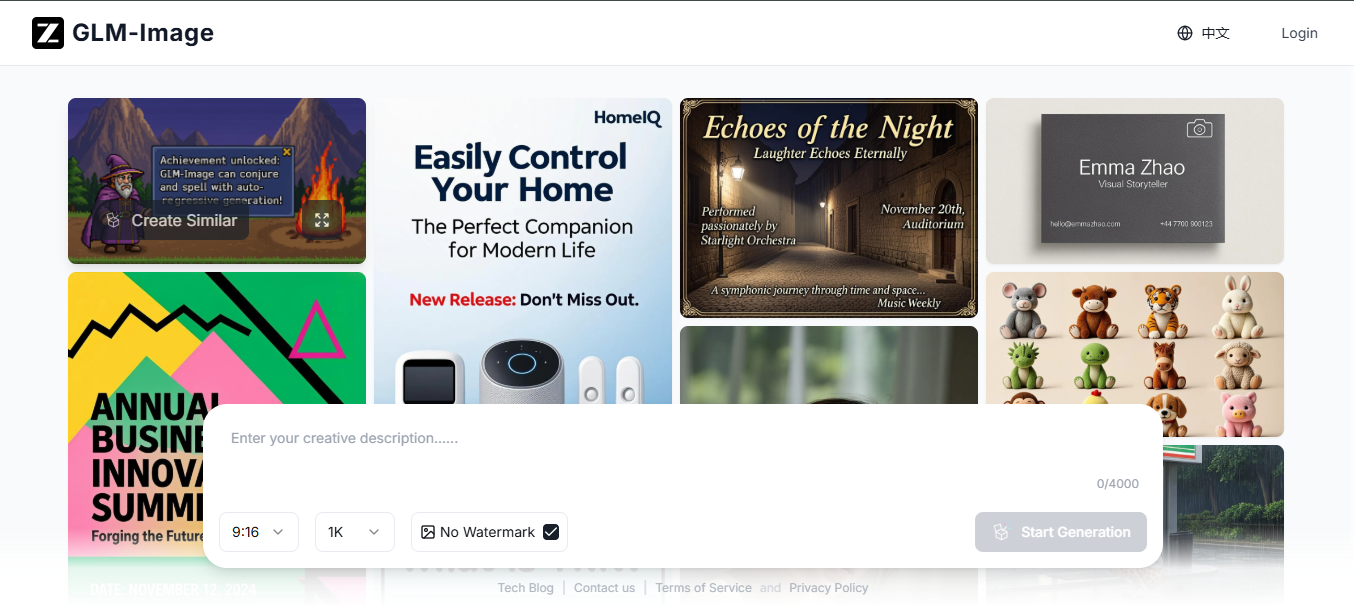
GLM-Image هو نموذج لتوليد الصور يعتمد على بنية فك ترميز هجينة ذاتية الارتباط والانتشار. ويظهر مزايا في عرض النصوص وسيناريوهات التوليد كثيفة المعرفة، مع قدرات قوية في توليد تفاصيل عالية الدقة والدقة المتناهية. تم تطويره بواسطة Zhipu AI، وهو مصمم لحالات الاستخدام التي تميل النماذج الأخرى إلى التقصير فيها، لا سيما عندما تحتاج الصور إلى تضمين نصوص مقروءة أو تخطيطات كثيفة المعلومات.
الميزات الرئيسية:
- تصميم البنية الهجينة: يجمع بين الترميز ذاتي الارتباط وفك ترميز الانتشار.
- عرض دقيق للنصوص: ينتج نصوصًا واضحة ومقروءة داخل الصور.
- دعم التخطيطات المعقدة: يعمل بشكل جيد مع الملصقات، والإنفوجرافيك، والمرئيات المنظمة.
- التوليد والتعديل الموحد: يتعامل مع كل من مهام تحويل النص إلى صورة وتحويل الصورة إلى صورة.
- تحسين ما بعد التدريب: يستخدم التعلم المعزز لتحسين التفاصيل والمحاذاة.
- Qwen-Image-2512
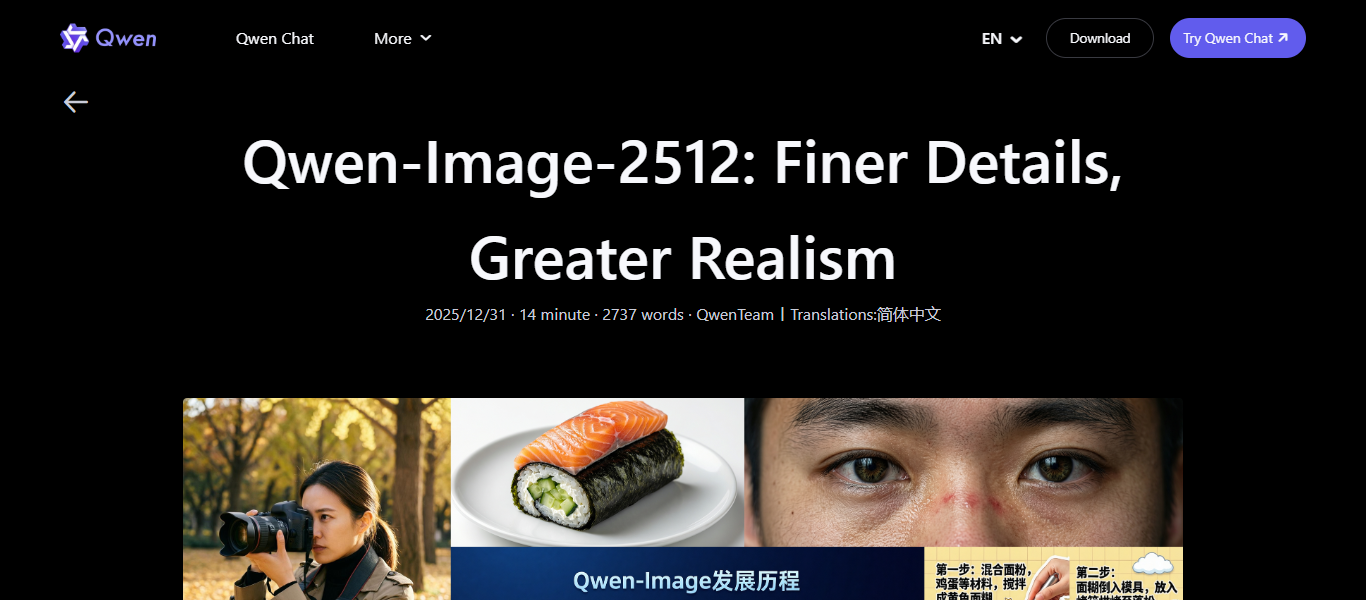
Qwen-Image-2512 هو تحديث شهر ديسمبر لنموذج تحويل النص إلى صورة من Qwen-Image أفضل نموذج مفتوح المصدر لتوليد الصور، والذي يتميز بواقعية بشرية محسنة، وتفاصيل طبيعية أدق، ودقة وجودة محسنة في عرض النصوص. وهو موجه بشكل مباشر لحالات الاستخدام المؤسسي والتجاري حيث تهم الجودة والموثوقية ووضوح الترخيص.
الميزة الرئيسية:
- واقعية بصرية محسنة: يقلل من المظهر الاصطناعي في الصور المولدة.
- دقة أفضل للنصوص: ينتج نصوصًا مدمجة وتخطيطات هيكلية أكثر وضوحًا.
- توليد مشاهد تفصيلية: يتعامل مع البيئات والأشياء بوضوح أعلى.
- ترخيص تجاري مفتوح: تم إصداره بموجب ترخيص Apache 2.0 للاستخدام والتعديل المجاني.
- وصول كامل للنموذج: متاح من خلال منصات النماذج المفتوحة للنشر.
- Waifu Diffusion
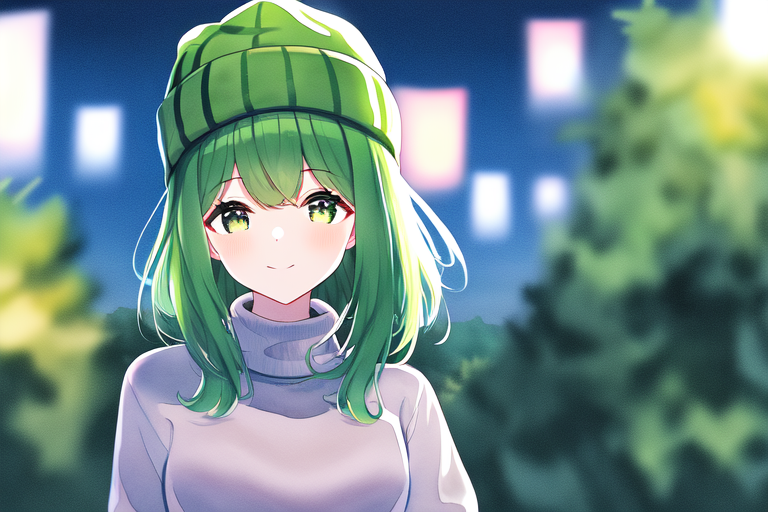
تم إنشاء Waifu Diffusion بواسطة Hakurei ويركز على توليد الصور بأسلوب الأنمي. تم تدريبه خصيصًا على مجموعات بيانات الأنمي، مما يسمح له بإنتاج تصميمات شخصيات متسقة ومرئيات ذات أسلوب مميز. وهو يعتمد على Stable Diffusion ويندمج مباشرة في نظامه البيئي، مما يجعله سهل الاستخدام للفنانين المعتادين بالفعل على تلك الأدوات.
الميزات الرئيسية:
- تدريب يركز على الأنمي: تم تدريب النموذج على مجموعة بيانات كبيرة من صور الأنمي، مما يساعده على تعلم نسب الشخصيات، وتعبيرات الوجه، والعناصر الأسلوبية الشائعة في فن الأنمي.
- جودة شخصية متسقة: يحافظ على ملامح وجه وتسريحات شعر وتفاصيل ملابس مستقرة عبر المطالبات المختلفة، وهو أمر مفيد عند إنشاء نفس الشخصية في مشاهد متعددة.
- التحكم في الأسلوب من خلال المطالبات: يمكنك توجيه المخرجات باستخدام العلامات وأنماط المطالبات الشائعة في مجتمعات الأنمي.
- نسخة قائمة على SDXL: يعمل الإصدار الأحدث المبني على SDXL على تحسين الدقة والإضاءة والتفاصيل الدقيقة مع الحفاظ على أسلوب الأنمي كما هو.
- ترخيص الوصول المفتوح: يتم توزيعه بموجب ترخيص CreativeML OpenRAIL-M، والذي يسمح بالاستخدام وإعادة التوزيع بشروط معينة.
- دعم مجتمعي واسع: يتوفر عدد كبير من نقاط الفحص المدربة مسبقًا (checkpoints)، و LoRAs، وحزم الأنماط.
- Z-Image-Turbo
تم تطوير Z-Image-Turbo بواسطة Tongyi-MAI. وهو يركز على السرعة والكفاءة، مما يجعله مناسبًا للتطبيقات التي تتطلب توليدًا سريعًا للصور. وهو جزء من عائلة نماذج مدمجة مصممة لتقديم نتائج قوية دون الاعتماد على بنيات ضخمة جدًا.
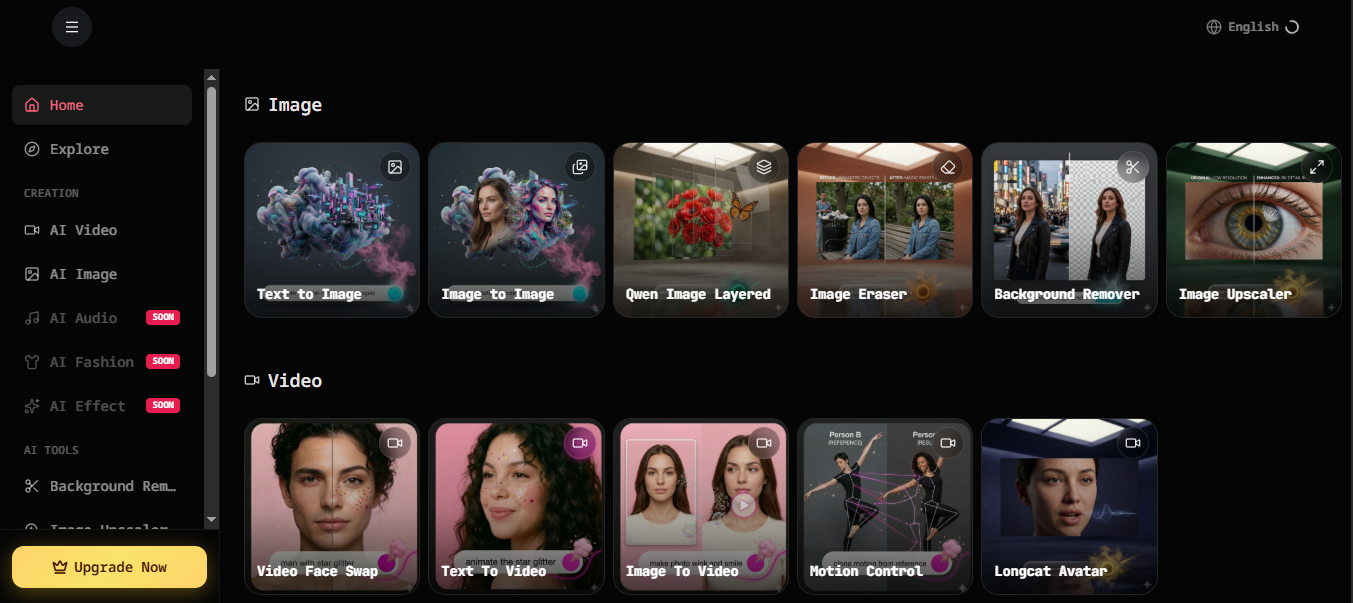
الميزات الرئيسية:
- سرعة توليد أقل من ثانية: يثبت Z-Image-Turbo أن الأداء من المستوى الأول يمكن تحقيقه دون الاعتماد على أحجام نماذج ضخمة.
- عرض النصوص ثنائية اللغة: يعرض النصوص الصينية والإنجليزية المعقدة بدقة، ويظهر مهارات تركيبية قوية وحسًا جيدًا بتنسيق النصوص (typography) في تصميم الملصقات.
- تحسين المطالبات والاستدلال: يمنح محسن المطالبات المدمج النموذج قدرات استدلالية.
- بنية أحادية التدفق فعالة: يستخدم Z-Image-Turbo بنية Scalable Single-Stream DiT حيث يتم دمج النصوص، والرموز الدلالية المرئية (visual semantic tokens)، ورموز VAE للصور على مستوى التسلسل في تدفق إدخال موحد.
عوامل رئيسية يجب مراعاتها قبل اختيار النموذج
قبل أن تلتزم بأحدها، هناك بعض الأمور العملية التي تستحق التحقق منها. إليك ما يجب النظر إليه وسبب أهميته.
- جودة الصورة
تعتمد جودة الصورة على مدى واقعية المخرجات وتفصيلها ودقتها مقارنة بما طلبته. تنتج بعض النماذج نتائج واقعية بينما يميل البعض الآخر إلى الأسلوب الفني (stylized). يعتمد الاختيار الصحيح على ما يحتاجه مشروعك بالفعل.
- السرعة (وقت الاستدلال)
وقت الاستدلال هو الوقت الذي يستغرقه النموذج لإنتاج صورة واحدة. إذا كنت تقوم بتوليد مئات الصور في دفعة واحدة أو تبني أداة تعمل في الوقت الفعلي، فإن السرعة تهم كثيرًا. قد لا يكون النموذج الأبطأ الذي ينتج نتائج رائعة عمليًا دائمًا.
- متطلبات VRAM
VRAM هي الذاكرة التي تستخدمها بطاقة الرسومات الخاصة بك لتشغيل النموذج. تحتاج النماذج الأكبر حجمًا إلى المزيد منها، وأحيانًا 16 جيجابايت أو أكثر. إذا كانت أجهزتك لا تلبي المتطلبات، فلن يعمل النموذج ببساطة، أو سيعمل ببطء شديد ليكون مفيدًا.
- القدرة على عرض النصوص
تتعامل بعض النماذج مع النصوص داخل الصور بشكل جيد، بينما يخطئ البعض الآخر تمامًا. إذا كانت مخرجاتك تتضمن لافتات أو ملصقات أو ملصقات تعريفية أو أي محتوى مكتوب، فإن هذا يصبح عاملاً حاسمًا. تم بناء نماذج مثل GLM-Image و Qwen-Image-2512 خصيصًا مع وضع ذلك في الاعتبار.
- الترخيص (تجاري مقابل مقيد)
بعض النماذج مجانية للاستخدام الشخصي أو البحثي ولكنها تتطلب ترخيصًا مدفوعًا للعمل التجاري. والبعض الآخر مثل Z-Image-Turbo و Qwen-Image-2512 مفتوح بالكامل بموجب ترخيص Apache 2.0. تحقق دائمًا من الترخيص قبل استخدام نموذج في مشروع أو منتج خاص بالعميل.
- النظام البيئي والمجتمع
المجتمع القوي يعني المزيد من البرامج التعليمية، والضبط الدقيق الجاهز، والمكونات الإضافية، والإصلاحات الأسرع عندما تسير الأمور بشكل خاطئ. على سبيل المثال، يحتوي Stable Diffusion على آلاف الموارد التي أنشأها المجتمع. قد يكون النموذج الأحدث أو الأكثر تخصصًا مثيرًا للإعجاب ولكنه يتركك مع القليل جدًا من الدعم حوله.
Framia Pro: خيارك للعمل مع النماذج غير المفتوحة
إن Framia Pro هي منصة إبداعية تعمل بالذكاء الاصطناعي تتيح لك إنشاء الصور ومقاطع الفيديو باستخدام نماذج مغلقة قوية من شركاء مثل Google Gemini ومحركات متقدمة أخرى. وهي تجمع نماذج ملكية متعددة في مساحة عمل واحدة حتى تتمكن من إنشاء مرئيات، تعديل تصميمات الصور، وإنتاج المحتوى دون تبديل الأدوات أو إدارة إعدادات معقدة. وهذا يسهل الأمر على المبدعين الذين يحتاجون إلى نتائج من نماذج ليست مفتوحة المصدر.
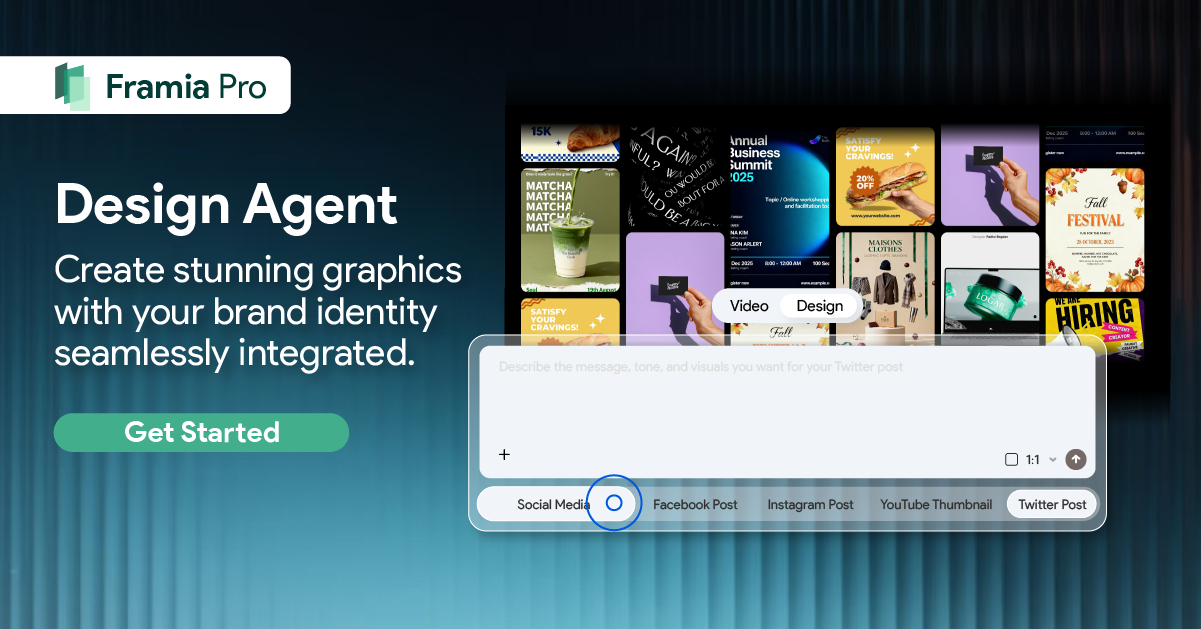
ميزات مولد الصور Framia Pro
توفر Framia Pro مساحة عمل واحدة حيث يمكنك إنشاء الصور وتعديلها باستخدام نماذج صور متقدمة مختلفة. تم تصميم كل ميزة لتمنحك التحكم في كيفية إنشاء الصور وتحسينها.
- نماذج صور متعددة للاختيار من بينها
تتيح Framia Pro الوصول إلى Nano Banana Pro و Qwen Image و MidJourney v7 و Flux Max و Seedream 4.5 داخل منصة واحدة. يمكنك التبديل بين النماذج المختلفة بناءً على نوع النتيجة التي تريدها، مثل المرئيات الواقعية، أو الأعمال الفنية الأسلوبية، أو التصاميم المفاهيمية. يغني هذا الإعداد عن الحاجة إلى استخدام أدوات منفصلة لكل نموذج ويسمح بالمقارنة المباشرة للمخرجات.
- يدعم أي مدخلات
تقبل المنصة أنواعًا مختلفة من المدخلات التي تشمل المطالبات النصية، والصور المرجعية، والمدخلات المدمجة. يمكنك وصف مشهد بلغة بسيطة أو تحميل صورة لتوجيه المخرجات. بهذه الطريقة، يمكنك التحكم في التكوين، والتخطيط، وتفاصيل الموضوع دون قواعد تنسيق صارمة.
- تعديل الصور باستخدام الدردشة
تتيح لك Framia Pro تعديل الصور من خلال واجهة قائمة على الدردشة. يمكنك وصف التغييرات بجمل بسيطة، مثل ضبط الإضاءة، أو إزالة الكائنات، أو تغيير الخلفيات. يفسر النظام تعليماتك ويطبق التعديلات مباشرة على الصورة.
- يعمل مع أنماط متعددة
يمكنك إنشاء صور بأنماط بصرية مختلفة، تتراوح من المشاهد الواقعية إلى الرسوم التوضيحية، والأنمي، والتصاميم التجريدية. يمكنك إدارة الأسلوب من خلال المطالبات واختيار النموذج. تدعم هذه الميزة المشاريع التي تتطلب نبرة أو طابعًا بصريًا معينًا، مثل المحتوى التسويقي، أو الفن المفاهيمي، أو مرئيات وسائل التواصل الاجتماعي.
- إنشاء ومعالجة الصور دفعة واحدة
تدعم Framia Pro المعالجة بالدفعة، مما يتيح لك إنشاء أو تعديل صور متعددة في جلسة واحدة. يمكنك إرسال عدة مطالبات في وقت واحد وتلقي المخرجات دون تكرار نفس الخطوات. هذا مفيد لإنشاء أشكال مختلفة من التصميم، والتي تنتج مجموعات كبيرة من الأصول، أو اختبار أفكار مختلفة بسرعة.
كيفية إنشاء صور باستخدام نماذج الصور على Framia؟
باستخدام هذه الخطوات، يمكنك إنشاء وتحسين الصور، والأعمال الفنية، واللافتات باستخدام Nano Banana Pro داخل Framia Pro.
الخطوة 1: أدخل مطالبتك
- افتح Framia Pro وابدأ بمطالبة نصية واضحة تصف المشهد الذي تريد إنشاءه.
- أضف تفاصيل محددة مثل الموضوع، والخلفية، والألوان، والمزاج، والكائنات لتوجيه المخرجات نحو فكرتك.
- انقر فوق خيار "Plan" لضبط تخطيط المشهد، واتجاه الإضاءة، والتكوين العام قبل بدء الإنشاء.
- قم بتشغيل خيار "Web" إذا كنت تريد أن يستخدم النموذج بيانات Google Search المباشرة للحصول على نتائج صور أكثر وعيًا بالسياق.
الخطوة 2: توليد الصورة
- حدد أي نموذج Pro من نماذج الصور المتاحة داخل المنصة.
- قم بتحميل صور متعددة لتوجيه البنية أو الأسلوب أو اتساق الموضوع.
- اختر نسبة عرض إلى ارتفاع تناسب حالة الاستخدام الخاصة بك، مثل المربع، أو الطولي، أو العرضي، أو مخرجات بدقة تصل إلى 4K.
- انقر فوق "Generate" لإنشاء الصورة بناءً على الوصف والمراجع الخاصة بك.
الخطوة 3: التعديل والتصدير إلى جهازك
- قم بمعاينة الصورة التي تم توليدها وتحقق من التكوين والإضاءة وموضع العناصر
- استخدم الأوامر المستندة إلى الدردشة لتعديل العناصر مثل استبدال الأشياء، أو ضبط الإضاءة، أو تغيير الخلفية
- اطلب تعديلات مستهدفة من خلال وصف التغييرات بنص عادي بدلاً من استخدام الأدوات اليدوية
- انقر فوق "Download" لتصدير الصورة النهائية إلى جهازك بالدقة والتنسيق المحددين
الخاتمة
في هذه المقالة، استكشفنا أفضل 7 نماذج لتوليد الصور مفتوحة المصدر لتوضيح كيفية تعامل الأدوات المختلفة مع إنشاء الصور والأداء والمرونة. يقدم كل نموذج نقاط قوته الخاصة في مجالات مثل الجودة البصرية والسرعة واحتياجات الأجهزة ودعم الأساليب المتنوعة. يجمع Framia Pro نماذج متعددة معًا في مكان واحد لمنحك المزيد من الخيارات لتوليد الصور وتعديلها في سير عمل واحد دون التنقل بين أدوات منفصلة.
الأسئلة الشائعة
- ما هو مولد صور الذكاء الاصطناعي مفتوح المصدر الأكثر استخدامًا
لا يزال Stable Diffusion أحد أكثر مولدات الصور مفتوحة المصدر استخدامًا على نطاق واسع نظرًا لمجتمعه النشط ودعمه الواسع للأدوات. في Framia Pro، يمكنك الوصول إلى نماذج صور مختلفة في مساحة عمل واحدة، مما يلغي الحاجة إلى إعداد بيئات منفصلة لكل مولد ويسمح بالتبديل الأسهل بين المخرجات.
- ما هي نماذج توليد الصور التي تنتج جودة بصرية أعلى
غالبًا ما تولد النماذج الأحدث، مثل تلك القائمة على SDXL وسلسلة Flux، قوامًا أكثر وضوحًا وإضاءة محسنة وتكوينًا أفضل. يمنحك Framia Pro إمكانية الوصول إلى نماذج Nano Banana Pro و Seedream 4.5 و Flux Max و Qwen Image و Midjourney v7 لتتيح لك إنشاء الصور على الفور.
- ما هو النموذج الذي يعمل بشكل أفضل لتوليد الصور على الأجهزة المحدودة
تعد الإصدارات المحسنة أو خفيفة الوزن من النماذج أكثر ملاءمة للأنظمة ذات ذاكرة VRAM المحدودة. يتعامل Framia Pro مع الوصول إلى النماذج في الخلفية، بحيث يمكنك تشغيل نماذج أثقل دون إدارة الإعداد المحلي، مما يقلل من الحاجة إلى أجهزة عالية الكفاءة من جانبك.
- ما هي النماذج التي تعتبر أفضل نماذج توليد الصور مفتوحة المصدر
تُستخدم نماذج مثل Stable Diffusion و Waifu Diffusion والإعدادات القائمة على ControlNet بشكل شائع لمهام مختلفة مثل الواقعية، وفن الأنمي، والتحكم الهيكلي. يجمع Framia Pro هذه الخيارات معًا، مما يتيح لك تحديد واختبار نماذج متعددة داخل مشروع واحد.
- ما هي نماذج الصور المفضلة لحالات الاستخدام المهني
غالبًا ما تتطلب سير العمل المهنية مخرجات مستقرة ونتائج متسقة ودعمًا للتعديل. يضيف Framia Pro قيمة من خلال تقديم تعديل الصور المستند إلى الدردشة والتوليد الجماعي، مما يتيح لك تحسين الصور وإنتاج تنوعات متعددة في مكان واحد دون تبديل الأدوات.