GPT-5.2 विस्तार से: फीचर्स, बेंचमार्क, प्राइसिंग और यूज़ केस
GPT-5.2 Instant, Thinking, Pro और Codex की प्राइसिंग, बेंचमार्क, एक्सेस, सीमाएं और 2026 में Gemini 3 से तुलना डेवलपर्स के लिए जानें।
चित्र 1. गुणवत्ता, स्पीड, कॉस्ट और कंट्रोल के आधार पर GPT-5.2 का आकलन
मैंने Enter Pro में GPT‑5.2 Pro चुना और एक प्रोजेक्ट-ब्रीफ रिव्यूअर बनाया जो ऐप आइडिया को रिक्वायरमेंट्स और एक्सेप्टेंस चेक्स में बदल देता है। स्क्रीनशॉट में सेटअप और रिव्यू आउटपुट दिख रहा है; पूरे हो चुके रिक्वेस्ट की पुष्टि करना अभी भी बाकी स्टेप है।
यह प्रैक्टिकल केस इस गाइड को एक ठोस रेफरेंस पॉइंट देता है। मैं ऑफिशियल बेंचमार्क रिज़ल्ट्स को ऐप में दिख रहे असली बिहेवियर से अलग रखता हूं, फिर इस मॉडल फैमिली की क्षमताओं, प्राइसिंग और सीमाओं की जांच करता हूं। किसी भी ऑब्ज़र्वेशन को Instant, Thinking, Pro या Codex पर लागू करने से पहले आपको सही वेरिएंट पहचानना होगा।
OpenAI ने इस फैमिली को 11 दिसंबर 2025 को प्रोफेशनल काम और लंबे समय तक चलने वाले एजेंट्स के लिए रिलीज़ किया। इसकी लॉन्च रिपोर्ट ऑफिशियल बेंचमार्क और प्राइसिंग बेसलाइन देती है। मैं इस रिपोर्ट के साथ-साथ मौजूदा रूटिंग जानकारी, महत्वपूर्ण इंडिपेंडेंट एक्सपीरियंस, और कम्युनिटी रिपोर्ट्स का भी इस्तेमाल करता हूं क्योंकि कोई एक सोर्स कंट्रोल्ड परफॉर्मेंस और रोज़मर्रा की दिक्कतों दोनों को एक साथ नहीं दिखा सकता।
Chat GPT 5.2 सर्च करने वाले अक्सर पूरे दिसंबर 2025 फैमिली का मतलब लेते हैं, लेकिन ChatGPT मोड्स और API मॉडल IDs के बीच का फर्क मैटर करता है। Instant का टेस्ट Thinking, Pro, या कोडिंग-स्पेशलाइज्ड मॉडल के बिहेवियर, प्राइस, या लेटेंसी को साबित नहीं करता।
GPT-5.2 एक नज़र में
9 अक्टूबर 2026 तक, OpenAI GPT‑5.2 और GPT‑5.2 Pro को पुरानी जेनरेशन के ऑप्शंस के रूप में लिस्ट करता है। मौजूदा प्रोजेक्ट्स इनके जाने-पहचाने बिहेवियर और फिक्स्ड स्नैपशॉट्स को वैल्यू दे सकते हैं, जबकि किसी नए प्रोजेक्ट को उन्हीं एक्सेप्टेंस क्राइटेरिया पर करंट रिकमेंडेड मॉडल्स की तुलना करनी चाहिए।
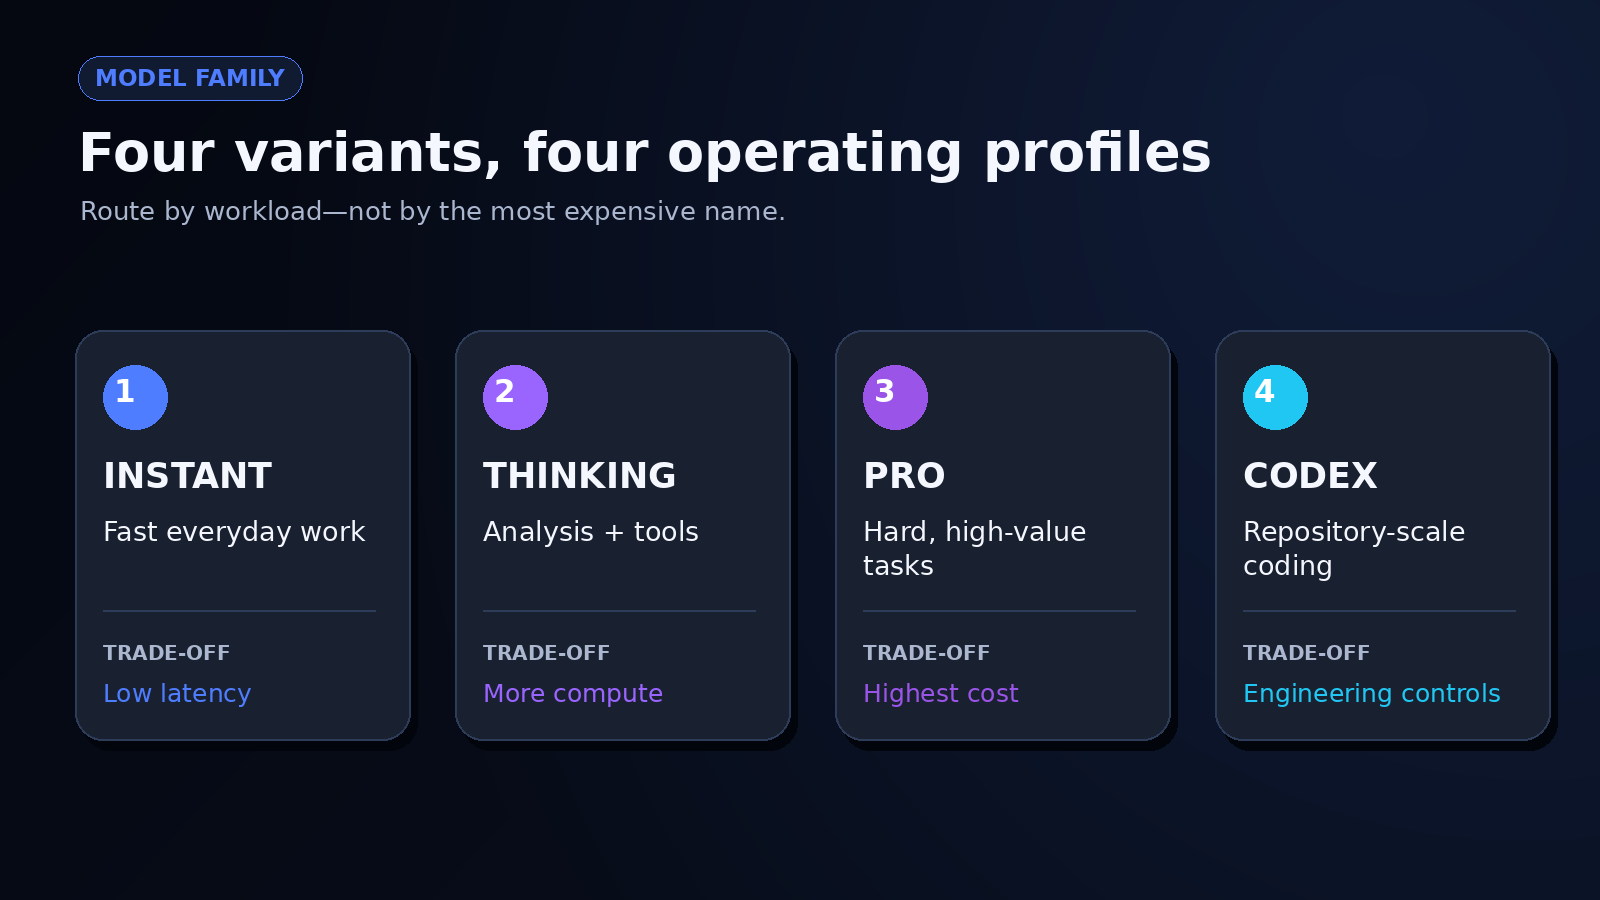
चित्र 2. Instant, Thinking, Pro और Codex वर्कलोड टाइप्स के हिसाब से
| स्पेसिफिकेशन | GPT-5.2 | GPT-5.2 Pro |
|---|---|---|
| करंट पोज़िशन | पुराना फ्लैगशिप | पुराना Pro मॉडल |
| कॉन्टेक्स्ट विंडो | 400,000 टोकन | 400,000 टोकन |
| मैक्सिमम आउटपुट | 128,000 टोकन | 128,000 टोकन |
| नॉलेज कटऑफ | 31 अगस्त 2025 | 31 अगस्त 2025 |
| मॉडैलिटीज़ | टेक्स्ट इनपुट/आउटपुट; इमेज इनपुट | टेक्स्ट इनपुट/आउटपुट; इमेज इनपुट |
| रीज़निंग इफर्ट | नहीं, लो, मीडियम, हाई, एक्स-हाई | मीडियम, हाई, एक्स-हाई |
| API प्राइस प्रति 1M टोकन | $1.75 इनपुट; $0.175 कैश्ड; $14 आउटपुट | $21 इनपुट; $168 आउटपुट |
| स्ट्रक्चर्ड आउटपुट्स | सपोर्टेड | सपोर्टेड नहीं |
| फाइन-ट्यूनिंग | सपोर्टेड नहीं | सपोर्टेड नहीं |
| स्नैपशॉट | gpt-5.2-2025-12-11 | gpt-5.2-pro-2025-12-11 |
करंट स्टेटस, कॉन्टेक्स्ट और मॉडैलिटीज़
400,000-टोकन कॉन्टेक्स्ट विंडो और 128,000-टोकन आउटपुट लिमिट असामान्य रूप से बड़ी हैं, लेकिन कैपेसिटी का मतलब रिकॉल नहीं है। अगर आप कॉन्ट्रैक्ट्स, लॉग्स, स्क्रीनशॉट्स, और रिक्वायरमेंट्स को एक ही रिक्वेस्ट में डाल देते हैं, तब भी आपको एक रिट्रीवल टेस्ट चाहिए: अलग-अलग पोज़िशन पर फैक्ट्स रखें, ऐसे सवाल पूछें जिनके लिए इन्हें कंबाइन करना ज़रूरी हो, और रिकॉर्ड करें कि मॉडल क्या मिस कर रहा है। मैं सिर्फ कॉन्टेक्स्ट नंबर से लॉन्ग-डॉक्युमेंट रीज़निंग की रिलायबिलिटी का अंदाज़ा नहीं लगाऊंगा।
ये मॉडल्स इमेज एक्सेप्ट करते हैं और टेक्स्ट जनरेट करते हैं; ये ऑडियो या वीडियो को नेटिव इनपुट के रूप में एक्सेप्ट नहीं करते। इससे ये चार्ट्स, इंटरफेस स्क्रीनशॉट्स, डायग्राम्स, और स्कैन किए गए डॉक्युमेंट्स के लिए उपयोगी बन जाते हैं, बशर्ते आप स्पेशल डिटेल्स और एक्सट्रैक्टेड वैल्यूज़ को वेरिफाई करें। एक धुंधला लेबल या अनुसार चार्ट स्केल एक कॉन्फिडेंट एक्सप्लेनेशन को एक प्लॉज़िबल एरर में बदल सकता है।
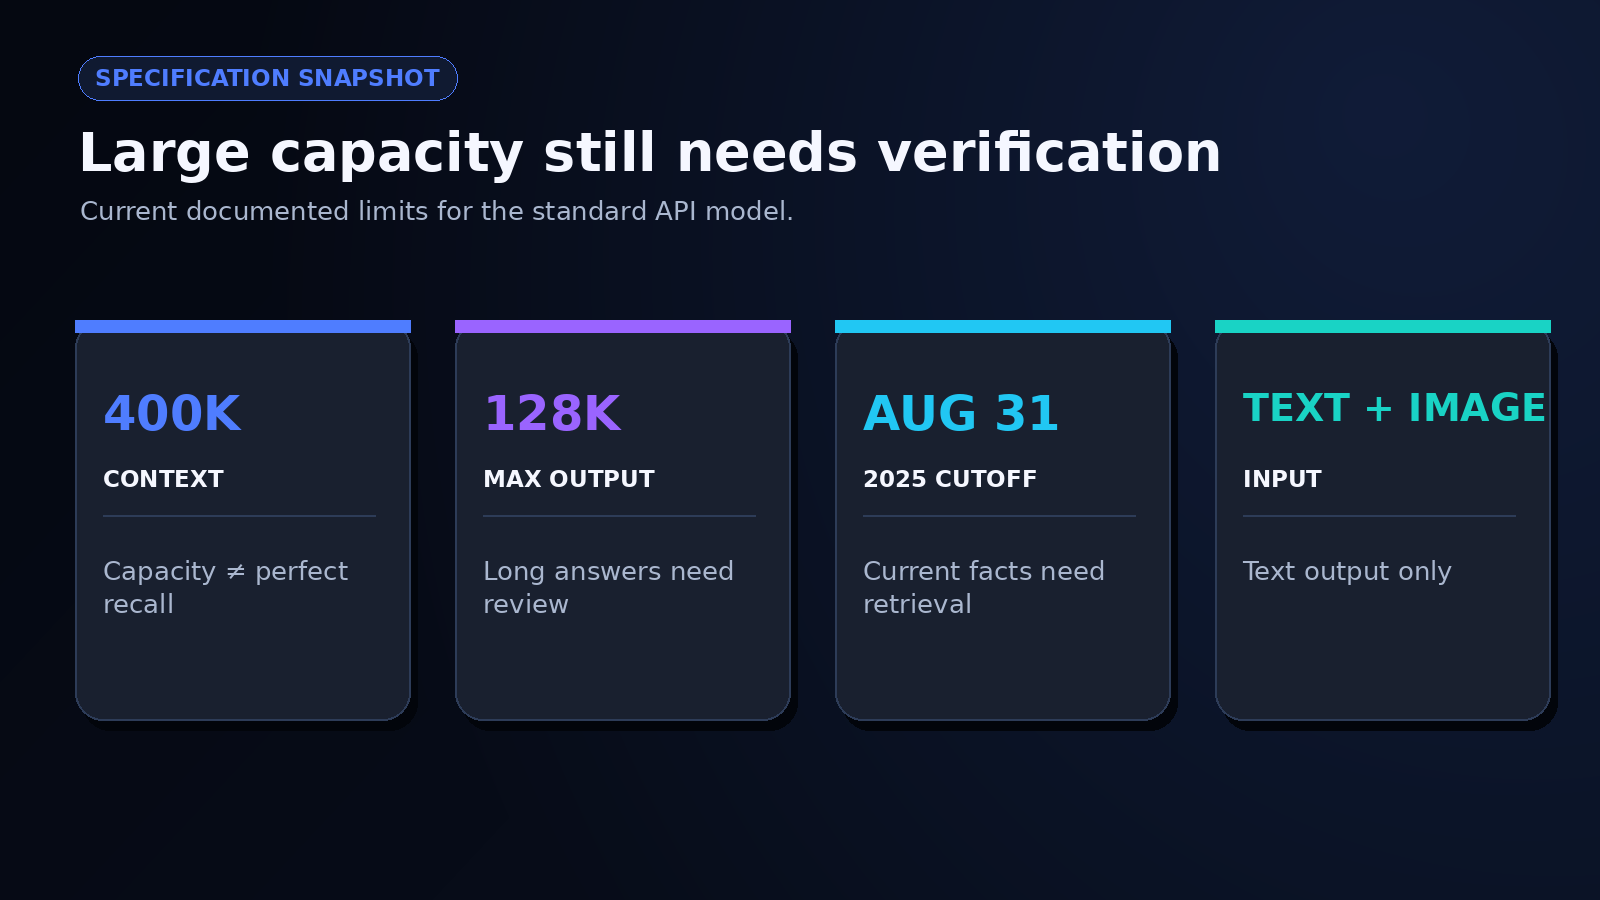
चित्र 3. कॉन्टेक्स्ट, आउटपुट, मॉडैलिटीज़, कटऑफ, और स्नैपशॉट्स
API प्राइसिंग और एक्सेस
स्टैंडर्ड API मॉडल की कॉस्ट $1.75 प्रति मिलियन इनपुट टोकन, $0.175 प्रति मिलियन कैश्ड इनपुट टोकन, और $14 प्रति मिलियन आउटपुट टोकन है। GPT 5.2 Pro की कॉस्ट इनपुट के लिए $21 और आउटपुट के लिए $168 है। रीज़निंग टोकन, रिट्राई, टूल कॉल्स, और ह्यूमन करेक्शन, एक्सेप्टेड रिज़ल्ट की कॉस्ट को इफेक्ट करते हैं। किसी इंटीग्रेशन प्लेटफॉर्म का इस्तेमाल करते समय, OpenAI के डॉलर रेट्स से तुलना करने से पहले उसके बिलिंग यूनिट्स को अलग से चेक करें।
आप करंट प्रोवाइडर रूटिंग और एवेलेबिलिटी OpenRouter के GPT‑5.2 पेज पर देख सकते हैं। मैं पर-रिक्वेस्ट कॉस्ट के बजाय पर-कम्प्लीटेड-टास्क कॉस्ट कैलकुलेट करूंगा। एक सस्ता रिस्पॉन्स जो दो बार वैलिडेशन फेल करे, एक ज़्यादा प्राइस वाले रिस्पॉन्स से महंगा साबित हो सकता है जो पहली ही बार में पास हो जाए।
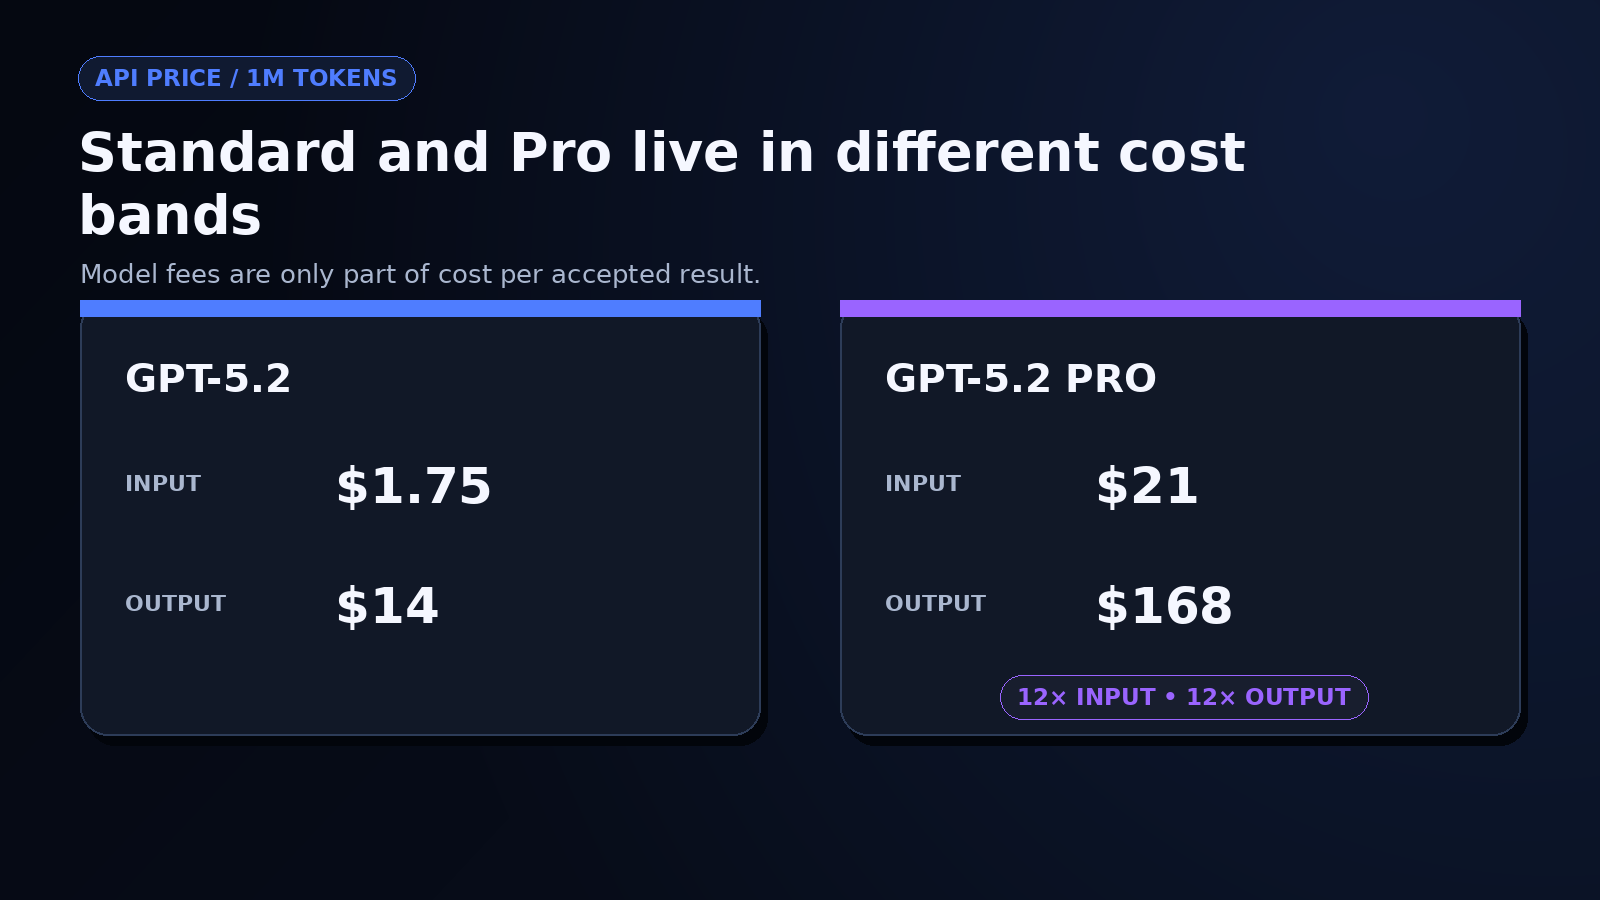
चित्र 4. स्टैंडर्ड बनाम Pro कॉस्ट प्रति मिलियन टोकन
OpenAI GPT-5.2 रिलीज़ में क्या बदला?
OpenAI GPT-5.2 रिलीज़ उस काम को टारगेट करती है जो एक जवाब से आगे जाकर जारी रहता है: आर्टिफैक्ट्स बनाना, लंबे डॉक्युमेंट्स जांचना, टूल्स यूज़ करना, कोड लिखना और रिव्यू करना, इमेज पर रीज़न करना, और मल्टी-स्टेप प्रोफेशनल टास्क्स पूरे करना। इसने फास्ट चैट, डीपर रीज़निंग, और हाई-कंप्यूट वर्क को भी एक सिंगल मॉडल लेबल से कहीं ज़्यादा साफ-साफ अलग किया है।
Instant, Thinking, और Pro अलग-अलग वर्कलोड्स को टारगेट करते हैं
Instant रोज़मर्रा के सवालों, एक्सप्लेनेशन, ट्रांसलेशन, और क्विक ड्राफ्टिंग को प्रायोरिटाइज़ करता है। Thinking एनालिसिस, कोडिंग, फाइल्स, प्लानिंग, और टूल यूज़ को टारगेट करता है। Pro मुश्किल प्रॉब्लम्स पर ज़्यादा कंप्यूटेशन खर्च करता है जहां लंबा इंतज़ार और बहुत ज़्यादा API बिल जस्टिफाई हो सकता है।
| मोड या मॉडल | प्रैक्टिकल फिट | मुख्य ट्रेड-ऑफ |
|---|---|---|
| Instant | रूटीन सवाल और लेटेंसी-सेंसिटिव काम | मुश्किल मल्टी-स्टेप टास्क्स पर कम डिलिबरेशन |
| Thinking | एनालिसिस, कोडिंग, लंबी फाइल्स, और टूल-ड्रिवन वर्कफ्लोज़ | ज़्यादा लेटेंसी और टोकन यूज़ |
| Pro | मुश्किल टास्क्स जहां इंक्रीमेंटल क्वालिटी की हाई वैल्यू हो | बहुत ज़्यादा कॉस्ट; रिस्पॉन्स में मिनट्स लग सकते हैं |
मैं प्रेस्टीज के बजाय रिस्क के हिसाब से रूट करूंगा। किसी क्लासिफिकेशन स्टेप को स्ट्रिक्ट स्कीमा वाले फास्ट मॉडल की ज़रूरत हो सकती है। किसी फाइनेंशियल मॉडल रिव्यू में डीपर रीज़निंग जस्टिफाइड हो सकती है। अगर आप हर रिक्वेस्ट Pro को भेजते हैं, तो आप यह छुपा देते हैं कि कौन से टास्क्स एक्स्ट्रा कंप्यूट से असल में फायदा पा रहे हैं, और कॉस्ट कंट्रोल को बहुत मुश्किल बना देते हैं।
प्रोफेशनल वर्क और टूल यूज़ इस लॉन्च का केंद्र थे
OpenAI ने स्प्रेडशीट्स, प्रेजेंटेशंस, फ्रंट-एंड वर्क, कोड रिव्यू, डॉक्युमेंट एनालिसिस, साइंस, मैथमेटिक्स, और टूल कॉलिंग पर ज़ोर दिया। डी-आइडेंटिफाइड ChatGPT क्वेरीज़ पर वेंडर-रन इवैल्युएशन में, रिस्पॉन्स-लेवल एरर्स को GPT‑5.1 Thinking की तुलना में रिलेटिवली 30% कम बताया गया। रिलीज़ में यह भी बताया गया है कि एरर ग्रेडिंग मॉडल्स ने ही की, इसलिए मैं इस नंबर को इंडिपेंडेंट गारंटी के बजाय डायरेक्शनल एविडेंस के तौर पर पढ़ता हूं।
प्रैक्टिकल इम्प्रूवमेंट यह नहीं है कि "मॉडल सब कुछ जानता है।" यह ज़्यादा चांस है कि एक वेल-स्पेसिफाइड टास्क कई स्टेप्स के बाद भी अपना स्ट्रक्चर खोए बिना बचा रहे। आपको अब भी ऑब्ज़र्वेबल चेकपॉइंट्स चाहिए: कौन सा टूल चला, उसे क्या डेटा मिला, उसने क्या बदला, और फेल्ड कॉल के बाद वर्कफ्लो कैसे रिकवर हुआ।
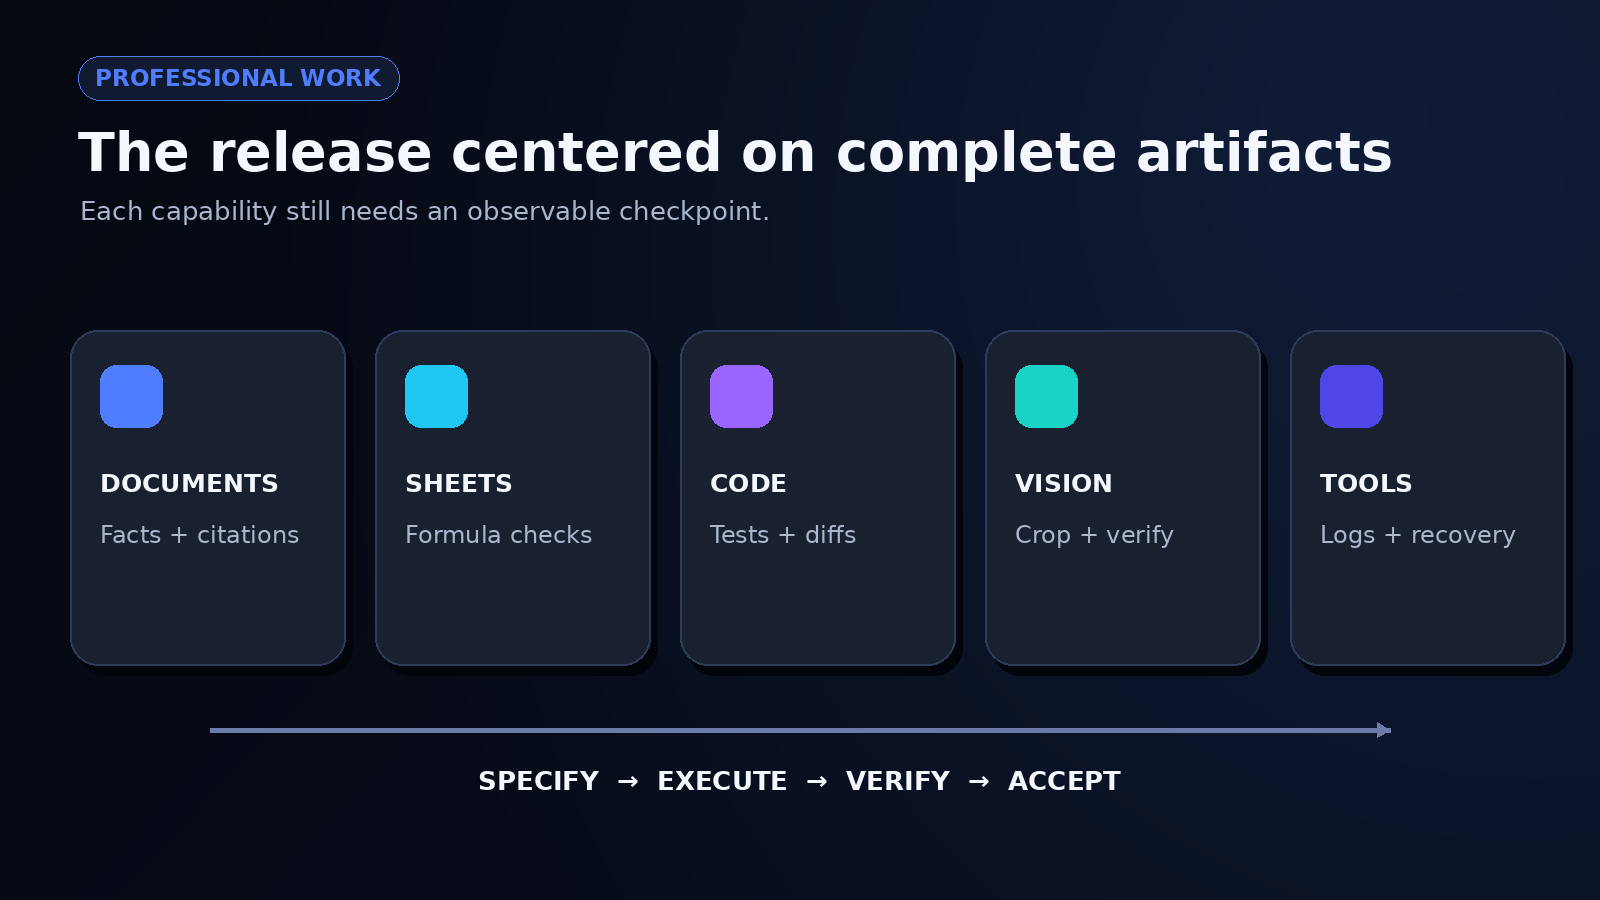
चित्र 5. स्प्रेडशीट, कोड, डॉक्युमेंट, इमेज, और टूल-कॉल पैनल्स
लॉन्च बेंचमार्क्स ने ब्रॉड लेकिन अनइवन स्ट्रेंथ्स दिखाईं
| बेंचमार्क | GPT-5.2 Thinking | यह क्या मापता है |
|---|---|---|
| GDPval wins या ties | 70.9% | 44 ऑक्युपेशंस में वेल-स्पेसिफाइड प्रोफेशनल टास्क्स |
| SWE-Bench Pro पब्लिक | 55.6% | मल्टी-लैंग्वेज सॉफ्टवेयर-इंजीनियरिंग टास्क्स |
| SWE-bench Verified | 80.0% | वेरिफाइड Python रिपॉज़िटरी टास्क्स |
| GPQA Diamond | 92.4% | टूल्स के बिना ग्रेजुएट-लेवल साइंस क्वेश्चंस |
| AIME 2025 | 100.0% | टूल्स के बिना कॉम्पिटिशन मैथमेटिक्स |
| ARC-AGI-2 Verified | 52.9% | नॉवेल एब्स्ट्रैक्ट-रीज़निंग टास्क्स |
स्प्रेड यहां उपयोगी पार्ट है। यह मज़बूत नतीजे दिखाता है, बिना ये कहे कि हर जगह बराबर मास्टरी है। वेरिफाइड Python इश्यूज़ पर 80% स्कोर कस्टम डिप्लॉयमेंट रूल्स वाले TypeScript मोनोरेपो में आपके पास रेट की भविष्यवाणी नहीं करता। इसी तरह, एक साइंस बेंचमार्क रिलायबल लीगल या मेडिकल जजमेंट साबित नहीं करता।
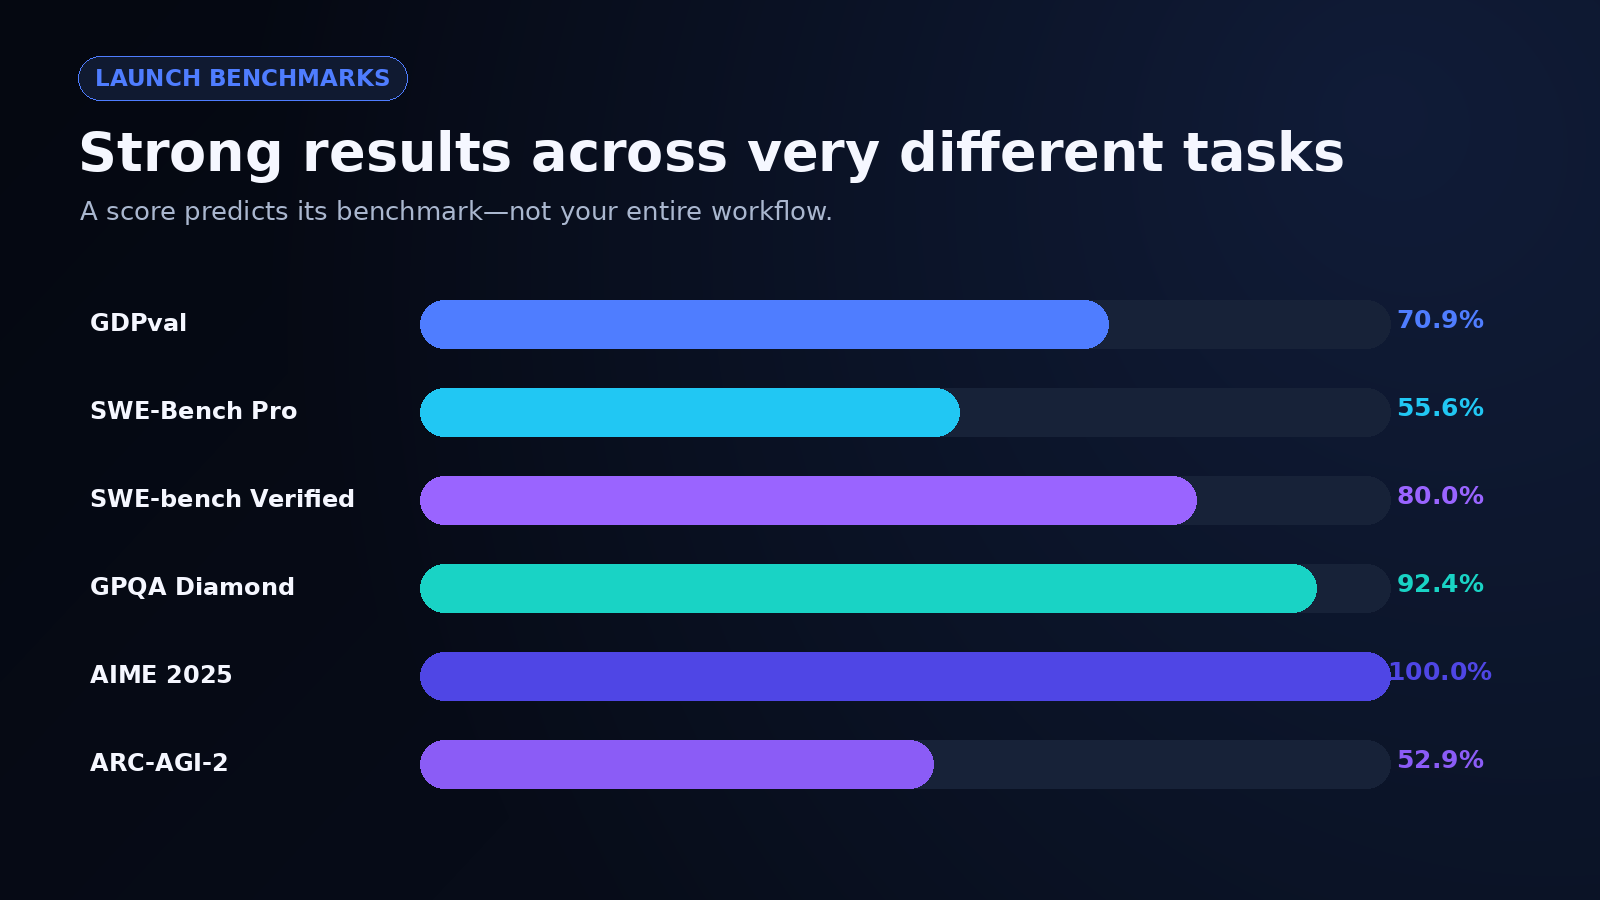
चित्र 6. टास्क कैटेगरीज़ के साथ छह लॉन्च स्कोर
GPT-5.2 बेंचमार्क्स को उनकी लिमिटेशंस के साथ पढ़ें
पब्लिक स्कोर्स कई चॉइसेज़ को एक नंबर में कम्प्रेस कर देते हैं: प्रॉम्प्ट फॉर्मेट, टूल्स, रीज़निंग इफर्ट, टेस्ट सिलेक्शन, ग्रेडर बिहेवियर, और रिट्राई पॉलिसी। आपके प्रोडक्शन वर्कफ्लो में डेटा क्वालिटी, परमिशंस, लेटेंसी लिमिट्स, और ह्यूमन रिव्यू ऐड होते हैं। मुझे बेंचमार्क्स यह चुनने में सबसे ज़्यादा उपयोगी लगते हैं कि क्या टेस्ट करना है—टेस्ट को स्किप करने के लिए नहीं।
मेरे ऐप रिव्यू ने असल में क्या दिखाया
प्रोजेक्ट-ब्रीफ रिव्यूअर ने "प्रोजेक्ट समरी" और "एसेंशियल रिक्वायरमेंट्स" के नीचे सबमिट की गई इंस्ट्रक्शंस दिखाई, जबकि रिस्पॉन्स अभी भी स्ट्रीम हो रहा था। इनपुट ने इम्प्लीमेंटेशन चेक्स मांगे थे, लेकिन दिख रहे रिज़ल्ट ने उस रिक्वेस्ट को एक ब्रीफ के रूप में ऑर्गनाइज़ किया। इसने कम्प्लीटेड कोड इंस्पेक्शन या टेस्ट आउटकम्स की रिपोर्ट नहीं दी।
सेपरेट सेशन व्यू में कोई लॉग्ड रिक्वेस्ट्स या यूसेज नहीं था, जिससे रिस्पॉन्स टाइम, रूटिंग, और कॉस्ट अनवेरिफाइड रह गए। इस चेक को पूरा करने के लिए एक कंस्ट्रेन्ड ब्रीफ के साथ एक रिक्वेस्ट पूरा करें।
बेंचमार्क स्कोर्स प्रोडक्शन गारंटी नहीं हैं
20 से 50 रिप्रेजेंटेटिव टास्क्स से शुरू करें और इन्हें रन करने से पहले एक्सेप्टेंस डिफाइन करें। कोड के लिए, इसमें टेस्ट पास रेट, डिफ साइज़, सिक्योरिटी फाइंडिंग्स, और रोलबैक सेफ्टी शामिल हो सकती है। डॉक्युमेंट वर्क के लिए, इसमें फैक्चुअल एक्यूरेसी, साइटेशन कवरेज, कैलकुलेशन एरर्स, और एडिटिंग टाइम शामिल हो सकता है। वेरिएंस मैटर करता है इसलिए एक ही सेट को एक से ज़्यादा बार रन करें।
फिर पर-एक्सेप्टेड-रिज़ल्ट कॉस्ट मेज़र करें। मान लें एक मॉडल की कॉस्ट $0.18 प्रति रन है और वह 60% केसेस पास करता है, जबकि दूसरे की कॉस्ट $0.28 है और वह 90% पास करता है। ह्यूमन करेक्शन से पहले, पर-एक्सेप्टेड-रिज़ल्ट उनकी एक्सपेक्टेड कॉस्ट $0.30 और लगभग $0.31 है। एक बार जब आप रिव्यू टाइम को प्राइस करते हैं, तो दूसरा साफतौर पर सस्ता हो सकता है—या नहीं भी। यह अरिथमेटिक डिसीज़न को वापस आपके वर्कफ्लो पर ले जाती है।
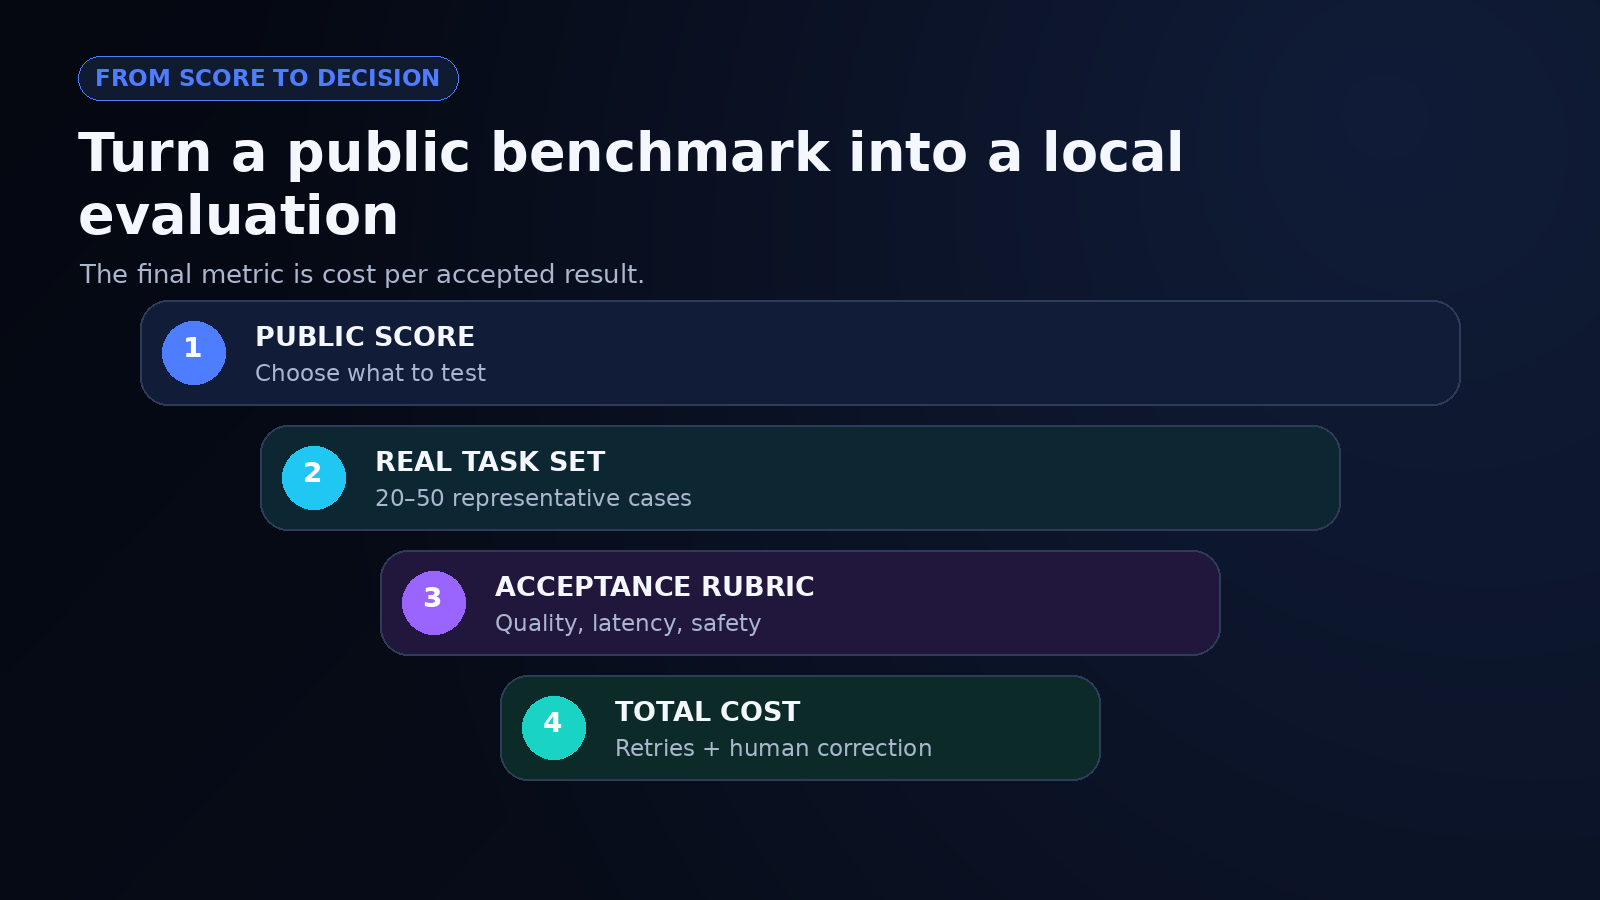
चित्र 7. बेंचमार्क स्कोर से रिप्रेजेंटेटिव टास्क्स तक एक्सेप्टेड-रिज़ल्ट कॉस्ट
लॉन्ग कॉन्टेक्स्ट और इमेज इनपुट अब भी वेरिफिकेशन मांगते हैं
एक लॉन्ग कॉन्टेक्स्ट विंडो चंकिंग को कम कर सकती है, लेकिन इससे चूक को नोटिस करना भी मुश्किल हो जाता है। मैं फाइल सेट के शुरुआत, बीच, और आखिर से रिट्रीवल टेस्ट करूंगा; क्रिटिकल फैक्ट्स के लिए क्वोटेशंस या रिकॉर्ड आइडेंटिफायर्स की डिमांड करूंगा; और कैलकुलेशंस को मॉडल के बाहर दोबारा रन करूंगा। इमेजेज़ के लिए, रेलेवेंट रीजन को क्रॉप करें और सवाल को एक्सप्लिसिटली पूछें, न कि मॉडल से यह उम्मीद रखें कि वह खुद समझ ले कि क्या इम्पॉर्टेंट है।
इंडिपेंडेंट क्रिटिसिज़्म भी ऐसे फेलियर मोड्स को उजागर कर सकता है जिन्हें लॉन्च पोस्ट फोरग्राउंड नहीं करेगी। एक हैंड्स-ऑन क्रिटीक लेखक के टास्क्स में निराशाजनक आउटपुट्स को बताता है। इससे बेंचमार्क रिज़ल्ट्स गलत साबित नहीं होते; यह बताता है कि क्यों आपके प्रॉम्प्ट, वर्कलोड, और एक्सेप्टेंस बार को डायरेक्टली रिप्रोड्यूस करना ज़रूरी है।
चित्र 8. 400K-टोकन डॉक्युमेंट स्ट्रीम में फैली एविडेंस
हाई-स्टेक्स वर्क को डोमेन सेफगार्ड्स चाहिए
31 अगस्त 2025 की नॉलेज कटऑफ का मतलब है कि करंट फैक्ट्स को रिट्रीवल चाहिए। मॉडल्स अब भी सोर्सेज़ इनवेंट कर सकते हैं, रिक्वायरमेंट्स ओवरलुक कर सकते हैं, स्क्रीनशॉट्स मिसरीड कर सकते हैं, या अनसेफ कोड जनरेट कर सकते हैं। ये फाइन-ट्यूनिंग भी सपोर्ट नहीं करते, इसलिए जिन टीमों को डीपली कस्टमाइज़्ड बिहेवियर चाहिए, उन्हें प्रॉम्प्टिंग, रिट्रीवल, टूल्स, वैलिडेशन, या किसी दूसरे मॉडल पर निर्भर रहना होगा।
आपको असिस्टेंस को अथॉरिटी से अलग करना चाहिए। एक मॉडल कॉन्ट्रैक्ट समराइज़ कर सकता है, संदिग्ध ट्रांज़ैक्शन को फ्लैग कर सकता है, या एक पैच प्रपोज़ कर सकता है। लीगल, मेडिकल, फाइनेंशियल, सिक्योरिटी, और प्रोडक्शन डिसीज़न किसी क्वालिफाइड पर्सन या डिटरमिनिस्टिक कंट्रोल को लेना चाहिए। एविडेंस लॉग करें और आउटपुट को रिजेक्ट या रोलबैक करने का साफ रास्ता रखें।
GPT-5.2-Codex क्या है और डेवलपर्स को इसे कैसे यूज़ करना चाहिए?
GPT 5.2 Codex इस फैमिली का कोडिंग-स्पेशलाइज्ड मेंबर है, जिसे आइसोलेटेड ऑटोकंप्लीट के बजाय लॉन्गर सॉफ्टवेयर-इंजीनियरिंग वर्क के लिए डिज़ाइन किया गया है। उपयोगी फर्क है वर्कफ्लो डेप्थ: एक रिपॉज़िटरी को समझना, एक चेंज प्लान करना, कई फाइल्स एडिट करना, टूल्स रन करना, फेलियर्स इंस्पेक्ट करना, और पैच रिवाइज़ करना।
बेस्ट-फिट कोडिंग टास्क्स
अच्छे कैंडिडेट्स में रिपॉज़िटरी एक्सप्लोरेशन, फीचर इम्प्लीमेंटेशन, बग रिपेयर, रीफैक्टरिंग, टेस्ट क्रिएशन, कोड रिव्यू, और एक्सप्लिसिट एक्सेप्टेंस क्राइटेरिया वाली माइग्रेशंस शामिल हैं। मैं मॉडल को वह सबसे छोटा कोहेरेंट गोल दूंगा जिसमें फिर भी रियल डिपेंडेंसी बाउंड्री शामिल हो। आर्टिफिशियली टिनी प्रॉम्प्ट एक क्लीन लोकल डिफ पैदा कर सकता है जो सराउंडिंग सिस्टम में फेल हो जाए।
आप GPT 5.2 Codex को एक रिपीटेबल रिपॉज़िटरी सेट से इवैल्युएट कर सकते हैं: नोन इश्यूज़, हिडन टेस्ट्स, लिंटिंग, डिपेंडेंसी पॉलिसी, सिक्योरिटी चेक्स, और मैक्सिमम एक्सेप्टेबल डिफ। टूल कॉल्स, करेक्शंस, और रिव्यूअर इंटरवेंशंस की संख्या रिकॉर्ड करें। एक पैच सिर्फ इस वजह से सक्सेसफुल नहीं है कि वह कॉम्पाइल हो जाता है।
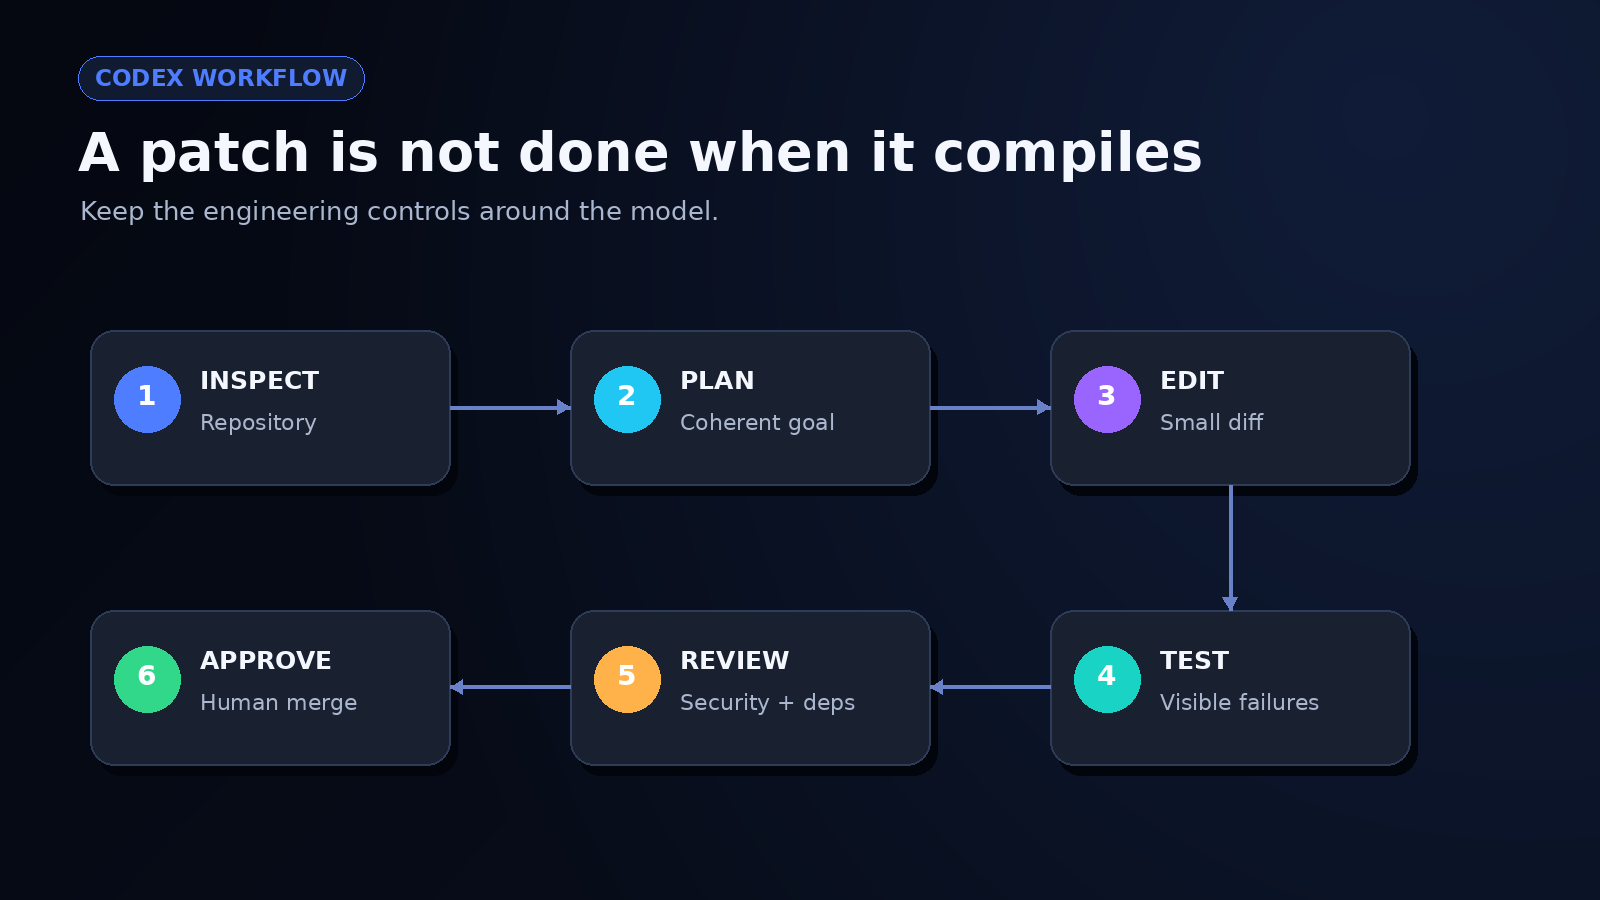
चित्र 9. इंस्पेक्ट, प्लान, एडिट, टेस्ट, रिव्यू, और अप्रूव
प्रोडक्शन गार्डरेल्स अब भी अप्लाई होते हैं
चेंजेज़ को रिव्यू के लिए काफी छोटा रखें, जब रिप्रोड्यूसिबिलिटी मैटर करे तो मॉडल स्नैपशॉट को पिन करें, और टूल्स को लीस्ट रिक्वायर्ड प्रिविलेज तक रिस्ट्रिक्ट करें। रिपॉज़िटरी टेस्ट्स, डिपेंडेंसी स्कैनिंग, सीक्रेट डिटेक्शन, स्टैटिक एनालिसिस, और ह्यूमन डिफ रिव्यू रन करें। अगर एजेंट डिप्लॉय कर सकता है, डेटा डिलीट कर सकता है, या क्रेडेंशियल्स रोटेट कर सकता है, तो इन एक्शंस को एक्सप्लिसिट एप्रूवल के पीछे रखें।
मैं एक फेलियर बजट को भी प्रिफर करता हूं: डिफाइन करें कि एक टास्क किसी ह्यूमन को रिटर्न होने से पहले कितने रिट्राईज़, मिनट्स, या टोकन्स कंज़्यूम कर सकता है। इस बाउंड्री के बिना, एक एजेंट प्रोडक्टिव दिख सकता है जबकि वह बढ़ते हुए स्पेक्युलेटिव फिक्सेज़ में लूप कर रहा हो।
GPT-5.2 vs Gemini 3 एग्ज़ैक्ट टास्क पर डिपेंड करता है
GPT-5.2 vs Gemini 3: बताता है कि बेस्ट AI मॉडल टास्क पर डिपेंड करता है, जैसे कोडिंग, रीज़निंग, राइटिंग, या रिसर्च।
"GPT 5.2 vs Gemini 3" का ऑनेस्ट जवाब एक टेस्ट डिज़ाइन है, कोई यूनिवर्सल विनर नहीं। एग्ज़ैक्ट वेरिएंट्स, डेट्स, टूल्स, कॉन्टेक्स्ट साइज़ेज़, रीज़निंग सेटिंग्स, और प्राइसिंग रिकॉर्ड की जानी चाहिए। वरना, एक कंपैरिज़न क्वाइटली एक मॉडल को सर्च, कोड एग्ज़ीक्यूशन, या बड़ा टाइम बजट दे सकती है।
| डिसीज़न फैक्टर | टेस्ट करने वाला सवाल |
|---|---|
| आउटपुट क्वालिटी | कौन सा मॉडल आपके टास्क रुब्रिक को ज़्यादा बार पास करता है? |
| कोडिंग | कौन छोटे, सेफर डिफ्स के साथ हाई टेस्ट-पास रेट प्रोड्यूस करता है? |
| लॉन्ग कॉन्टेक्स्ट | कौन आपकी फाइल्स से फैक्ट्स को ज़्यादा एक्यूरेटली रिट्रीव और कंबाइन करता है? |
| टूल यूज़ | कौन रिकवरेबल फेलियर्स और यूज़ेबल लॉग्स के साथ वर्कफ्लो कंप्लीट करता है? |
| लेटेंसी | मीडियन और 95वां पर्सेंटाइल रिस्पॉन्स टाइम क्या हैं? |
| कॉस्ट | रिट्राईज़ और करेक्शन के बाद पर-एक्सेप्टेड-रिज़ल्ट टोटल कॉस्ट क्या है? |
| गवर्नेंस | आपके यूज़ केस के लिए कौन से डेटा, रिटेंशन, रीजन, और ऑडिट कंट्रोल्स फिट होते हैं? |
वही हेड-टू-हेड इवैल्युएशन रन करें
दोनों मॉडल्स को एक जैसे प्रॉम्प्ट्स, सोर्स फाइल्स, टूल्स, टाइम बजट, और स्कोरिंग रुब्रिक दें। टास्क ऑर्डर को रैंडमाइज़ करें और जहां पॉसिबल हो, रिव्यूअर्स से मॉडल नेम छुपाएं। एक अच्छा दिखने वाला सिंगल आंसर सिलेक्ट करने के बजाय रिप्रेजेंटेटिव केसेज़ को रिपीट करें। GPT‑5.2 लॉन्च डिस्कशन में कम्युनिटी रिएक्शंस टेस्ट करने के लिए कंप्लेंट्स डिस्कवर करने में यूज़फुल हैं, लेकिन वो कंट्रोल्ड कंपैरिज़ंस नहीं हैं।
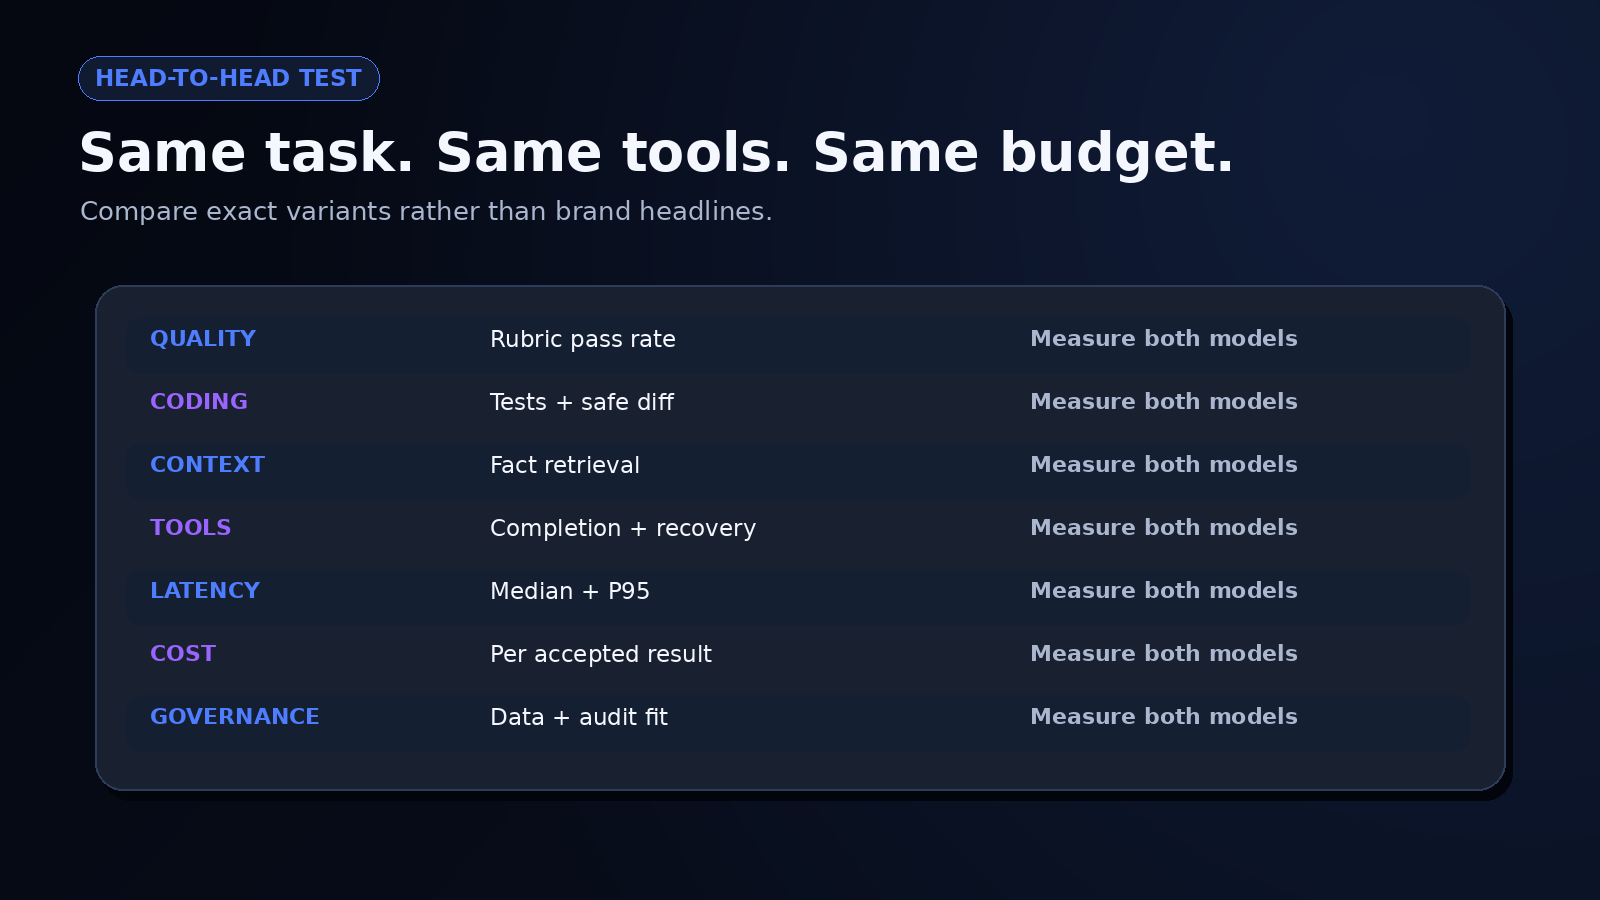
चित्र 10. क्वालिटी, कोडिंग, कॉन्टेक्स्ट, टूल्स, लेटेंसी, कॉस्ट, और गवर्नेंस
बेटर हेडलाइन के बजाय लोअर-रिस्क वर्कफ्लो चुनें
आपका विनर स्टेप के हिसाब से अलग हो सकता है। एक मॉडल अच्छी तरह प्लान कर सकता है, दूसरा क्लीनर कोड जनरेट कर सकता है, और एक स्मॉलर ऑप्शन कॉस्ट के एक फ्रैक्शन पर क्लासिफिकेशन हैंडल कर सकता है। राइट आर्किटेक्चर एक मॉडल को सब कुछ करने पर मजबूर करने के बजाय वर्क को रूट कर सकता है।
GPT 5.2 vs Gemini 3 इवैल्युएशन के लिए, मैं वह सबसे सिंपल मॉडल मिक्स चुनूंगा जो क्वालिटी थ्रेशहोल्ड पूरा करे और फेल होने पर भी ऑब्ज़र्वेबल बना रहे। हर एडिशनल प्रोवाइडर या फॉलबैक रूटिंग लॉजिक, इवैल्युएशन वर्क, प्राइवेसी रिव्यू, और इंसिडेंट कॉम्प्लेक्सिटी ऐड करता है। मॉडल डाइवर्सिटी तब यूज़फुल है जब यह किसी मेज़र्ड रिस्क को कम करे।
Enter Pro में GPT‑5.2 Pro ऐप बनाएं
मैंने Enter Pro के AI ऐप बिल्डर का इस्तेमाल कर एक AI प्रोजेक्ट-ब्रीफ रिव्यूअर बनाया, जिसमें GPT‑5.2 Pro को इंटीग्रेशन के तौर पर सिलेक्ट किया गया। मकसद था एक रफ ऐप आइडिया को रिक्वायरमेंट्स, मिसिंग इंफॉर्मेशन, प्रायोरिटीज़, और एक्सेप्टेंस चेक्स में बदलना।
GPT‑5.2 Pro सिलेक्ट करें और रेट्स पढ़ें
मैंने मॉडल कैटलॉग में GPT‑5.2 Pro ढूंढा और इसकी डिटेल्स खोली। पैनल में एक Integrate बटन और** 2.1 क्रेडिट्स प्रति 1,000 इनपुट टोकन्स** और** 16.8 क्रेडिट्स प्रति 1,000 आउटपुट टोकन्स** के रेट्स दिखे। ये कैप्चर किए गए प्लेटफॉर्म रेट्स हैं।
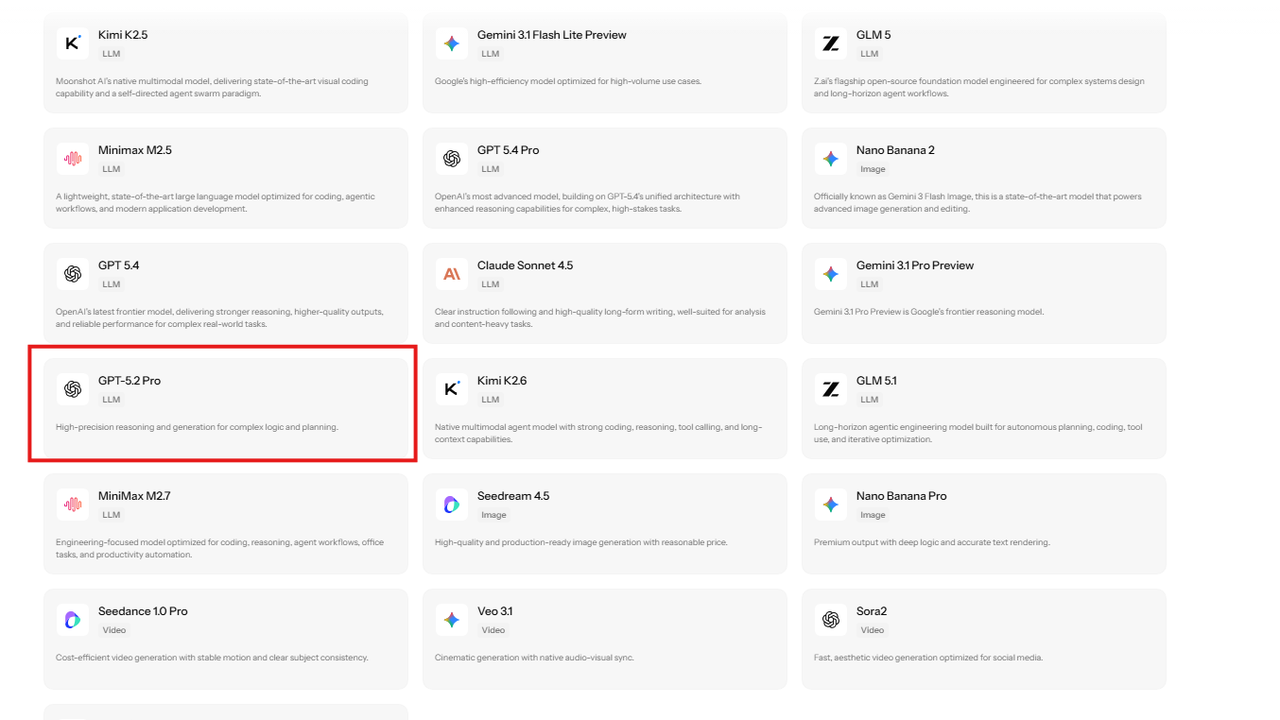
चित्र 11. GPT‑5.2 Pro मॉडल कैटलॉग में अन्य एवेलेबल इंटीग्रेशंस के बीच दिखता है।
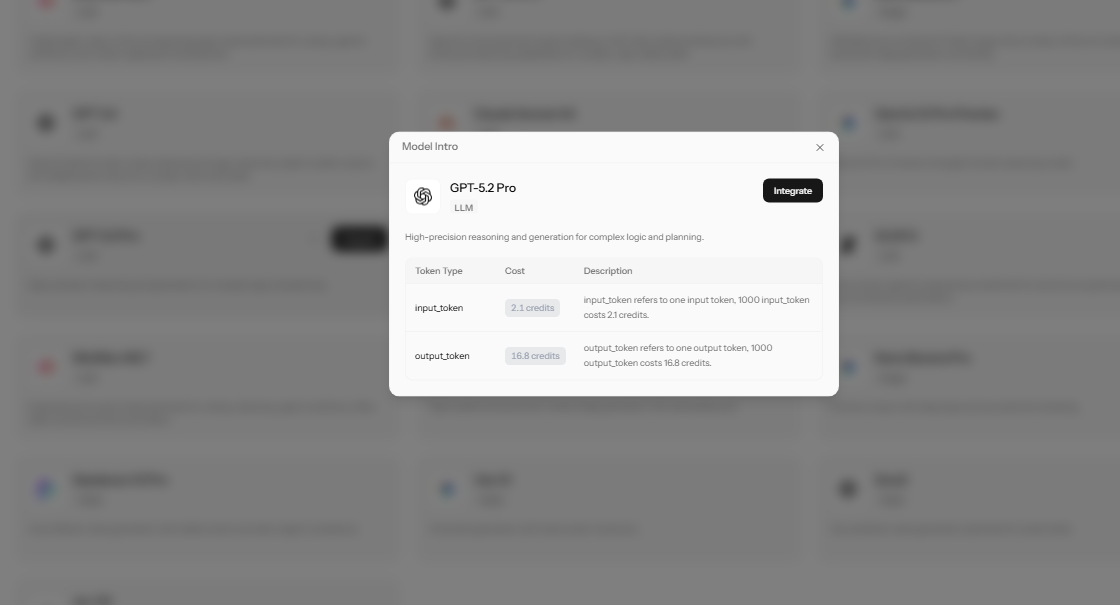
चित्र 12. GPT‑5.2 Pro डिटेल्स पैनल Integrate कंट्रोल और क्रेडिट रेट्स दिखाता है।
मॉडल अटैच करें और ऐप डिस्क्राइब करें
प्रोजेक्ट रिक्वेस्ट में GPT‑5.2 Pro चिप अटैच था। मैंने एक बड़ा ब्रीफ फील्ड, एक Review Brief बटन, और पांच सेक्शंस में व्यवस्थित रिस्पॉन्सेस मांगे: प्रोजेक्ट समरी, एसेंशियल रिक्वायरमेंट्स, कॉन्ट्राडिक्शंस और मिसिंग इंफॉर्मेशन, इम्प्लीमेंटेशन प्रायोरिटीज़, और एक्सेप्टेंस चेक्स। रिक्वेस्ट में जेनुइन लोडिंग और एरर स्टेट्स भी मांगे गए थे।
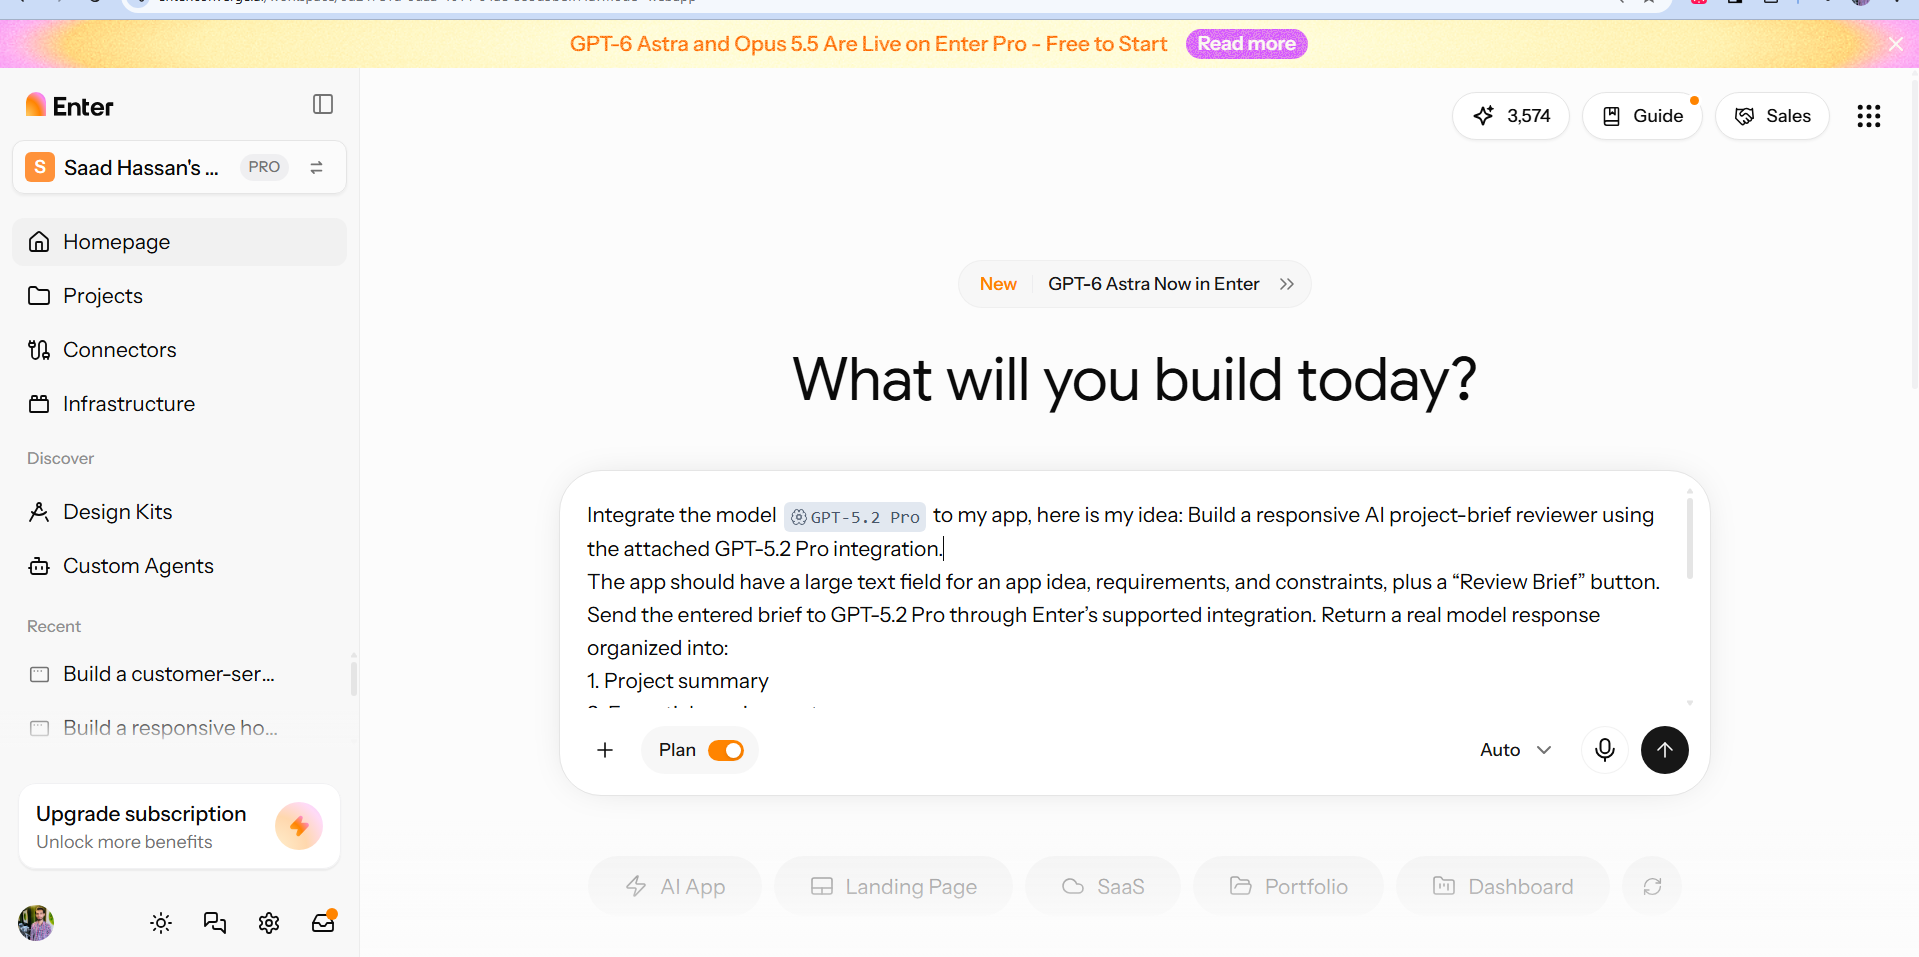
चित्र 13. प्रोजेक्ट प्रॉम्प्ट GPT‑5.2 Pro को अटैच करता है और रिव्यूअर के पर्पज़ और रिस्पॉन्स स्ट्रक्चर को स्पेसिफाई करता है।
बिल्ड प्लान इंस्पेक्ट करें
Enter ने Vite, React, और Tailwind इंटरफेस के लिए एक प्लान जनरेट किया, जिसमें एक बैकएंड फंक्शन AI रिक्वेस्ट को हैंडल करता था। इसमें स्ट्रीमिंग रिज़ल्ट्स, प्लेन इंग्लिश टेक्स्ट, और कोई सेव्ड रिव्यू हिस्ट्री नहीं होने की बात स्पेसिफाइड थी। प्राइवेट क्रेडेंशियल को बैकएंड पर रखना इस प्लान का हिस्सा था। यह कैप्चर प्रपोज़्ड इम्प्लीमेंटेशन को रिकॉर्ड करता है।
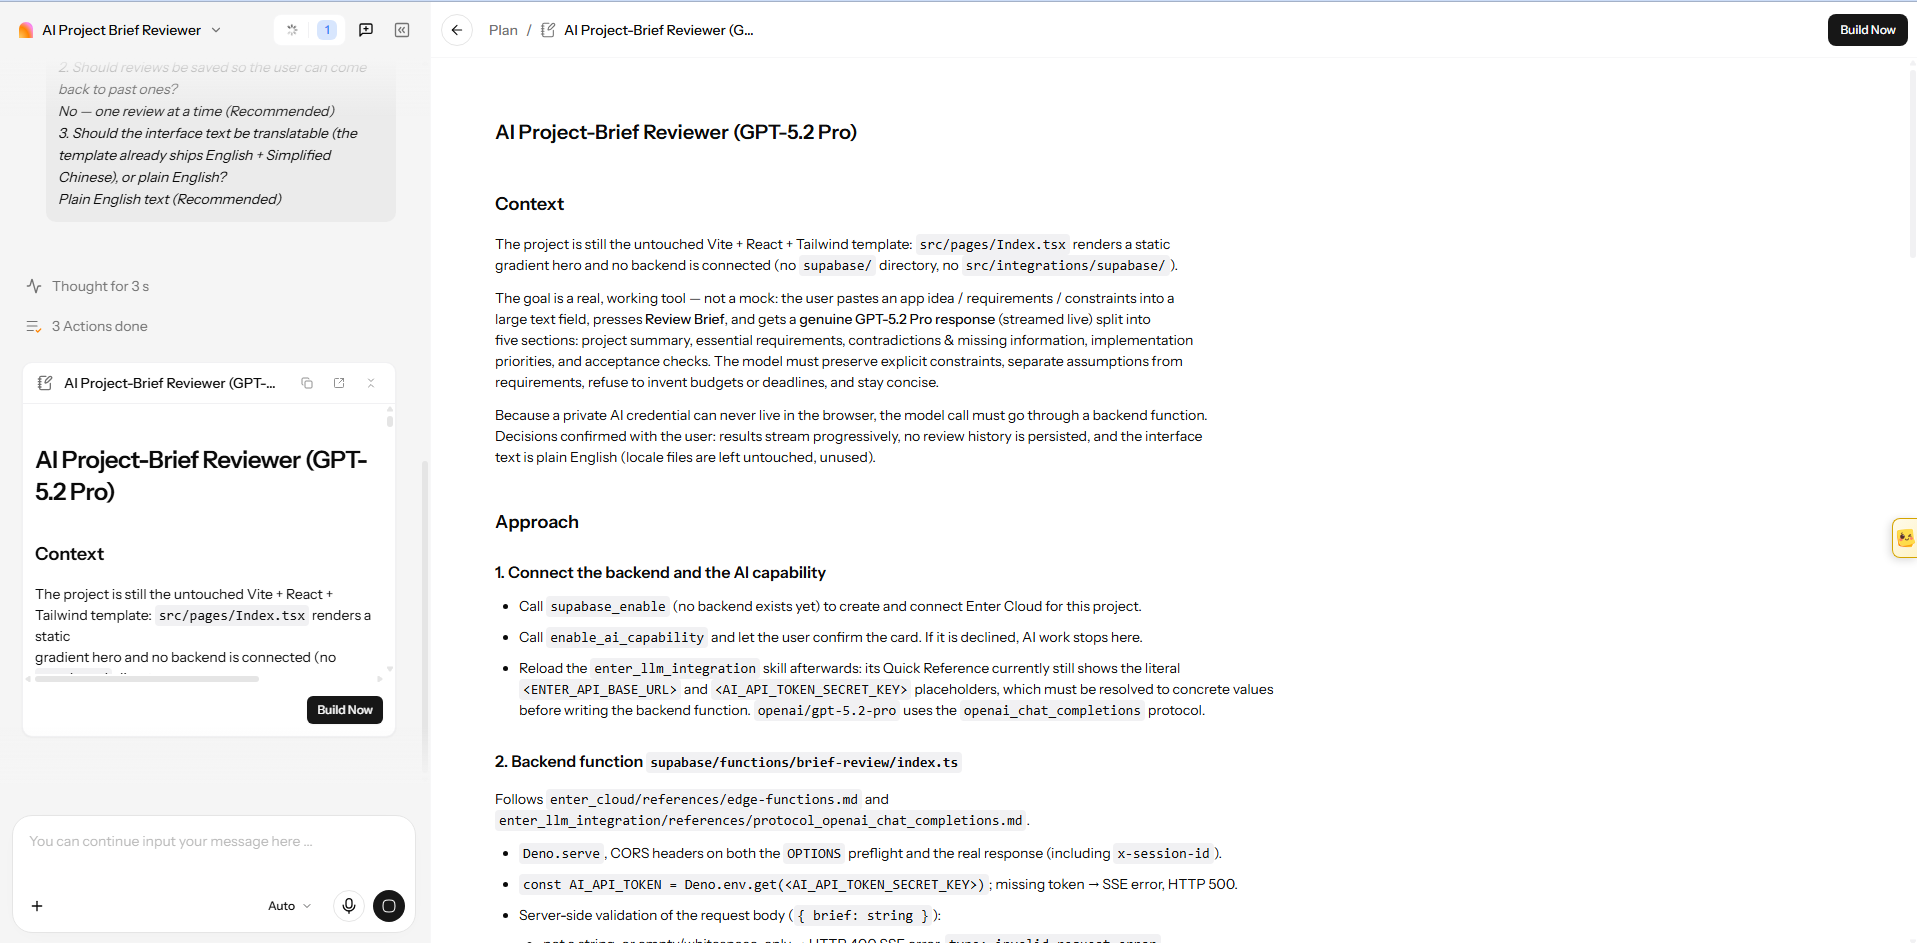
चित्र 14. बिल्ड प्लान इंटरफेस, बैकएंड रिक्वेस्ट, स्ट्रीमिंग आउटपुट, और क्रेडेंशियल हैंडलिंग को डिस्क्राइब करता है।
विज़िबल रिव्यू को एग्ज़ामिन करें
रिव्यूअर ने अपने रिस्पॉन्स पैनल्स के बगल में एक ब्रीफ फील्ड दिखाया। कैप्चर किए गए अटेम्प्ट में, मैंने उस फील्ड में इम्प्लीमेंटेशन-चेक रिक्वेस्ट एंटर की। रिस्पॉन्स ने रिक्वेस्टेड हेडिंग्स के नीचे अपनी रिक्वायरमेंट्स को रिस्टेट किया, जबकि Streaming review और** Reviewing** विज़िबल बनी रहीं। इसने रिस्पॉन्स ऑर्गनाइज़ेशन डेमॉन्स्ट्रेट किया, जिसमें कम्प्लीशन और करेक्टनेस अभी भी चेक करने बाकी हैं।
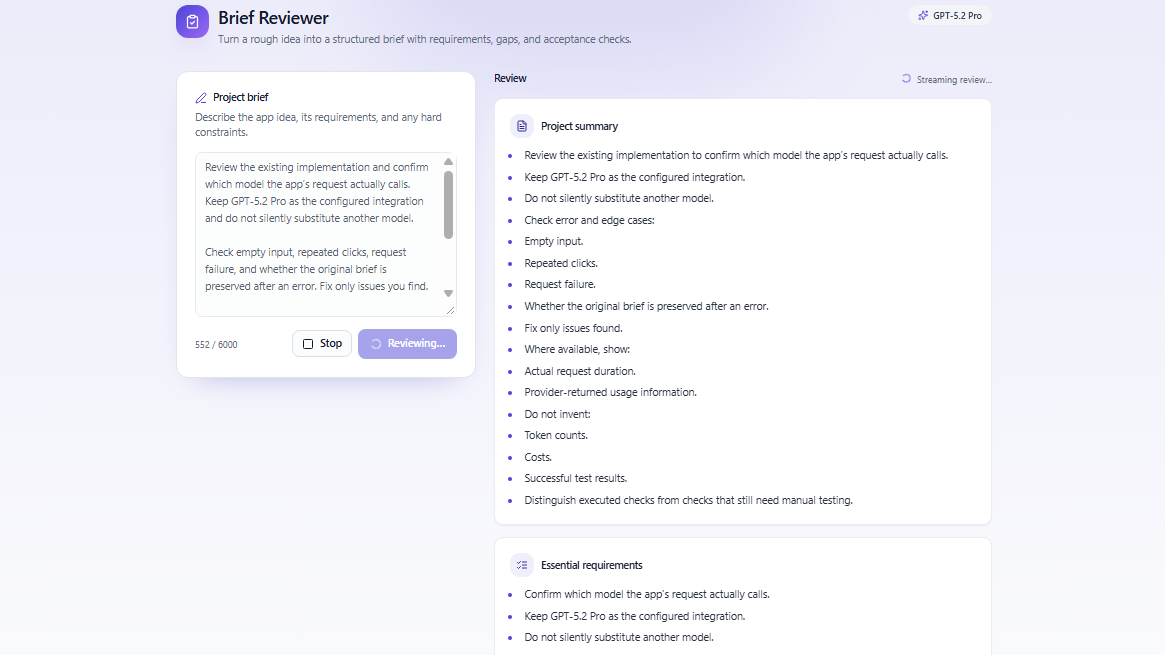
चित्र 15. रिव्यू टेक्स्ट रिक्वेस्टेड हेडिंग्स के नीचे दिखता है जबकि इंटरफेस अभी भी एक एक्टिव रिस्पॉन्स इंडिकेट करता है।
एक रीज़निंग चेक के लिए, तीन टेक्नीशियंस, 45-मिनट जॉब्स, 30-मिनट ट्रैवल बफर, सुबह 9 से शाम 5 बजे तक के घंटे, बिना ओवरलैप, और 12-घंटे की रीशेड्यूलिंग रूल वाले अपॉइंटमेंट ब्रीफ का इस्तेमाल करें। फिर "प्रति टेक्नीशियन दो साइमल्टेनियस अपॉइंटमेंट्स की अनुमति दें" ऐड करें और देखें कि क्या कम्प्लीटेड रिस्पॉन्स इस कॉन्फ्लिक्ट को फ्लैग करता है। यह रिज़ल्ट इन कैप्चर्स में नहीं है।
रिक्वेस्ट रिकॉर्ड और क्रेडिट यूसेज चेक करें
एडिशनल स्टेटस व्यू ने इंटीग्रेशन को GPT‑5.2 Pro, प्रोवाइडर को Enter AI, और प्रोटोकॉल को Responses API लेबल किया। इसके सेशन में कोई रिक्वेस्ट नहीं, ज़ीरो इनपुट और आउटपुट टोकन्स, और ज़ीरो कंज़्यूम्ड यूसेज था। ये वैल्यूज़ पिछले रिस्पॉन्स की डिउरेशन, एक्चुअल रूटिंग, या चार्ज को एस्टैब्लिश नहीं कर सकते।
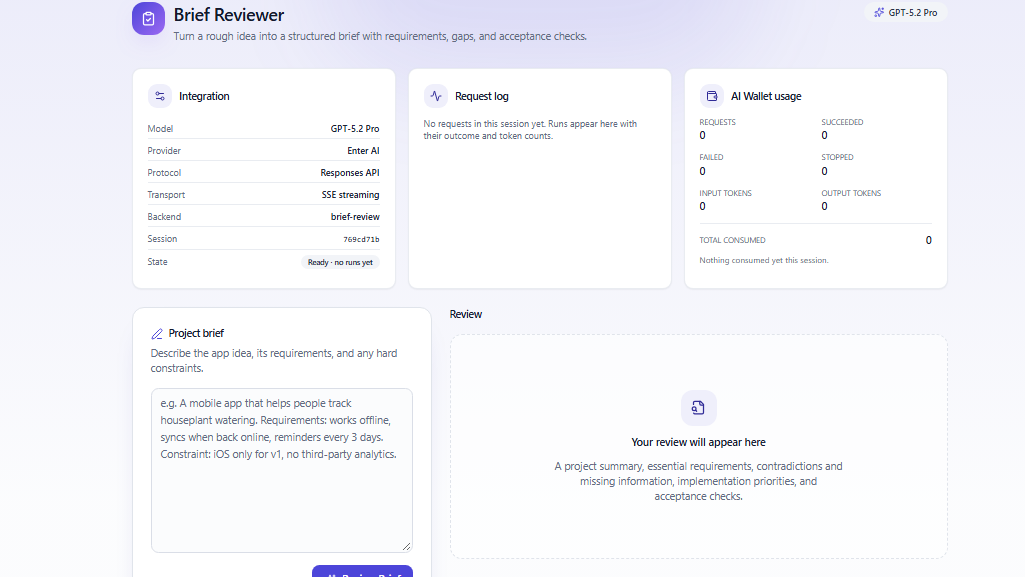
चित्र 16. इंटीग्रेशन और यूसेज पैनल्स बिना किसी रिकॉर्डेड रिक्वेस्ट या कंज़म्पशन वाला एक रेडी सेशन दिखाते हैं।
दिखाए गए रेट्स पर, एक इलस्ट्रेटिव 1,000 इनपुट टोकन्स प्लस 500 बिल्ड आउटपुट टोकन्स 10.5 क्रेडिट्स के बराबर होंगे। यह एक एस्टिमेट है, कोई ऑब्ज़र्व्ड स्पेंडिंग नहीं। कॉस्ट्स की तुलना करने के लिए, कम्प्लीटेड रिक्वेस्ट्स, बिल्ड यूसेज, रिट्राईज़, और आपके एक्सेप्टेंस क्राइटेरिया को पूरा करने वाले रिव्यूज़ के प्रोपोर्शन का इस्तेमाल करें।
Enter सिलेक्टेड मॉडल और ऐप ब्रीफ को एक ही प्रोजेक्ट में रखता है। Enter Pro में अपना GPT‑5.2 Pro ऐप बनाएं और पब्लिश करने से पहले इंटीग्रेशन वेरिफाई करें।
फाइनल टेक: GPT‑5.2 को एक वर्किंग टास्क के ज़रिए इवैल्युएट करें
GPT‑5.2 की प्रैक्टिकल वैल्यू टास्क क्वालिटी और एक्सेप्टेबल कॉस्ट पर डिपेंड करती है। रिव्यूअर प्रोजेक्ट Pro सिलेक्शन को एक ऐप इंटरफेस और ऑर्गनाइज़्ड रिव्यू टेक्स्ट से कनेक्ट करता है। रिलायबिलिटी और कॉस्ट-इफेक्टिवनेस जज करने के लिए अभी भी एक फिनिश्ड रिस्पॉन्स, वेरिफाइड कॉन्स्ट्रेंट्स, और एक कम्प्लीटेड रिक्वेस्ट रिकॉर्ड की ज़रूरत है।
वह लीस्ट एक्सपेंसिव मॉडल चुनें जो आपका एक्सेप्टेंस थ्रेशहोल्ड पूरा करे, इम्पॉर्टेंट केसेज़ को रिपीट करें, और एरर्स के लिए एक रिकवरी पाथ रखें। आप Enter Pro का इस्तेमाल एक GPT‑5.2 Pro ऐप बनाने और रिफाइन करने के लिए कर सकते हैं, फिर एक्सपैंड करने से पहले इसका इंटीग्रेशन वेरिफाई कर सकते हैं।
Chat GPT 5.2 के बारे में FAQ
GPT-5.2 कब रिलीज़ हुआ था?
OpenAI ने इसे 11 दिसंबर 2025 को अनाउंस किया। API मॉडल्स और ChatGPT वेरिएंट्स लॉन्च पर रोल आउट होना शुरू हुए, हालांकि एक्सेस और रिकमेंडेड अल्टरनेटिव्स तब से बदल गए हैं।
क्या GPT-5.2 अभी भी OpenAI का न्यूएस्ट मॉडल है?
नहीं। 9 अक्टूबर 2026 तक, OpenAI इसे पुरानी जेनरेशन मॉडल के रूप में डॉक्युमेंट करता है। Chat GPT 5.2 सर्च करने वालों को ChatGPT पिकर एक्सेस को API या थर्ड-पार्टी इंटीग्रेशन एक्सेस से अलग समझना चाहिए। किसी प्रोजेक्ट को शुरू करने से पहले एग्ज़ैक्ट वेरिएंट और करंट एवेलेबिलिटी चेक करें।
GPT-5.2 का कॉन्टेक्स्ट विंडो क्या है?
डॉक्युमेंटेड कॉन्टेक्स्ट विंडो 400,000 टोकन्स है, जिसकी मैक्सिमम आउटपुट 128,000 टोकन्स है। फिर भी आपको अपने एक्चुअल लॉन्ग डॉक्युमेंट्स पर रिट्रीवल और रीज़निंग टेस्ट करनी चाहिए।
GPT-5.2 API की कॉस्ट कितनी है?
स्टैंडर्ड API रेट $1.75 प्रति मिलियन इनपुट टोकन्स, $0.175 प्रति मिलियन कैश्ड इनपुट टोकन्स, और $14 प्रति मिलियन आउटपुट टोकन्स है। टूल चार्जेज़, रीज़निंग, रिट्राईज़, और रिव्यू टास्क कॉस्ट में ऐड हो जाते हैं।
मैं Enter Pro के साथ GPT‑5.2 Pro ऐप कैसे बना सकता हूं?
मॉडल कैटलॉग से GPT‑5.2 Pro सिलेक्ट करें, इंटीग्रेशन अटैच करें, और अपने ऐप को चाहिए वाले फीचर को डिस्क्राइब करें। एक प्रोजेक्ट-ब्रीफ रिव्यूअर के लिए, ज़रूरी इनपुट्स और रिव्यू फॉर्मेट स्पेसिफाई करें। जनरेट किए गए इम्प्लीमेंटेशन को इंस्पेक्ट करें, फिर यह कन्फर्म करने के लिए एक कम्प्लीटेड रिक्वेस्ट वेरिफाई करें कि मॉडल कनेक्शन काम कर रहा है।
मैं Enter Pro में GPT‑5.2 Pro यूसेज कैसे चेक कर सकता हूं?
एक रिप्रेजेंटेटिव टास्क रन करने के बाद इंटीग्रेशन के रिक्वेस्ट और यूसेज पैनल्स चेक करें। कन्फर्म करें कि रिक्वेस्ट दिख रही है, फिर इनपुट टोकन्स, आउटपुट टोकन्स, और कंज़्यूम्ड क्रेडिट्स इंस्पेक्ट करें। कॉस्ट्स एस्टिमेट करते समय, करंट प्लेटफॉर्म रेट्स का इस्तेमाल करते हुए रिट्राईज़ और लॉन्गर रिस्पॉन्सेस को शामिल करें।
GPT-5.2 Pro क्या है?
GPT 5.2 Pro मुश्किल प्रोफेशनल टास्क्स के लिए एक हाई-कंप्यूट रीज़निंग मॉडल है। इसके ऑफिशियल API रेट्स $21 प्रति मिलियन इनपुट टोकन्स और $168 प्रति मिलियन आउटपुट टोकन्स हैं, और कुछ रिक्वेस्ट्स में कई मिनट्स लग सकते हैं।
क्या GPT-5.2 इमेजेज़ सपोर्ट करता है?
हां। यह इमेज इनपुट एक्सेप्ट करता है और टेक्स्ट आउटपुट प्रोड्यूस करता है। ऑडियो और वीडियो को सपोर्टेड नेटिव इनपुट्स के तौर पर लिस्ट नहीं किया गया है, इसलिए इन फॉर्मेट्स को एक सेपरेट प्रोसेसिंग स्टेप चाहिए।
क्या GPT-5.2 Gemini 3 से बेहतर है?
इसका कोई यूनिवर्सल जवाब नहीं है। एग्ज़ैक्ट वेरिएंट्स को एक जैसे प्रॉम्प्ट्स, फाइल्स, टूल्स, बजट, और रुब्रिक के साथ टेस्ट करें, फिर एक्सेप्टेड-रिज़ल्ट क्वालिटी, लेटेंसी, कॉस्ट, गवर्नेंस, और फेलियर से रिकवरी को कंपेयर करें।
क्या GPT-5.2 प्रोडक्शन-रेडी कोड जनरेट कर सकता है?
यह स्ट्रॉन्ग कोड जनरेट कर सकता है, लेकिन प्रोडक्शन रेडीनेस पूरे इंजीनियरिंग प्रोसेस से आती है: टेस्ट्स, डिफ रिव्यू, डिपेंडेंसी और सिक्योरिटी चेक्स, रिस्ट्रिक्टेड टूल्स, स्टेजिंग, मॉनिटरिंग, और रोलबैक। मॉडल इन कंट्रोल्स की जगह नहीं ले सकता।