GPT-5.2 Dijelaskan: Fitur, Benchmark, Harga, dan Use Case
Kenali GPT-5.2 Instant, Thinking, Pro, dan Codex — mulai dari harga, benchmark, akses, batasan, hingga perbandingannya dengan Gemini 3 untuk developer di 2026.
Gambar 1. GPT-5.2 dinilai dari sisi kualitas, kecepatan, biaya, dan kontrol
Saya memilih GPT‑5.2 Pro di Enter Pro untuk membangun reviewer brief proyek yang mengubah ide aplikasi menjadi daftar requirement dan kriteria penerimaan. Tangkapan layar berikut menunjukkan proses setup dan hasil review-nya; verifikasi request yang benar-benar selesai masih menjadi langkah terbuka.
Studi kasus praktis ini memberi titik acuan konkret untuk panduan ini. Saya memisahkan hasil benchmark resmi dari apa yang benar-benar terlihat dilakukan aplikasi, lalu menelusuri kemampuan, harga, dan batasan dari keluarga model ini. Anda perlu memastikan varian yang tepat sebelum menerapkan suatu temuan ke Instant, Thinking, Pro, atau Codex.
OpenAI memperkenalkan keluarga model ini pada 11 Desember 2025 sebagai rilis untuk pekerjaan profesional dan agen yang berjalan lama. Laporan peluncurannya menjadi acuan resmi untuk benchmark dan harga. Saya menggunakan laporan tersebut bersama informasi routing terbaru, kritik independen yang tajam, serta laporan komunitas — karena tidak ada satu sumber pun yang mencakup performa terkontrol sekaligus friksi penggunaan sehari-hari.
Orang yang mencari Chat GPT 5.2 biasanya memaksudkan seluruh keluarga model Desember 2025, tapi perbedaan antara mode ChatGPT dan ID model API sangat penting. Hasil uji pada Instant tidak bisa dijadikan patokan perilaku, harga, atau latensi Thinking, Pro, maupun model khusus coding.
GPT-5.2 Sekilas
Per 9 Oktober 2026, OpenAI mencantumkan GPT‑5.2 dan GPT‑5.2 Pro sebagai opsi generasi sebelumnya. Proyek yang sudah berjalan mungkin tetap menghargai perilaku yang sudah dikenal dan snapshot yang terkunci (pinned), sementara proyek baru sebaiknya membandingkan model yang saat ini direkomendasikan dengan kriteria penerimaan yang sama.
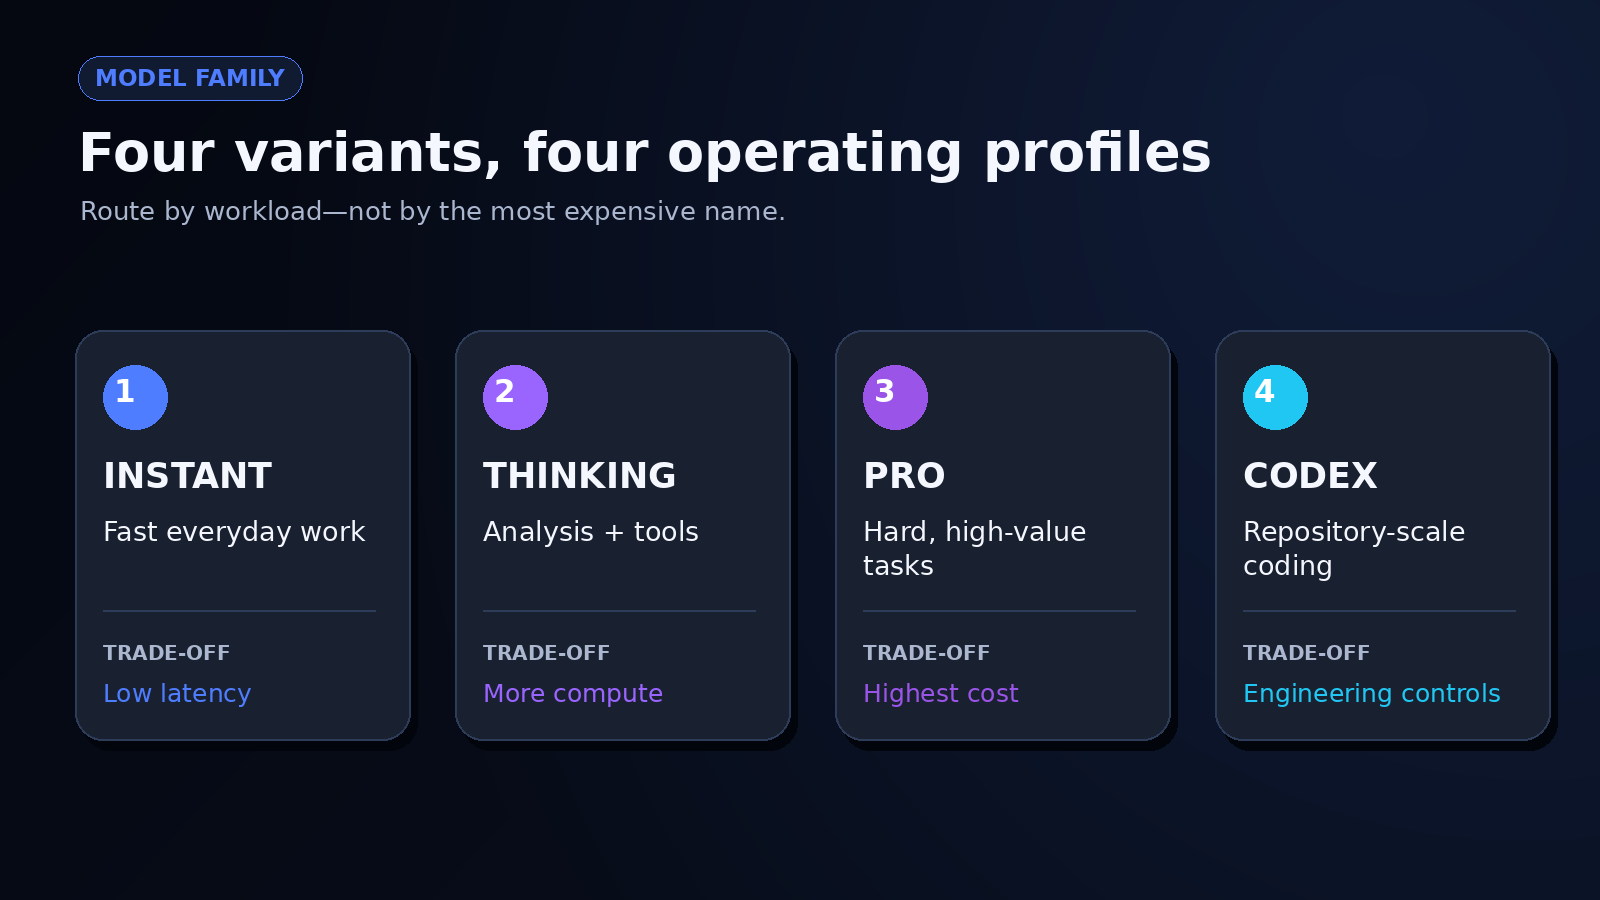
Gambar 2. Instant, Thinking, Pro, dan Codex dipetakan ke jenis-jenis beban kerja
| Spesifikasi | GPT-5.2 | GPT-5.2 Pro |
|---|---|---|
| Posisi saat ini | Flagship generasi sebelumnya | Model Pro generasi sebelumnya |
| Context window | 400.000 token | 400.000 token |
| Output maksimum | 128.000 token | 128.000 token |
| Batas pengetahuan (knowledge cutoff) | 31 Agustus 2025 | 31 Agustus 2025 |
| Modalitas | Input/output teks; input gambar | Input/output teks; input gambar |
| Tingkat reasoning | none, low, medium, high, xhigh | medium, high, xhigh |
| Harga API per 1M token | $1,75 input; $0,175 cached; $14 output | $21 input; $168 output |
| Structured output | Didukung | Tidak didukung |
| Fine-tuning | Tidak didukung | Tidak didukung |
| Snapshot | gpt-5.2-2025-12-11 | gpt-5.2-pro-2025-12-11 |
Status, Context, dan Modalitas Saat Ini
Context window 400.000 token dan batas output 128.000 token memang sangat besar, tapi kapasitas bukan berarti daya ingat (recall) yang sempurna. Jika Anda memasukkan kontrak, log, screenshot, dan requirement ke satu request, Anda tetap perlu melakukan uji retrieval: tanamkan fakta di posisi yang berbeda-beda, ajukan pertanyaan yang memaksa model menggabungkan fakta-fakta itu, lalu catat bagian yang terlewat. Saya tidak akan menyimpulkan kemampuan reasoning dokumen panjang hanya dari besarnya angka context window.
Model-model ini menerima gambar dan menghasilkan teks; mereka tidak menerima audio atau video sebagai input native. Artinya model ini berguna untuk chart, screenshot interface, diagram, dan dokumen hasil scan — asal Anda tetap memverifikasi detail spasial dan nilai yang diekstraksi. Label yang buram atau skala chart yang tidak biasa bisa mengubah penjelasan yang terdengar percaya diri menjadi kesalahan yang terlihat meyakinkan.
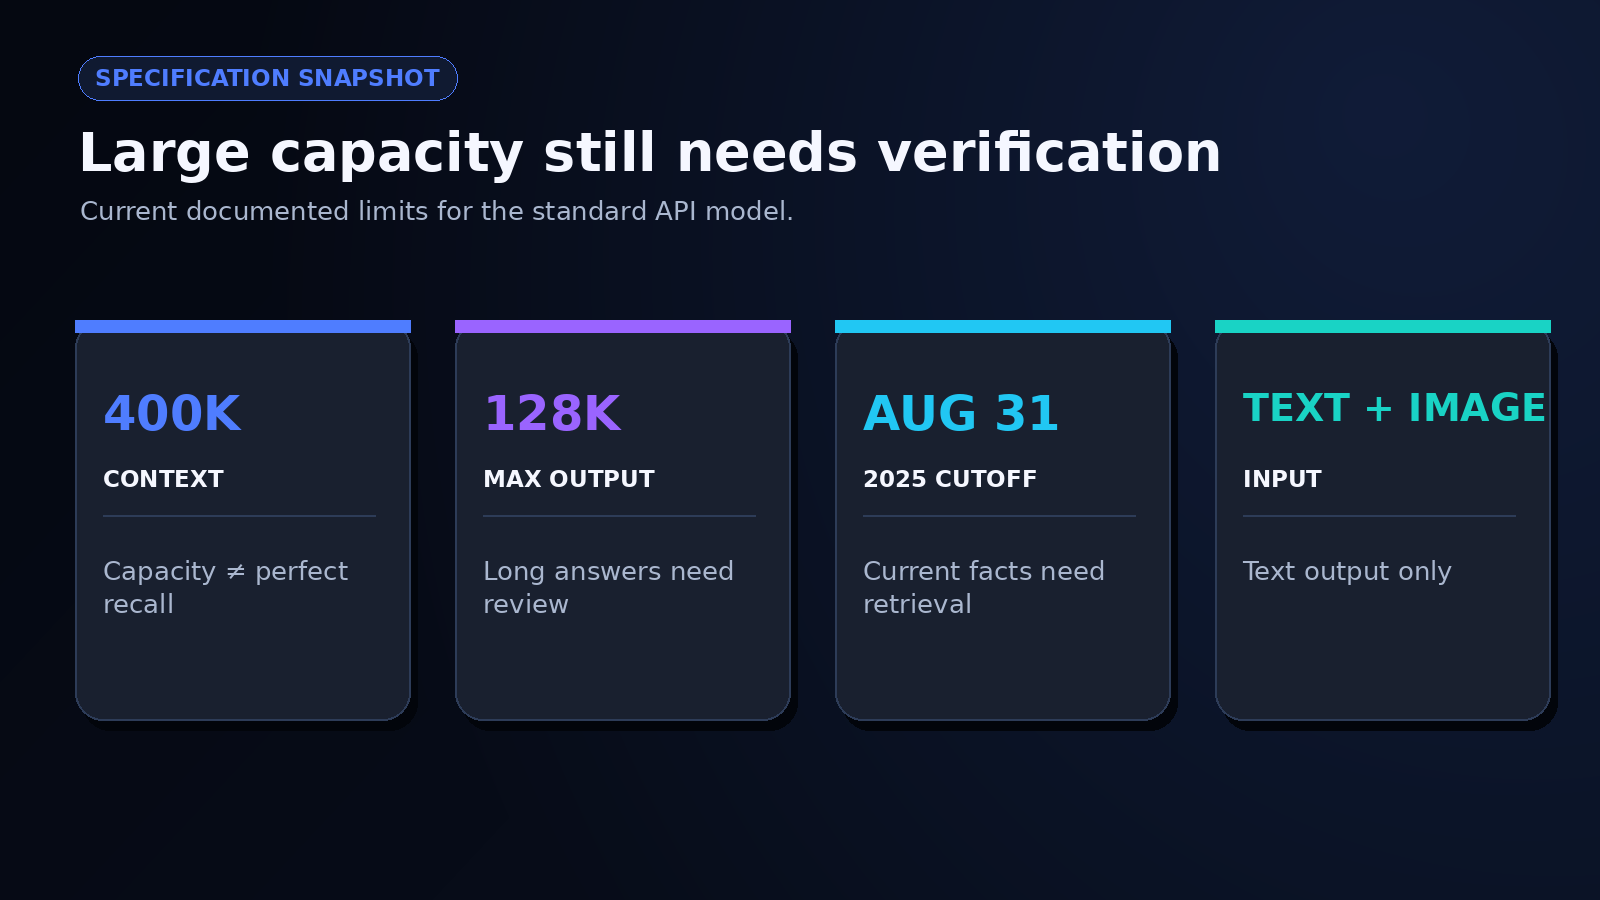
Gambar 3. context, output, modalitas, cutoff, dan snapshot
Harga dan Akses API
Model API standar dibanderol $1,75 per juta token input, $0,175 per juta token input yang di-cache, dan $14 per juta token output. GPT 5.2 Pro dibanderol $21 untuk input dan $168 untuk output. Token reasoning, retry, pemanggilan tool, dan koreksi manual ikut memengaruhi biaya dari satu hasil yang diterima. Jika menggunakan platform integrasi, periksa satuan billing-nya secara terpisah sebelum dibandingkan dengan tarif dolar OpenAI.
Anda bisa melihat routing dan ketersediaan provider terkini di halaman GPT‑5.2 di OpenRouter. Saya akan menghitung biaya per task yang berhasil diselesaikan, bukan biaya per request. Respons yang lebih murah tapi gagal validasi dua kali bisa jadi lebih mahal dibanding respons berharga lebih tinggi yang langsung lolos di percobaan pertama.
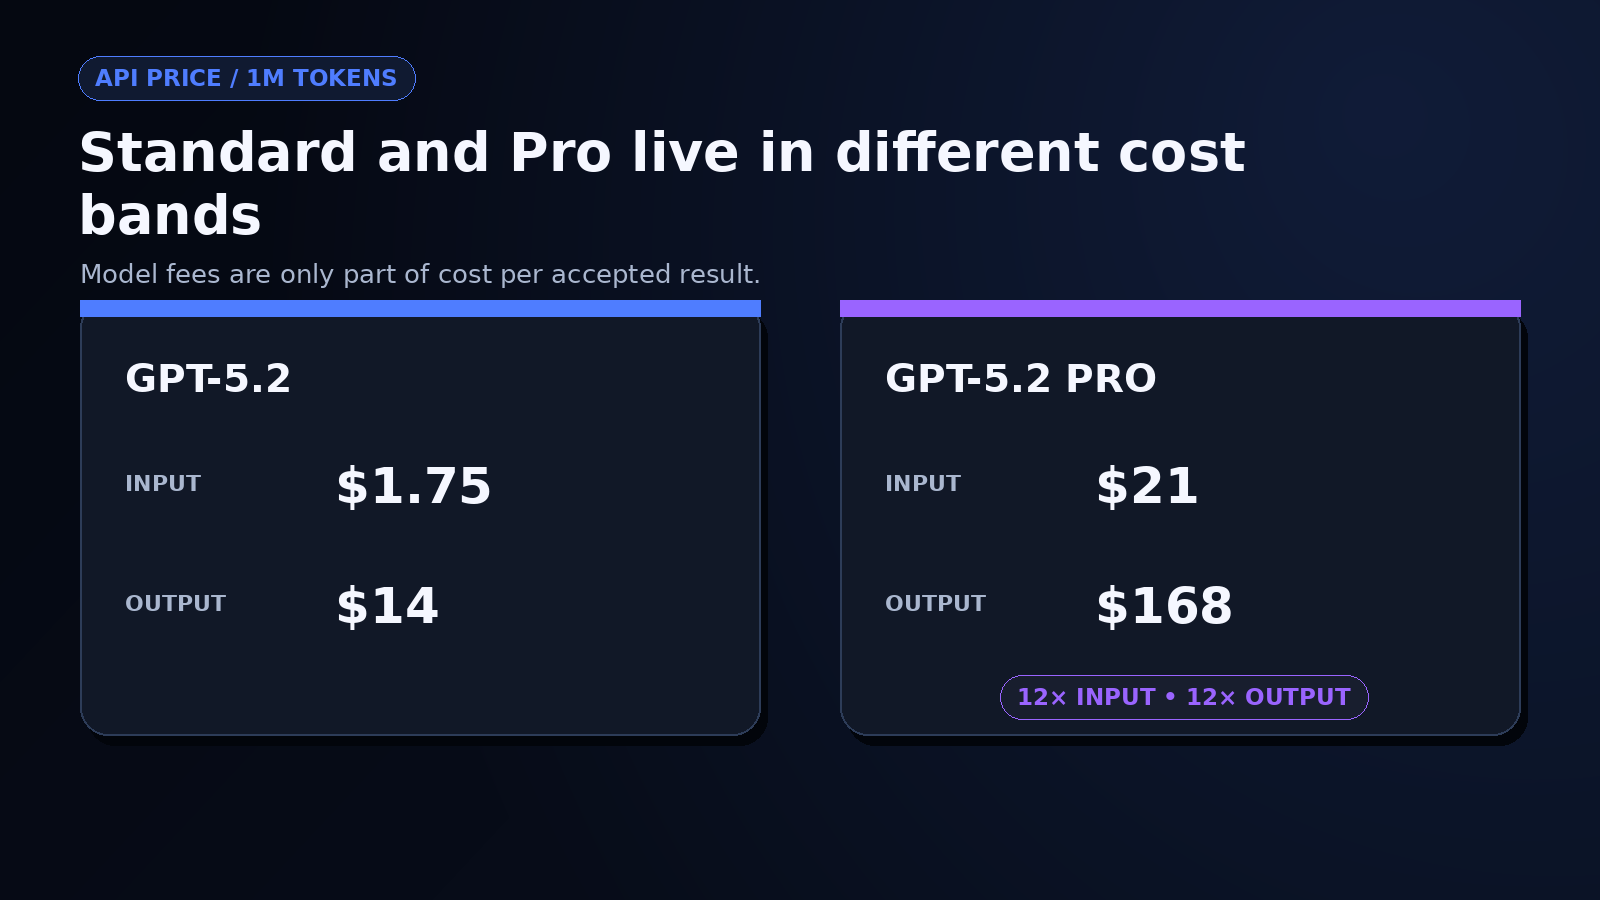
Gambar 4. perbandingan biaya per juta token, standar versus Pro
Apa yang Berubah pada Rilis OpenAI GPT-5.2?
Rilis OpenAI GPT-5.2 ditujukan untuk pekerjaan yang berlanjut melampaui satu jawaban saja: membangun artifact, memeriksa dokumen panjang, menggunakan tool, menulis dan mereview kode, melakukan reasoning atas gambar, serta menyelesaikan tugas profesional multi-langkah. Rilis ini juga memisahkan chat cepat, reasoning yang lebih dalam, dan pekerjaan berkomputasi tinggi secara lebih jelas daripada yang tersirat dari satu label model.
Instant, Thinking, dan Pro Menyasar Beban Kerja yang Berbeda
Instant mengutamakan pertanyaan sehari-hari, penjelasan, terjemahan, dan draft cepat. Thinking menyasar analisis, coding, file, perencanaan, dan penggunaan tool. Pro mengalokasikan lebih banyak komputasi untuk masalah sulit, di mana waktu tunggu lebih lama dan biaya API yang jauh lebih tinggi bisa dianggap sepadan.
| Mode atau model | Kecocokan praktis | Trade-off utama |
|---|---|---|
| Instant | Pertanyaan rutin dan pekerjaan yang sensitif terhadap latensi | Deliberasi lebih sedikit pada tugas multi-langkah yang sulit |
| Thinking | Analisis, coding, file panjang, dan workflow berbasis tool | Latensi dan penggunaan token lebih tinggi |
| Pro | Tugas sulit di mana peningkatan kualitas bernilai tinggi | Biaya sangat tinggi; respons bisa butuh beberapa menit |
Saya akan melakukan routing berdasarkan risiko, bukan gengsi. Tahap klasifikasi mungkin cukup dengan model cepat dan skema yang ketat. Review model finansial mungkin memang membutuhkan reasoning yang lebih dalam. Jika setiap request dikirim ke Pro, Anda jadi tidak tahu task mana yang benar-benar diuntungkan oleh komputasi ekstra tersebut, dan kontrol biaya jadi jauh lebih sulit.
Pekerjaan Profesional dan Penggunaan Tool Menjadi Sorotan Utama Peluncuran
OpenAI menekankan spreadsheet, presentasi, pekerjaan front-end, code review, analisis dokumen, sains, matematika, dan pemanggilan tool. Dalam evaluasi internal vendor terhadap query ChatGPT yang sudah dianonimkan, error di level respons dilaporkan 30% lebih sedikit secara relatif dibanding GPT‑5.1 Thinking. Rilis ini juga mencatat bahwa penilaian error dilakukan oleh model lain, sehingga saya membaca angka tersebut sebagai indikasi arah, bukan garansi independen.
Peningkatan praktisnya bukan berarti "model ini tahu segalanya". Melainkan, ada kemungkinan lebih besar bahwa task yang spesifikasinya jelas bisa bertahan melewati beberapa langkah tanpa kehilangan strukturnya. Anda tetap perlu checkpoint yang bisa diamati: tool mana yang berjalan, data apa yang diterimanya, apa yang diubahnya, dan bagaimana workflow pulih setelah pemanggilan yang gagal.
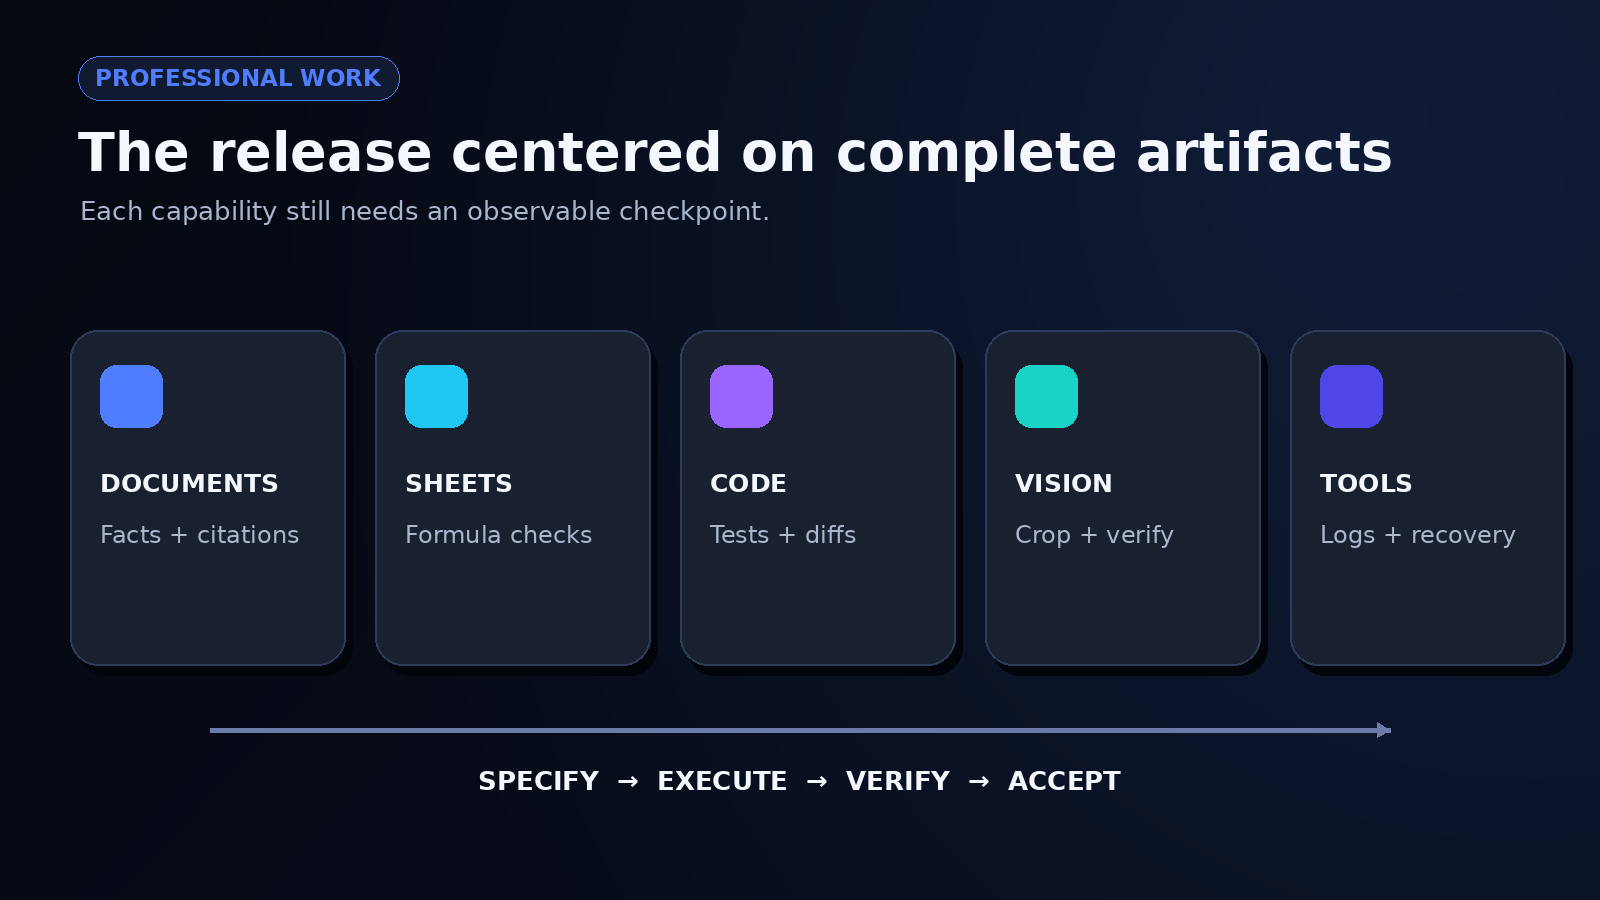
Gambar 5. panel spreadsheet, kode, dokumen, gambar, dan pemanggilan tool
Benchmark Peluncuran Menunjukkan Kekuatan yang Luas tapi Tidak Merata
| Benchmark | GPT-5.2 Thinking | Apa yang diukur |
|---|---|---|
| GDPval wins or ties | 70,9% | Task profesional dengan spesifikasi jelas di 44 profesi |
| SWE-Bench Pro public | 55,6% | Task software engineering multi-bahasa |
| SWE-bench Verified | 80,0% | Task repositori Python yang terverifikasi |
| GPQA Diamond | 92,4% | Pertanyaan sains tingkat pascasarjana tanpa tool |
| AIME 2025 | 100,0% | Matematika kompetisi tanpa tool |
| ARC-AGI-2 Verified | 52,9% | Task reasoning abstrak yang baru/belum pernah dilihat |
Bagian yang paling berguna adalah rentangnya. Ini menunjukkan hasil yang kuat tanpa menyiratkan penguasaan yang seragam di semua bidang. Skor 80% pada soal Python terverifikasi tidak memprediksi pass rate Anda pada monorepo TypeScript dengan aturan deployment khusus. Begitu pula, benchmark sains tidak membuktikan penilaian hukum atau medis yang bisa diandalkan.
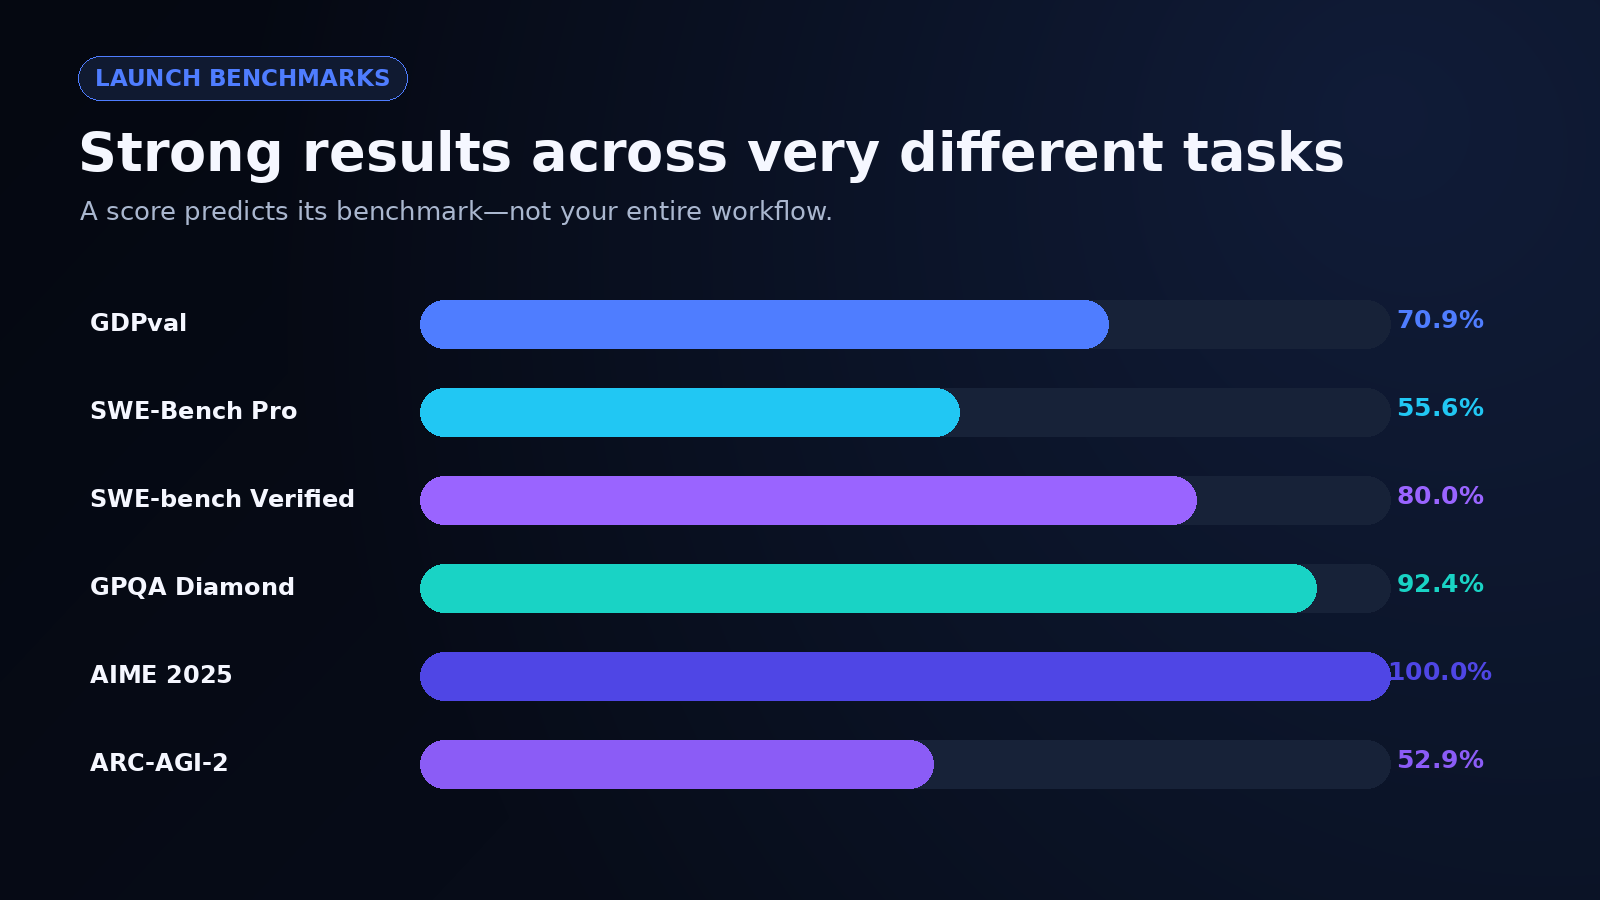
Gambar 6. enam skor peluncuran dengan kategori task-nya
Bacalah Benchmark GPT-5.2 Bersamaan dengan Batasannya
Skor publik memadatkan banyak pilihan menjadi satu angka: format prompt, tool, tingkat reasoning, seleksi test, perilaku grader, dan kebijakan retry. Workflow produksi Anda menambahkan kualitas data, izin akses, batas latensi, dan review manusia. Saya merasa benchmark paling berguna untuk menentukan apa yang perlu diuji — bukan untuk melewatkan pengujian itu sendiri.
Apa yang Sebenarnya Ditunjukkan oleh Review Aplikasi Saya
Reviewer brief proyek menampilkan instruksi yang dimasukkan di bawah "Project summary" dan "Essential requirements" saat respons masih streaming. Input-nya meminta pemeriksaan implementasi, tapi hasil yang terlihat justru mengorganisir permintaan itu sebagai brief. Hasil tersebut tidak melaporkan pemeriksaan kode yang sudah selesai atau hasil test.
Tampilan sesi terpisah tidak mencatat adanya request atau penggunaan apa pun, sehingga waktu respons, routing, dan biaya belum bisa diverifikasi. Perlu menyelesaikan satu request dengan brief yang dibatasi untuk menuntaskan pemeriksaan ini.
Skor Benchmark Bukan Garansi Produksi
Mulailah dengan 20 hingga 50 task yang representatif, dan tentukan kriteria penerimaan sebelum menjalankannya. Untuk kode, itu bisa berupa pass rate test, ukuran diff, temuan keamanan, dan keamanan rollback. Untuk pekerjaan dokumen, bisa berupa akurasi faktual, kelengkapan sitasi, kesalahan kalkulasi, dan waktu editing. Jalankan set yang sama lebih dari sekali karena variansnya penting.
Lalu ukur biaya per hasil yang diterima. Misalnya satu model berbiaya $0,18 per run dan lolos 60% kasus, sementara model lain berbiaya $0,28 dan lolos 90%. Sebelum memperhitungkan koreksi manual, biaya yang diperkirakan per hasil yang diterima adalah $0,30 dan sekitar $0,31. Setelah Anda memasukkan harga waktu review, model kedua bisa jadi jelas lebih murah — atau tidak. Perhitungan ini memaksa keputusan kembali ke workflow Anda sendiri.
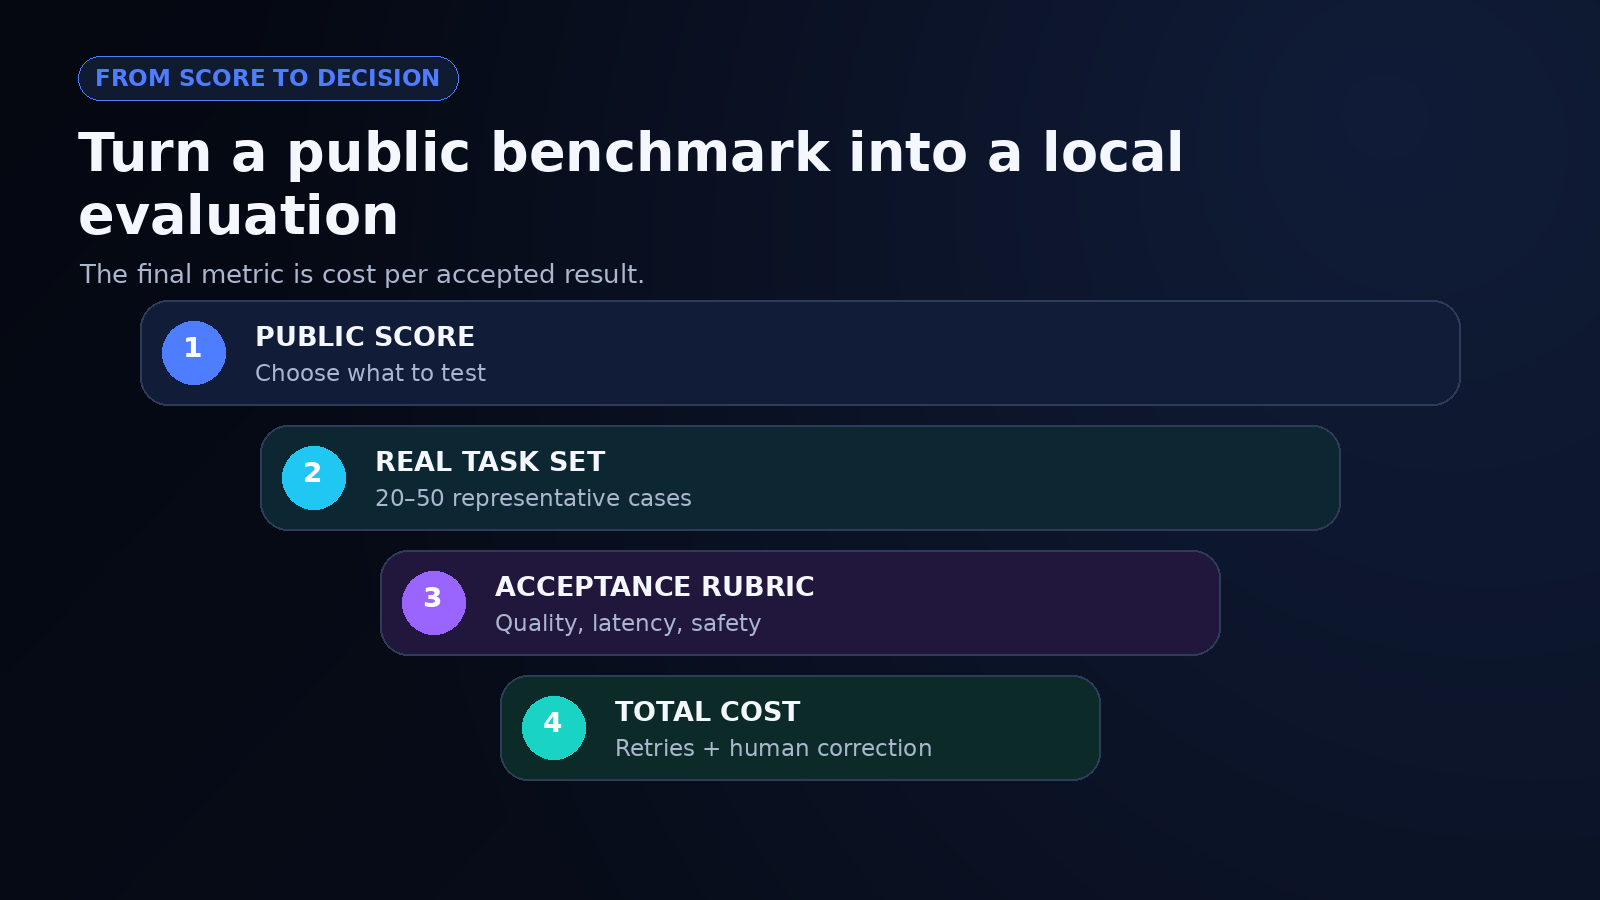
Gambar 7. dari skor benchmark ke task representatif ke biaya hasil yang diterima
Context Panjang dan Input Gambar Tetap Perlu Diverifikasi
Context window yang panjang bisa mengurangi kebutuhan chunking, tapi juga membuat bagian yang terlewat lebih sulit disadari. Saya akan menguji retrieval dari awal, tengah, dan akhir sekumpulan file; mewajibkan kutipan atau identifier catatan untuk fakta-fakta penting; serta menjalankan ulang kalkulasi di luar model. Untuk gambar, crop bagian yang relevan dan ajukan pertanyaan secara eksplisit, jangan berharap model menebak sendiri apa yang penting.
Kritik independen juga bisa mengungkap mode kegagalan yang tidak akan ditonjolkan dalam postingan peluncuran. Satu kritik langsung dari pengalaman penggunaan menggambarkan output yang mengecewakan dalam task penulisnya. Ini tidak membantah hasil benchmark; ini menunjukkan mengapa prompt, beban kerja, dan standar penerimaan Anda sendiri harus direplikasi secara langsung.
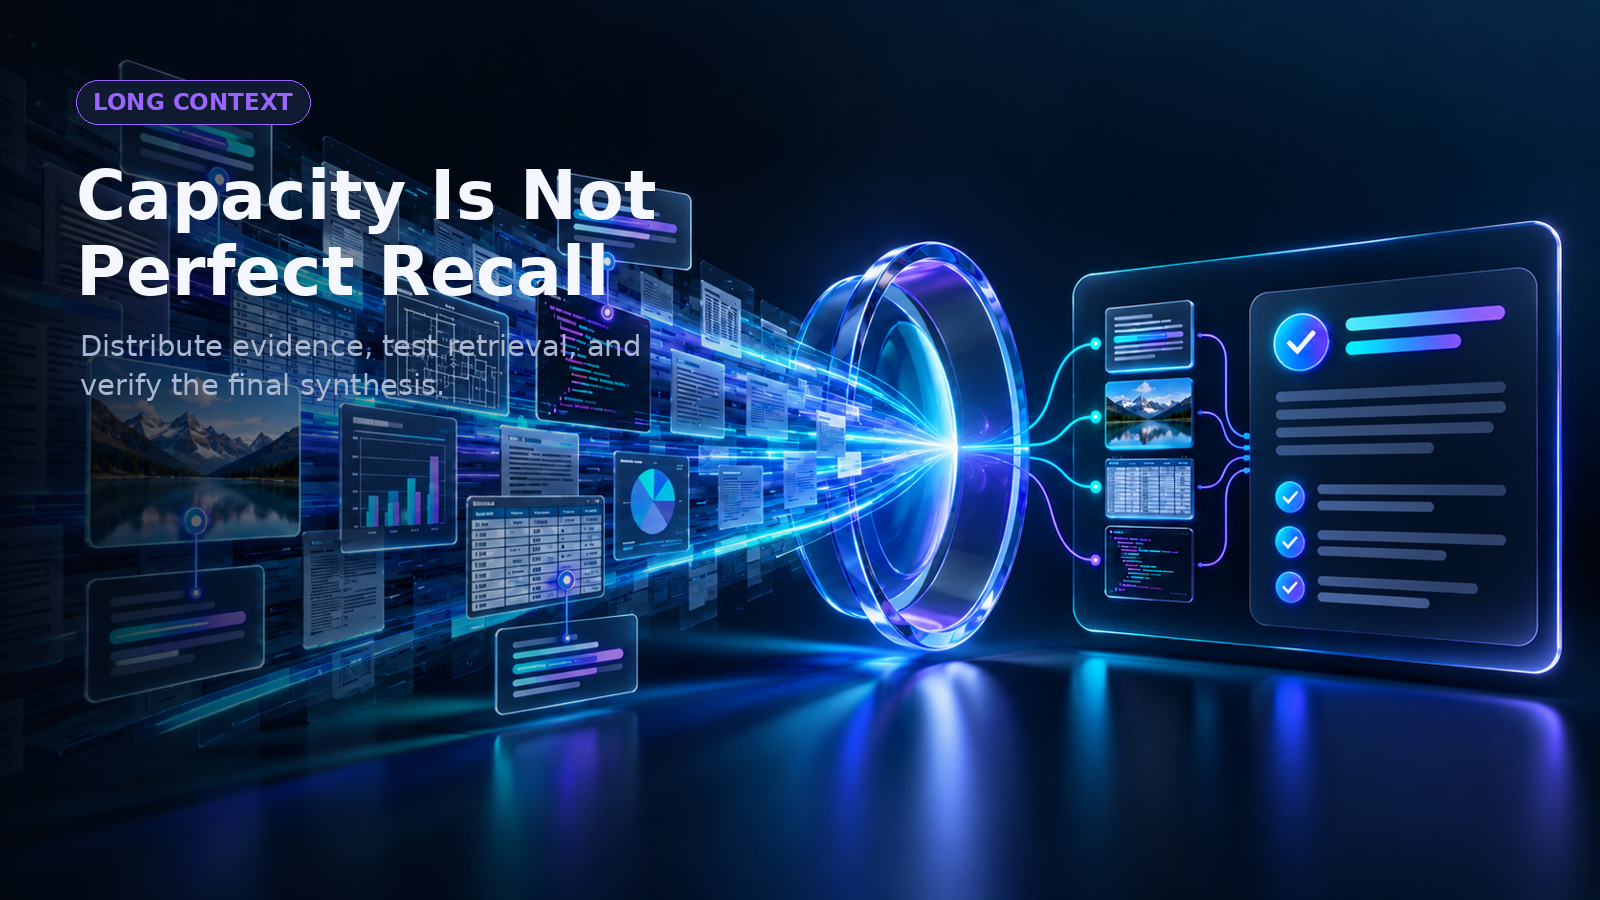
Gambar 8. bukti yang tersebar di sepanjang aliran dokumen 400K token
Pekerjaan Berisiko Tinggi Membutuhkan Pengaman Khusus Domain
Batas pengetahuan 31 Agustus 2025 berarti fakta terkini harus diambil lewat retrieval. Model-model ini tetap bisa mengarang sumber, melewatkan requirement, salah membaca screenshot, atau menghasilkan kode yang tidak aman. Mereka juga tidak mendukung fine-tuning, jadi tim yang butuh perilaku yang sangat disesuaikan harus mengandalkan prompting, retrieval, tool, validasi, atau model lain.
Anda perlu memisahkan bantuan dari otoritas keputusan. Model bisa meringkas kontrak, menandai transaksi yang mencurigakan, atau mengusulkan patch. Namun keputusan hukum, medis, finansial, keamanan, dan produksi harus dibuat oleh orang yang berkompeten atau kontrol deterministik. Catat bukti-buktinya dan jaga agar selalu ada jalur yang jelas untuk menolak atau melakukan rollback terhadap output tersebut.
Apa Itu GPT-5.2-Codex dan Bagaimana Developer Sebaiknya Menggunakannya?
GPT 5.2 Codex adalah anggota keluarga model yang dikhususkan untuk coding, dirancang untuk pekerjaan software engineering yang lebih panjang, bukan sekadar autocomplete yang berdiri sendiri. Perbedaan yang paling berguna terletak pada kedalaman workflow-nya: memahami sebuah repositori, merencanakan perubahan, mengedit beberapa file, menjalankan tool, memeriksa kegagalan, dan merevisi patch.
Task Coding yang Paling Cocok
Kandidat yang baik meliputi eksplorasi repositori, implementasi fitur, perbaikan bug, refactoring, pembuatan test, code review, dan migrasi dengan kriteria penerimaan yang eksplisit. Saya akan memberikan model tujuan terkecil yang tetap koheren tapi masih mencakup batas dependensi yang nyata. Prompt yang dibuat terlalu kecil secara artifisial bisa menghasilkan diff lokal yang rapi tapi gagal di sistem sekitarnya.
Anda bisa mengevaluasi GPT 5.2 Codex dengan satu set repositori yang bisa diulang: isu-isu yang sudah diketahui, test tersembunyi, linting, kebijakan dependensi, pemeriksaan keamanan, dan diff maksimum yang masih bisa diterima. Catat jumlah pemanggilan tool, koreksi, dan intervensi reviewer. Sebuah patch tidak otomatis berhasil hanya karena berhasil di-compile.
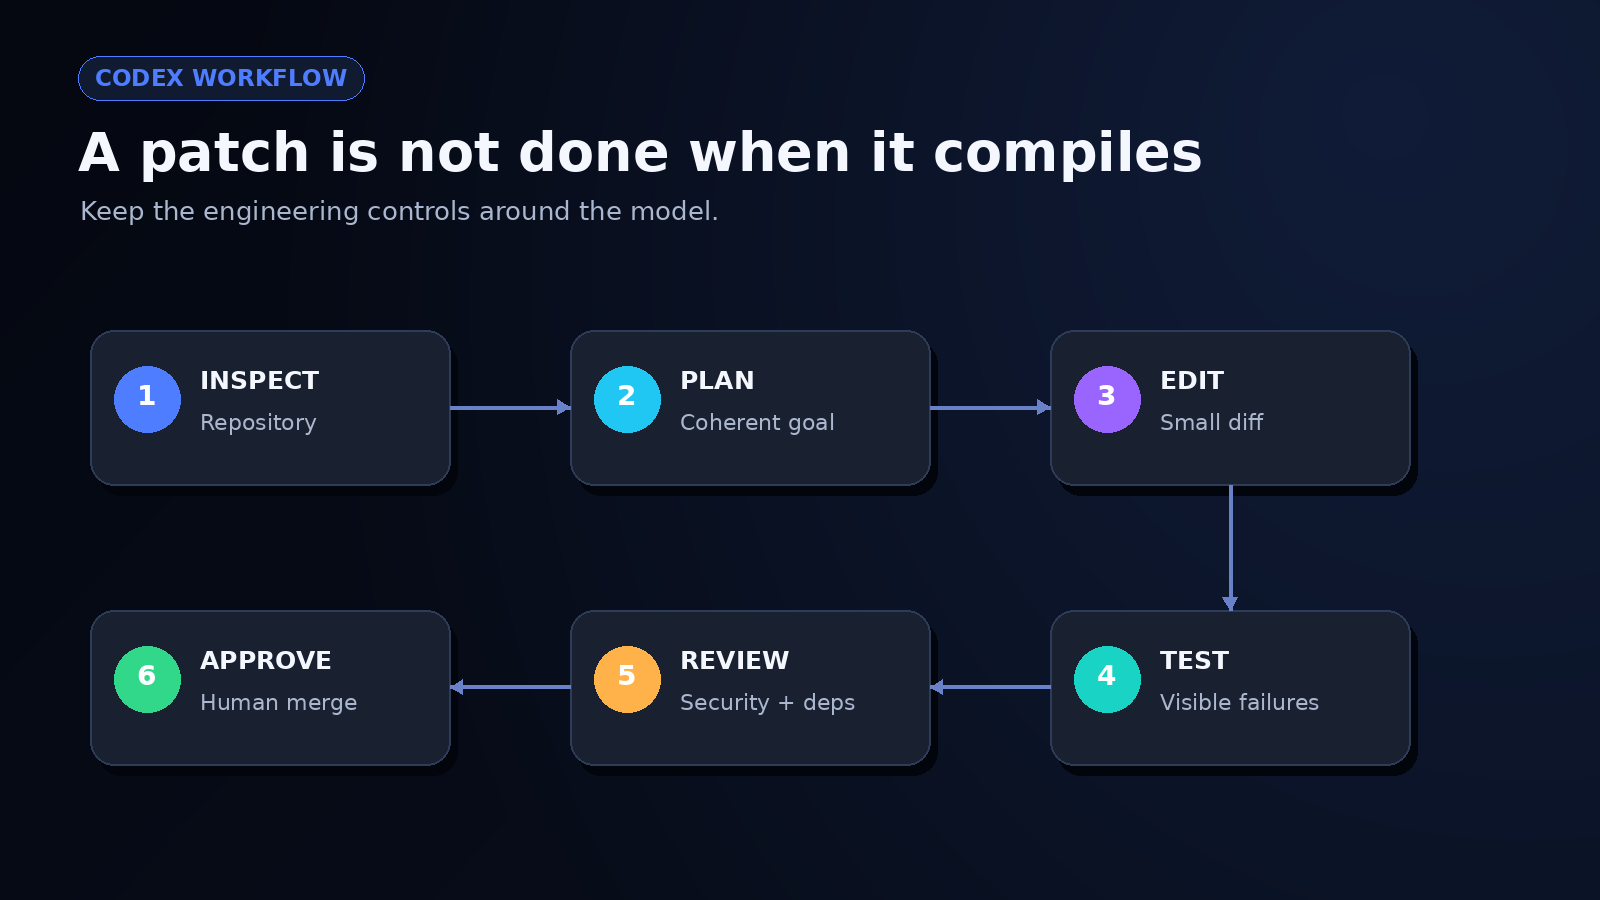
Gambar 9. memeriksa, merencanakan, mengedit, menguji, mereview, dan menyetujui
Guardrail Produksi Tetap Berlaku
Jaga agar perubahan tetap cukup kecil untuk direview, kunci (pin) snapshot model saat reproduktifitas penting, dan batasi tool hanya pada privilese minimum yang dibutuhkan. Jalankan test repositori, pemindaian dependensi, deteksi secret, analisis statis, dan review diff oleh manusia. Jika agen bisa melakukan deploy, menghapus data, atau merotasi kredensial, letakkan aksi-aksi itu di belakang persetujuan eksplisit.
Saya juga lebih suka menetapkan "budget kegagalan": tentukan berapa banyak retry, menit, atau token yang boleh dihabiskan sebuah task sebelum dikembalikan ke manusia. Tanpa batas ini, sebuah agen bisa tampak produktif sambil terus berputar mencoba perbaikan yang makin spekulatif.
GPT-5.2 vs Gemini 3 Bergantung pada Task yang Spesifik
GPT-5.2 vs Gemini 3: menjelaskan bahwa model AI yang lebih baik bergantung pada task-nya, seperti coding, reasoning, writing, atau riset.
Jawaban paling jujur untuk pertanyaan "GPT 5.2 vs Gemini 3" adalah soal desain pengujian, bukan pemenang universal. Varian yang tepat, tanggal, tool, ukuran context, setelan reasoning, dan harga semuanya harus dicatat. Jika tidak, sebuah perbandingan bisa diam-diam memberi satu model keunggulan berupa search, eksekusi kode, atau budget waktu yang lebih besar.
| Faktor keputusan | Pertanyaan yang perlu diuji |
|---|---|
| Kualitas output | Model mana yang lebih sering lolos rubrik task Anda? |
| Coding | Mana yang menghasilkan pass rate test lebih tinggi dengan diff yang lebih kecil dan lebih aman? |
| Context panjang | Mana yang lebih akurat mengambil dan menggabungkan fakta dari file Anda? |
| Penggunaan tool | Mana yang menyelesaikan workflow dengan kegagalan yang bisa di-recover dan log yang bisa digunakan? |
| Latensi | Berapa waktu respons median dan persentil ke-95? |
| Biaya | Berapa total biaya per hasil yang diterima setelah retry dan koreksi? |
| Governance | Kontrol data, retensi, region, dan audit mana yang cocok dengan use case Anda? |
Jalankan Evaluasi Head-to-Head yang Sama
Berikan kedua model prompt, file sumber, tool, budget waktu, dan rubrik penilaian yang sama. Acak urutan task dan sembunyikan nama model dari reviewer jika memungkinkan. Ulangi kasus-kasus yang representatif daripada hanya memilih satu jawaban yang terlihat bagus. Reaksi komunitas dalam diskusi peluncuran GPT‑5.2 berguna untuk menemukan keluhan yang perlu diuji, tapi itu bukan perbandingan yang terkontrol.
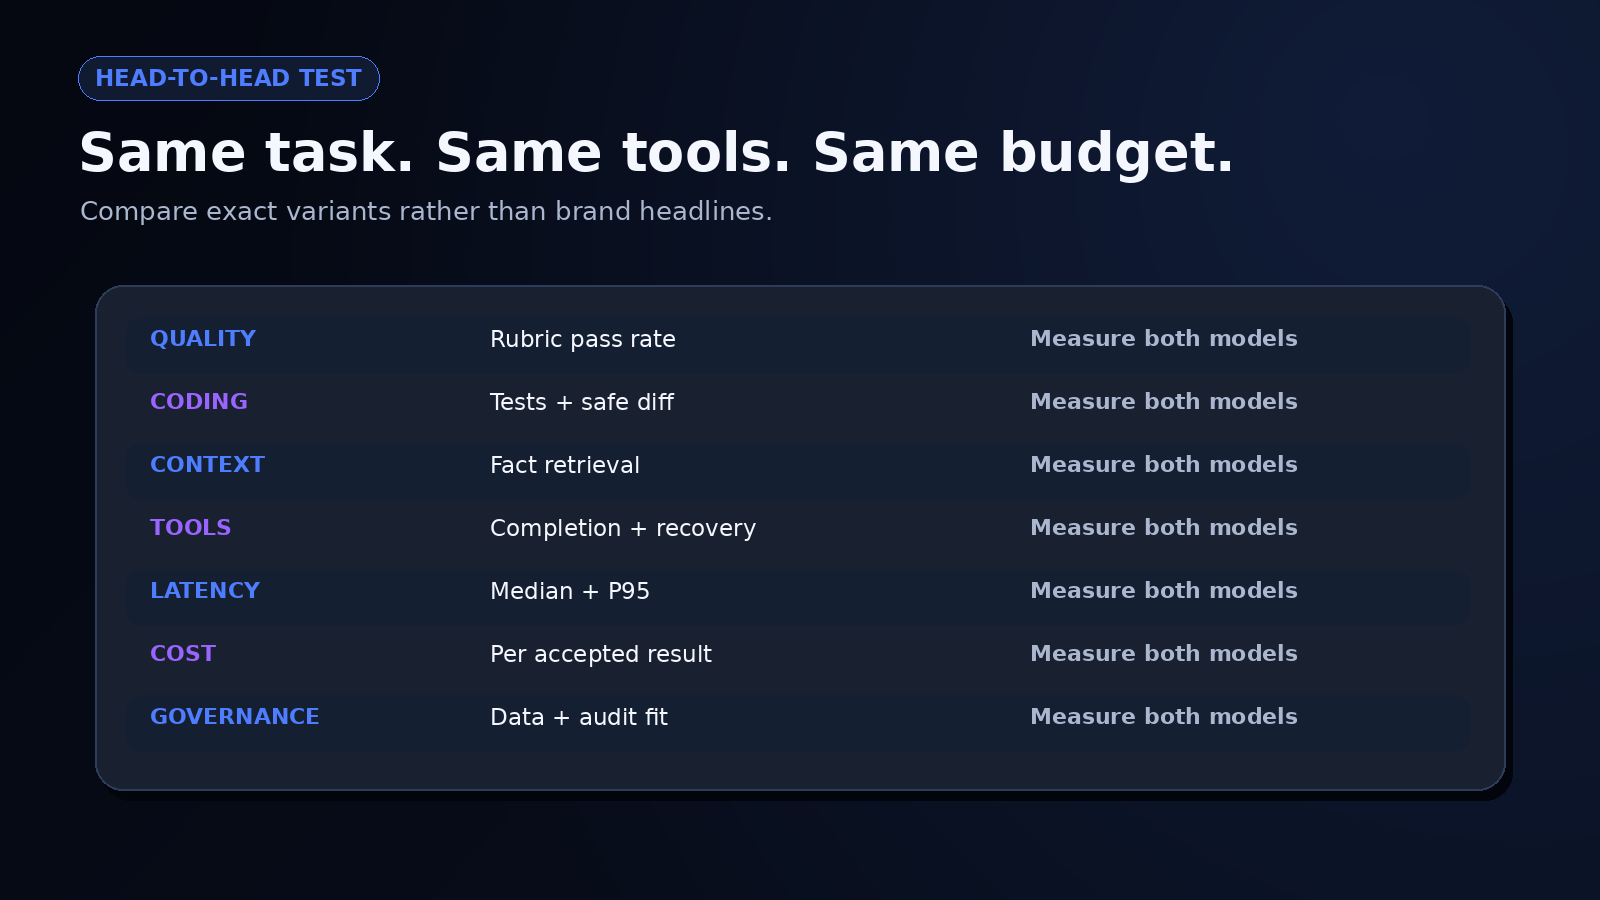
Gambar 10. kualitas, coding, context, tool, latensi, biaya, dan governance
Pilih Workflow dengan Risiko Lebih Rendah, Bukan Headline yang Lebih Keren
Pemenang Anda bisa berbeda di tiap langkah. Satu model mungkin unggul dalam merencanakan, model lain mungkin menghasilkan kode yang lebih bersih, dan opsi yang lebih kecil mungkin menangani klasifikasi dengan biaya jauh lebih murah. Arsitektur yang tepat bisa melakukan routing pekerjaan, bukan memaksa satu model mengerjakan semuanya.
Untuk evaluasi GPT 5.2 vs Gemini 3, saya akan memilih kombinasi model paling sederhana yang memenuhi ambang kualitas dan tetap bisa diamati ketika gagal. Setiap provider atau fallback tambahan menambah logika routing, pekerjaan evaluasi, review privasi, dan kompleksitas insiden. Diversitas model berguna jika benar-benar mengurangi risiko yang terukur.
Bangun Aplikasi GPT‑5.2 Pro di Enter Pro
Saya menggunakan AI app builder dari Enter Pro untuk membuat reviewer brief proyek AI dengan GPT‑5.2 Pro sebagai integrasinya. Tujuannya adalah mengubah ide aplikasi yang masih kasar menjadi daftar requirement, informasi yang hilang, prioritas, dan kriteria penerimaan.
Pilih GPT‑5.2 Pro dan Baca Tarifnya
Saya menemukan GPT‑5.2 Pro di katalog model dan membuka detailnya. Panel tersebut menampilkan tombol Integrate dan tarif** 2,1 credit per 1.000 token input** serta** 16,8 credit per 1.000 token output**. Ini adalah tarif platform yang tercatat saat itu.
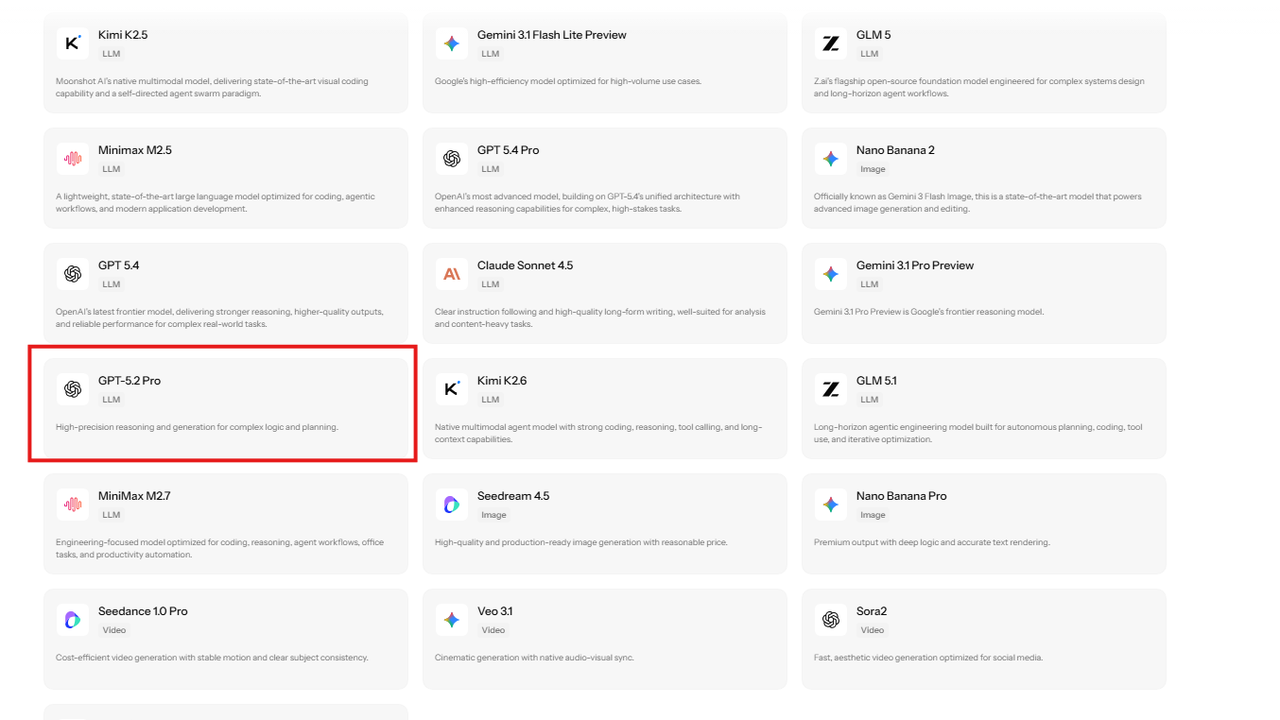
Gambar 11. GPT‑5.2 Pro muncul di katalog model di antara integrasi lain yang tersedia.
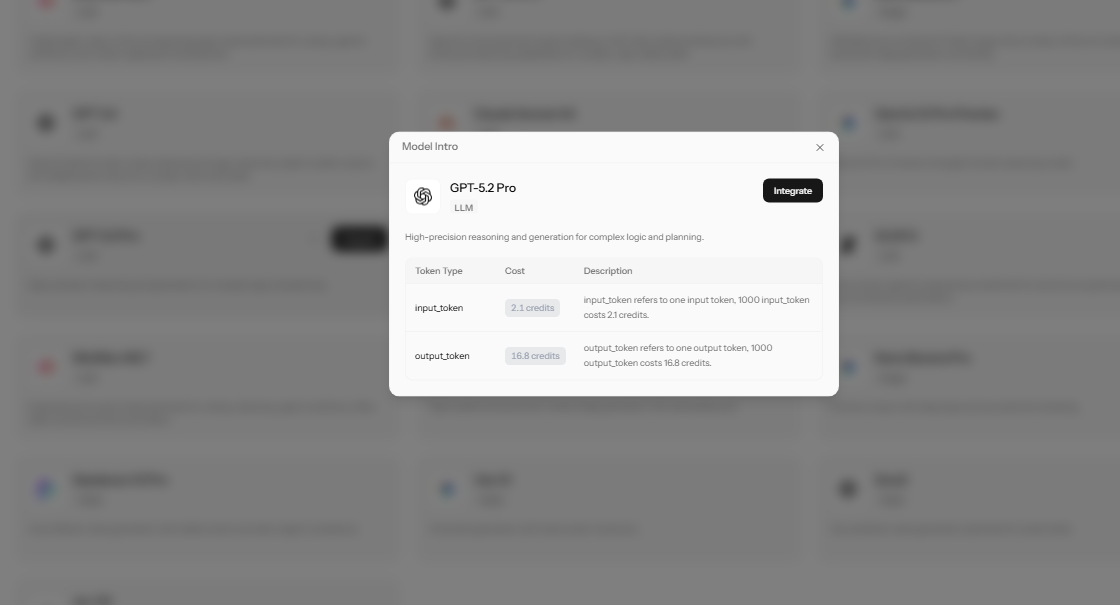
Gambar 12. Panel detail GPT‑5.2 Pro menampilkan kontrol Integrate dan tarif credit-nya.
Pasang Model dan Deskripsikan Aplikasinya
Permintaan proyek sudah menyertakan chip GPT‑5.2 Pro yang terpasang. Saya meminta field brief berukuran besar, tombol Review Brief, dan respons yang tersusun ke dalam lima bagian: ringkasan proyek, requirement penting, kontradiksi dan informasi yang hilang, prioritas implementasi, dan kriteria penerimaan. Permintaan ini juga meminta status loading dan error yang sungguhan.
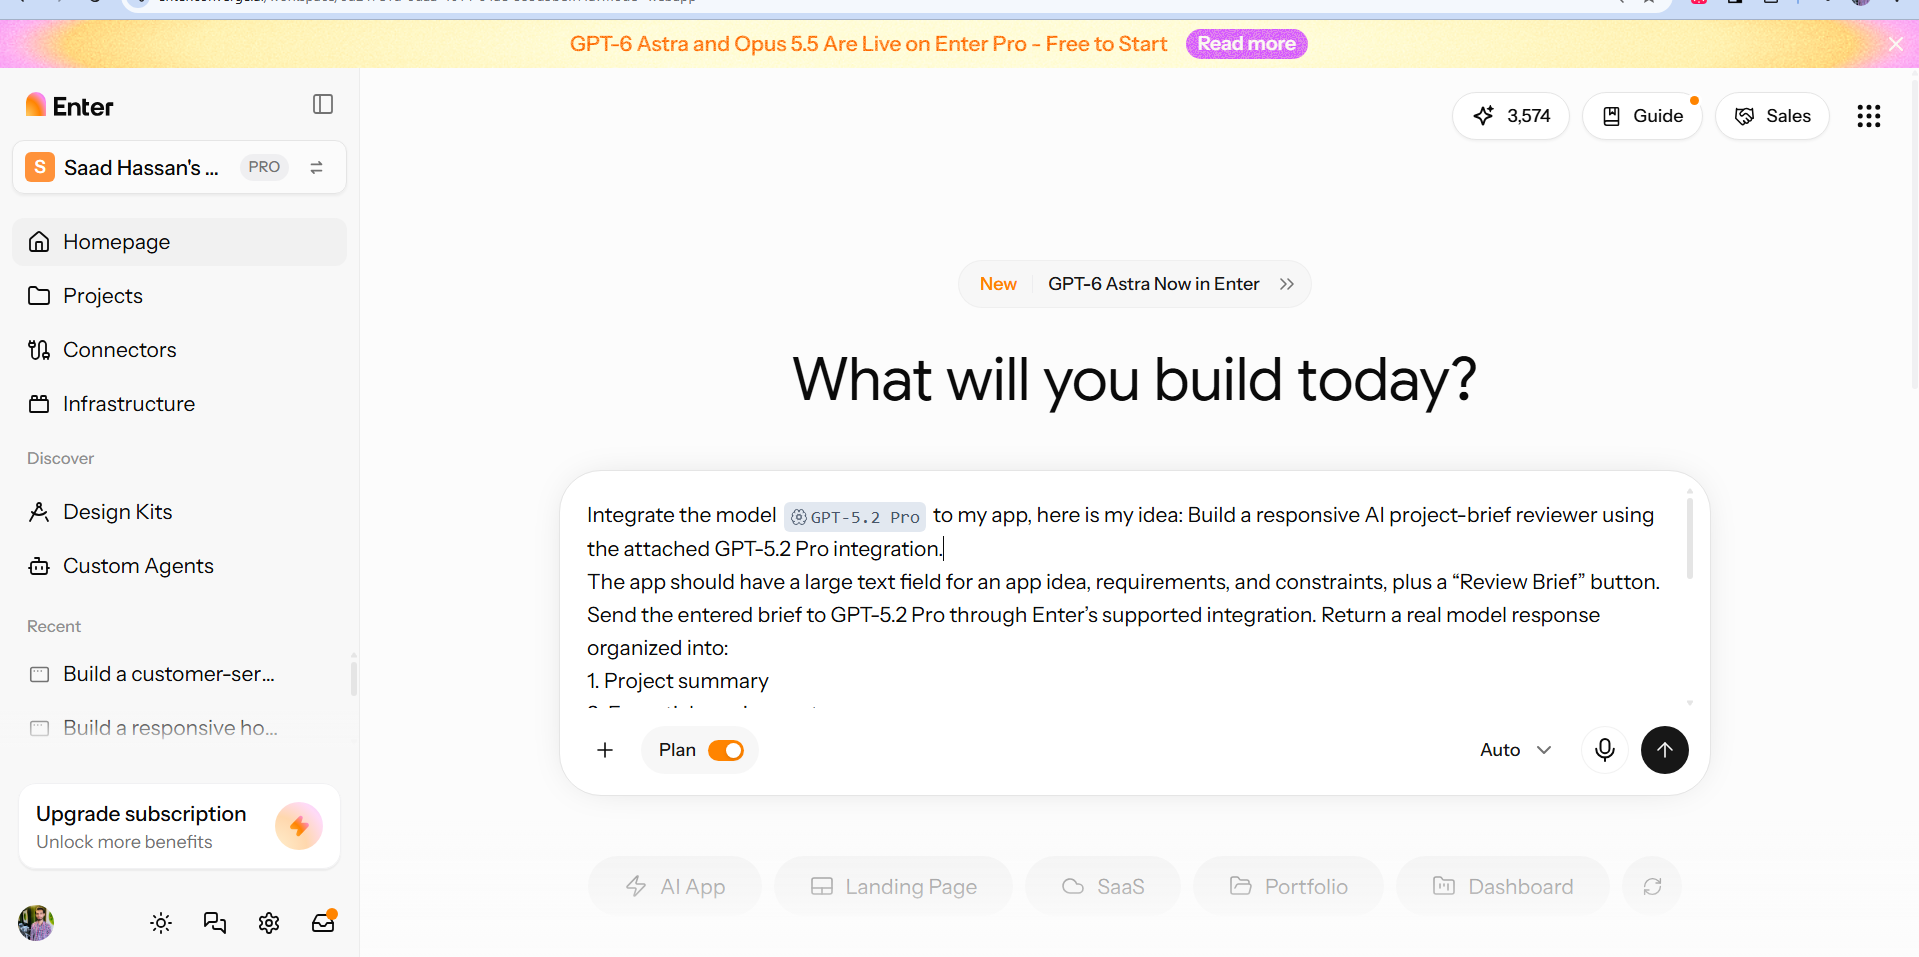
Gambar 13. Prompt proyek memasang GPT‑5.2 Pro dan menentukan tujuan reviewer serta struktur responsnya.
Periksa Rencana Pembangunan Aplikasi
Enter menghasilkan rencana untuk interface berbasis Vite, React, dan Tailwind, dengan fungsi backend yang menangani request AI. Rencana ini menetapkan hasil streaming, teks bahasa Inggris biasa, dan tanpa riwayat review yang disimpan. Menjaga kredensial privat di sisi backend juga menjadi bagian dari rencana ini. Tangkapan layar ini mencatat implementasi yang diusulkan.
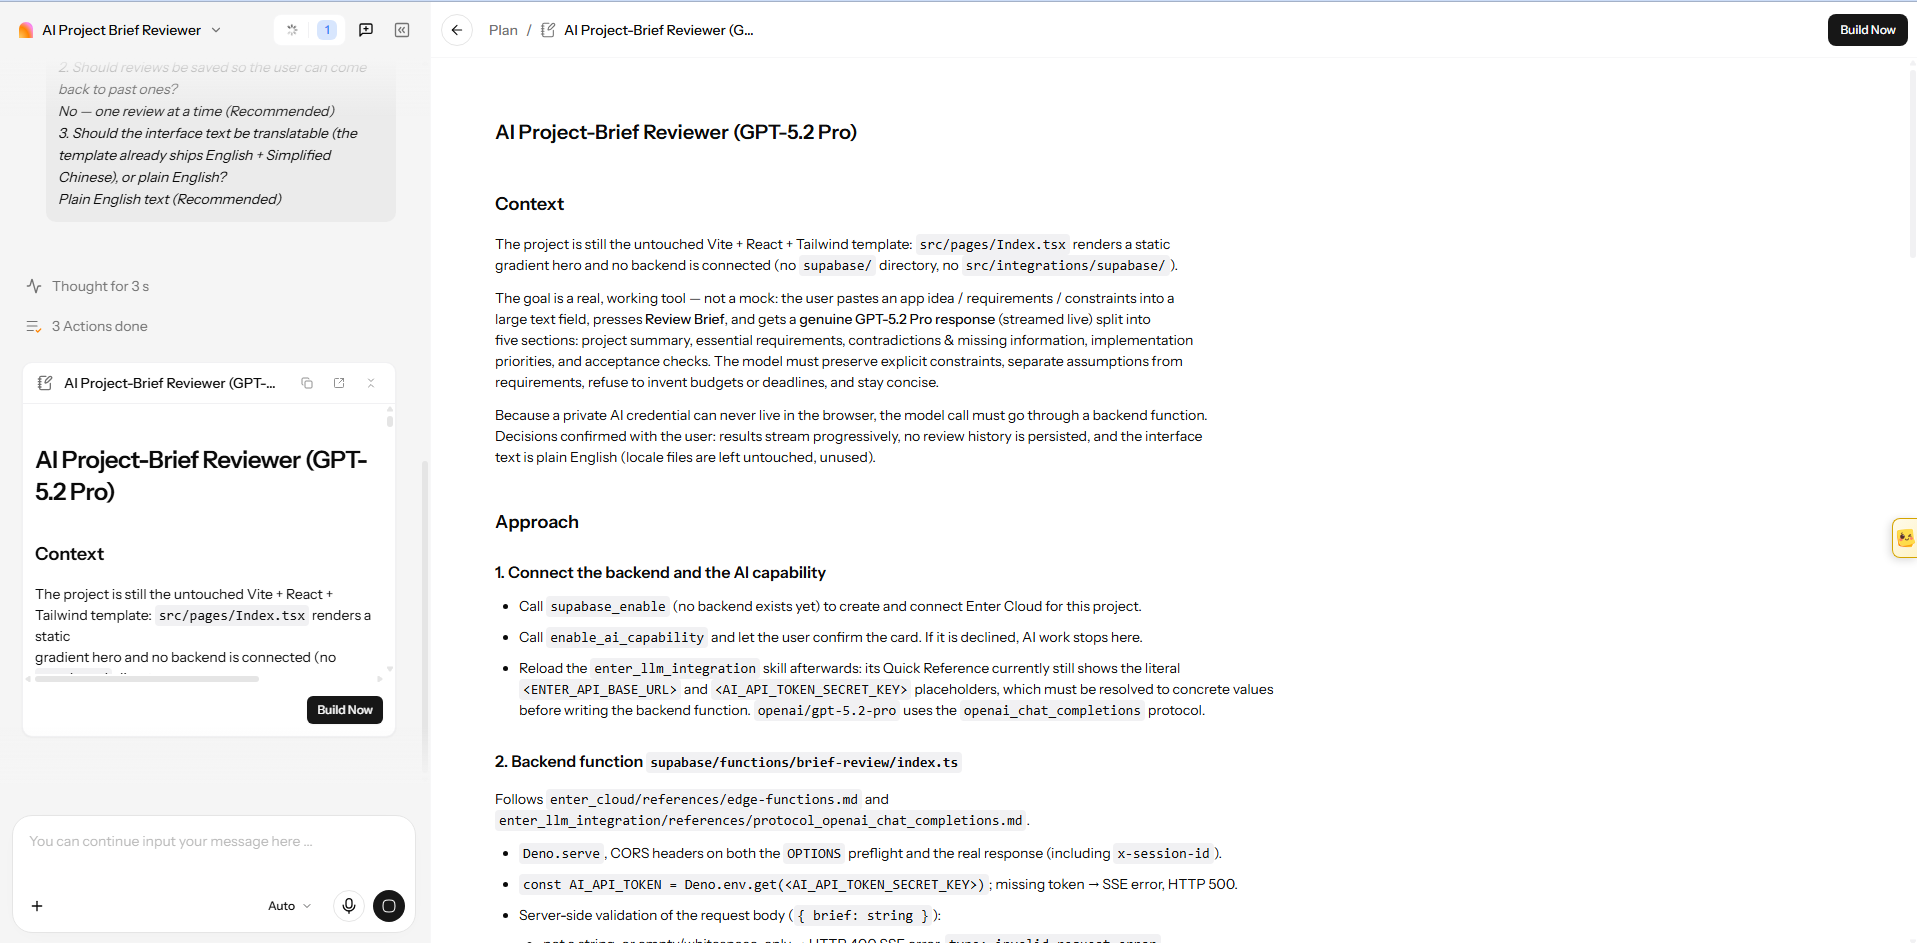
Gambar 14. Rencana pembangunan menjelaskan interface, request backend, output streaming, dan penanganan kredensial.
Amati Hasil Review yang Terlihat
Reviewer menampilkan field brief di samping panel responsnya. Dalam percobaan yang terekam, saya memasukkan permintaan pemeriksaan implementasi ke field tersebut. Respons yang muncul justru menulis ulang requirement-nya di bawah heading yang diminta, sementara teks Streaming review dan** Reviewing** masih terlihat. Ini menunjukkan pengorganisasian respons, dengan penyelesaian dan ketepatan hasilnya masih perlu diperiksa lebih lanjut.
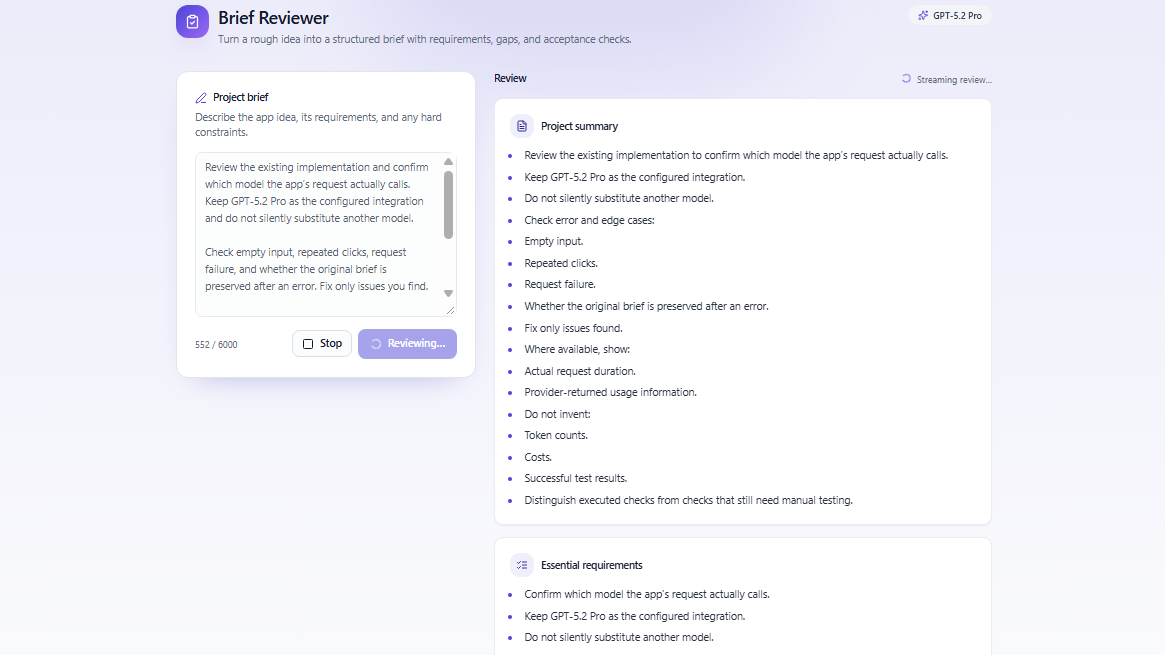
Gambar 15. Teks review muncul di bawah heading yang diminta, sementara interface masih menunjukkan respons yang aktif.
Untuk uji reasoning, gunakan brief penjadwalan appointment dengan tiga teknisi, pekerjaan 45 menit, buffer perjalanan 30 menit, jam kerja 9 pagi–5 sore, tanpa tumpang tindih, dan aturan penjadwalan ulang 12 jam. Lalu tambahkan "izinkan dua appointment bersamaan per teknisi" dan periksa apakah respons yang sudah selesai menandai konflik tersebut. Hasil itu tidak ada dalam tangkapan layar ini.
Periksa Catatan Request dan Penggunaan Credit
Tampilan status tambahan melabeli integrasi sebagai GPT‑5.2 Pro, provider-nya Enter AI, dan protokolnya Responses API. Sesinya menunjukkan tidak ada request, nol token input dan output, serta nol penggunaan yang tercatat. Nilai-nilai ini tidak bisa membuktikan durasi, routing aktual, atau biaya dari respons sebelumnya.
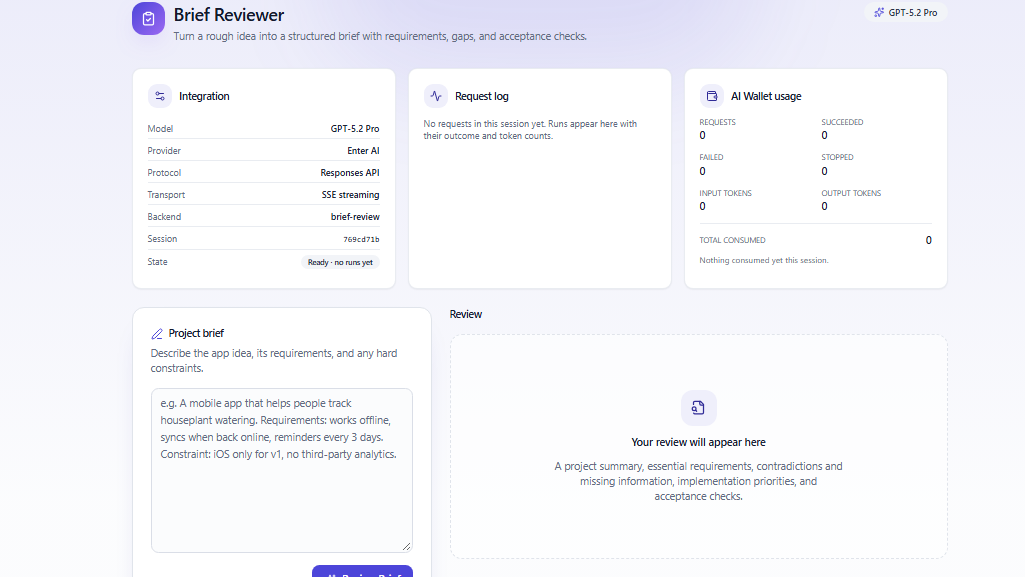
Gambar 16. Panel integrasi dan penggunaan menunjukkan sesi yang siap tanpa request atau konsumsi yang tercatat.
Dengan tarif yang ditampilkan, ilustrasi 1.000 token input ditambah 500 token output yang ditagih akan setara dengan 10,5 credit. Ini adalah estimasi, bukan pengeluaran yang benar-benar teramati. Untuk membandingkan biaya, gunakan request yang sudah selesai, penggunaan yang ditagih, retry, serta proporsi review yang memenuhi kriteria penerimaan Anda.
Enter menyimpan model yang dipilih dan brief aplikasi dalam satu proyek. Bangun aplikasi GPT‑5.2 Pro Anda di Enter Pro dan verifikasi integrasinya sebelum melakukan publish.
Kesimpulan: Nilai GPT‑5.2 Lewat Task yang Benar-Benar Berjalan
Nilai praktis GPT‑5.2 bergantung pada kualitas task dan biaya yang bisa diterima. Proyek reviewer ini menghubungkan pemilihan Pro dengan interface aplikasi dan teks review yang tersusun rapi. Respons yang benar-benar selesai, batasan yang terverifikasi, dan catatan request yang lengkap masih diperlukan untuk menilai keandalan dan efisiensi biayanya.
Pilih model paling murah yang memenuhi ambang penerimaan Anda, ulangi kasus-kasus penting, dan jaga jalur pemulihan untuk error. Anda bisa menggunakan Enter Pro untuk membangun dan menyempurnakan aplikasi GPT‑5.2 Pro, lalu verifikasi integrasinya sebelum mengembangkannya lebih lanjut.
FAQ Seputar Chat GPT 5.2
Kapan GPT-5.2 Dirilis?
OpenAI mengumumkannya pada 11 Desember 2025. Model API dan varian ChatGPT mulai diluncurkan secara bertahap sejak saat itu, meski akses dan rekomendasi alternatif sudah berubah sejak peluncuran tersebut.
Apakah GPT-5.2 Masih Model OpenAI Terbaru?
Tidak. Per 9 Oktober 2026, OpenAI mendokumentasikannya sebagai model generasi sebelumnya. Orang yang mencari Chat GPT 5.2 perlu membedakan akses lewat picker ChatGPT dari akses API atau integrasi pihak ketiga. Periksa varian yang tepat dan ketersediaan saat ini sebelum memulai proyek.
Berapa Context Window GPT-5.2?
Context window yang terdokumentasi adalah 400.000 token, dengan output maksimum 128.000 token. Anda tetap harus menguji retrieval dan reasoning pada dokumen panjang Anda sendiri.
Berapa Biaya API GPT-5.2?
Tarif API standarnya adalah $1,75 per juta token input, $0,175 per juta token input yang di-cache, dan $14 per juta token output. Biaya tool, reasoning, retry, dan review menambah total biaya task.
Bagaimana Cara Membangun Aplikasi GPT‑5.2 Pro dengan Enter Pro?
Pilih GPT‑5.2 Pro dari katalog model, pasang integrasinya, dan deskripsikan fitur yang dibutuhkan aplikasi Anda. Untuk reviewer brief proyek, tentukan input yang diperlukan dan format review-nya. Periksa implementasi yang dihasilkan, lalu verifikasi satu request yang sudah selesai untuk memastikan koneksi model berfungsi.
Bagaimana Cara Memeriksa Penggunaan GPT‑5.2 Pro di Enter Pro?
Periksa panel request dan penggunaan dari integrasi setelah menjalankan task yang representatif. Pastikan request-nya muncul, lalu periksa token input, token output, dan credit yang terpakai. Sertakan retry dan respons yang lebih panjang saat memperkirakan biaya, dengan menggunakan tarif platform yang berlaku saat ini.
Apa Itu GPT-5.2 Pro?
GPT 5.2 Pro adalah model reasoning berkomputasi tinggi untuk task profesional yang sulit. Tarif API resminya adalah $21 per juta token input dan $168 per juta token output, dan beberapa request bisa memakan waktu beberapa menit.
Apakah GPT-5.2 Mendukung Gambar?
Ya. Model ini menerima input gambar dan menghasilkan output teks. Audio dan video tidak tercantum sebagai input native yang didukung, sehingga format-format tersebut membutuhkan langkah pemrosesan terpisah.
Apakah GPT-5.2 Lebih Baik dari Gemini 3?
Tidak ada jawaban universal. Uji varian yang tepat dengan prompt, file, tool, budget, dan rubrik yang sama, lalu bandingkan kualitas hasil yang diterima, latensi, biaya, governance, dan kemampuan pulih dari kegagalan.
Bisakah GPT-5.2 Menghasilkan Kode yang Siap Produksi?
Model ini bisa menghasilkan kode yang kuat, tapi kesiapan produksi berasal dari seluruh proses engineering: test, review diff, pemeriksaan dependensi dan keamanan, tool yang dibatasi, staging, monitoring, dan rollback. Model tidak bisa menggantikan kontrol-kontrol tersebut.





