Compartilhar


Principais conclusões
- Modelos de geração de imagens de código aberto podem oferecer uma maneira de criar e editar imagens sem uma assinatura recorrente ou taxas de licenciamento de modelo separadas.
- O Hugging Face hospeda quase 109.255 modelos de texto para imagem, então os criadores têm uma ampla gama de opções de estilo, velocidade e necessidades de hardware.
- Stable Diffusion 3.5, FLUX e Qwen-Image-2512 lideram o campo para trabalho criativo geral, precisão de prompt e licenciamento comercial.
- ControlNet 1.1 e Waifu Diffusion cobrem necessidades especializadas, como controle estrutural e arte no estilo anime.
- Z-Image-Turbo e GLM-Image destacam-se pela velocidade e geração de imagens com muito texto, como cartazes e infográficos.
- O Framia Pro traz modelos fechados como Nano Banana Pro, Midjourney v7 e Seedream 4.5 para um único espaço de trabalho para criadores que desejam resultados sem gerenciar configurações locais.
Modelos de geração de imagens de código aberto abriram um mundo totalmente novo para criadores, desenvolvedores e empresas. Agora você pode transformar texto em imagens, editar fotos, produzir vídeos e criar objetos 3D, sem gastar uma fortuna em software. O espaço cresceu rapidamente, com quase 109.255 modelos de texto para imagem disponíveis no Hugging Face apenas. Adotar o código aberto significa sem assinaturas, controle total sobre seus dados e a liberdade de ajustar as coisas como precisar. Este guia cobre os melhores modelos disponíveis e tudo o mais que você precisa para começar com o pé direito.
O que são modelos de geração de imagens de código aberto?
Modelos de geração de imagens de código aberto são programas de software que criam imagens a partir de descrições escritas. Você digita o que deseja ver, digamos, um pôr do sol sobre as montanhas, uma maquete de produto, um personagem de desenho animado, e o modelo o produz como uma imagem.
Pense nisso como contratar um artista que estudou milhões de pinturas, fotos e ilustrações durante toda a sua vida. Você descreve o que deseja, e ele desenha para você em segundos. Exceto que este artista nunca dorme, nunca cobra por projeto e vive no seu próprio computador.
O que os torna "código aberto" é que o código está disponível publicamente. Qualquer pessoa pode baixar, usar, modificar ou construir sobre eles gratuitamente. Isso é diferente de ferramentas pagas como Midjourney ou Adobe Firefly, onde você paga para acessar o software e não tem controle sobre como ele funciona nos bastidores.
Esses modelos são treinados em milhões de imagens, o que os ensina a entender a relação entre palavras e elementos visuais. Com o tempo, eles se tornaram bons o suficiente para produzir resultados de qualidade profissional, e os melhores agora rivalizam com opções comerciais caras.
Por que escolher o código aberto em vez de modelos de imagem fechados
Os modelos de imagem pagos são convenientes, mas vêm com limitações reais. Você paga por imagem, entrega seus dados a servidores de terceiros e não tem voz sobre como o software funciona. Os modelos de código aberto resolvem tudo isso. Aqui está o porquê de mais criadores e desenvolvedores estarem fazendo a transição.
- Controle total sobre os resultados
Com ferramentas fechadas, a plataforma decide o que você pode e não pode gerar. Os modelos de código aberto rodam na sua própria configuração, então você define as regras. Você obtém exatamente o que pede, sem filtros de conteúdo ou restrições de plataforma atrapalhando.
- Capacidade de fazer ajuste fino nos modelos
Os modelos fechados são bloqueados e não podem ser alterados para atender às suas necessidades específicas. No entanto, você pode treinar ainda mais os modelos de código aberto com suas próprias imagens, estilos ou diretrizes de marca. Isso significa que o resultado começa a ter a sua cara, e não a de todos os outros que usam a mesma ferramenta.
- Sem custo por imagem
A maioria das ferramentas comerciais cobra por cada imagem gerada, o que acumula rapidamente. Mas com modelos de código aberto, você roda tudo no seu próprio hardware e gera quantas imagens quiser. O único custo é a eletricidade e as máquinas fazendo o trabalho.
- Privacidade e uso offline
Quando você usa uma ferramenta baseada em nuvem, seus prompts e imagens passam pelos servidores de outra pessoa. Os modelos de código aberto podem rodar totalmente offline, de modo que nada sai da sua máquina. Isso importa muito para empresas que lidam com projetos confidenciais ou conteúdo proprietário.
- Grande suporte da comunidade
Os modelos de código aberto são apoiados por milhares de desenvolvedores, pesquisadores e criadores em todo o mundo. Eles compartilham versões ajustadas, tutoriais, plugins e correções diariamente. Se você tiver um problema, é provável que alguém na comunidade já o tenha resolvido.
Como testei e escolhi estes modelos
Trabalho com ferramentas de IA criativas e estava cansado de ver listas de "melhores" que apenas copiam fichas técnicas da página do GitHub de um modelo. Por isso, antes de classificar qualquer coisa aqui, passei uma semana executando cada modelo por conta própria para ver como eles se saíam fora de uma captura de tela de marketing.
Tenho um computador desktop reserva com uma RTX 4090 e 24 GB de VRAM em casa, então essa se tornou minha principal máquina de testes. Para os modelos maiores que precisavam de mais memória, como o FLUX.2 de 32B e o Qwen-Image-2512, aluguei uma GPU na nuvem por hora em vez de adivinhar seus resultados apenas pelas fichas técnicas.
Criei um conjunto de 20 prompts e executei a mesma lista em todos os modelos, sem seleção tendenciosa. Os prompts cobriam cinco áreas: um retrato fotorrealista, uma foto de produto em um fundo simples, um pôster com um título e letras miúdas, um personagem em estilo anime e uma cena movimentada com vários objetos. Cada modelo teve três tentativas por prompt, e mantive a melhor das três, da mesma forma que a maioria das pessoas realmente usa essas ferramentas.
Para a pontuação, avaliei cada resultado de 1 a 5 em quatro aspectos: quão próximo o resultado ficou do prompt, quão limpos os detalhes finos pareciam em resolução total, quanto tempo a geração levou no meu hardware e se o texto dentro da imagem (quando solicitado pelo prompt) realmente ficou legível. Registrei os números em uma planilha à medida que avançava, em vez de confiar na memória depois, já que alguns modelos se confundiram na minha mente após uma tarde inteira de testes.
Algumas coisas se destacaram rapidamente. O Z-Image-Turbo terminou seu lote de 20 prompts em menos de quatro minutos no total, enquanto o FLUX 2 de 32B levou cerca de 40 minutos na GPU alugada. O GLM-Image e o Qwen-Image-2512 foram os únicos dois que conseguiram acertar consistentemente o texto pequeno no prompt do pôster, sem letras distorcidas. O Waifu Diffusion venceu o prompt de anime por uma grande margem, mas teve muita dificuldade no retrato fotorrealista, o que condiz com o que eu esperaria de um modelo treinado em um conjunto de dados restrito.
Classifiquei os sete modelos abaixo com base nesses testes, e não apenas em especificações teóricas ou no hype da comunidade, e observei onde o uso real de VRAM de um modelo foi maior do que o mínimo oficial depois que carreguei um pipeline completo com um tamanho de lote decente.
Os 7 melhores modelos de geração de imagens de código aberto
Diferentes geradores de imagens de IA de código aberto focam em diferentes pontos fortes, como realismo, velocidade, controle de estrutura ou precisão de texto. Abaixo estão sete modelos amplamente utilizados, cada um com um propósito claro.
| Modelo | Arquitetura | VRAM Mínima | Licença | Principais Pontos Fortes | Ideal Para |
| Stable Diffusion 3.5 | Difusão latente (DiT) | 8 GB+ | Comercial | Grande ecossistema, suporte a LoRA, comunidade ativa | Trabalho criativo geral, iniciantes, fluxos de trabalho baseados em plugins |
| ControlNet 1.1 | Extensão condicionada para SD | 8 GB+ | Apache 2.0 | Controle de pose, mapas de profundidade, orientação de bordas | Consistência de personagens, layouts de arquitetura, geração guiada |
| FLUX.2 | Transformer de correspondência de fluxo (4B–32B) | 13 GB (4B) / 24 GB (32B) | BFL Comercial | Suporte a referência de múltiplas imagens e forte aderência ao prompt | Visuais de alta qualidade, ativos de marca, conteúdo de marketing |
| GLM-Image | Híbrido AR + DiT (9B + 7B) | ~16 GB | Pesquisa / Personalizada | Forte renderização de texto, suporte a tipografia chinesa, edição + geração em um único fluxo | Pôsteres, mockups de UI, designs bilíngues, infográficos |
| Qwen-Image-2512 | Difusão + modelo de linguagem de visão (20B) | ~16 GB | Apache 2.0 | Texto multilíngue, edição RGBA em camadas, suporte a ControlNet | Fluxos de trabalho comerciais, edição avançada, conteúdo multilíngue |
| Waifu Diffusion | Stable Diffusion ajustado (conjunto de dados de anime) | 6 GB+ | CreativeML OpenRAIL | Estilo anime, visuais de mangá, resultados focados em personagens | Jogos, visual novels, arte em estilo anime |
| Z-Image-Turbo | Transformer de difusão destilado (6B) | 16 GB | Apache 2.0 | Latência muito baixa, suporte a inglês + chinês, processamento em lote | Aplicativos em tempo real, pipelines de larga escala, implantação de borda |
- Stable Diffusion 3.5
O Stable Diffusion 3.5 é um Multimodal Diffusion Transformer (MMDiT) modelo de texto para imagem desenvolvido pela Stability AI. Ele melhora a qualidade da imagem, a tipografia, a compreensão de prompts e o desempenho geral. O modelo vem em três tamanhos, projetados para diferentes configurações de hardware e casos de uso. Este melhor modelo para gerar imagems continua sendo um dos modelos abertos de geração de imagens mais amplamente utilizados, apoiado por uma grande comunidade de desenvolvedores e criadores de conteúdo.
Principais recursos:
- Três tamanhos de modelo: Large (8B parâmetros), Large Turbo e Medium (~2.5B parâmetros), cada um adequado para diferentes necessidades de desempenho e hardware
- Saída de alta resolução: O modelo Large suporta geração de imagens de alta qualidade com resolução de cerca de 1 megapixel
- Variante de geração rápida: O Large Turbo produz resultados de qualidade em um pequeno número de etapas
- Suporte a ajuste fino: Desenvolvido para personalização com consistência de prompt aprimorada
- Licença de uso flexível: Gratuito para indivíduos e empresas menores, com licenciamento corporativo para organizações maiores
Minha experiência: 4.5/5
Este foi o meu modelo mais consistente em todas as cinco categorias de prompt. O modelo Large acertou em cheio a foto do produto e o prompt da cena movimentada na primeira ou segunda tentativa quase sempre, e nunca travou na minha 4090, mesmo em resolução máxima. O único ponto em que perdeu nota foi na renderização de texto, onde as letras miúdas no prompt do pôster ainda saíram ligeiramente distorcidas.
- ControlNet 1.1
O ControlNet é uma estrutura de rede neural que controla modelos de difusão adicionando condições extras. Ele copia os pesos dos blocos da rede neural em uma cópia bloqueada e uma cópia treinável. A treinável aprende a sua condição, enquanto a bloqueada preserva o modelo original. Lançado pelo pesquisador lllyasviel, ele não gera imagens por conta própria. Em vez disso, este melhor modelo de imagem funciona sobre o Stable Diffusion e oferece controle estrutural preciso sobre o que é gerado.
Principais recursos:
- Múltiplos tipos de condicionamento: O ControlNet suporta controle via detecção de bordas canny, estimativa de profundidade Midas, detecção de bordas suaves HED, detecção de linhas M-LSD, mapas normais, detecção de pose humana OpenPose e segmentação semântica.
- Controles combináveis: O ControlNet suporta a combinação de múltiplos ControlNets de uma só vez. Todos os modelos prontos para produção são amplamente testados com múltiplos ControlNets combinados, e o suporte oficial a Multi-ControlNet está disponível através do plugin A1111.
- Robustez aprimorada na v1.1: O ControlNet 1.1 adiciona novo processamento de bordas suaves, múltiplos novos pré-processadores como Canny, Depth e Inpaint, e fortalece a robustez geral do modelo e a qualidade da imagem em comparação com a versão 1.0.
- Edição baseada em instruções: O ControlNet 1.1 inclui um modelo treinado no conjunto de dados Instruct Pix2Pix, treinado tanto com prompts de instrução quanto com prompts de descrição.
Minha experiência: 4/5
Não avaliei o ControlNet 1.1 com os mesmos cinco prompts porque seus pesos oficiais foram projetados para o Stable Diffusion 1.5, não para o SD 3.5. Em vez disso, avaliei seus controles de pose e profundidade separadamente das execuções do SD 3.5. Ao longo de dez regenerações, o controle de pose manteve a posição do personagem estável. Isso sugere que o ControlNet 1.1 pode fornecer orientações úteis em um fluxo de trabalho compatível, mas esses resultados não devem ser considerados como evidência de compatibilidade direta com o SD 3.5.
- Série FLUX
A série FLUX é desenvolvida pela Black Forest Labs e foca em geração de imagens de alta qualidade com forte alinhamento de prompt. Inclui múltiplos modelos projetados tanto para experimentação quanto para fluxos de trabalho de produção.
Principais recursos:
- Múltiplas variantes: Inclui FLUX.1 [schnell], [dev] e ferramentas especializadas para edição e condicionamento.
- Edição de imagem em contexto: Permite alterações na imagem usando instruções de texto sem necessidade de retreinamento.
- Ferramentas de edição dedicadas: Inclui suporte para inpainting de imagem, outpainting e orientação estrutural.
- Disponibilidade de pesos abertos: Permite implantação local e personalização.
- Opções flexíveis de implantação: Suporta APIs, configurações locais e ambientes de teste.
Minha experiência: 4.5/5
O FLUX.2 me deu os detalhes finos mais nítidos de qualquer modelo que testei, especialmente no prompt de foto de produto, onde a textura do material realmente parecia iluminada em vez de pintada. A variante 32B foi a que levou mais tempo de todos os modelos do meu lote na GPU alugada, cerca de 40 minutos para a execução completa de 20 prompts, então não é a escolha ideal se você estiver com pressa.
- GLM-Image
O GLM-Image é um modelo de geração de imagens que adota uma arquitetura híbrida de decodificador autorregressivo e de difusão. Ele apresenta vantagens em cenários de renderização de texto e geração intensiva de conhecimento, com fortes capacidades na geração de detalhes de alta fidelidade e granulação fina. Desenvolvido pela Zhipu AI, ele foi construído para casos de uso onde outros modelos costumam falhar, particularmente quando as imagens precisam incluir texto legível ou layouts densos em informações.
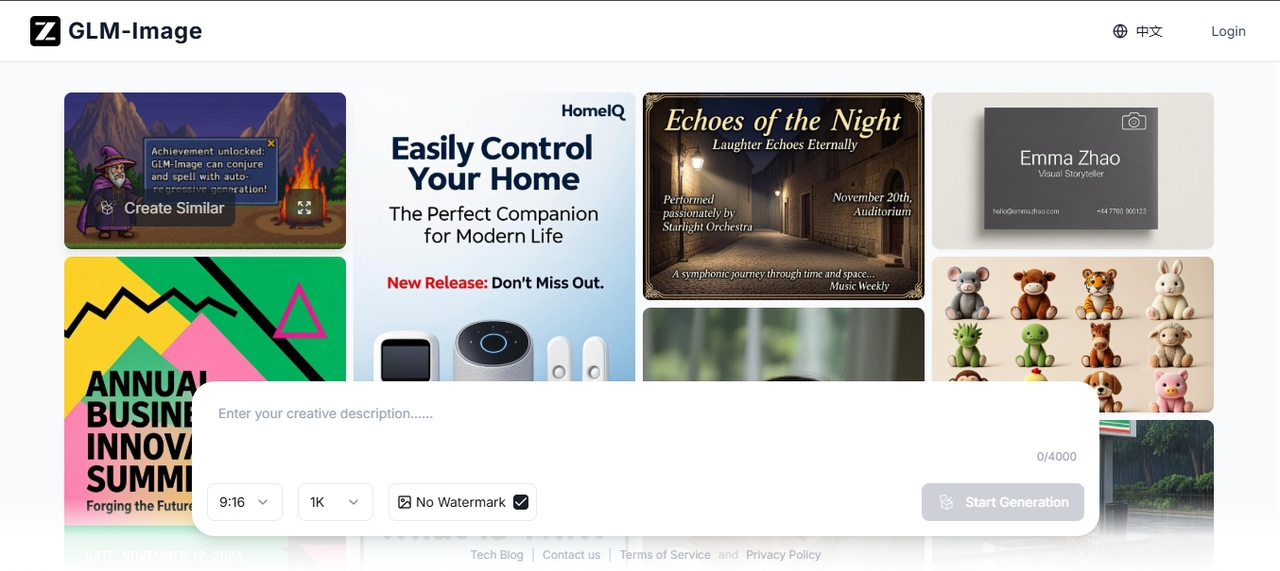
Principais recursos:
- Design de arquitetura híbrida: Combina codificação autorregressiva com decodificação de difusão.
- Renderização de texto precisa: Produz texto claro e legível dentro das imagens.
- Suporte para layouts complexos: Funciona bem para pôsteres, infográficos e recursos visuais estruturados.
- Geração e edição unificadas: Lida com tarefas de texto para imagem e imagem para imagem.
- Refinamento pós-treinamento: Usa aprendizado por reforço para melhorar os detalhes e o alinhamento.
Minha experiência: 4/5
O GLM-Image foi um dos dois únicos modelos que conseguiram tornar as letras miúdas no prompt do meu pôster totalmente legíveis, e ele lidou com o layout em estilo infográfico sem que as letras se misturassem. A configuração demorou mais do que a maioria, pois os termos da licença exigem uma leitura mais atenta antes do uso comercial, o que tirou um ponto em termos de conveniência, e não de qualidade do resultado.
- Qwen-Image-2512
O Qwen-Image-2512 é a atualização de dezembro do modelo de texto para imagem do Qwen-Image melhor modelo de geração de imagens de código aberto, que apresenta realismo humano aprimorado, detalhes naturais mais finos e melhor precisão e qualidade de renderização de texto. Ele é voltado diretamente para casos de uso corporativos e comerciais onde a qualidade, a confiabilidade e a clareza do licenciamento são importantes.
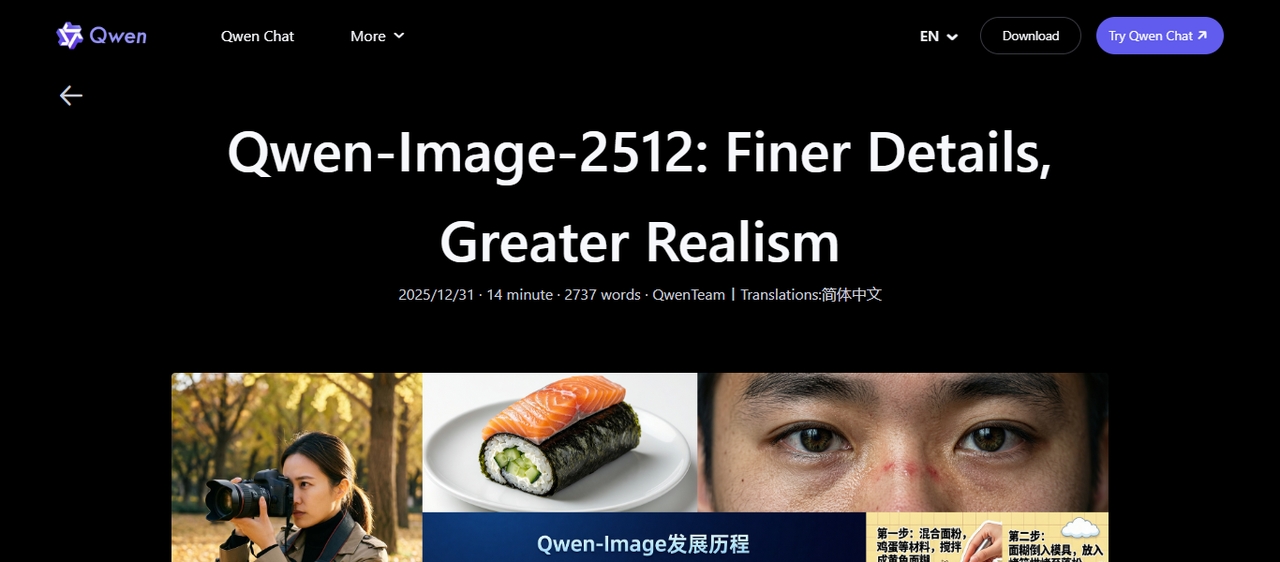
Recurso principal:
- Realismo visual aprimorado: Reduz a aparência artificial nas imagens geradas.
- Melhor precisão de texto: Produz texto incorporado mais claro e layouts estruturados.
- Geração de cenas detalhadas: Lida com ambientes e objetos com maior clareza.
- Licença comercial aberta: Lançado sob a licença Apache 2.0 para uso e modificação gratuitos.
- Acesso total ao modelo: Disponível através de plataformas de modelos abertos para implantação.
Minha experiência: 4.5/5
O Qwen-Image-2512 foi o outro modelo que leu corretamente o texto pequeno no prompt do pôster, e seus resultados de retrato pareceram os mais naturais do grupo, menos artificiais do que os que obtive de alguns dos outros modelos de difusão. Combinado com a licença Apache 2.0, este é o que eu escolheria primeiro para um projeto de cliente onde preciso agir rápido sem ter que discutir licenciamento.
- Waifu Diffusion
O Waifu Diffusion foi criado por Hakurei e foca na geração de imagens no estilo anime. Ele é treinado especificamente em conjuntos de dados de anime, o que permite produzir designs de personagens consistentes e visuais estilizados. Ele é baseado no Stable Diffusion e se integra diretamente ao seu ecossistema, o que o torna fácil de usar para artistas que já estão familiarizados com essas ferramentas.
Recursos principais:
- Treinamento focado em anime: O modelo é treinado em um grande conjunto de dados de imagens de anime, o que o ajuda a aprender proporções de personagens, expressões faciais e elementos estilísticos comuns na arte de anime.
- Qualidade consistente de personagens: Ele mantém características faciais, penteados e detalhes de roupas estáveis em diferentes prompts, o que é útil ao criar o mesmo personagem em várias cenas.
- Controle de estilo através de prompts: Você pode guiar o resultado usando tags e estilos de prompt comumente usados em comunidades de anime.
- Variante baseada em SDXL: A versão mais recente baseada no SDXL melhora a resolução, a iluminação e os detalhes mais finos, mantendo o estilo de anime intacto.
- Licença de acesso aberto: Distribuído sob a licença CreativeML OpenRAIL-M, que permite o uso e a redistribuição sob certas condições.
- Amplo suporte da comunidade: Um grande número de checkpoints pré-treinados, LoRAs e pacotes de estilo estão disponíveis.
Minha experiência: 3.5/5
O Waifu Diffusion venceu o prompt de anime de forma categórica ao manter o rosto e a roupa do personagem consistentes em todas as três tentativas que executei. Mas quando o direcionei para o meu prompt de retrato fotorrealista, o resultado ainda saiu com uma aparência próxima à de anime, não importa como eu o formulasse, o que é exatamente o que se espera de um modelo treinado em um conjunto de dados restrito. Excelente em uma tarefa, mas não construído para o resto.
- Z-Image-Turbo
O Z-Image-Turbo é desenvolvido pela Tongyi-MAI. Ele se concentra em velocidade e eficiência, o que o torna adequado para aplicações que exigem geração rápida de imagens. Faz parte de uma família de modelos compactos projetada para entregar resultados robustos sem depender de arquiteturas muito grandes.
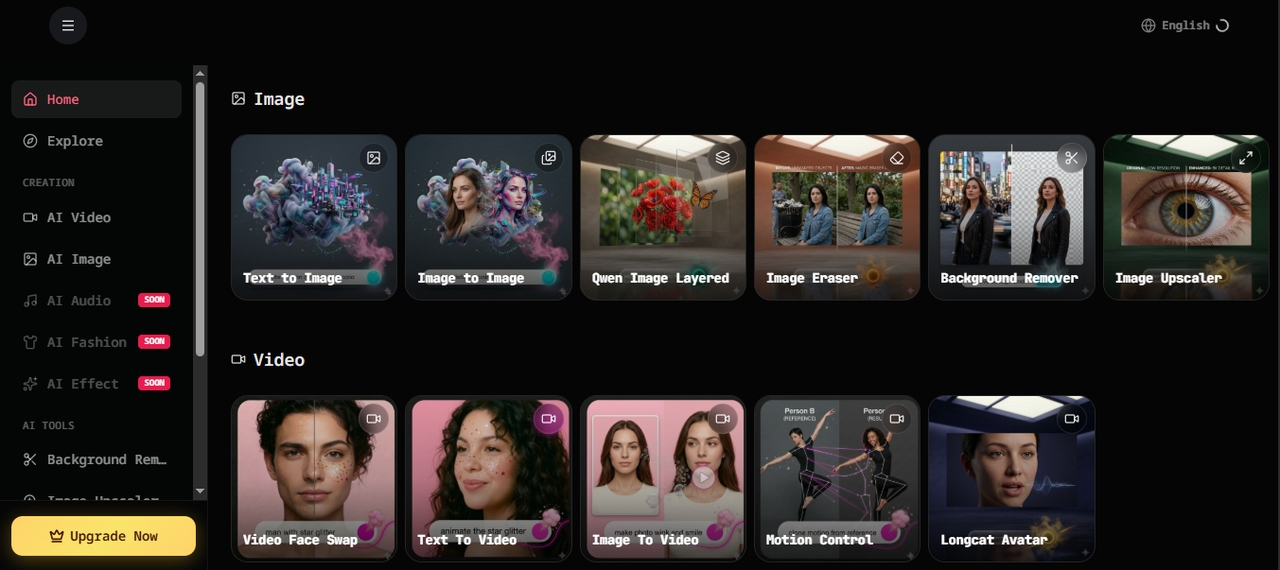
Principais recursos:
- Velocidade de geração de subsegundo: O Z-Image-Turbo prova que o desempenho de alto nível é alcançável sem depender de tamanhos de modelo enormes.
- Renderização de texto bilíngue: Renderiza com precisão textos complexos em chinês e inglês e, no design de pôsteres, demonstra fortes habilidades de composição e um bom senso de tipografia.
- Aprimoramento e raciocínio de prompt: Um aprimorador de prompt integrado capacita o modelo com recursos de raciocínio.
- Arquitetura eficiente de fluxo único: O Z-Image-Turbo usa uma arquitetura DiT de fluxo único escalável (Scalable Single-Stream DiT) onde texto, tokens semânticos visuais e tokens VAE de imagem são concatenados no nível da sequência em um fluxo de entrada unificado.
Minha experiência: 4/5
O Z-Image-Turbo processou todo o meu lote de 20 prompts em menos de quatro minutos, de longe o mais rápido dos sete. A renderização de texto bilíngue se saiu bem tanto na versão em inglês quanto na em chinês do meu prompt de pôster. Os detalhes finos no prompt de cena complexa ficaram um passo atrás do Stable Diffusion 3.5 e do FLUX.2, o que faz sentido considerando o quão menor o modelo é.
Fatores-chave a considerar antes de escolher um modelo
Antes de se comprometer com um, há algumas coisas práticas que vale a pena verificar. Aqui está o que analisar e por que isso importa.
- Qualidade da imagem
A qualidade da imagem resume-se a quão realista, detalhado e preciso o resultado parece em comparação com o que você pediu. Alguns modelos produzem resultados realistas, enquanto outros tendem a ser mais estilizados. A escolha certa depende do que o seu projeto realmente precisa.
- Velocidade (tempo de inferência)
O tempo de inferência é quanto tempo o modelo leva para produzir uma imagem. Se você estiver gerando centenas de imagens em um lote ou criando uma ferramenta em tempo real, a velocidade importa muito. Um modelo mais lento que produz ótimos resultados pode nem sempre ser prático.
- Requisitos de VRAM
VRAM é a memória que sua placa de vídeo usa para executar o modelo. Modelos maiores precisam de mais memória, às vezes 16 GB ou mais. Se o seu hardware não atender aos requisitos, o modelo simplesmente não funcionará ou funcionará de forma lenta demais para ser útil.
- Capacidade de renderização de texto
Alguns modelos lidam bem com texto dentro de imagens, outros erram completamente. Se os seus resultados incluem placas, pôsteres, rótulos ou qualquer conteúdo escrito, isso se torna um fator crítico. Modelos como o GLM-Image e o Qwen-Image-2512 foram criados especificamente com isso em mente.
- Licenciamento (comercial vs. restrito)
Alguns modelos são gratuitos para uso pessoal ou de pesquisa, mas exigem uma licença paga para trabalho comercial. Outros, como o Z-Image-Turbo e o Qwen-Image-2512, são totalmente abertos sob a licença Apache 2.0. Sempre verifique a licença antes de usar um modelo em um projeto ou produto de cliente.
- Ecossistema e comunidade
Uma comunidade forte significa mais tutoriais, ajustes finos pré-construídos, plugins e correções mais rápidas quando as coisas dão errado. Stable Diffusion, por exemplo, possui milhares de recursos criados pela comunidade. Um modelo mais novo ou mais de nicho pode ser impressionante, mas deixá-lo com muito pouco suporte ao seu redor.
Pese esses seis fatores juntos e o código aberto começa a parecer menos com um almoço grátis. Um modelo que acerta em cheio na qualidade da imagem e na renderização de texto pode precisar de mais de 16 GB de VRAM que você não tem, além de tempo real gasto depurando uma configuração local antes de produzir algo utilizável. Se o que você realmente deseja é esse desempenho de alto nível sem hospedar um modelo por conta própria, ou acesso a modelos fechados que essas opções de código aberto não conseguem alcançar de forma alguma, é aí que o Framia Pro se encaixa.
Framia Pro: Sua opção para trabalhar com modelos não abertos
O Framia Pro é uma plataforma criativa de IA construída em torno de uma tela de fluxo de trabalho, onde você conecta modelos fechados de parceiros como Seedream 5.0 Pro, Nano Banana Pro, Kling, Seedance 2.5 e Veo 3.1 em um único espaço de trabalho, em vez de escolher um único motor e viver com seus limites. Você descreve o que deseja, e o Framia Pro cuida do roteiro, dos visuais e da montagem em nós conectados que você pode editar em qualquer ponto do processo. Ele reúne geração de imagens, vídeo e um Marketing Studio completo em um só lugar, para que os criadores que precisam de resultados de modelos que não são de código aberto não precisem juntar várias assinaturas para chegar lá.
Passei algumas horas no Framia Pro ao lado dos sete modelos acima para ver como a experiência de modelo fechado realmente se compara, e anotei abaixo onde ela se encaixa e onde não se encaixa.
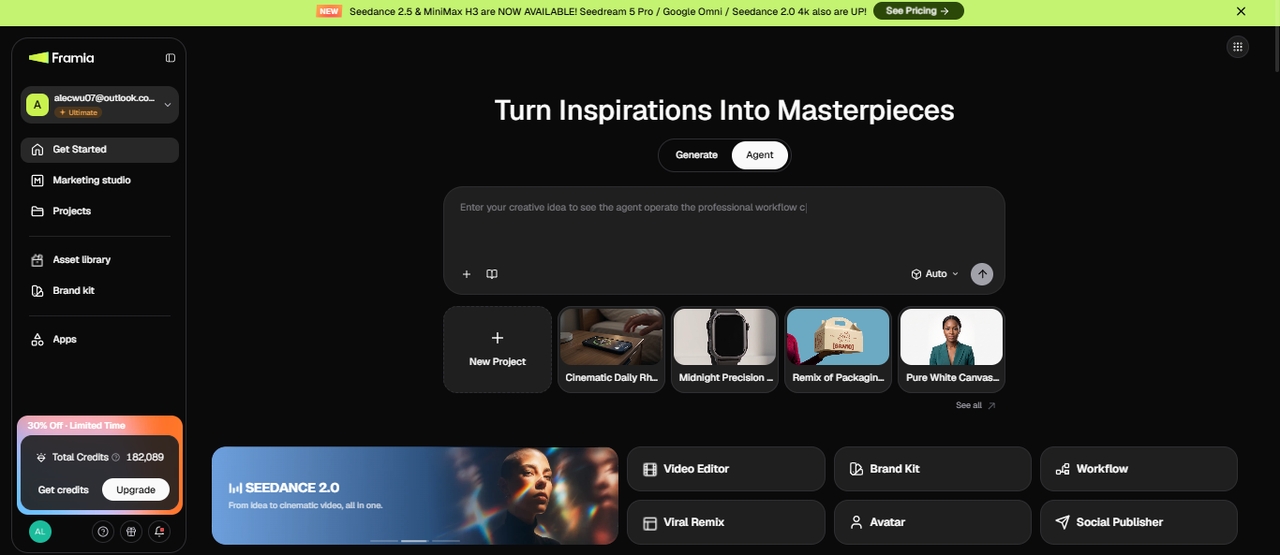
Recursos do gerador de imagens Framia Pro
O Framia Pro oferece um único espaço de trabalho onde você pode criar e editar imagens usando diferentes melhores modelos de geração de imagens. Cada recurso é projetado para lhe dar controle sobre como as imagens são geradas e refinadas.
- Tela de fluxo de trabalho que conecta cada etapa
A tela do Framia Pro organiza seu projeto como nós conectados — roteiro, imagem, vídeo e áudio — que você pode arrastar, adicionar ou remover conforme o projeto se desenvolve. Em vez de gerar uma imagem e recomeçar para o próximo ativo, você constrói uma sequência completa e executa novamente apenas o nó que precisa de alteração.
- Múltiplos modelos de IA em um único espaço de trabalho
O Framia Pro oferece acesso ao Nano Banana Pro, Qwen Image, Midjourney v7, Flux Max e Seedream 4.5 para imagens, além de Kling, Veo 3.1 e Seedance para vídeo, tudo dentro de uma única plataforma. Você pode alternar os modelos dependendo do resultado desejado e comparar os resultados lado a lado sem abrir ferramentas separadas.
- Brand Kit para visuais consistentes
O gerador de Brand Kit do Framia Pro cria logotipos, paletas de cores, tipografia e modelos sociais a partir de um único briefing, mantendo cada imagem gerada posteriormente alinhada a essas diretrizes de marca. Isso é importante para equipes de marketing e empresas que produzem um alto volume de visuais em várias campanhas.
- Modelos de tendências para remixar
O Framia Pro mantém uma galeria de modelos de tendências prontos para viralizar que você pode selecionar e remixar com seu próprio prompt, em vez de construir um conceito do zero. Isso é mais voltado para conteúdo de redes sociais de rápida produção do que para os estilos em que este guia se concentra, mas vale a pena conhecer se você também produz vídeo.
- Edite imagens por meio de comandos simples de chat
Você pode descrever uma alteração em linguagem simples, como trocar um fundo ou redimensionar um logotipo, e o Framia Pro a aplica diretamente à imagem. Essa edição baseada em chat dispensa a máscara manual ou a necessidade de refazer uma geração inteira para uma pequena correção.
Conclusão
Neste artigo, exploramos os 7 principais modelos de geração de imagens de código aberto e mostramos como diferentes ferramentas lidam com a criação de imagens, desempenho e flexibilidade. Cada modelo oferece seus próprios pontos fortes em áreas como qualidade visual, velocidade, necessidades de hardware e suporte para vários estilos. O Framia Pro reúne múltiplos modelos em um só lugar para oferecer mais opções para gerar e editar imagens em um único fluxo de trabalho, sem alternar entre ferramentas separadas. Experimente agora!
Perguntas Frequentes
Qual gerador de imagens de IA de código aberto é usado com mais frequência?
O Stable Diffusion continua sendo um dos geradores de imagens de código aberto mais amplamente utilizados devido à sua comunidade ativa e amplo suporte a ferramentas. No Framia Pro, você pode acessar diferentes modelos de imagem em um único espaço de trabalho, o que elimina a necessidade de configurar ambientes separados para cada gerador e permite alternar mais facilmente entre os resultados.
Quais modelos de geração de imagens produzem maior qualidade visual?
Modelos mais novos, como os baseados em SDXL e a série Flux, geralmente geram texturas mais nítidas, iluminação aprimorada e melhor composição. O Framia Pro oferece acesso aos modelos Nano Banana Pro, Seedream 4.5, Flux Max, Qwen Image e Midjourney v7 para permitir que você crie imagens instantaneamente.
Qual modelo funciona melhor para geração de imagens em hardware limitado?
Versões otimizadas ou leves de modelos são mais adequadas para sistemas com VRAM limitada. O Framia Pro gerencia o acesso aos modelos no backend, para que você possa executar modelos mais pesados sem gerenciar a configuração local, o que reduz a necessidade de hardware de ponta do seu lado.
Quais são considerados os melhores modelos de geração de imagens de código aberto?
Modelos como Stable Diffusion, Waifu Diffusion e configurações baseadas em ControlNet são comumente usados para diferentes tarefas, como realismo, arte de anime, e controle estrutural. O Framia Pro reúne essas opções, permitindo que você selecione e teste múltiplos modelos em um único projeto.
Quais modelos de imagem são preferidos para casos de uso profissional?
Fluxos de trabalho profissionais frequentemente exigem saídas estáveis, resultados consistentes e suporte para edição. O Framia Pro agrega valor ao oferecer edição de imagem baseada em chat e geração em lote, o que permite refinar imagens e produzir múltiplas variações em um só lugar sem alternar ferramentas.
Qual é o melhor modelo gratuito de geração de imagens?
O Stable Diffusion 3.5 é a opção gratuita mais completa, já que as variantes Medium e Large Turbo rodam em hardware de nível de consumidor e a licença cobre o uso comercial para empresas menores. O Z-Image-Turbo e o Qwen-Image-2512 também são totalmente gratuitos sob a licença Apache 2.0, com saída mais rápida, mas com uma comunidade menor construída em torno deles até o momento.
Existe um gerador de imagens de IA local de código aberto disponível?
Sim. O Stable Diffusion 3.5, ControlNet 1.1, FLUX.2, Waifu Diffusion e Z-Image-Turbo rodam localmente em seu próprio hardware após o download, sem a necessidade de conta na nuvem ou assinatura. O principal requisito é VRAM suficiente, geralmente de 6 GB a 24 GB, dependendo do modelo escolhido.
Posso usar modelos de imagem de código aberto para projetos comerciais?
Sim, mas depende da licença do modelo. Alguns modelos permitem o uso comercial, enquanto outros possuem restrições. Sempre revise os termos da licença antes de usar imagens geradas para trabalhos de clientes, produtos ou campanhas pagas.