Compartir


Conclusiones clave
- Los modelos de generación de imágenes de código abierto pueden ofrecer una forma de crear y editar imágenes sin una suscripción recurrente o tarifas de licencia de modelos independientes.
- Hugging Face alberga casi 109,255 modelos de texto a imagen, por lo que los creadores tienen una amplia gama de opciones para estilo, velocidad y necesidades de hardware.
- Stable Diffusion 3.5, FLUX y Qwen-Image-2512 lideran el campo para el trabajo creativo general, la precisión de las instrucciones y las licencias comerciales.
- ControlNet 1.1 y Waifu Diffusion cubren necesidades especializadas, como el control estructural y el arte de estilo anime.
- Z-Image-Turbo y GLM-Image se destacan por su velocidad y la generación de imágenes con mucho texto, como carteles e infografías.
- Framia Pro reúne modelos cerrados como Nano Banana Pro, Midjourney v7 y Seedream 4.5 en un solo espacio de trabajo para creadores que desean resultados sin gestionar configuraciones locales.
Los modelos de generación de imágenes de código abierto han abierto un mundo completamente nuevo para creadores, desarrolladores y empresas. Ahora puedes convertir texto en imágenes, editar fotos, producir videos y crear objetos 3D, sin gastar una fortuna en software. El espacio ha crecido rápidamente, con casi 109,255 modelos de texto a imagen disponibles en Hugging Face únicamente. Optar por el código abierto significa que no hay suscripciones, se tiene un control total sobre tus datos y la libertad de ajustar las cosas como lo necesites. Esta guía cubre los mejores modelos disponibles y todo lo demás que necesitas para empezar con buen pie.
¿Qué son los modelos de generación de imágenes de código abierto?
Los modelos de generación de imágenes de código abierto son programas de software que crean imágenes a partir de descripciones escritas. Escribes lo que quieres ver, por ejemplo, un atardecer sobre las montañas, una maqueta de producto, un personaje de caricatura, y el modelo lo produce como una imagen.
Piensa en ello como contratar a un artista que ha estudiado millones de pinturas, fotos e ilustraciones toda su vida. Describes lo que quieres y ellos lo dibujan para ti en segundos. Excepto que este artista nunca duerme, nunca cobra por proyecto y vive en tu propia computadora.
Lo que los hace de "código abierto" es que el código está disponible públicamente. Cualquiera puede descargarlos, usarlos, modificarlos o construir sobre ellos de forma gratuita. Esto es diferente de las herramientas de pago como Midjourney o Adobe Firefly, donde pagas para acceder al software y no tienes control sobre cómo funciona internamente.
Estos modelos se entrenan con millones de imágenes, lo que les enseña a comprender la relación entre las palabras y los elementos visuales. Con el tiempo, se han vuelto lo suficientemente buenos como para producir resultados de calidad profesional, y los mejores ahora rivalizan con las costosas opciones comerciales.
Por qué elegir el código abierto en lugar de los modelos de imágenes cerrados
Los modelos de imágenes de pago son convenientes, pero vienen con limitaciones reales. Pagas por imagen, entregas tus datos a servidores de terceros y no tienes voz ni voto en cómo funciona el software. Los modelos de código abierto resuelven todo eso. He aquí por qué más creadores y desarrolladores están haciendo el cambio.
- Control total sobre los resultados
Con las herramientas cerradas, la plataforma decide lo que puedes y no puedes generar. Los modelos de código abierto se ejecutan en tu propia configuración, por lo que tú pones las reglas. Obtienes exactamente lo que pides, sin que los filtros de contenido o las restricciones de la plataforma se interpongan en el camino.
- Capacidad para ajustar los modelos
Los modelos cerrados están bloqueados y no se pueden cambiar para adaptarse a tus necesidades específicas. Sin embargo, puedes entrenar más los modelos de código abierto con tus propias imágenes, estilos o pautas de marca. Esto significa que el resultado comienza a verse y sentirse como tuyo, no como el de todos los demás que usan la misma herramienta.
- Sin costo por imagen
La mayoría de las herramientas comerciales te cobran por cada imagen que generas, lo que se acumula rápidamente. Pero con los modelos de código abierto, ejecutas todo en tu propio hardware y generas tantas imágenes como quieras. El único costo es la electricidad y las máquinas que hacen el trabajo.
- Privacidad y uso sin conexión
Cuando utilizas una herramienta basada en la nube, tus instrucciones e imágenes pasan por los servidores de otra persona. Los modelos de código abierto pueden ejecutarse completamente sin conexión, por lo que nada sale de tu máquina. Esto importa mucho para las empresas que manejan proyectos confidenciales o contenido patentado.
- Gran soporte de la comunidad
Los modelos de código abierto están respaldados por miles de desarrolladores, investigadores y creadores de todo el mundo. Comparten versiones ajustadas, tutoriales, complementos y correcciones a diario. Si te encuentras con un problema, es probable que alguien en la comunidad ya lo haya resuelto.
Cómo probé y elegí estos modelos
Trabajo con herramientas de IA creativa y estaba cansado de ver listas de "lo mejor de" que solo copian hojas de especificaciones de la página de GitHub de un modelo. Así que antes de clasificar nada aquí, pasé una semana ejecutando cada modelo por mí mismo para ver cómo se comportaba fuera de una captura de pantalla de marketing.
Tengo una computadora de escritorio de repuesto con una RTX 4090 y 24 GB de VRAM en casa, así que esa se convirtió en mi plataforma de prueba principal. Para los modelos más grandes que necesitaban más memoria, como FLUX.2 a 32B y Qwen-Image-2512, alquilé una GPU en la nube por horas en lugar de adivinar su rendimiento únicamente a partir de las hojas de especificaciones.
Creé un conjunto de 20 prompts y ejecuté la misma lista en cada modelo, sin seleccionar a conveniencia. Los prompts cubrían cinco áreas: un retrato fotorrealista, una toma de producto sobre un fondo liso, un póster con un titular y letra pequeña, un personaje de estilo anime y una escena concurrida con varios objetos. Cada modelo tuvo tres intentos por prompt y me quedé con el mejor de los tres, de la misma manera que la mayoría de la gente realmente usa estas herramientas.
Para la puntuación, califiqué cada resultado del 1 al 5 en cuatro aspectos: qué tan cerca estaba el resultado de coincidir con el prompt, qué tan limpio se veía el detalle fino a resolución completa, cuánto tiempo tomó la generación en mi hardware y si el texto dentro de la imagen (cuando un prompt lo solicitaba) realmente resultaba legible. Registré los números en una hoja de cálculo a medida que avanzaba en lugar de confiar en la memoria después, ya que algunos modelos se confundían entre sí tras una tarde entera de pruebas.
Un par de cosas destacaron rápidamente. Z-Image-Turbo terminó su lote de 20 prompts en menos de cuatro minutos en total, mientras que FLUX 2 a 32B tardó cerca de 40 minutos en la GPU alquilada. GLM-Image y Qwen-Image-2512 fueron los únicos dos que lograron consistentemente que el texto pequeño saliera bien en el prompt del póster sin letras distorsionadas. Waifu Diffusion ganó el prompt de anime por un amplio margen, pero tuvo serias dificultades con el retrato fotorrealista, lo cual coincide con lo que esperaría de un modelo entrenado con un conjunto de datos limitado.
Clasifiqué los siete modelos a continuación basándome en esas pruebas, no solo en especificaciones teóricas o en la exageración de la comunidad, y señalé dónde el uso de VRAM en el mundo real de un modelo fue mayor que su mínimo oficial una vez que cargué un flujo de trabajo completo con un tamaño de lote decente.
Los 7 mejores modelos de generación de imágenes de código abierto
Diferentes generadores de imágenes de IA de código abierto se enfocan en diferentes fortalezas como el realismo, la velocidad, el control de la estructura o la precisión del texto. A continuación se presentan siete modelos ampliamente utilizados, cada uno con un propósito claro.
| Modelo | Arquitectura | VRAM mín. | Licencia | Fortalezas clave | Ideal para |
| Stable Diffusion 3.5 | Difusión latente (DiT) | 8 GB+ | Comercial | Gran ecosistema, soporte para LoRA, comunidad activa | Trabajo creativo general, principiantes, flujos de trabajo basados en complementos |
| ControlNet 1.1 | Complemento condicionado de SD | 8 GB+ | Apache 2.0 | Control de pose, mapas de profundidad, guía de bordes | Consistencia de personajes, diseños arquitectónicos, generación guiada |
| FLUX.2 | Transformer de coincidencia de flujo (4B–32B) | 13 GB (4B) / 24 GB (32B) | BFL Comercial | Soporte de referencia de múltiples imágenes y fuerte adherencia al prompt | Elementos visuales de alta calidad, activos de marca, contenido de marketing |
| GLM-Image | Híbrido AR + DiT (9B + 7B) | ~16 GB | Investigación / Personalizada | Fuerte renderizado de texto, admite tipografía china, edición + generación en un solo flujo | Pósteres, maquetas de interfaz de usuario, diseños bilingües, infografías |
| Qwen-Image-2512 | Difusión + modelo de lenguaje de visión (20B) | ~16 GB | Apache 2.0 | Texto multilingüe, edición RGBA por capas, soporte para ControlNet | Flujos de trabajo comerciales, edición avanzada, contenido multilingüe |
| Waifu Diffusion | Stable Diffusion ajustado (conjunto de datos de anime) | 6 GB+ | CreativeML OpenRAIL | Estilo anime, elementos visuales de manga, resultados centrados en personajes | Juegos, novelas visuales, obras de arte de estilo anime |
| Z-Image-Turbo | Transformer de difusión destilado (6B) | 16 GB | Apache 2.0 | Latencia muy baja, admite inglés + chino, procesamiento por lotes | Aplicaciones en tiempo real, flujos de trabajo a gran escala, despliegue en el borde |
- Stable Diffusion 3.5
Stable Diffusion 3.5 es un Transformer de Difusión Multimodal (MMDiT) modelo de texto a imagen desarrollado por Stability AI. Mejora la calidad de la imagen, la tipografía, la comprensión de los prompts y el rendimiento general. El modelo viene en tres tamaños, diseñados para diferentes configuraciones de hardware y casos de uso. Este mejor modelo para generar imágenes sigue siendo uno de los modelos de generación de imágenes abiertos más utilizados, respaldado por una gran comunidad de desarrolladores y creadores de contenido.
Características clave:
- Tres tamaños de modelo: Large (8B parámetros), Large Turbo y Medium (~2.5B parámetros), cada uno adecuado para diferentes necesidades de rendimiento y hardware
- Salida de alta resolución: El modelo Large admite la generación de imágenes de alta calidad a una resolución de aproximadamente 1 megapíxel
- Variante de generación rápida: Large Turbo produce resultados de calidad en un número reducido de pasos
- Soporte para ajuste fino: Diseñado para la personalización con una consistencia de prompt mejorada
- Licencia de uso flexible: Gratis para individuos y empresas más pequeñas, con licencias empresariales para organizaciones más grandes
Mi experiencia: 4.5/5
Este fue mi modelo más consistente en las cinco categorías de prompts. El modelo Large clavó la toma del producto y el prompt de la escena concurrida en el primer o segundo intento casi siempre, y nunca falló en mi 4090 incluso a resolución completa. El único aspecto en el que perdió puntos fue en el renderizado de texto, donde la letra pequeña en el prompt del póster todavía salía ligeramente distorsionada.
- ControlNet 1.1
ControlNet es una estructura de red neuronal que controla los modelos de difusión al agregar condiciones adicionales. Copia los pesos de los bloques de la red neuronal en una copia bloqueada y una copia entrenable. La entrenable aprende tu condición, mientras que la bloqueada conserva el modelo original. Lanzado por el investigador lllyasviel, no genera imágenes por sí solo. En su lugar, este mejor modelo de imagen se sitúa sobre Stable Diffusion y te ofrece un control estructural preciso sobre lo que se genera.
Características clave:
- Múltiples tipos de condicionamiento: ControlNet admite el control mediante detección de bordes canny, estimación de profundidad Midas, detección de bordes suaves HED, detección de líneas M-LSD, mapas normales, detección de pose humana OpenPose y segmentación semántica.
- Controles componibles: ControlNet admite la combinación de múltiples ControlNets a la vez. Todos los modelos listos para producción se prueban exhaustivamente con múltiples ControlNets combinados, y el soporte oficial de Multi-ControlNet está disponible a través del complemento A1111.
- Robustez mejorada en v1.1: ControlNet 1.1 agrega un nuevo procesamiento de bordes suaves, múltiples preprocesadores nuevos como Canny, Depth e Inpaint, y fortalece la robustez general y la calidad de imagen del modelo en comparación con la versión 1.0.
- Edición basada en instrucciones: ControlNet 1.1 incluye un modelo entrenado en el conjunto de datos Instruct Pix2Pix, entrenado tanto con prompts de instrucción como con prompts de descripción.
Mi experiencia: 4/5
No califiqué a ControlNet 1.1 con los mismos cinco prompts porque sus pesos oficiales están diseñados para Stable Diffusion 1.5, no para SD 3.5. En su lugar, evalué sus controles de pose y profundidad por separado de las ejecuciones de SD 3.5. A lo largo de diez regeneraciones, el control de pose mantuvo estable la posición del personaje. Esto sugiere que ControlNet 1.1 puede proporcionar una guía útil en un flujo de trabajo compatible, pero estos resultados no deben tomarse como evidencia de compatibilidad directa con SD 3.5.
- Serie FLUX
La serie FLUX está desarrollada por Black Forest Labs y se centra en la generación de imágenes de alta calidad con una sólida alineación de prompts. Incluye múltiples modelos diseñados tanto para la experimentación como para los flujos de trabajo de producción.
Características clave:
- Múltiples variantes: Incluye FLUX.1 [schnell], [dev] y herramientas especializadas para edición y condicionamiento.
- Edición de imágenes en contexto: Permite realizar cambios en la imagen utilizando instrucciones de texto sin necesidad de reentrenamiento.
- Herramientas de edición dedicadas: Incluye soporte para inpainting de imágenes, outpainting y guía estructural.
- Disponibilidad de pesos abiertos: Permite la implementación local y la personalización.
- Opciones de implementación flexibles: Admite APIs, configuraciones locales y entornos de prueba.
Mi experiencia: 4.5/5
FLUX.2 me dio el detalle fino más nítido de cualquier modelo que probé, especialmente en el prompt de toma de producto donde la textura del material realmente parecía iluminada en lugar de pintada. La variante 32B fue la que más tardó de todos los modelos de mi lote en la GPU alquilada, cerca de 40 minutos para la ejecución completa de 20 prompts, por lo que no es la opción ideal si tienes prisa.
- GLM-Image
GLM-Image es un modelo de generación de imágenes que adopta una arquitectura híbrida de decodificador autorregresivo y de difusión. Muestra ventajas en la representación de texto y en escenarios de generación intensivos en conocimiento, con sólidas capacidades en la generación de detalles de alta fidelidad y grano fino. Desarrollado por Zhipu AI, está diseñado para casos de uso en los que otros modelos suelen quedarse cortos, particularmente cuando las imágenes necesitan incluir texto legible o diseños densos en información.
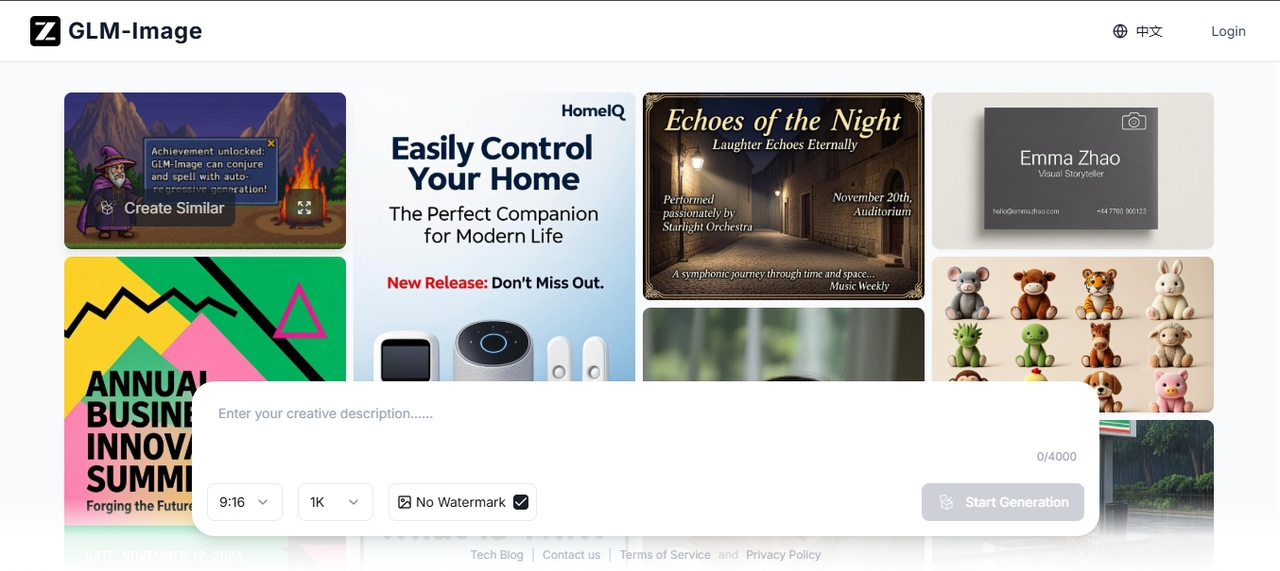
Características clave:
- Diseño de arquitectura híbrida: Combina la codificación autorregresiva con la decodificación de difusión.
- Representación precisa de texto: Produce texto claro y legible dentro de las imágenes.
- Soporte para diseños complejos: Funciona bien para carteles, infografías y elementos visuales estructurados.
- Generación y edición unificadas: Maneja tareas tanto de texto a imagen como de imagen a imagen.
- Refinamiento post-entrenamiento: Utiliza el aprendizaje por refuerzo para mejorar el detalle y la alineación.
Mi experiencia: 4/5
GLM-Image fue uno de los dos únicos modelos que logró que la letra pequeña en mi prompt de póster fuera completamente legible, y manejó el diseño estilo infografía sin que las letras se mezclaran entre sí. La configuración tomó más tiempo que la mayoría, ya que los términos de la licencia requieren una lectura más detallada antes del uso comercial, lo que le restó un punto por conveniencia más que por la calidad del resultado.
- Qwen-Image-2512
Qwen-Image-2512 es la actualización de diciembre del modelo de texto a imagen de Qwen-Image mejor modelo de generación de imágenes de código abierto, que presenta un realismo humano mejorado, detalles naturales más finos y una precisión y calidad de renderizado de texto mejoradas. Está dirigido directamente a casos de uso empresariales y comerciales donde la calidad, la confiabilidad y la claridad de las licencias son importantes.
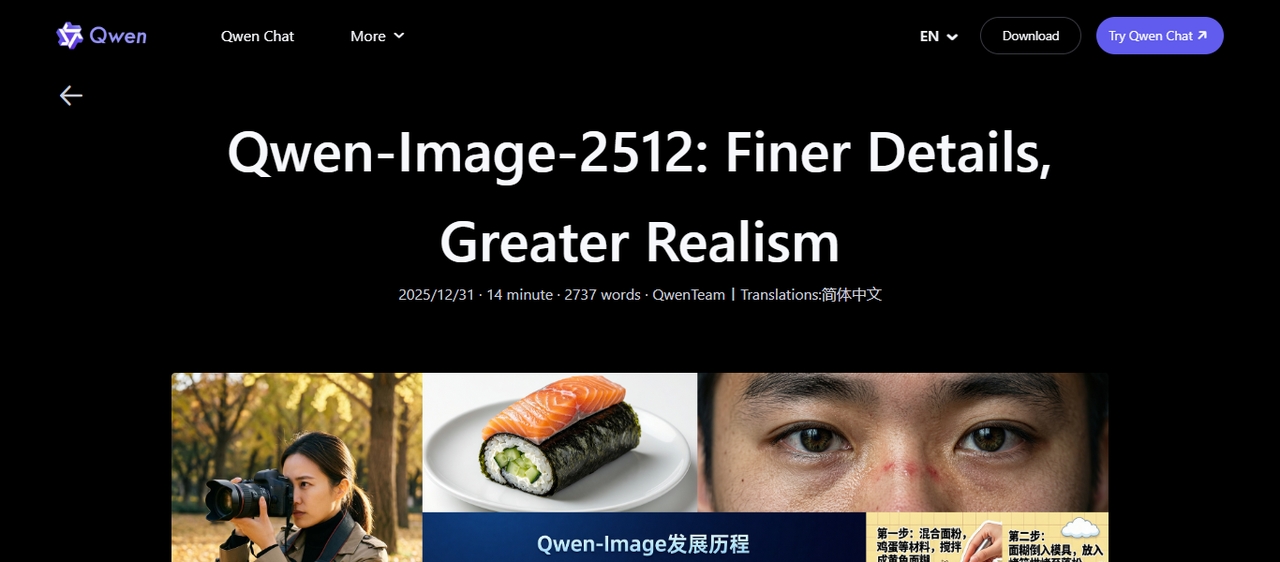
Característica clave:
- Realismo visual mejorado: Reduce la apariencia artificial en las imágenes generadas.
- Mejor precisión del texto: Produce texto incrustado más claro y diseños estructurados.
- Generación de escenas detalladas: Maneja entornos y objetos con mayor claridad.
- Licencia comercial abierta: Lanzado bajo Apache 2.0 para uso y modificación gratuitos.
- Acceso completo al modelo: Disponible a través de plataformas de modelos abiertos para su implementación.
Mi experiencia: 4.5/5
Qwen-Image-2512 fue el otro modelo que leyó correctamente el texto pequeño en el prompt del póster, y sus resultados de retratos se vieron como los más naturales del grupo, menos cerosos que los que obtuve de algunos de los otros modelos de difusión. Combinado con la licencia Apache 2.0, este es el que elegiría primero para un proyecto de cliente en el que necesito avanzar rápido sin una conversación sobre licencias.
- Waifu Diffusion
Waifu Diffusion es creado por Hakurei y se enfoca en la generación de imágenes de estilo anime. Está entrenado específicamente en conjuntos de datos de anime, lo que le permite producir diseños de personajes consistentes y visuales estilizados. Se basa en Stable Diffusion y se integra directamente en su ecosistema, lo que facilita su uso para artistas que ya están familiarizados con esas herramientas.
Características clave:
- Entrenamiento enfocado en anime: El modelo está entrenado en un gran conjunto de datos de imágenes de anime, lo que le ayuda a aprender proporciones de personajes, expresiones faciales y elementos estilísticos comunes en el arte del anime.
- Calidad de personaje consistente: Mantiene características faciales, peinados y detalles de ropa estables en diferentes prompts, lo cual es útil al crear el mismo personaje en múltiples escenas.
- Control de estilo a través de prompts: Puedes guiar el resultado utilizando etiquetas y estilos de prompts comúnmente utilizados en las comunidades de anime.
- Variante basada en SDXL: La versión más nueva basada en SDXL mejora la resolución, la iluminación y los detalles más finos mientras mantiene intacto el estilo anime.
- Licencia de acceso abierto: Distribuido bajo CreativeML OpenRAIL-M, que permite el uso y la redistribución bajo ciertas condiciones.
- Amplio soporte de la comunidad: Está disponible una gran cantidad de checkpoints preentrenados, LoRAs y paquetes de estilos.
Mi experiencia: 3.5/5
Waifu Diffusion ganó el prompt de anime por completo al mantener la cara y el atuendo del personaje consistentes en los tres intentos que realicé. Pero cuando lo apunté a mi prompt de retrato fotorrealista, el resultado de todos modos salió con un aspecto cercano al anime sin importar cómo lo redactara, que es exactamente lo que se esperaría de un modelo entrenado en un conjunto de datos limitado. Excelente en un trabajo, no diseñado para el resto.
- Z-Image-Turbo
Z-Image-Turbo es desarrollado por Tongyi-MAI. Se centra en la velocidad y la eficiencia, lo que lo hace adecuado para aplicaciones que requieren una generación rápida de imágenes. Forma parte de una familia de modelos compactos diseñada para ofrecer resultados sólidos sin depender de arquitecturas muy grandes.
Características clave:
- Velocidad de generación de menos de un segundo: Z-Image-Turbo demuestra que es posible alcanzar un rendimiento de primer nivel sin depender de tamaños de modelo enormes.
- Renderizado de texto bilingüe: Renderiza con precisión texto complejo en chino e inglés, y en el diseño de pósteres demuestra sólidas habilidades de composición y un buen sentido de la tipografía.
- Mejora de prompts y razonamiento: Un mejorador de prompts integrado dota al modelo de capacidades de razonamiento.
- Arquitectura eficiente de flujo único: Z-Image-Turbo utiliza una arquitectura DiT de flujo único escalable (Scalable Single-Stream DiT) donde el texto, los tokens semánticos visuales y los tokens VAE de imagen se concatenan a nivel de secuencia en un flujo de entrada unificado.
Mi experiencia: 4/5
Z-Image-Turbo procesó todo mi lote de 20 prompts en menos de cuatro minutos, con diferencia el más rápido de los siete. El renderizado de texto bilingüe se mantuvo bien tanto en la versión en inglés como en la de chino de mi prompt para póster. El detalle fino en el prompt de escena concurrida estuvo un paso por detrás de Stable Diffusion 3.5 y FLUX.2, lo cual es lógico teniendo en cuenta lo mucho más pequeño que es el modelo.
Factores clave a considerar antes de elegir un modelo
Antes de comprometerte con uno, vale la pena comprobar algunas cosas prácticas. Esto es lo que debes mirar y por qué es importante.
- Calidad de imagen
La calidad de imagen se reduce a qué tan realista, detallado y preciso se ve el resultado en comparación con lo que pediste. Algunos modelos producen resultados realistas, mientras que otros se inclinan más por lo estilizado. La elección correcta depende de lo que realmente necesite tu proyecto.
- Velocidad (tiempo de inferencia)
El tiempo de inferencia es lo que tarda el modelo en producir una imagen. Si estás generando cientos de imágenes en un lote o construyendo una herramienta en tiempo real, la velocidad importa mucho. Un modelo más lento que produce excelentes resultados puede no ser siempre práctico.
- Requisitos de VRAM
La VRAM es la memoria que utiliza tu tarjeta gráfica para ejecutar el modelo. Los modelos más grandes necesitan más, a veces 16 GB o más. Si tu hardware no cumple con el requisito, el modelo simplemente no se ejecutará, o lo hará demasiado lento para ser útil.
- Capacidad de renderizado de texto
Algunos modelos manejan bien el texto dentro de las imágenes, otros lo hacen completamente mal. Si tus resultados incluyen letreros, pósteres, etiquetas o cualquier contenido escrito, esto se convierte en un factor crítico. Modelos como GLM-Image y Qwen-Image-2512 se crearon específicamente con esto en mente.
- Licencias (comercial vs. restringida)
Algunos modelos son gratuitos para uso personal o de investigación, pero requieren una licencia de pago para el trabajo comercial. Otros como Z-Image-Turbo y Qwen-Image-2512 son completamente abiertos bajo Apache 2.0. Comprueba siempre la licencia antes de usar un modelo en un proyecto o producto de un cliente.
- Ecosistema y comunidad
Una comunidad fuerte significa más tutoriales, ajustes finos preconstruidos, complementos y soluciones más rápidas cuando las cosas van mal. Stable Diffusion, por ejemplo, tiene miles de recursos creados por la comunidad. Un modelo más nuevo o más de nicho puede ser impresionante, pero dejarte con muy poco soporte a su alrededor.
Sopesa esos seis factores juntos y el código abierto empieza a parecer menos una ganga. Un modelo que clava la calidad de imagen y el renderizado de texto podría necesitar más de 16 GB de VRAM que no tienes, además de tiempo real dedicado a depurar una configuración local antes de que produzca algo utilizable. Si lo que realmente deseas es ese rendimiento de primer nivel sin alojar un modelo tú mismo, o el acceso a modelos cerrados que estas opciones de código abierto no pueden igualar en absoluto, ahí es donde entra Framia Pro fits in.
Framia Pro: Tu opción para trabajar con modelos no abiertos
Framia Pro es una plataforma creativa de IA construida en torno a un lienzo de flujo de trabajo, donde conectas modelos cerrados de socios como Seedream 5.0 Pro, Nano Banana Pro, Kling, Seedance 2.5 y Veo 3.1 en un solo espacio de trabajo en lugar de elegir un único motor y vivir con sus límites. Describes lo que quieres y Framia Pro se encarga del guion, los elementos visuales y el ensamblaje a través de nodos conectados que puedes editar en cualquier momento del proceso. Reúne la generación de imágenes, el video y un Marketing Studio completo en un solo lugar, para que los creadores que necesitan resultados de modelos que no son de código abierto no tengan que combinar varias suscripciones para lograrlo.
Pasé unas horas en Framia Pro junto con los siete modelos anteriores para ver cómo se compara realmente la experiencia de modelos cerrados, y a continuación he señalado dónde encaja y dónde no.
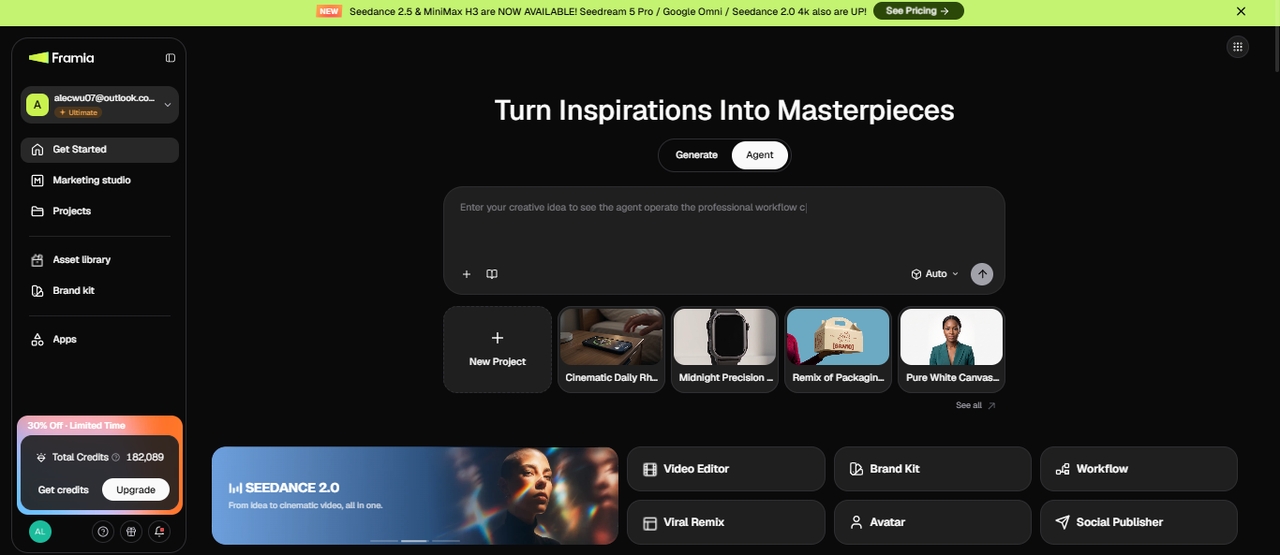
Características del generador de imágenes de Framia Pro
Framia Pro ofrece un único espacio de trabajo donde puedes crear y editar imágenes utilizando diferentes mejores modelos de generación de imágenes. Cada función está diseñada para darte control sobre cómo se generan y perfeccionan las imágenes.
- Lienzo de flujo de trabajo que conecta cada paso
El lienzo de Framia Pro presenta tu proyecto como nodos conectados (guion, imagen, video y audio) que puedes arrastrar, agregar o eliminar a medida que se desarrolla el proyecto. En lugar de generar una imagen y comenzar de nuevo para el siguiente recurso, construyes una secuencia completa y vuelves a ejecutar solo el nodo que necesita un cambio.
- Múltiples modelos de IA en un solo espacio de trabajo
Framia Pro te brinda acceso a Nano Banana Pro, Qwen Image, Midjourney v7, Flux Max y Seedream 4.5 para imágenes, además de Kling, Veo 3.1 y Seedance para video, todo dentro de una sola plataforma. Puedes cambiar de modelo según el resultado que desees y comparar los resultados uno al lado del otro sin abrir herramientas separadas.
- Brand Kit para elementos visuales consistentes
El generador de Brand Kit de Framia Pro crea logotipos, paletas de colores, tipografía y plantillas para redes sociales a partir de un solo informe, y luego mantiene cada imagen que generes después adaptada a esas pautas de marca. Esto es importante para los equipos de marketing y las empresas que producen un gran volumen de elementos visuales en sus campañas.
- Plantillas en tendencia para remezclar
Framia Pro mantiene una galería de plantillas en tendencia y listas para hacerse virales que puedes seleccionar y remezclar con tu propia indicación en lugar de construir un concepto desde un lienzo en blanco. Esto está más orientado a contenido para redes sociales de rápida entrega que a los estilos en los que se centra esta guía, pero vale la pena conocerlo si también produces video.
- Edita imágenes mediante comandos de chat sencillos
Puedes describir un cambio en lenguaje sencillo, como cambiar un fondo o cambiar el tamaño de un logotipo, y Framia Pro lo aplica directamente a la imagen. Esta edición basada en chat evita el enmascaramiento manual o tener que rehacer una generación completa para una pequeña corrección.
Conclusión
En este artículo, exploramos los 7 mejores modelos de generación de imágenes de código abierto y mostramos cómo diferentes herramientas manejan la creación de imágenes, el rendimiento y la flexibilidad. Cada modelo ofrece sus propias fortalezas en áreas como la calidad visual, la velocidad, las necesidades de hardware y el soporte para varios estilos. Framia Pro reúne múltiples modelos en un solo lugar para brindarte más opciones para generar y editar imágenes en un único flujo de trabajo sin cambiar entre herramientas separadas. ¡Pruébalo ahora!
Preguntas frecuentes
¿Qué generador de imágenes de IA de código abierto se utiliza con más frecuencia?
Stable Diffusion sigue siendo uno de los generadores de imágenes de código abierto más utilizados debido a su comunidad activa y su amplio soporte de herramientas. En Framia Pro, puedes acceder a diferentes modelos de imagen en un solo espacio de trabajo, lo que elimina la necesidad de configurar entornos separados para cada generador y permite cambiar más fácilmente entre los resultados.
¿Qué modelos de generación de imágenes producen una mayor calidad visual?
Los modelos más nuevos, como los basados en SDXL y la serie Flux, a menudo generan texturas más claras, una iluminación mejorada y una mejor composición. Framia Pro te brinda acceso a los modelos Nano Banana Pro, Seedream 4.5, Flux Max, Qwen Image y Midjourney v7 para permitirte crear imágenes al instante.
¿Qué modelo funciona mejor para la generación de imágenes en hardware limitado?
Las versiones optimizadas o ligeras de los modelos son más adecuadas para sistemas con VRAM limitada. Framia Pro gestiona el acceso a los modelos en el backend, por lo que puedes ejecutar modelos más pesados sin necesidad de gestionar la configuración local, lo que reduce la necesidad de hardware de gama alta por tu parte.
¿Cuáles se consideran los mejores modelos de generación de imágenes de código abierto?
Modelos como Stable Diffusion, Waifu Diffusion y configuraciones basadas en ControlNet se utilizan comúnmente para diferentes tareas como el realismo, arte de anime y el control estructural. Framia Pro reúne estas opciones, permitiéndote seleccionar y probar múltiples modelos dentro de un solo proyecto.
¿Qué modelos de imagen se prefieren para casos de uso profesional?
Los flujos de trabajo profesionales a menudo requieren resultados estables, consistentes y soporte para edición. Framia Pro aporta valor al ofrecer edición de imágenes basada en chat y generación por lotes, lo que te permite perfeccionar imágenes y producir múltiples variaciones en un solo lugar sin cambiar de herramienta.
¿Cuál es el mejor modelo gratuito de generación de imágenes?
Stable Diffusion 3.5 es la opción gratuita más completa, ya que las variantes Medium y Large Turbo se ejecutan en hardware de consumo y la licencia cubre el uso comercial para empresas más pequeñas. Z-Image-Turbo y Qwen-Image-2512 también son completamente gratuitos bajo Apache 2.0, con una velocidad de generación más rápida pero con una comunidad más pequeña construida a su alrededor hasta el momento.
¿Existe algún generador de imágenes de IA local de código abierto disponible?
Sí. Stable Diffusion 3.5, ControlNet 1.1, FLUX.2, Waifu Diffusion y Z-Image-Turbo se ejecutan localmente en tu propio hardware una vez descargados, sin necesidad de una cuenta en la nube ni suscripción. El requisito principal es tener suficiente VRAM, generalmente de 6 GB a 24 GB según el modelo que elijas.
¿Puedo utilizar modelos de imagen de código abierto para proyectos comerciales?
Sí, pero depende de la licencia del modelo. Algunos modelos permiten el uso comercial, mientras que otros tienen restricciones. Revisa siempre los términos de la licencia antes de utilizar las imágenes generadas para trabajos de clientes, productos o campañas pagadas.