GLM-5 रिव्यू: वर्शन, बेंचमार्क, प्राइसिंग और एक्सेस
GLM-5 के सभी वर्शन, बेंचमार्क, प्राइसिंग, आर्किटेक्चर, लोकल डिप्लॉयमेंट, API एक्सेस और Enter Pro इंटीग्रेशन की पूरी तुलना।
GLM-5 अब कोई एक मॉडल नहीं रहा जिसे किसी एक बेंचमार्क के आधार पर परखा जा सके। यह अब एक पूरा, तेज़ी से आगे बढ़ता मॉडल फैमिली बन गया है: कुछ वर्शन सिर्फ़ टेक्स्ट प्रोसेस करते हैं, कुछ इमेज इनपुट भी लेते हैं, नए वर्शन ने कॉन्टेक्स्ट विंडो बढ़ाकर 10 लाख टोकन कर दी है, और सबसे सस्ता ऑप्शन फ्लैगशिप वर्शन की कीमत का सिर्फ़ एक छोटा हिस्सा है।
इस रिव्यू को अपडेट करने से पहले मैंने Z.ai के रिलीज़ नोट्स, मॉडल कार्ड्स, API डॉक्यूमेंटेशन, रिपॉज़िटरी और असली प्रोडक्ट स्क्रीनशॉट्स देखे हैं। यह ध्यान देने लायक बात है क्योंकि कुछ दावे काफ़ी आकर्षक हैं — जैसे इंटरनल कोडिंग में 50% सुधार या लॉन्ग कॉन्टेक्स्ट में 2.9 गुना कम कंप्यूट — और ये दावे Z.ai की तरफ़ से हैं, किसी इंडिपेंडेंट ऑडिट से नहीं। इसलिए मैं इन्हें "दावे" ही कहूंगा, अपने टेस्टिंग के नतीजे नहीं।
GLM-5 मॉडल चुनते वक़्त चार सवाल ध्यान में रखने चाहिए: आपके पास किस तरह का इनपुट है? टास्क कितना मुश्किल है? इन्फरेंस कहां रन होना चाहिए? अगर रीट्राई करना पड़े, तो एक सफल रिज़ल्ट की लागत कितनी आती है? मेरा छोटा-सा जवाब है: ज़्यादा जटिल टेक्स्ट/कोडिंग के लिए GLM-5.3, मल्टीमोडल या लागत बचाने के लिए GLM-5.3-Flash, और अगर आपके पास पहले से वैलिडेटेड इंटीग्रेशन है तो GLM-5.2 इस्तेमाल करें।
GLM-5 क्या है?
GLM-5, Z.ai द्वारा सॉफ़्टवेयर इंजीनियरिंग, टूल इस्तेमाल और लंबे समय तक चलने वाले एजेंट्स के लिए बनाए गए ओपन-वेट मॉडल फैमिली का नाम है। इसका ओरिजिनल रिलीज़ (फ़रवरी 2026) एक टेक्स्ट-इनपुट, टेक्स्ट-आउटपुट Mixture-of-Experts (MoE) मॉडल है, जिसमें 744 बिलियन टोटल पैरामीटर, प्रति टोकन लगभग 40 बिलियन एक्टिव पैरामीटर, और 2,00,000 टोकन की कॉन्टेक्स्ट विंडो है। ये स्पेसिफिकेशंस GLM-5 टेक्निकल रिपोर्ट और ऑफ़िशियल GitHub रिपॉज़िटरी से लिए गए हैं।
MoE मॉडल हर टोकन के लिए पूरे नेटवर्क को एक्टिवेट नहीं करता। एक राउटर हर टोकन को "एक्सपर्ट्स" के एक छोटे ग्रुप तक भेजता है, जिससे एक्टिव कंप्यूटेशन कम हो जाता है, जबकि चेकपॉइंट बहुत बड़ा ही बना रहता है। इसका मतलब यह नहीं है कि GLM-5 लैपटॉप पर चलने वाला मॉडल है: पूरे वेट्स को अभी भी स्टोरेज, राउटिंग और सर्वर-क्लास हार्डवेयर की ज़रूरत है।
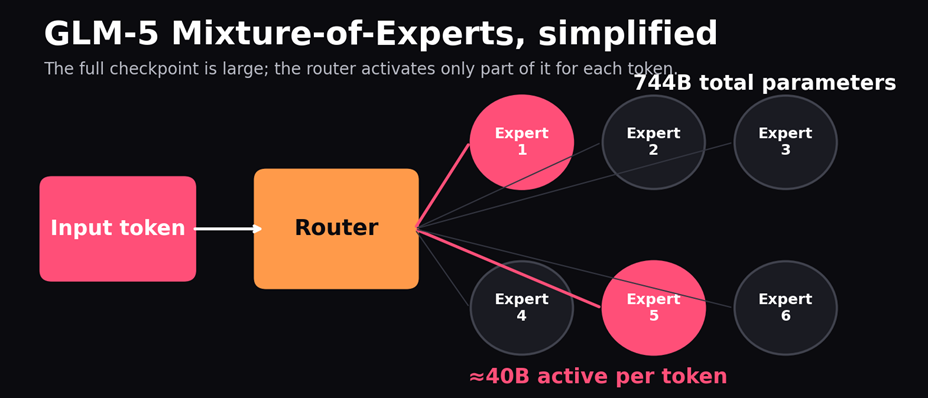
फ़िगर 1. GLM-5 प्रति टोकन 744 बिलियन में से लगभग 40 बिलियन पैरामीटर एक्टिवेट करता है; पूरा चेकपॉइंट अब भी सर्वर-स्केल डिप्लॉयमेंट की मांग करता है।
सही शब्द है "ओपन वेट्स"। कोड, मॉडल वेट्स, होस्टेड सर्विस और ट्रेनिंग डेटा के लिए अलग-अलग शर्तें लागू होती हैं। किसी भी कमर्शियल इस्तेमाल से पहले, आपको जिस मॉडल कार्ड का इस्तेमाल करना है उसके साथ मौजूद लाइसेंस ज़रूर देख लेना चाहिए, क्योंकि हर GLM वर्शन के अधिकार एक जैसे नहीं होते।
GLM-5 वर्शन फैमिली
फैमिली का नाम कई अहम अंतरों को छिपा देता है। आपको मॉडैलिटी, कॉन्टेक्स्ट, वैलिडेशन हिस्ट्री और डिप्लॉयमेंट रूट के आधार पर चुनाव करना चाहिए, न कि हर 5.x वर्शन को एक-दूसरे का विकल्प मान लेना चाहिए।
| वर्शन | इनपुट/कॉन्टेक्स्ट | इस्तेमाल करने की सबसे बड़ी वजह | ज़रूरी चेतावनी |
|---|---|---|---|
| GLM-5 | टेक्स्ट / 2,00,000 | ओरिजिनल रिसर्च या पुराना इंटीग्रेशन | फैमिली का पहला रिलीज़; नए प्रोजेक्ट के लिए मेरी डिफ़ॉल्ट पसंद नहीं |
| GLM-5-Turbo | टेक्स्ट / 2,00,000 | होस्टेड, टूल-हेवी एजेंट वर्क | यह एक प्रोवाइडर रूट है, न कि छोटा डाउनलोडेबल चेकपॉइंट |
| GLM-5V-Turbo | टेक्स्ट, इमेज, वीडियो, फ़ाइलें / 2,00,000 | विज़ुअल कोडिंग और GUI टास्क | अपने एंडपॉइंट पर सपोर्टेड फ़ॉर्मेट कन्फ़र्म करें |
| GLM-5.1 | टेक्स्ट / 2,00,000 | लगातार चलने वाले इंजीनियरिंग टास्क | ज़्यादातर नए इवैल्युएशन के लिए पुराना पड़ चुका है |
| GLM-5.2 | टेक्स्ट / 10 लाख | लॉन्ग कॉन्टेक्स्ट और वैलिडेटेड इंटीग्रेशन | 5.3 पर माइग्रेशन रीज़निंग बिहेवियर बदल देता है |
| GLM-5.3 | टेक्स्ट / 10 लाख | मुश्किल कोडिंग और लॉन्ग-रनिंग एजेंट्स | रीज़निंग हमेशा ऑन रहती है; आउटपुट लंबा हो सकता है |
| GLM-5.3-Flash | मल्टीमोडल / 10 लाख | स्क्रीनशॉट, वॉल्यूम, और कम लागत | अलग 320B/18B आर्किटेक्चर, न कि "कम एफ़र्ट वाला 5.3" |
सोर्स: Z.ai रिलीज़ नोट्स, GLM-5-Turbo गाइड, GLM-5V-Turbo गाइड, और GLM-5.1 गाइड। हो सकता है कि कोई होस्ट मॉडल द्वारा सपोर्टेड कॉन्टेक्स्ट विंडो से छोटी विंडो ऑफ़र करे।
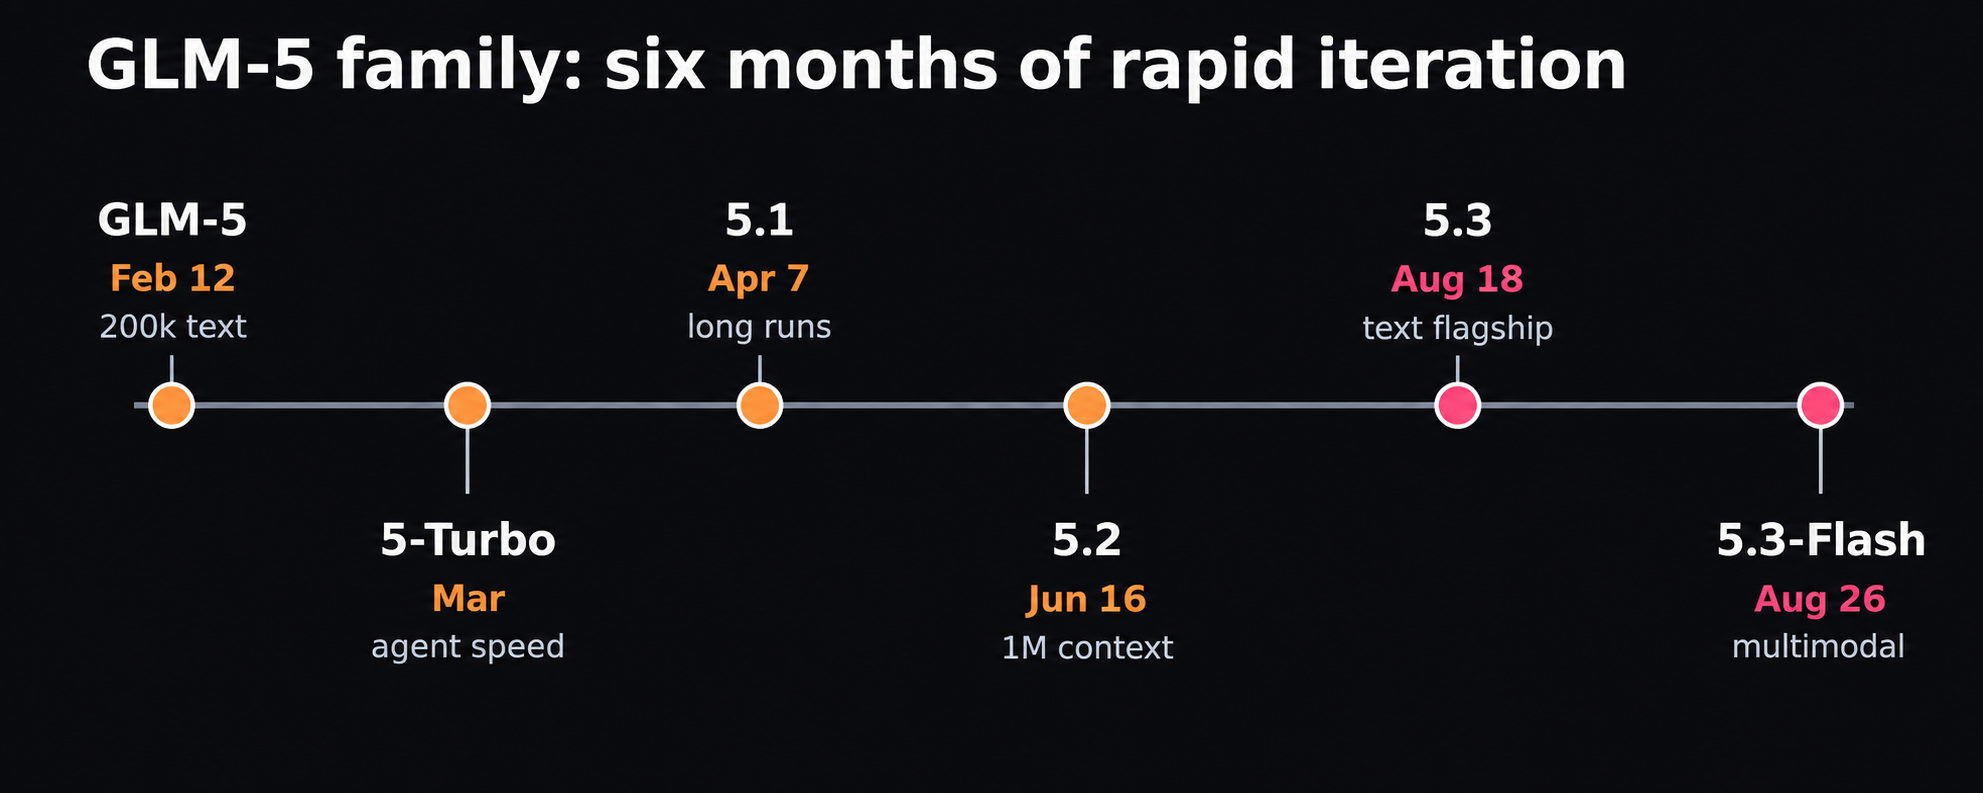
फ़िगर 2. छह महीनों की रिलीज़ ने कॉन्टेक्स्ट लेंथ, मॉडैलिटी, रीज़निंग बिहेवियर और कीमत बदल दी।
GLM-5 से GLM-5.2 तक
एजेंट-बेस्ड आर्किटेक्चर बेस GLM-5 पर ही सेट किया गया था। GLM-5.1 का फ़ोकस लगातार चलने वाले टास्क पर था; Z.ai का दावा है कि यह 8 घंटे तक चल सकता है, लेकिन इसे थोड़ा सावधानी से लेना चाहिए, क्योंकि आपकी रिपॉज़िटरी अलग तरह से व्यवहार कर सकती है। इसके बाद GLM-5.2 में 10 लाख टोकन की कॉन्टेक्स्ट विंडो, फ़्लेक्सिबल एफ़र्ट सेटिंग्स, और लॉन्ग-कॉन्टेक्स्ट अटेंशन को एफ़िशिएंट बनाने के लिए IndexShare जोड़ा गया।
GLM-5.3 और GLM-5.3-Flash
GLM का फ़्लैगशिप मॉडल सिर्फ़ टेक्स्ट पर काम करता है: GLM-5.3। इसके डॉक्यूमेंटेशन के मुताबिक़, इनपुट की लिमिट 10 लाख टोकन है, आउटपुट की लिमिट 1,28,000 टोकन है, और रीज़निंग एफ़र्ट लो, हाई या मैक्स में से कोई एक हो सकता है। थिंकिंग को डिसेबल नहीं किया जा सकता; अगर कोई 5.2 रिक्वेस्ट इसे साफ़-साफ़ डिसेबल करती है, तो वह माइग्रेशन के दौरान फ़ेल हो सकती है।
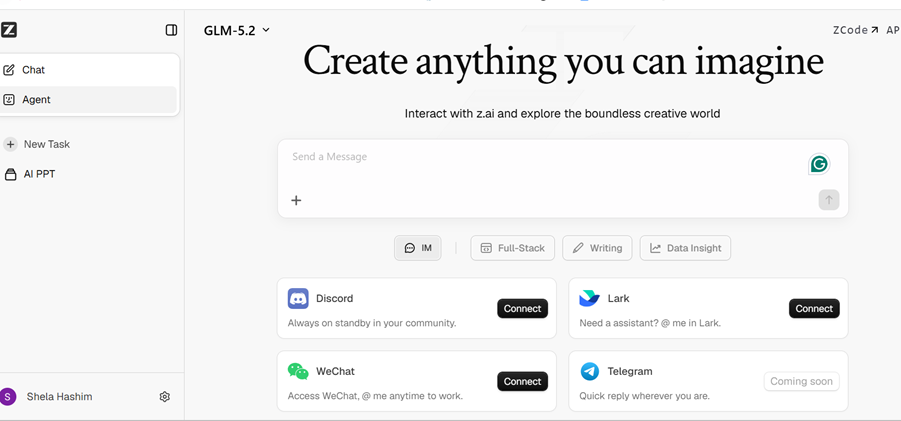
फ़िगर 3. GLM-5.3 का लाइव इंटरफ़ेस एक अलग फ़्लैगशिप रूट होने की पुष्टि करता है; उपलब्धता और लेबल बदल सकते हैं।
GLM-5.3-Flash एक और मॉडल है जिसमें 320B टोटल/18B एक्टिव पैरामीटर हैं, और यह नेटिव मल्टीमोडल इनपुट और हाइब्रिड स्पार्स/लीनियर अटेंशन देता है। मेरी शुरुआती सलाह सीधी-सी है: जब गहराई ज़रूरी हो, 5.3 इस्तेमाल करें; जब बात स्क्रीनशॉट या बड़े वॉल्यूम की हो, पहले Flash टेस्ट करें।
किसी मौजूदा इंटीग्रेशन को बदलने से पहले, सिर्फ़ मॉडल का नाम बदलने के बजाय सेव की गई रिक्वेस्ट्स को फिर से रन करें। स्ट्रक्चर्ड आउटपुट, टूल-कॉल आर्ग्युमेंट्स, मैक्स कम्पलीशन लेंथ, और टाइमआउट हैंडलिंग टेस्ट करें। हो सकता है कि कोई रिस्पॉन्स चैट में ज़्यादा अच्छा दिखे, लेकिन इससे पार्सर फ़ेल हो सकता है या आपकी ऐप की लेटेंसी लिमिट पार हो सकती है। जब तक नया वर्शन उन्हीं प्रोडक्शन गेट्स से न गुज़रे, पुराने रूट को एक्टिव बनाए रखें।
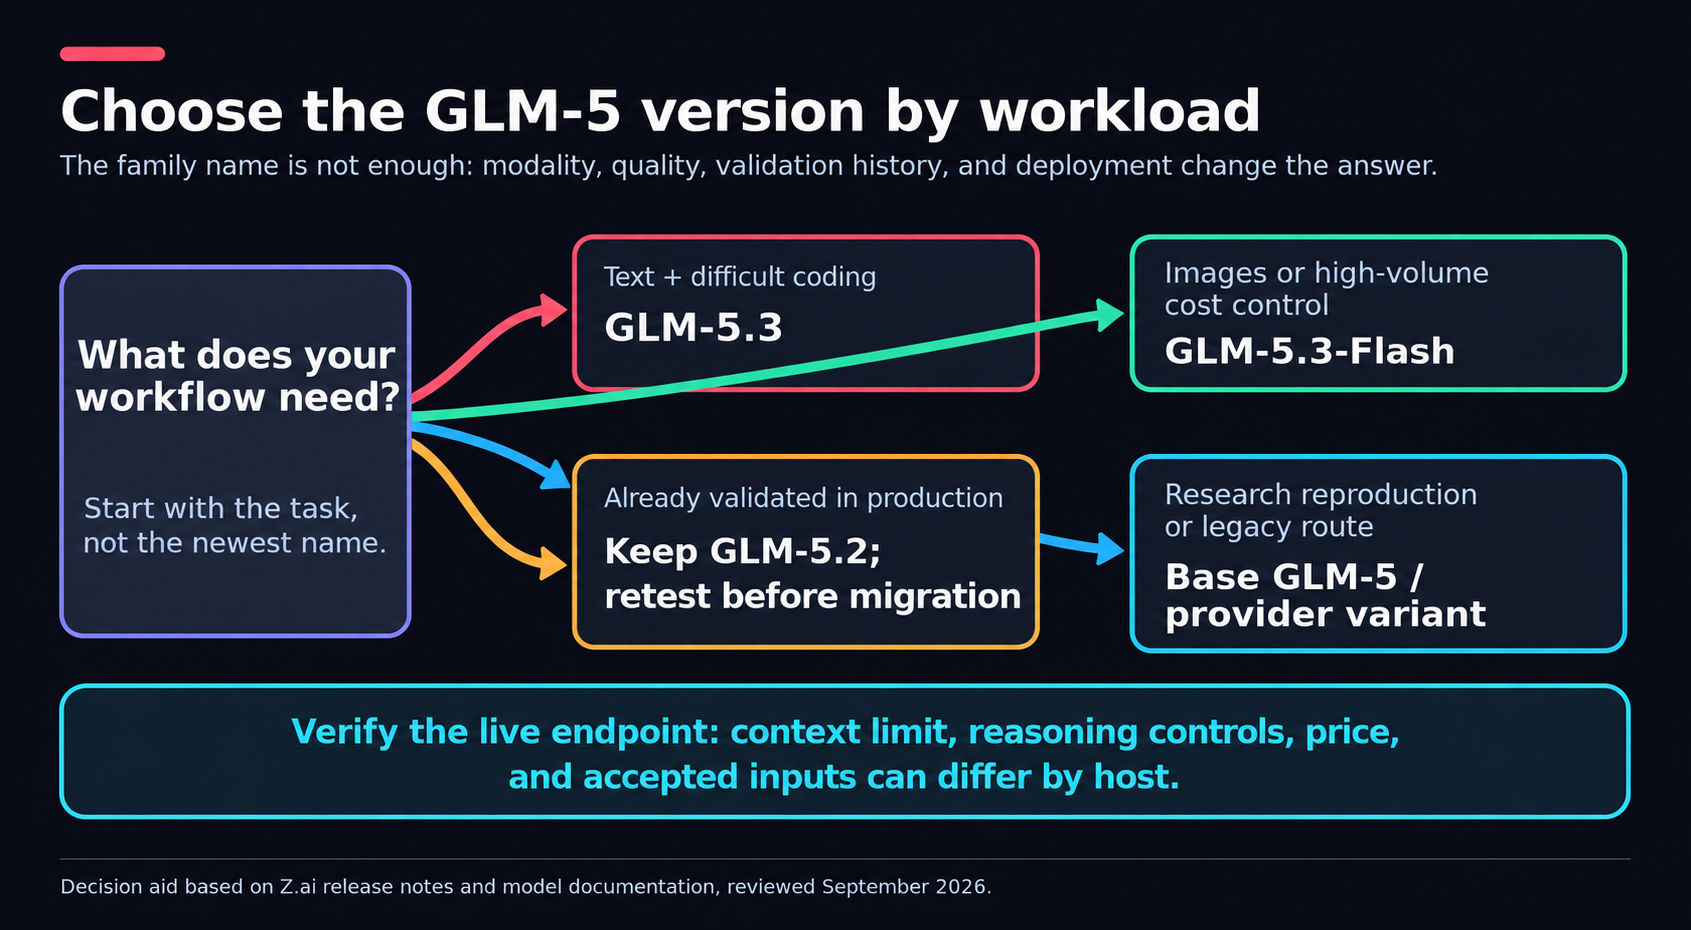
फ़िगर 4. वर्कलोड और एंडपॉइंट के बिहेवियर के आधार पर चुनाव करें, न कि सिर्फ़ सबसे नए मॉडल नाम के आधार पर।
GLM-5 की तुलना Claude, GPT और Gemini से कैसे होती है?
GLM-5.3 किसी भी कोडिंग-एजेंट शॉर्टलिस्ट में जगह पाने लायक है, लेकिन एक टेबल किसी एक ओवरऑल विनर का ऐलान नहीं कर सकती। Terminal-Bench स्कोर हार्नेस, टूल परमिशन, टाइम बजट, और एफ़र्ट लेवल पर निर्भर करते हैं। Z.ai बताता है कि मैक्स एफ़र्ट पर GLM-5.3 ने Terminal-Bench 2.1 पर 88.2 और Terminal-Bench 3.0 पर 28.3 स्कोर किया है; इनकी टेबल में Claude Opus 4.8 और GPT-5.6 Sol के नतीजे भी दोहराए गए हैं।
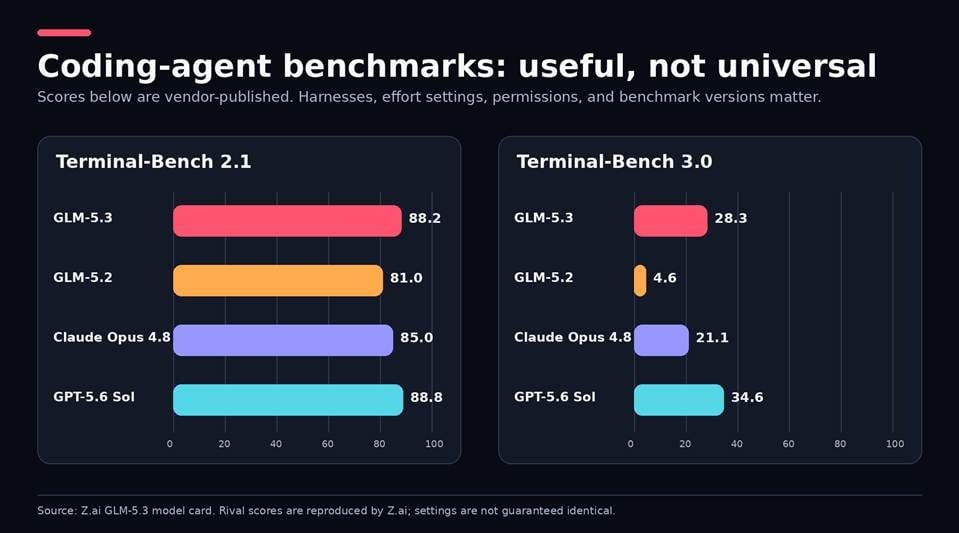
फ़िगर 5. वेंडर द्वारा पब्लिश किए गए स्कोर सिर्फ़ दिशा-निर्देशक सबूत हैं, आपके वर्कलोड के लिए बिल्कुल सेम टेस्ट का विकल्प नहीं।
दूसरे मॉडल्स से अलग, GLM-5.3 का मॉडल कार्ड अपने हार्नेस और एफ़र्ट सेटिंग्स का नाम बताता है। यह यह नहीं बताता कि राइवल मॉडल्स को भी वही शर्तें मिली थीं या नहीं। इसी तरह, GLM-5.2 रिपोर्ट के मुताबिक़, यह Terminal-Bench 2.1 के कुछ टास्क्स में Gemini 3.1 Pro से बेहतर परफ़ॉर्म करता है, जो यहां बताए गए कोडिंग टास्क्स का एक छोटा-सा हिस्सा है; लेकिन इसका मतलब यह नहीं है कि GLM सभी मल्टीमोडल, रिसर्च या राइटिंग टास्क में Gemini 3.1 Pro से बेहतर है।
मैं मॉडल्स को एक ही प्रॉम्प्ट्स, टूल्स, टाइमआउट, और पासिंग क्राइटेरिया के साथ परखना पसंद करूंगा। ध्यान एक सफल टास्क की कीमत पर देना चाहिए, टोकन की कीमत पर नहीं। एक सस्ता मॉडल जो तीन बार फ़ेल होता है, आखिर में ज़्यादा महंगा निकल सकता है, और अगर Flash आपके टेस्ट पहली ही कोशिश में पास कर दे, तो फ़्लैगशिप मॉडल का फ़ायदा बेमानी हो जाता है।
GLM-5.3 का मॉडल कार्ड इस मामले में थोड़ा अलग है कि यह हार्नेस के नाम और एफ़र्ट लेवल बताता है। लेकिन क्या दूसरे राइवल मॉडल्स को भी वैसे ही शर्तों में टेस्ट किया गया था, यह अभी भी साबित नहीं हुआ है। इसी तरह, GLM-5.2 गाइड सिर्फ़ यह कहती है कि यह Terminal-Bench 2.1 — जो कोडिंग एजेंट्स पर फ़ोकस्ड टास्क है — पर Gemini 3.1 Pro से बेहतर है, न कि यह ज़रूरी तौर पर मल्टीमोडल, रिसर्च या राइटिंग टास्क में भी बेहतर है।
मैं मॉडल्स को उन्हीं प्रॉम्प्ट्स, टूल्स, टाइमआउट और पास होने की शर्तों पर जांचूंगा। सिर्फ़ सफल टास्क की लागत पर ध्यान दूंगा, टोकन की कीमत पर नहीं। अगर टेस्ट पहली ही कोशिश में सफल हो जाते हैं, तो Flash शायद ज़्यादा किफ़ायती ऑप्शन हो सकता है, जिससे फ़्लैगशिप मॉडल का फ़ायदा भी शायद उतना ही कम हो जाएगा।
GLM-5 की ट्रेनिंग और आर्किटेक्चर के भीतर
स्पार्स अटेंशन और IndexShare
लॉन्ग कॉन्टेक्स्ट महंगा होता है क्योंकि अटेंशन आम तौर पर टोकन के बीच कई रिलेशनशिप्स पर विचार करता है। GLM-5.2 में एक इंडेक्सर डाला गया है, जिसे चार अलग-अलग अटेंशन लेयर्स में फिर से इस्तेमाल किया जा सकता है, ताकि सही पोज़िशन पता चल सके। Z.ai का कहना है कि 10 लाख टोकन पर प्रति-टोकन FLOPs 2.9 गुना कम हो जाता है। यह डेवलपर की तरफ़ से एफ़िशिएंसी का दावा है, न कि एंडपॉइंट लेटेंसी या असली रिक्वेस्ट कॉस्ट का।
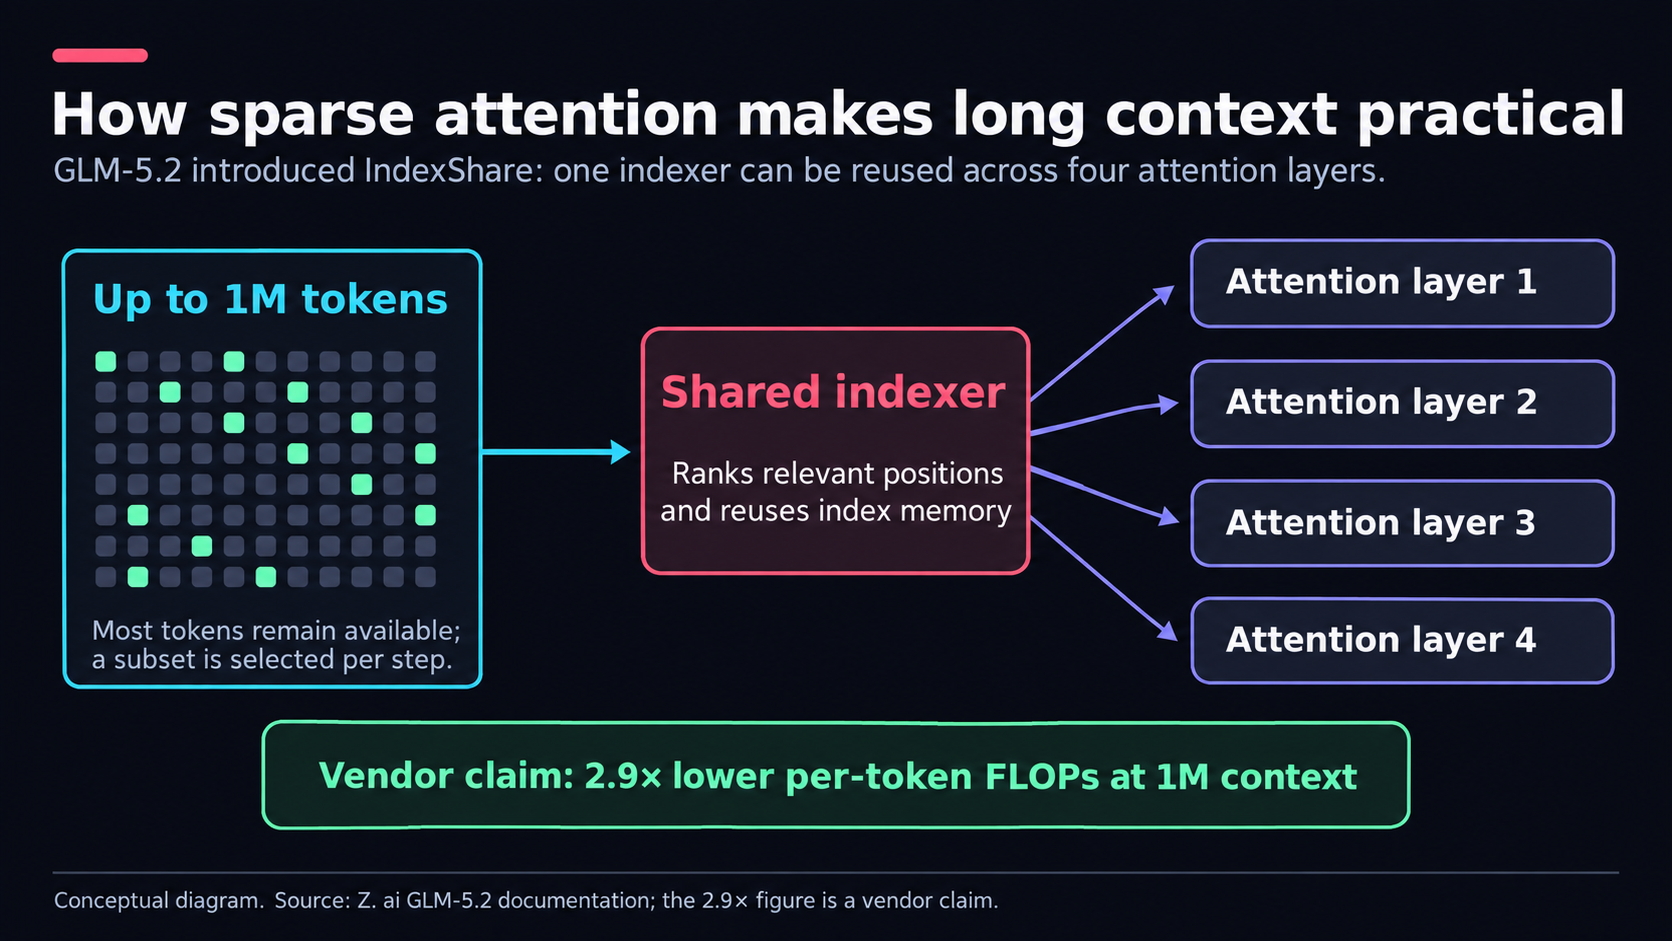
फ़िगर 6. IndexShare एक इंडेक्सर को चार अटेंशन लेयर्स में फिर से इस्तेमाल करता है; 2.9x का आंकड़ा Z.ai का दावा है।
लॉन्ग-होराइज़न रीइनफ़ोर्समेंट लर्निंग
GLM-5.3 के लिए, Z.ai अपने एसिंक्रोनस रीइनफ़ोर्समेंट-लर्निंग सिस्टम के विज़न को पेश करता है, जिसे वे "slime" कहते हैं, साथ ही कॉन्टेक्स्ट कम्पैक्शन और सिंथेसाइज़्ड वेरिफायर्स भी। ये तकनीकें उन चीज़ों पर फ़ोकस करती हैं जो अक्सर एजेंट्स लंबे रन में गलत करते हैं: गोल खो देना, किसी टास्क को छोड़ देना, या जवाब को चेक न करना। फिर भी, कुछ चेकपॉइंट और एक्सटर्नल टेस्ट ज़रूरी होते हैं, इसलिए यह एक लंबा ट्रेजेक्टरी या बड़ा फ़ेल्यर ट्रेस भी बन सकता है।
साइबर सिक्योरिटी क्षमता को इंसानी वैलिडेशन की ज़रूरत है
अपने सिक्योरिटी कोलैबोरेशन के तहत, Z.ai 269 ओपन-सोर्स प्रोजेक्ट्स में से 2,436 वल्नरेबिलिटीज़ का ज़िक्र करता है, जिनमें से 1,097 मीडियम से हाई सिविरिटी की हैं। डिफ़ेंसिव रिव्यू की बात आने पर, ये नंबर GLM-5.3 के लिए काफ़ी मायने रखते हैं, लेकिन GLM-5.3 किसी वल्नरेबिलिटी की पुष्टि नहीं करता, वह सिर्फ़ एक "मॉडल फ़ाइंडिंग" देता है।
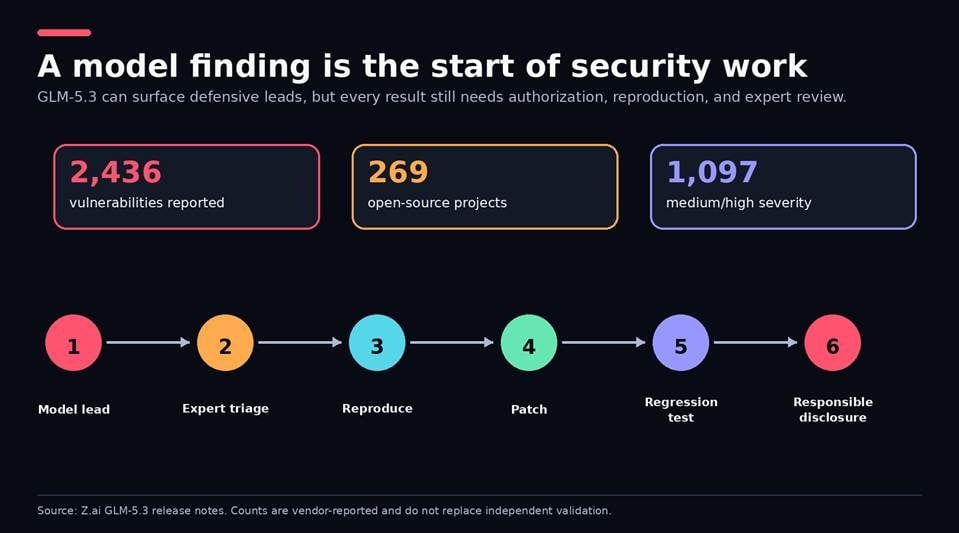
फ़िगर 7. रीप्रोड्यूस करें, पैच करें, रिग्रेशन-टेस्ट करें, और ज़िम्मेदारी से डिस्क्लोज़ करें; किसी ऐसे सिस्टम पर कभी एजेंट न लगाएं जिसे टेस्ट करने के लिए आपको अधिकार नहीं है।
GLM-5 प्राइसिंग
Z.ai सितंबर 2026 से अनकैश्ड इनपुट, कैश्ड इनपुट, और आउटपुट की लागत अलग-अलग दिखाता है। मैंने इन कीमतों को ऑफ़िशियल वेबसाइट की प्राइसिंग पेज से दोबारा चेक किया है; बजट बनाते वक़्त यह मान कर न चलें कि ये कीमतें हमेशा ऐसी ही रहेंगी, क्योंकि ये समय के साथ बदल सकती हैं।
| मॉडल | इनपुट / 10 लाख | कैश्ड इनपुट / 10 लाख | आउटपुट / 10 लाख |
|---|---|---|---|
| GLM-5 | $1.00 | $0.20 | $3.20 |
| GLM-5.1 | $1.40 | $0.26 | $4.40 |
| GLM-5.2 | $1.40 | $0.26 | $4.40 |
| GLM-5.3 | $1.40 | $0.26 | $4.40 |
| GLM-5.3-Flash | $0.15 | $0.03 | $0.50 |
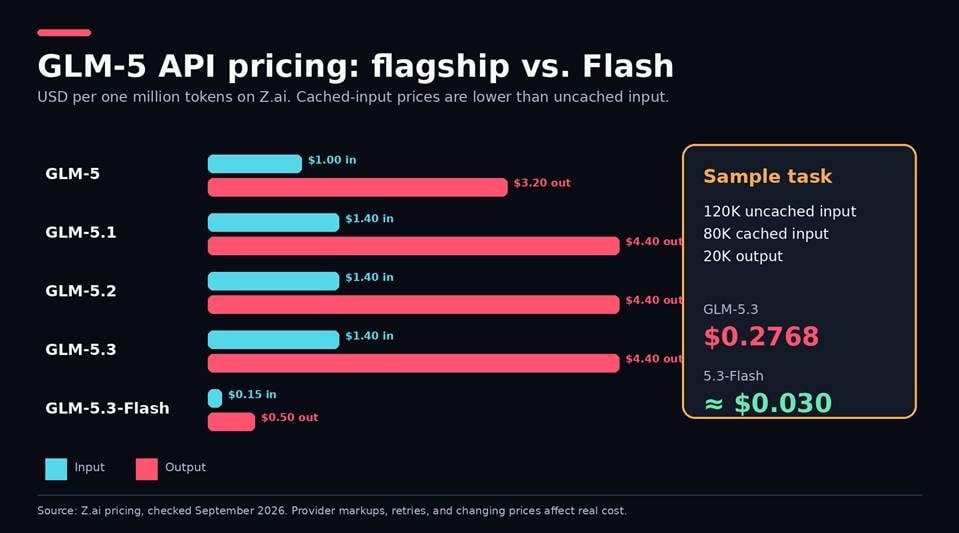
फ़िगर 8. Z.ai की API प्राइसिंग दिखाती है कि आउटपुट लेंथ और रीट्राई फ़ाइनल बिल पर क्यों हावी हो सकते हैं।
GLM-5.3 की लागत लगभग $0.2768 है, जो 1,20,000 अनकैश्ड इनपुट, 80,000 कैश्ड इनपुट, और 20,000 आउटपुट के आधार पर है; 5.3-Flash की लागत लगभग $0.030 है (रीट्राई को छोड़कर)। OpenRouter जैसे दूसरे होस्ट अलग-अलग कीमतें, लिमिट, लेटेंसी, और रूटिंग दे सकते हैं। GLM Coding Plan प्रोडक्शन API अलाउंस नहीं है, बल्कि सपोर्टेड कोडिंग टूल्स के लिए एक अलग सब्सक्रिप्शन है।
आउटपुट रिक्वेस्ट का सबसे महंगा हिस्सा है, और एक एजेंट जो लंबे समय तक रीज़न करता है, वह किसी क्विक एस्टिमेट को आसानी से पार कर सकता है। मैं एक आउटपुट सीलिंग रखूंगा, जहां रीपीटेड कॉन्टेक्स्ट क्वालिफ़ाई करता है वहां कैशिंग इस्तेमाल करूंगा, और हर पूरे हुए टास्क की कॉस्ट लॉग करूंगा। प्रोडक्शन बजट बनाते वक़्त, रीट्राई, फ़ेल हुई टूल कॉल्स, और कमज़ोर रिस्पॉन्स ठीक करने में इंसानों के लगे वक़्त को ज़रूर ध्यान में रखें। यही वह नंबर है जिसकी तुलना आपको प्रोवाइडर-दर-प्रोवाइडर करनी चाहिए।
GLM-5 कैसे इस्तेमाल करें
| रूट | किसके लिए बेस्ट | इन्फरेंस कहां रन होता है |
|---|---|---|
| Z.ai Chat | तेज़ क्वालिटेटिव इवैल्युएशन | Z.ai सर्वर |
| Z.ai API | फ़र्स्ट-पार्टी इंटीग्रेशन | Z.ai सर्वर |
| OpenRouter | प्रोवाइडर चॉइस और फ़ेलओवर | चुना गया होस्टेड प्रोवाइडर |
| Enter MaaS | ऐप-बिल्डिंग वर्कफ़्लो के भीतर मॉडल एक्सेस | Enter में दिखाया गया होस्टेड रूट |
| Hugging Face + vLLM/SGLang | सेल्फ़-मैनेज्ड डिप्लॉयमेंट | आपका अपना इंफ़्रास्ट्रक्चर |
| Ollama :cloud | Ollama क्लाइंट के ज़रिए रिमोट एक्सेस | रिमोट सर्वर, आपका लैपटॉप नहीं |
Z.ai Chat से शुरू करें
GLM-5 चैट को आज़माने का सबसे आसान रूट है chat.z.ai। इसका इस्तेमाल प्रॉम्प्ट बिहेवियर और आउटपुट स्ट्रक्चर टेस्ट करने के लिए करें, लेकिन इंटरफ़ेस में दिखाए गए सटीक मॉडल पर ध्यान दें। किसी टीम से "फ़्री" या "अनलिमिटेड" इस्तेमाल का वादा मौजूदा अकाउंट कोटा चेक किए बिना न करें।
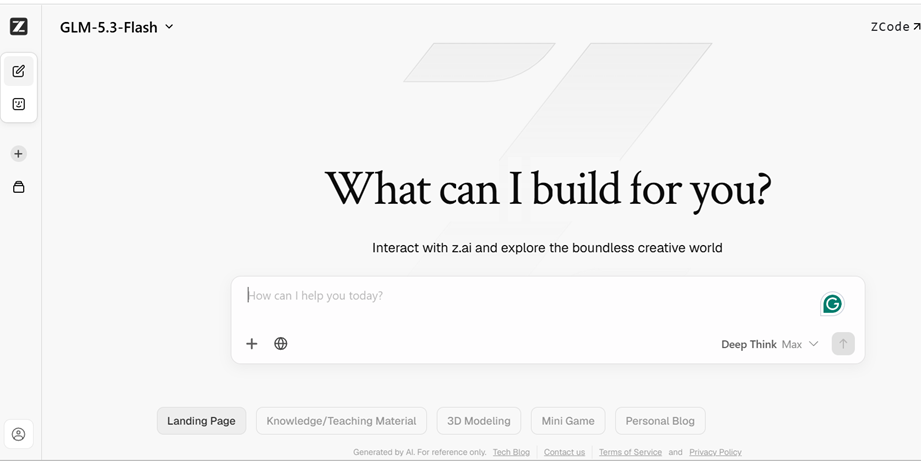
फ़िगर 9. चैट इंटरफ़ेस एक तेज़ क्वालिटेटिव चेक है, लेकिन दिखाया गया मॉडल और अकाउंट कोटा अब भी मायने रखते हैं।
Z.ai API या OpenRouter कॉल करें
Z.ai एक OpenAI-कम्पैटिबल एंडपॉइंट देता है, जिसका मतलब है कि ऑफ़िशियल Python SDK को अलग बेस URL के साथ इस्तेमाल किया जा सकता है। API key को एक एनवायरनमेंट वेरिएबल में स्टोर करें और मॉडल ID, एफ़र्ट, इस्तेमाल किए गए टोकन की संख्या, और क्या रिक्वेस्ट पूरी हुई या नहीं, यह रिकॉर्ड करें।
फ़िगर 10. Z.ai का OpenAI-कम्पैटिबल एंडपॉइंट SDK में बदलाव कम करता है; यह माइग्रेशन टेस्टिंग को खत्म नहीं करता।
import os

from openai import OpenAI

client = OpenAI(

        api_key=os.environ["ZAI_API_KEY"],

        base_url="https://api.z.ai/api/paas/v4/",

)

response = client.chat.completions.create(

        model="glm-5.3",

        messages=[{"role": "user", "content": "List five tests for a password-reset flow."}],

        max_tokens=4096,

        extra_body={"thinking": {"type": "enabled"}, "reasoning_effort": "high"},

)

print(response.choices[0].message.content)
5.2 से माइग्रेट करते वक़्त, वह रिक्वेस्ट हटा दें जो थिंकिंग को डिसेबल करती है; GLM-5.3 इस बिहेवियर को स्वीकार नहीं करता। अगर आप OpenRouter का GLM-5.3 रूट इस्तेमाल करते हैं, तो जब गवर्नेंस या रीप्रोड्यूसिबिलिटी मायने रखती हो, तो यह रिकॉर्ड करें कि रिक्वेस्ट को किस प्रोवाइडर ने हैंडल किया।
वेट्स डाउनलोड करें और सेल्फ़-होस्ट करें
ऑफ़िशियल रिपॉज़िटरी या वेरिफ़ाइड GLM-5.3 Hugging Face कार्ड इस्तेमाल करें। Z.ai सपोर्टेड पाथ्स में SGLang, vLLM, Transformers, KTransformers, और Unsloth को लिस्ट करता है।
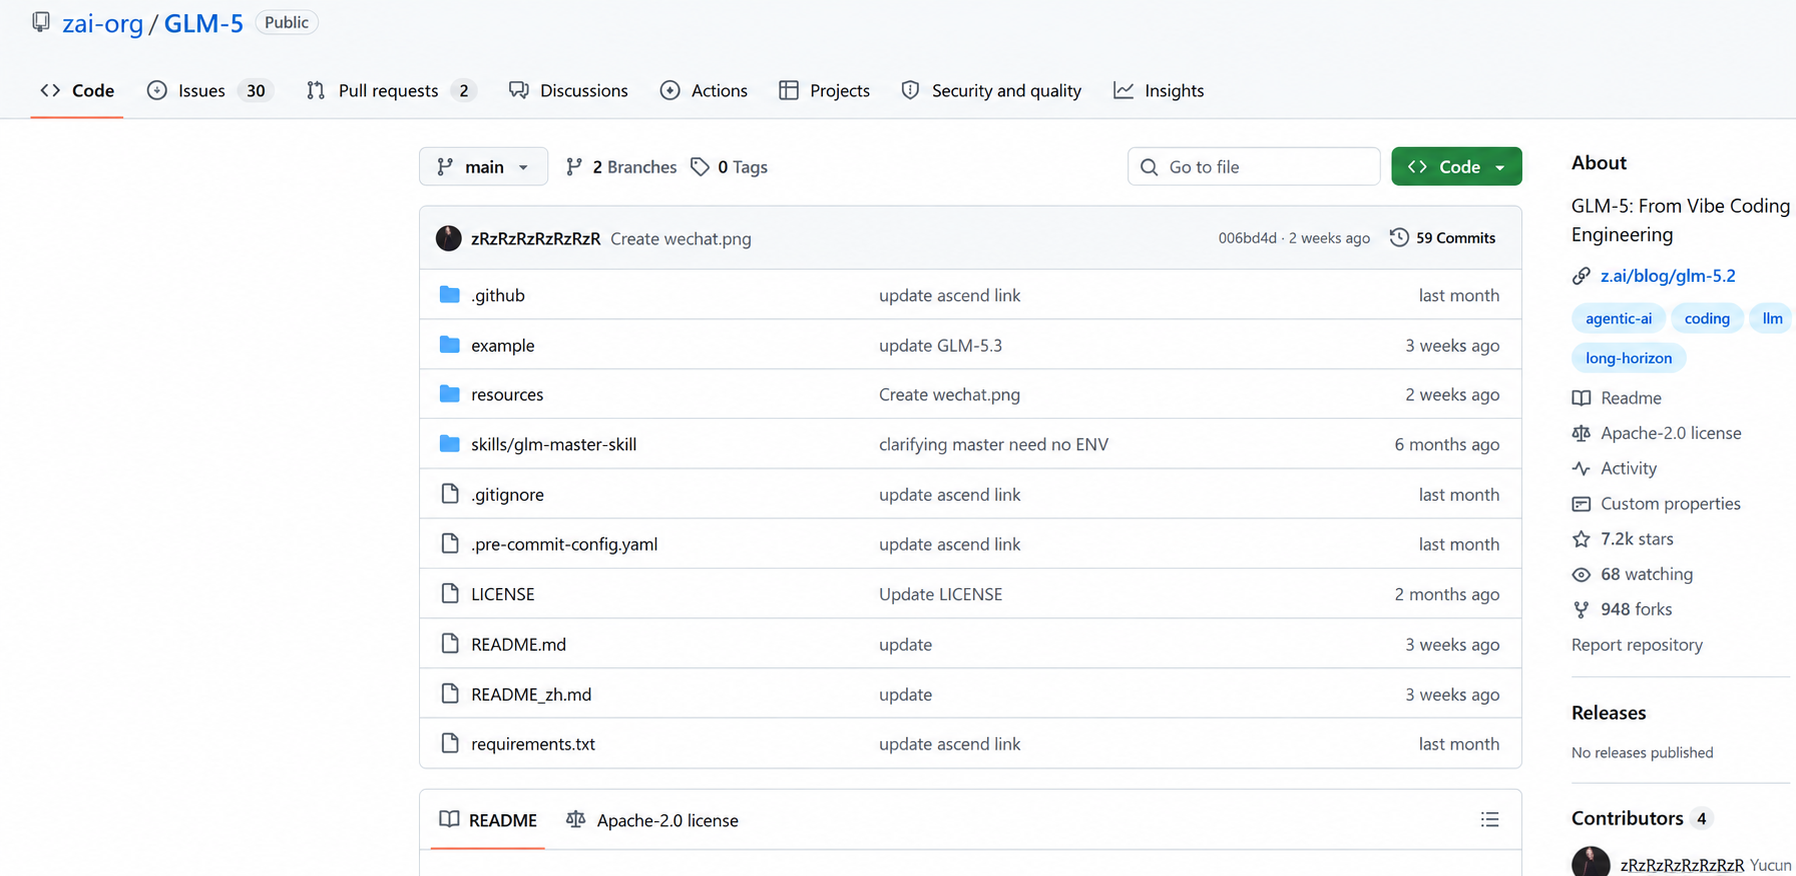
फ़िगर 11. किसी अनऑफ़िशियल वेट मिरर के बजाय वेरिफ़ाइड रिपॉज़िटरी और ऑफ़िशियल मॉडल कार्ड इस्तेमाल करें।
डाउनलोडेबल होने का मतलब रनेबल होना नहीं है। क्वांटाइज़ेशन मेमोरी रिक्वायरमेंट्स कम करता है, लेकिन इससे क्वालिटी पर असर पड़ सकता है; 744B के चेकपॉइंट पर सर्वर-क्लास स्टोरेज और एक्सेलरेटर्स की ज़रूरत पड़ती है। Ollama की GLM-5 लिस्टिंग को ध्यान से पढ़ें: "cloud" टैग का मतलब है कि यह रिमोट इन्फरेंस है। सही मायने में लोकल रन करने के लिए लोकल वेट्स, लोकल रनटाइम, और पर्याप्त हार्डवेयर चाहिए।
प्रोडक्शन से पहले मैं GLM-5 को कैसे इवैल्युएट करूंगा
मैं किसी व्यापक सवाल, जैसे "कौन-सा मॉडल सबसे स्मार्ट है?" से शुरुआत नहीं करूंगा। मैं एक जैसे टूल्स और लिमिट्स के साथ 5.2, 5.3, और Flash के खिलाफ़ चार रिप्रेज़ेंटेटिव टास्क्स रन करूंगा: किसी रिपॉज़िटरी के बग को फ़िक्स करना, किसी लंबे डॉक्यूमेंट में प्लांट किए गए फ़ैक्ट्स को रिट्रीव करना, एक इंड्यूस्ड फ़ेल्यर के साथ मल्टी-टूल वर्कफ़्लो को पूरा करना, और एक लिखित रूब्रिक के खिलाफ़ आउटपुट तैयार करना।
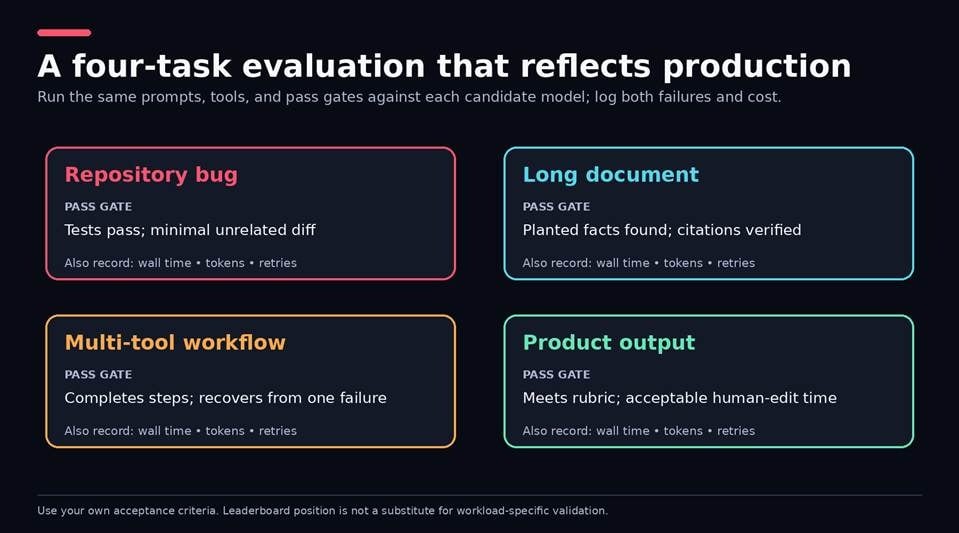
फ़िगर 12. एक छोटा, दोहराया जा सकने वाला वर्कलोड टेस्ट, "सबसे स्मार्ट मॉडल" जैसे व्यापक सवाल से कहीं ज़्यादा उपयोगी है।
पास/फ़ेल, वॉल टाइम, टोकन, रीट्राई, ह्यूमन-एडिट टाइम, और प्रोवाइडर। इससे वे माइग्रेशन रिस्क पहचानना मुमकिन होता है जो बेंचमार्क एवरेज नहीं दिखाते — जैसे 5.3 की हमेशा-ऑन रीज़निंग और संभावित रूप से लंबा आउटपुट। यह आपको यह भी बताता है कि क्या Flash की कम कीमत आपके एक्सेप्टेंस टेस्ट से टकराने के बाद भी कायम रह पाती है।
GLM-5 किसे इस्तेमाल करना चाहिए?
एजेंटिक कोडिंग और रिपॉज़िटरी वर्क
अगर किसी टास्क में रिपॉज़िटरी सर्च करना, को-ऑर्डिनेटेड एडिट्स, टेस्ट एग्ज़ीक्यूशन, और टूल कॉल्स शामिल हैं, तो GLM-5 एक बेहतरीन ऑप्शन है। पब्लिक बेंचमार्क एविडेंस इस शॉर्ट लिस्ट को सपोर्ट करता है, लेकिन आपका एक्सेप्टेंस गेट मज़बूत होना चाहिए: टेस्ट पास होने चाहिए, डिफ़ फ़ोकस्ड होना चाहिए, और किसी भी क्रेडेंशियल या नेटवर्क बाउंड्री को क्रॉस नहीं किया जाना चाहिए। एक अलग वर्क एरिया दें और लीस्ट प्रिविलेज का इस्तेमाल करें। कंट्रोल के बिना ज़्यादा ऑटोनॉमी सिर्फ़ और बड़े फ़ेल्यर ट्रेसेस पैदा करती है।
लंबे डॉक्यूमेंट्स और नॉलेज वर्क
मिलियन-टोकन मॉडल्स स्पेसिफ़िकेशंस, रिसर्च पैकेट्स, और बड़े कोडबेस के लिए उपयुक्त हैं। बड़ी कॉन्टेक्स्ट विंडो को भरोसेमंद रिट्रीवल नहीं माना जाना चाहिए। अहम जानकारी को शुरुआत, बीच और आख़िर में रखें; साइटेशन करें; साइटेड जानकारी को वेरिफ़ाई करें। मैं एक रिट्रीवल पाइपलाइन के साथ भी तुलना करूंगा, क्योंकि सब कुछ एक ही बड़े प्रॉम्प्ट में डालना, पहले उपयोगी एविडेंस छानने से ज़्यादा धीमा और महंगा हो सकता है।
मल्टीमोडल और डिफ़ेंसिव वर्कफ़्लो
GLM-5.3-Flash या GLM-5V-Turbo के साथ, स्क्रीनशॉट, इंटरफ़ेस स्टेट्स, या काम के लिए ज़रूरी किसी भी दूसरे विज़ुअल इनपुट को रूटीन काम का हिस्सा बनाया जा सकता है। सभी फ़ाइंडिंग्स को डिफ़ेंसिव सिक्योरिटी रिव्यू के लिए लीड्स की तरह इस्तेमाल करें, और उन्हें रीप्रोड्यूस व प्राथमिकता दें। GLM-5 उन लोगों के लिए कम उपयुक्त है जो छोटा लोकल लैपटॉप मॉडल चाहते हैं, जो डिप्लॉयमेंट डिसीज़न नहीं ले सकते, या जो होस्ट रेज़िडेंसी और रिटेंशन टर्म्स वेरिफ़ाई नहीं कर सकते।
क्या GLM-5 प्राइवेट या कंपनी के डेटा के लिए सुरक्षित है?
होस्टेड रूट्स
यह सिर्फ़ मॉडल पर नहीं, बल्कि रूट पर भी निर्भर करता है। कई तरह के डेटा पाथ मौजूद हैं, जैसे Z.ai Chat, Z.ai API, कोई दूसरा होस्ट, या सेल्फ़-मैनेज्ड डिप्लॉयमेंट। Z.ai की प्राइवेसी पॉलिसी से शुरुआत करें, और फिर हर इंटरमीडियरी के साथ डेटा रिटेंशन, ट्रेनिंग के लिए इस्तेमाल, डिलीशन, रेज़िडेंसी, और कॉन्ट्रैक्चुअल टर्म्स तय करें।
अगर कोई एग्रीगेटर यह सुविधा देता है, तो एक प्रोवाइडर पिन करें, और सिर्फ़ सुविधा के लिए सीक्रेट्स न भेजें। होस्टेड डेटा के साथ क्या होता है, यह आपके कॉन्ट्रैक्ट और कॉन्फ़िगरेशन से तय होता है, "ओपन वेट्स" जैसे शब्दों से नहीं।
सेल्फ़-होस्टिंग
सेल्फ़-होस्टिंग प्रॉम्प्ट्स को आपके एनवायरनमेंट में ही रखती है, लेकिन वेट्स, क्रेडेंशियल्स, पैचिंग, नेटवर्क कंट्रोल्स, और मॉनिटरिंग की ज़िम्मेदारी आप पर ही होती है। फिर भी मैं यह मान कर चलूंगा कि कोई रास्ता ऐसा है जिससे शुरुआत में ही कोई असुरक्षित जनरेटेड कोड इंजेक्ट किया जा सके। बिल्ड और प्रोडक्शन क्रेडेंशियल्स को अलग करें, आउटबाउंड नेटवर्क एक्सेस सीमित करें, टूल एक्शन्स को ऑडिट करें, और बड़े बदलावों के लिए इंसानी अप्रूवल बनाए रखें। एजेंट्स को टास्क की ज़रूरत से ज़्यादा अधिकार न दें।
Enter Pro के साथ GLM-5 कैसे इस्तेमाल करें
GLM-5, Enter Pro का डायरेक्ट कॉम्पिटिटर नहीं है। GLM मॉडल कैपेबिलिटी देता है, जबकि Enter Pro मॉडल्स के आसपास एक प्रोडक्ट-बिल्डिंग वर्कफ़्लो देता है। यह तब उपयोगी होता है जब आप सिर्फ़ "कंप्लीशन पाना" नहीं, बल्कि "ऐसा कंप्लीशन पाना चाहते हैं जिसे इंटरफ़ेस, लॉजिक, और पब्लिशिंग पाथ में बदला जा सके।"
अगर API कंट्रोल, कस्टम इंफ़्रास्ट्रक्चर, या किसी खास डेटा स्ट्रक्चर की ज़रूरत है, तो डायरेक्ट रूट बेहतर ऑप्शन है। जब प्रोडक्ट-लेवल वर्कअराउंड एक लिमिटिंग फ़ैक्टर बन जाए, तब Enter Pro काम में आता है। इसका AI MVP Builder प्लानिंग, ऐप क्रिएशन, विज़ुअल एडिटिंग, और पब्लिशिंग को एक ही प्रोसेस में स्ट्रीमलाइन करता है, जबकि Enter Code रिपॉज़िटरी टास्क के लिए एक टर्मिनल-सेंट्रिक अप्रोच देता है।
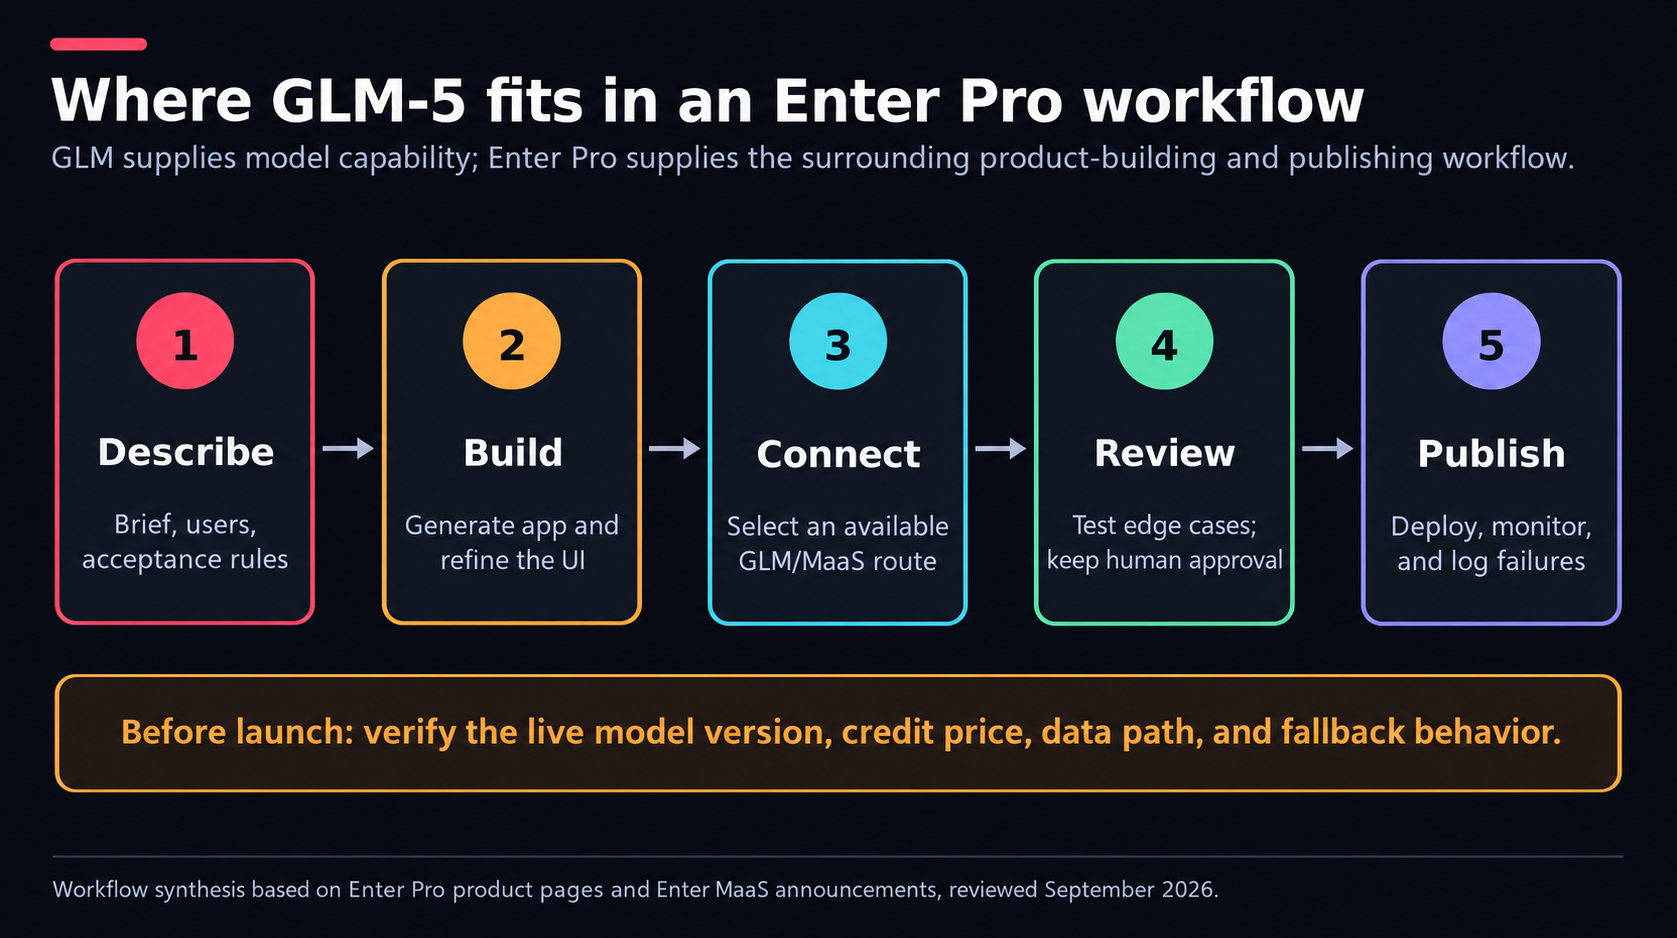
फ़िगर 13. मॉडल जनरेट या क्लासिफ़ाई करता है; प्रोडक्ट वर्कफ़्लो UI, रिव्यू, डिप्लॉयमेंट, और मॉनिटरिंग जोड़ता है।
Enter का चेंजलॉग कन्फ़र्म करता है कि GLM-5.2, 17 जून तक पिछले AI All कैटलॉग में था। Enter MaaS की घोषणा में GLM 5 का ज़िक्र है और यह बताया गया है कि मॉडल्स को क्रेडिट्स में कैसे प्राइस किया जाता है। यह GLM-5.3 को साफ़-साफ़ कन्फ़र्म नहीं करता, इसलिए किसी खास वर्शन के आसपास डिज़ाइन करने से पहले लाइव मॉडल सिलेक्टर, क्रेडिट प्राइस, कॉन्टेक्स्ट लिमिट, और डेटा पाथ ज़रूर चेक करें।
एक सपोर्ट-ट्रायेज ऐप यह अच्छी तरह दिखाता है कि यह कॉम्बिनेशन कहां सही बैठता है। Enter Pro के साथ, आप टिकट फ़ॉर्म और डैशबोर्ड डिज़ाइन कर सकते हैं, और टिकट्स को कैटेगराइज़ करने और रिस्पॉन्स बनाने के लिए किसी मौजूदा GLM रूट को लिंक कर सकते हैं। पब्लिश करने से पहले, मॉडल के खाली रिस्पॉन्स, अस्पष्ट रिक्वेस्ट्स, मल्टीलिंग्वल इनपुट, प्रॉम्प्ट इंजेक्शन, और मैसेज बॉडी के भीतर प्राइवेट डेटा को वैलिडेट करें। ड्राफ़्ट और सेंड बटन के बीच हमेशा एक इंसान को रखें।
| अगर आपकी प्रायोरिटी है… | डायरेक्ट GLM रूट चुनें | Enter Pro चुनें |
|---|---|---|
| मॉडल पैरामीटर और प्रोवाइडर कंट्रोल | हां | सिर्फ़ उपलब्ध ऑप्शंस के भीतर |
| विज़ुअल ऐप क्रिएशन और एडिटिंग | अलग टूलिंग बनाएं या जोड़ें | वर्कफ़्लो का मुख्य फ़ायदा |
| कस्टम होस्टिंग और नेटवर्क पॉलिसी | सबसे मज़बूत फ़िट | पहले प्लेटफ़ॉर्म फ़िट वेरिफ़ाई करें |
| मॉडल आउटपुट से प्रोडक्ट UI तक का तेज़ रास्ता | ज़्यादा इंजीनियरिंग चाहिए | मज़बूत फ़िट |
लेकिन Enter, GLM को ज़्यादा स्मार्ट नहीं बनाता, और GLM का किसी ऐप तक एक्सेस होना भी उसके कोडिंग एजेंट को ज़्यादा स्मार्ट नहीं बनाता। अगर बात इंटीग्रेशन या UI वर्क की हो, तो मैं Enter चुनूंगा। अगर आप इस स्थिति में हैं, तो Enter Pro वर्कस्पेस खोलें और अपनी आर्किटेक्चर पर कमिट करने से पहले मौजूद मॉडल कैटलॉग चेक करें।
निष्कर्ष
हालांकि इसे GLM-5 कहा जाता है, लेकिन कोडिंग और लॉन्ग-होराइज़न एजेंट्स के मामले में वर्शन और सर्व करने का तरीका मॉडल जितना ही अहम है! मुश्किल टेक्स्ट और कोड के लिए GLM-5.3, मल्टीमोडल और/या वॉल्यूम के लिए GLM-5.3-Flash इस्तेमाल करें, और माइग्रेशन कॉस्ट-इफ़ेक्टिव होने तक 5.2 को बनाए रखें। फिर, लीडर/वेंडर के नंबरों को प्रोडक्शन एविडेंस की तरह इस्तेमाल करने से पहले अपने ही टास्क पर टेस्ट करें।
वह मॉडल जो असल में काम करता है, वही है जो आपके एक्सेप्टेंस क्राइटेरिया पर फ़िट बैठता है, आपकी लेटेंसी और प्राइवेसी रेंज के भीतर रहता है, और रीट्राई के बाद भी सही कीमत बनाए रखता है — उस एक खास बेंचमार्क पर मिले करीब-करीब परफ़ेक्ट स्कोर से कोई फ़र्क़ नहीं पड़ता।
Enter Pro के साथ बनाना शुरू करें →
अक्सर पूछे जाने वाले सवाल
क्या GLM-5 फ़्री है?
पब्लिक वेट्स डाउनलोड के लिए उपलब्ध हैं, बिना किसी पर-टोकन API फ़ीस के, लेकिन हार्डवेयर और ऑपरेशंस के लिए पैसे खर्च करने होंगे। Z.ai Chat कोटा-बेस्ड एक्सेस दे सकता है। होस्टेड APIs, राउटर्स, और GPU सर्वर पेड सर्विसेज़ हैं, और वर्शन और रूट के हिसाब से इसमें फ़र्क़ हो सकता है।
GLM-5 का कौन-सा वर्शन बेहतर है?
मुश्किल टेक्स्ट/कोडिंग के लिए, मैं GLM-5.3 से शुरुआत करता हूं। इमेज, स्क्रीनशॉट, या कॉस्ट-क्रिटिकल वॉल्यूम के लिए GLM-5.3-Flash बेहतर शुरुआती टेस्ट है। GLM-5.2 को न बदलें अगर वह पहले से वैलिडेटेड है और माइग्रेशन का रिस्क उसके फ़ायदे से ज़्यादा है।
क्या GLM-5 कोड लिख और डीबग कर सकता है?
हां। कोडिंग एजेंट्स और रिपॉज़िटरी-स्केल इंजीनियरिंग इसके मुख्य इस्तेमाल हैं, और वेंडर्स ने Terminal-Bench और DeepSWE पर अच्छे नतीजे बताए हैं। फिर भी सैंडबॉक्स, टेस्ट, रिस्ट्रिक्टेड परमिशन, और ह्यूमन रिव्यू की ज़रूरत बनी रहती है।
GLM-5 API की कीमत कितनी है?
सितंबर 2026 में, Z.ai GLM-5 को प्रति मिलियन टोकन $1.00 इनपुट और $3.20 आउटपुट पर लिस्ट करता है; GLM-5.3 को $1.40 और $4.40 पर; और 5.3-Flash को $0.15 और $0.50 पर। कैश्ड इनपुट सस्ता होता है। असली लागत प्रोवाइडर मार्कअप और रीट्राई से प्रभावित होती है।
क्या GLM-5 ओपन-सोर्स सॉफ़्टवेयर है?
"ओपन वेट्स" कहना ज़्यादा सही है। वेट लाइसेंस, रिपॉज़िटरी कोड लाइसेंस, और ट्रेनिंग-डेटा ट्रांसपेरेंसी अलग-अलग सवाल हैं। किसी कमर्शियल डिप्लॉयमेंट से पहले, ख़ास तौर पर Hugging Face मॉडल कार्ड और रिपॉज़िटरी लाइसेंस ज़रूर चेक करें।
क्या GLM-5 को लोकली (Ollama के साथ) इस्तेमाल किया जा सकता है?
सिर्फ़ तब, जब आपके पास लोकल वेट्स, रनटाइम सपोर्ट, और उसके लिए पर्याप्त हार्डवेयर हो। cloud टैग का मतलब है कि यह रिमोट इंफ़्रास्ट्रक्चर पर रन हो रहा है, इसलिए इसका यह मतलब नहीं है कि पूरा 744B मॉडल आपके डिवाइस पर रन कर रहा है।
क्या GLM-5 इमेज प्रोसेस कर सकता है?
बेस GLM-5 और GLM-5.3, दोनों सिर्फ़ टेक्स्ट के लिए हैं। मल्टीमोडल इनपुट के लिए GLM-5.3-Flash या GLM-5V-Turbo इस्तेमाल करें; चुने गए एंडपॉइंट पर सपोर्टेड फ़ाइल टाइप्स चेक करें।