Bagikan


Poin-poin penting
- Model pembuatan gambar sumber terbuka dapat menawarkan cara untuk membuat dan mengedit gambar tanpa langganan berulang atau biaya lisensi model terpisah.
- Hugging Face menampung hampir 109.255 model teks-ke-gambar, sehingga kreator memiliki berbagai macam pilihan untuk gaya, kecepatan, dan kebutuhan perangkat keras.
- Stable Diffusion 3.5, FLUX, dan Qwen-Image-2512 memimpin bidang ini untuk karya kreatif umum, akurasi prompt, dan lisensi komersial.
- ControlNet 1.1 dan Waifu Diffusion mencakup kebutuhan khusus, seperti kontrol struktural dan seni gaya anime.
- Z-Image-Turbo dan GLM-Image menonjol karena kecepatan dan pembuatan gambar yang padat teks, seperti poster dan infografis.
- Framia Pro menyatukan model tertutup seperti Nano Banana Pro, Midjourney v7, and Seedream 4.5 ke dalam satu ruang kerja untuk kreator yang menginginkan hasil tanpa harus mengelola pengaturan lokal.
Model pembuatan gambar sumber terbuka telah membuka dunia yang sama sekali baru bagi para kreator, pengembang, dan bisnis. Anda sekarang dapat mengubah teks menjadi gambar, mengedit foto, memproduksi video, dan membuat objek 3D, tanpa menghabiskan banyak uang untuk perangkat lunak. Ruang ini telah berkembang pesat, dengan hampir 109.255 model teks-ke-gambar tersedia di Hugging Face saja. Beralih ke sumber terbuka berarti tidak ada langganan, kontrol penuh atas data Anda, dan kebebasan untuk menyesuaikan berbagai hal sesuai kebutuhan Anda. Panduan ini membahas model-model terbaik di luar sana dan hal lain yang Anda butuhkan untuk langsung memulainya.
Apa itu model pembuatan gambar sumber terbuka?
Model pembuatan gambar sumber terbuka adalah program perangkat lunak yang membuat gambar dari deskripsi tertulis. Anda mengetik apa yang ingin Anda lihat, katakanlah matahari terbenam di atas pegunungan, maket produk, karakter kartun, dan model tersebut akan menghasilkannya sebagai gambar.
Bayangkan seperti mempekerjakan seorang seniman yang telah mempelajari jutaan lukisan, foto, dan ilustrasi sepanjang hidup mereka. Anda mendeskripsikan apa yang Anda inginkan, dan mereka akan menggambarnya untuk Anda dalam hitungan detik. Bedanya, seniman ini tidak pernah tidur, tidak pernah mengenakan biaya per proyek, dan tinggal di komputer Anda sendiri.
Apa yang membuat mereka disebut "sumber terbuka" adalah karena kodenya tersedia untuk umum. Siapa saja dapat mengunduh, menggunakan, memodifikasi, atau membangun di atasnya secara gratis. Ini berbeda dengan alat berbayar seperti Midjourney atau Adobe Firefly, di mana Anda membayar untuk mengakses perangkat lunak dan tidak memiliki kontrol atas cara kerjanya di balik layar.
Model-model ini dilatih pada jutaan gambar, yang mengajarkan mereka untuk memahami hubungan antara kata-kata dan visual. Seiring waktu, mereka telah menjadi cukup baik untuk menghasilkan hasil berkualitas profesional, dan yang terbaik kini menyaingi opsi komersial yang mahal.
Mengapa memilih sumber terbuka daripada model gambar tertutup
Model gambar berbayar memang nyaman, tetapi memiliki batasan nyata. Anda membayar per gambar, menyerahkan data Anda ke server pihak ketiga, dan tidak memiliki hak suara dalam cara kerja perangkat lunak tersebut. Model sumber terbuka menyelesaikan semua itu. Berikut adalah alasan mengapa lebih banyak kreator dan pengembang beralih.
- Kontrol penuh atas hasil
Dengan alat tertutup, platform menentukan apa yang dapat dan tidak dapat Anda buat. Model sumber terbuka berjalan pada pengaturan Anda sendiri, jadi Anda yang menetapkan aturannya. Anda mendapatkan persis apa yang Anda minta, tanpa filter konten atau batasan platform yang menghalangi.
- Kemampuan untuk melakukan fine-tune pada model
Model tertutup dikunci dan tidak dapat diubah agar sesuai dengan kebutuhan spesifik Anda. Namun, Anda dapat melatih model sumber terbuka lebih lanjut pada gambar, gaya, atau panduan merek Anda sendiri. Ini berarti hasilnya mulai terlihat dan terasa seperti milik Anda, bukan seperti milik orang lain yang menggunakan alat yang sama.
- Tanpa biaya per gambar
Sebagian besar alat komersial mengenakan biaya untuk setiap gambar yang Anda buat, yang dengan cepat menumpuk. Namun dengan model sumber terbuka, Anda menjalankan semuanya di perangkat keras Anda sendiri dan menghasilkan gambar sebanyak yang Anda inginkan. Satu-satunya biaya adalah listrik dan mesin yang melakukan pekerjaan tersebut.
- Privasi dan penggunaan offline
Saat Anda menggunakan alat berbasis cloud, prompt dan gambar Anda melewati server orang lain. Model sumber terbuka dapat berjalan sepenuhnya secara offline, sehingga tidak ada yang meninggalkan mesin Anda. Ini sangat penting bagi bisnis yang menangani proyek sensitif atau konten kepemilikan.
- Dukungan komunitas yang besar
Model sumber terbuka didukung oleh ribuan pengembang, peneliti, dan kreator di seluruh dunia. Mereka membagikan versi yang telah di-fine-tune, tutorial, plugin, dan perbaikan setiap hari. Jika Anda mengalami masalah, seseorang di komunitas kemungkinan besar sudah menyelesaikannya.
Bagaimana saya menguji dan memilih model-model ini
Saya bekerja dengan alat AI kreatif, dan saya bosan melihat daftar "terbaik" yang hanya menyalin lembar spesifikasi dari halaman GitHub suatu model. Jadi sebelum memeringkat apa pun di sini, saya menghabiskan waktu seminggu untuk benar-benar menjalankan setiap model sendiri untuk melihat bagaimana kinerjanya di luar tangkapan layar pemasaran.
Saya menjalankan komputer desktop cadangan dengan RTX 4090 dan VRAM 24GB di rumah, jadi itu menjadi rig pengujian utama saya. Untuk model yang lebih besar yang membutuhkan lebih banyak memori, seperti FLUX.2 pada 32B dan Qwen-Image-2512, saya menyewa GPU cloud per jam alih-alih menebak output mereka dari lembar spesifikasi saja.
Saya membuat satu set berisi 20 prompt dan menjalankan daftar yang sama di setiap model, tanpa memilih-milih hasil terbaik (no cherry-picking). Prompt tersebut mencakup lima area: potret fotorealistis, foto produk dengan latar belakang polos, poster dengan tajuk utama dan cetakan kecil, karakter bergaya anime, dan pemandangan sibuk dengan beberapa objek di dalamnya. Setiap model mendapat tiga kali percobaan per prompt, dan saya menyimpan yang terbaik dari ketiganya, cara yang sama seperti kebanyakan orang menggunakan alat-alat ini.
Untuk penilaian, saya menilai setiap hasil dari 1 hingga 5 pada empat hal: seberapa dekat output cocok dengan prompt, seberapa bersih detail halus terlihat pada resolusi penuh, berapa lama pembuatan gambar berlangsung pada perangkat keras saya, dan apakah teks di dalam gambar (ketika prompt memintanya) benar-benar terbaca. Saya mencatat angka-angka tersebut di spreadsheet saat saya melakukannya alih-alih mengandalkan ingatan setelahnya, karena beberapa model terasa membingungkan dan bercampur aduk setelah pengujian sore penuh.
Beberapa hal menonjol dengan cepat. Z-Image-Turbo menyelesaikan batch 20 prompt-nya dalam waktu kurang dari empat menit secara total, sementara FLUX 2 pada 32B membutuhkan waktu mendekati 40 menit pada GPU sewaan. GLM-Image dan Qwen-Image-2512 adalah satu-satunya dua model yang secara konsisten menghasilkan teks kecil dengan benar pada prompt poster tanpa huruf yang rusak. Waifu Diffusion memenangkan prompt anime dengan selisih yang besar, tetapi sangat kesulitan pada potret fotorealistis, yang sesuai dengan apa yang saya harapkan dari model yang dilatih pada dataset yang sempit.
Saya memeringkat tujuh model di bawah ini berdasarkan pengujian tersebut, tidak hanya pada spesifikasi di atas kertas atau kehebohan komunitas, dan saya mencatat di mana penggunaan VRAM dunia nyata suatu model berjalan lebih tinggi daripada batas minimum resminya setelah saya memuat pipeline penuh dengan ukuran batch yang layak.
7 Teratas model pembuatan gambar sumber terbuka
Berbagai generator gambar AI sumber terbuka fokus pada kekuatan yang berbeda seperti realisme, kecepatan, kontrol struktur, atau akurasi teks. Di bawah ini adalah tujuh model yang banyak digunakan, masing-masing dengan tujuan yang jelas.
| Model | Arsitektur | VRAM Min | Lisensi | Kekuatan Utama | Terbaik Untuk |
| Stable Diffusion 3.5 | Latent diffusion (DiT) | 8 GB+ | Komersial | Ekosistem besar, dukungan LoRA, komunitas aktif | Pekerjaan kreatif umum, pemula, alur kerja berbasis plugin |
| ControlNet 1.1 | Add-on SD terkondisi | 8 GB+ | Apache 2.0 | Kontrol pose, peta kedalaman, panduan tepi | Konsistensi karakter, tata letak arsitektur, pembuatan terpandu |
| FLUX.2 | Flow matching transformer (4B–32B) | 13 GB (4B) / 24 GB (32B) | BFL Komersial | Dukungan referensi multi-gambar dan kepatuhan prompt yang kuat | Visual berkualitas tinggi, aset bermerek, konten pemasaran |
| GLM-Image | Hibrida AR + DiT (9B + 7B) | ~16 GB | Penelitian / Kustom | Perenderan teks yang kuat, mendukung tipografi Mandarin, edit + buat dalam satu alur | Poster, mockup UI, desain dwibahasa, infografis |
| Qwen-Image-2512 | Difusi + model bahasa visi (20B) | ~16 GB | Apache 2.0 | Teks multibahasa, pengeditan RGBA berlapis, dukungan ControlNet | Alur kerja komersial, pengeditan tingkat lanjut, konten multibahasa |
| Waifu Diffusion | Stable Diffusion yang disesuaikan (dataset anime) | 6 GB+ | CreativeML OpenRAIL | Gaya anime, visual manga, output yang berfokus pada karakter | Game, novel visual, karya seni bergaya anime |
| Z-Image-Turbo | Distilled diffusion transformer (6B) | 16 GB | Apache 2.0 | Latensi sangat rendah, mendukung bahasa Inggris + Mandarin, pemrosesan batch | Aplikasi real-time, pipeline skala besar, penerapan edge |
- Stable Diffusion 3.5
Stable Diffusion 3.5 adalah Multimodal Diffusion Transformer (MMDiT) model teks-ke-gambar yang dikembangkan oleh Stability AI. Ini meningkatkan kualitas gambar, tipografi, pemahaman prompt, dan kinerja secara keseluruhan. Model ini hadir dalam tiga ukuran, yang dirancang untuk pengaturan perangkat keras dan kasus penggunaan yang berbeda. Ini model terbaik untuk menghasilkan gambar tetap menjadi salah satu model pembuatan gambar terbuka yang paling banyak digunakan, didukung oleh komunitas pengembang yang besar dan pembuat konten.
Fitur utama:
- Tiga ukuran model: Large (8B parameter), Large Turbo, dan Medium (~2.5B parameter), masing-masing cocok untuk kebutuhan kinerja dan perangkat keras yang berbeda
- Output resolusi tinggi: Model Large mendukung pembuatan gambar berkualitas tinggi pada resolusi sekitar 1 megapiksel
- Varian pembuatan cepat: Large Turbo menghasilkan hasil berkualitas dalam jumlah langkah yang sedikit
- Dukungan fine-tuning: Dibuat untuk penyesuaian dengan konsistensi prompt yang lebih baik
- Lisensi penggunaan yang fleksibel: Gratis untuk individu dan bisnis kecil, dengan lisensi perusahaan untuk organisasi yang lebih besar
Pengalaman saya: 4.5/5
Ini adalah model saya yang paling konsisten di kelima kategori prompt. Model Large berhasil menghasilkan foto produk dan prompt pemandangan sibuk pada percobaan pertama atau kedua hampir setiap saat, dan tidak pernah crash pada 4090 saya bahkan pada resolusi penuh. Satu-satunya bagian yang kehilangan poin adalah perenderan teks, di mana cetakan kecil pada prompt poster masih keluar sedikit rusak.
- ControlNet 1.1
ControlNet adalah struktur jaringan saraf yang mengontrol model difusi dengan menambahkan kondisi ekstra. Ini menyalin bobot blok jaringan saraf ke dalam salinan terkunci dan salinan yang dapat dilatih. Salinan yang dapat dilatih mempelajari kondisi Anda, sedangkan salinan yang terkunci mempertahankan model asli. Dirilis oleh peneliti lllyasviel, alat ini tidak menghasilkan gambar sendiri. Sebaliknya, model gambar terbaik ini berada di atas Stable Diffusion dan memberi Anda kontrol struktural yang tepat atas apa yang dihasilkan.
Fitur utama:
- Beberapa tipe pengondisian: ControlNet mendukung kontrol melalui deteksi tepi canny, estimasi kedalaman Midas, deteksi tepi lunak HED, deteksi garis M-LSD, peta normal, deteksi pose manusia OpenPose, dan segmentasi semantik.
- Kontrol yang dapat dikomposisikan: ControlNet mendukung penggabungan beberapa ControlNet sekaligus. Semua model siap produksi diuji secara ekstensif dengan beberapa ControlNet yang digabungkan, dan dukungan resmi Multi-ControlNet tersedia melalui plugin A1111.
- Peningkatan ketahanan di v1.1: ControlNet 1.1 menambahkan pemrosesan tepi lunak baru, beberapa preprosesor baru seperti Canny, Depth, dan Inpaint, serta memperkuat ketahanan keseluruhan dan kualitas gambar model dibandingkan dengan versi 1.0.
- Pengeditan berbasis instruksi: ControlNet 1.1 menyertakan model yang dilatih pada dataset Instruct Pix2Pix, yang dilatih dengan prompt instruksi dan prompt deskripsi.
Pengalaman saya: 4/5
Saya tidak menilai ControlNet 1.1 terhadap lima prompt yang sama karena bobot resminya dirancang untuk Stable Diffusion 1.5, bukan SD 3.5. Sebaliknya, saya menilai kontrol pose dan kedalamannya secara terpisah dari pengujian SD 3.5. Di sepuluh regenerasi, kontrol pose menjaga posisi karakter tetap stabil. Ini menunjukkan bahwa ControlNet 1.1 dapat memberikan panduan yang berguna dalam alur kerja yang kompatibel, tetapi hasil ini tidak boleh dianggap sebagai bukti kompatibilitas langsung dengan SD 3.5.
- Seri FLUX
Seri FLUX dikembangkan oleh Black Forest Labs dan berfokus pada pembuatan gambar berkualitas tinggi dengan keselarasan prompt yang kuat. Ini mencakup beberapa model yang dirancang untuk alur kerja eksperimen dan produksi.
Fitur utama:
- Beberapa varian: Mencakup FLUX.1 [schnell], [dev], dan alat khusus untuk pengeditan dan pengondisian.
- Pengeditan gambar dalam konteks: Memungkinkan perubahan gambar menggunakan instruksi teks tanpa pelatihan ulang.
- Alat pengeditan khusus: Mencakup dukungan untuk inpainting gambar, outpainting, dan panduan struktural.
- Ketersediaan bobot terbuka: Memungkinkan penerapan lokal dan kustomisasi.
- Opsi penerapan yang fleksibel: Mendukung API, pengaturan lokal, dan lingkungan pengujian.
Pengalaman saya: 4.5/5
FLUX.2 memberi saya detail halus paling tajam dari model mana pun yang saya uji, terutama pada prompt foto produk di mana tekstur bahan benar-benar terlihat diterangi alih-alih seperti dilukis. Varian 32B membutuhkan waktu paling lama dari model mana pun dalam batch saya di GPU sewaan, mendekati 40 menit untuk menjalankan 20 prompt penuh, jadi ini bukan pilihan yang tepat jika Anda sedang terburu-buru.
- GLM-Image
GLM-Image adalah model pembuatan gambar yang mengadopsi arsitektur dekoder autoregresif dan difusi hibrida. Model ini menunjukkan keunggulan dalam perenderan teks dan skenario pembuatan padat pengetahuan, dengan kemampuan kuat dalam pembuatan detail fidelitas tinggi dan berbutir halus. Dikembangkan oleh Zhipu AI, model ini dibuat untuk kasus penggunaan di mana model lain cenderung kurang optimal, terutama ketika gambar perlu menyertakan teks yang dapat dibaca atau tata letak yang padat informasi.
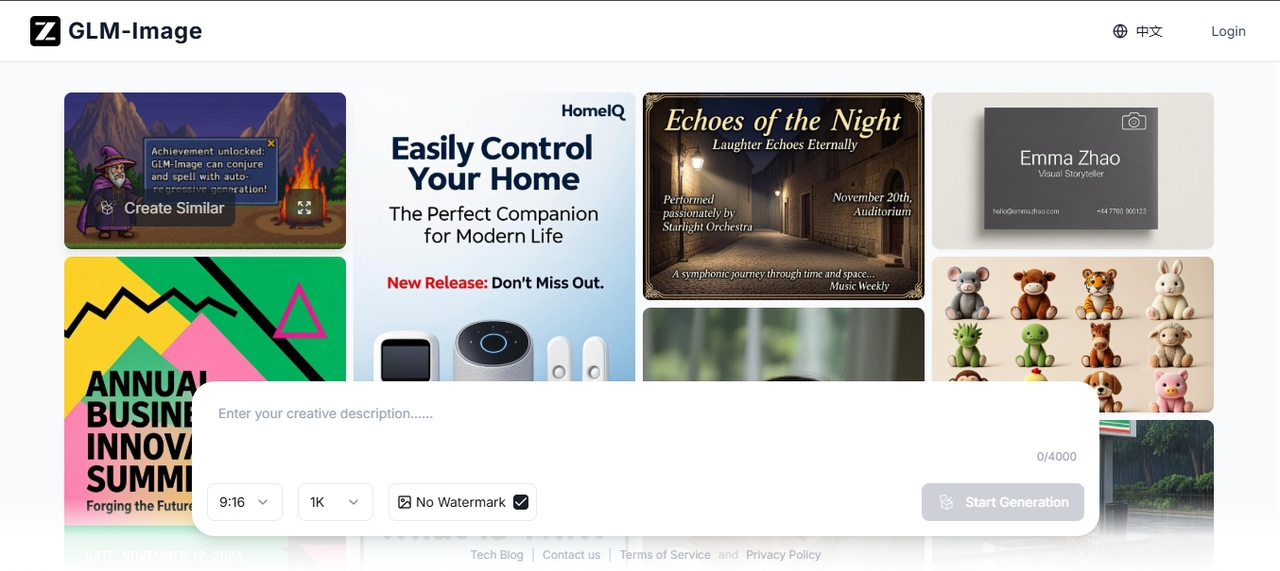
Fitur utama:
- Desain arsitektur hibrida: Menggabungkan pengodean autoregresif dengan pendekodean difusi.
- Perenderan teks yang akurat: Menghasilkan teks yang jelas dan dapat dibaca di dalam gambar.
- Dukungan untuk tata letak yang kompleks: Berfungsi dengan baik untuk poster, infografis, dan visual terstruktur.
- Pembuatan dan pengeditan terpadu: Menangani tugas teks-ke-gambar dan gambar-ke-gambar.
- Penyempurnaan pasca-pelatihan: Menggunakan pembelajaran penguatan untuk meningkatkan detail dan keselarasan.
Pengalaman saya: 4/5
GLM-Image adalah satu dari hanya dua model yang berhasil membuat tulisan kecil pada prompt poster saya terbaca sepenuhnya, dan model ini menangani tata letak gaya infografis tanpa huruf-huruf yang saling tumpang tindih. Penyiapan memakan waktu lebih lama daripada sebagian besar model lainnya karena ketentuan lisensi perlu dibaca lebih teliti sebelum penggunaan komersial, yang mengurangi satu poin untuk kenyamanan alih-alih kualitas hasil.
- Qwen-Image-2512
Qwen-Image-2512 adalah pembaruan bulan Desember dari text-to-image Qwen-Image model pembuatan gambar sumber terbuka terbaik, yang menghadirkan realisme manusia yang ditingkatkan, detail alami yang lebih halus, serta akurasi dan kualitas rendering teks yang lebih baik. Model ini ditujukan langsung untuk kasus penggunaan perusahaan dan komersial di mana kualitas, keandalan, dan kejelasan lisensi sangat penting.
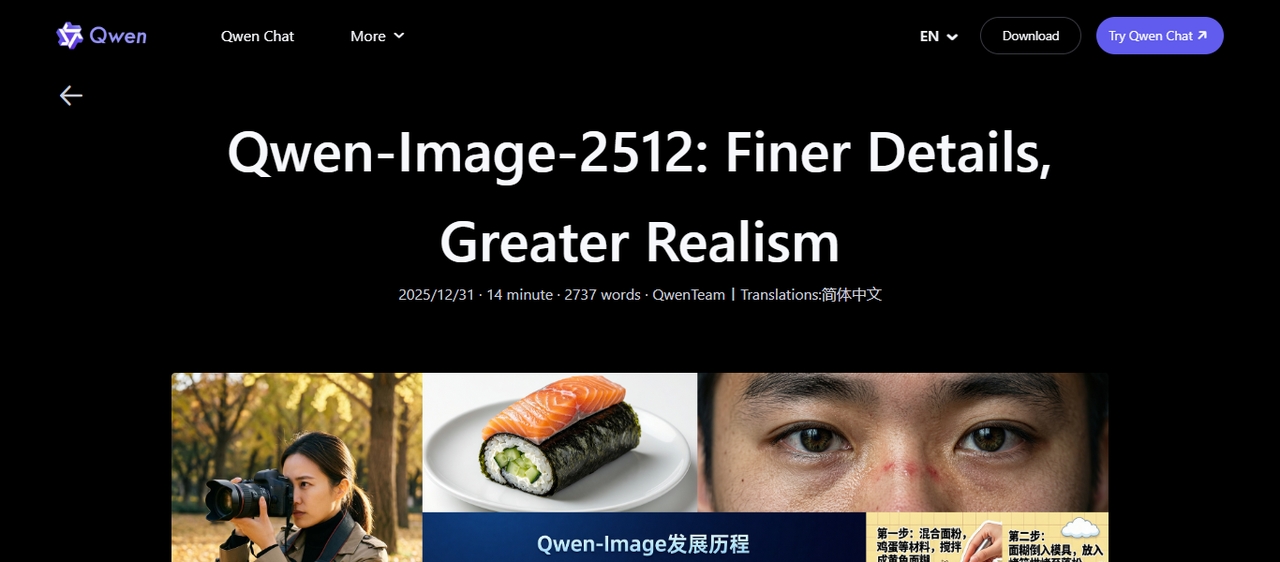
Fitur utama:
- Realisme visual yang ditingkatkan: Mengurangi tampilan buatan pada gambar yang dihasilkan.
- Akurasi teks yang lebih baik: Menghasilkan teks tersemat dan tata letak terstruktur yang lebih jelas.
- Pembuatan pemandangan yang detail: Menangani lingkungan dan objek dengan kejelasan yang lebih tinggi.
- Lisensi komersial terbuka: Dirilis di bawah Apache 2.0 untuk penggunaan dan modifikasi gratis.
- Akses model penuh: Tersedia melalui platform model terbuka untuk penerapan.
Pengalaman saya: 4.5/5
Qwen-Image-2512 adalah model lain yang membaca teks kecil dengan benar pada prompt poster, dan hasil potretnya terlihat paling alami di antara semuanya, tidak terlalu kaku (waxy) dibandingkan dengan apa yang saya dapatkan dari beberapa model difusi lainnya. Dikombinasikan dengan lisensi Apache 2.0, ini adalah model yang akan saya pilih pertama kali untuk proyek klien di mana saya harus bergerak cepat tanpa perlu membahas masalah lisensi.
- Waifu Diffusion
Waifu Diffusion dibuat oleh Hakurei dan berfokus pada pembuatan gambar bergaya anime. Model ini dilatih secara khusus pada dataset anime, yang memungkinkannya menghasilkan desain karakter yang konsisten dan visual yang bergaya. Model ini dibangun di atas Stable Diffusion dan langsung cocok dengan ekosistemnya, sehingga mudah digunakan bagi seniman yang sudah terbiasa dengan alat-alat tersebut.
Fitur utama:
- Pelatihan yang berfokus pada anime: Model ini dilatih pada dataset gambar anime yang besar, yang membantunya mempelajari proporsi karakter, ekspresi wajah, dan elemen gaya yang umum dalam seni anime.
- Kualitas karakter yang konsisten: Model ini mempertahankan fitur wajah, gaya rambut, dan detail pakaian yang stabil di berbagai prompt yang berbeda, yang berguna saat membuat karakter yang sama di beberapa adegan.
- Kontrol gaya melalui prompt: Anda dapat memandu hasil keluaran menggunakan tag dan gaya prompt yang umum digunakan dalam komunitas anime.
- Varian berbasis SDXL: Versi terbaru yang dibangun di atas SDXL meningkatkan resolusi, pencahayaan, dan detail yang lebih halus sambil tetap mempertahankan gaya anime.
- Lisensi akses terbuka: Didistribusikan di bawah CreativeML OpenRAIL-M, yang memungkinkan penggunaan dan pendistribusian ulang dengan kondisi tertentu.
- Dukungan komunitas yang luas: Tersedia sejumlah besar checkpoint pra-pelatihan, LoRA, dan paket gaya.
Pengalaman saya: 3.5/5
Waifu Diffusion memenangkan prompt anime secara mutlak dengan menjaga wajah dan pakaian karakter tetap konsisten di ketiga percobaan yang saya jalankan. Namun, ketika saya mengarahkannya ke prompt potret fotorealistik saya, hasilnya tetap keluar dengan tampilan yang mendekati anime tidak peduli bagaimana saya merangkai kata-katanya, yang merupakan hal yang memang Anda harapkan dari model yang dilatih pada dataset yang sempit. Sangat bagus untuk satu tugas, tetapi tidak dibuat untuk tugas lainnya.
- Z-Image-Turbo
Z-Image-Turbo dikembangkan oleh Tongyi-MAI. Model ini berfokus pada kecepatan dan efisiensi, yang membuatnya cocok untuk aplikasi yang membutuhkan pembuatan gambar cepat. Ini adalah bagian dari keluarga model ringkas yang dirancang untuk memberikan hasil yang kuat tanpa bergantung pada arsitektur yang sangat besar.
Fitur utama:
- Kecepatan pembuatan sub-detik: Z-Image-Turbo membuktikan bahwa performa tingkat atas dapat dicapai tanpa bergantung pada ukuran model yang sangat besar.
- Penyajian teks bilingual: Secara akurat menyajikan teks bahasa Mandarin dan Inggris yang kompleks, dan dalam desain poster menunjukkan keterampilan komposisi yang kuat serta kepekaan tipografi yang baik.
- Peningkatan dan penalaran prompt: Peningkat prompt bawaan memberdayakan model dengan kemampuan penalaran.
- Arsitektur aliran tunggal yang efisien: Z-Image-Turbo menggunakan arsitektur Scalable Single-Stream DiT di mana teks, token semantik visual, dan token VAE gambar digabungkan pada tingkat urutan menjadi aliran input yang terpadu.
Pengalaman saya: 4/5
Z-Image-Turbo menyelesaikan seluruh batch 20 prompt saya dalam waktu kurang dari empat menit, sejauh ini yang tercepat dari ketujuhnya. Penyajian teks bilingual bertahan dengan baik pada versi bahasa Inggris dan bahasa Mandarin dari prompt poster saya. Detail halus pada prompt pemandangan yang sibuk berada satu langkah di belakang Stable Diffusion 3.5 dan FLUX.2, yang wajar mengingat seberapa jauh lebih kecil ukuran model ini.
Faktor-faktor kunci yang perlu dipertimbangkan sebelum memilih model
Sebelum Anda berkomitmen pada salah satu model, ada beberapa hal praktis yang layak untuk diperiksa. Berikut adalah apa yang perlu diperhatikan dan mengapa hal itu penting.
- Kualitas gambar
Kualitas gambar bergantung pada seberapa realistis, detail, dan akurat hasil yang terlihat dibandingkan dengan apa yang Anda minta. Beberapa model menghasilkan hasil yang tampak nyata sementara yang lain lebih condong ke arah gaya tertentu. Pilihan yang tepat tergantung pada apa yang sebenarnya dibutuhkan oleh proyek Anda.
- Kecepatan (waktu inferensi)
Waktu inferensi adalah berapa lama waktu yang dibutuhkan model untuk menghasilkan satu gambar. Jika Anda menghasilkan ratusan gambar dalam satu batch atau membangun alat waktu nyata (real-time), kecepatan sangatlah penting. Model yang lebih lambat yang menghasilkan hasil luar biasa mungkin tidak selalu praktis.
- Persyaratan VRAM
VRAM adalah memori yang digunakan kartu grafis Anda untuk menjalankan model. Model yang lebih besar membutuhkan lebih banyak memori, terkadang 16 GB atau lebih. Jika perangkat keras Anda tidak memenuhi persyaratan, model tersebut tidak akan berjalan, atau akan berjalan terlalu lambat untuk dapat berguna.
- Kemampuan penyajian teks
Beberapa model menangani teks di dalam gambar dengan baik, yang lain salah sama sekali. Jika hasil keluaran Anda mencakup tanda, poster, label, atau konten tertulis apa pun, ini menjadi faktor penting. Model seperti GLM-Image dan Qwen-Image-2512 dibangun secara khusus dengan mempertimbangkan hal ini.
- Lisensi (komersial vs terbatas)
Beberapa model gratis untuk penggunaan pribadi atau penelitian tetapi memerlukan lisensi berbayar untuk pekerjaan komersial. Model lain seperti Z-Image-Turbo dan Qwen-Image-2512 sepenuhnya terbuka di bawah Apache 2.0. Selalu periksa lisensi sebelum menggunakan model dalam proyek atau produk klien.
- Ekosistem dan komunitas
Komunitas yang kuat berarti lebih banyak tutorial, fine-tune bawaan, plugin, dan perbaikan yang lebih cepat ketika terjadi kesalahan. Stable Diffusion, misalnya, memiliki ribuan sumber daya yang dibuat oleh komunitas. Model yang lebih baru atau lebih khusus mungkin mengesankan tetapi membuat Anda memiliki sangat sedikit dukungan di sekitarnya.
Timbang keenam faktor tersebut bersama-sama dan sumber terbuka (open-source) mulai terlihat tidak sepenuhnya gratis. Model yang unggul dalam kualitas gambar dan penyajian teks mungkin memerlukan VRAM 16GB+ yang tidak Anda miliki, ditambah waktu nyata yang dihabiskan untuk men-debug pengaturan lokal sebelum menghasilkan sesuatu yang dapat digunakan. Jika yang sebenarnya Anda inginkan adalah performa tingkat atas tanpa menghosting model sendiri, atau akses ke model tertutup yang tidak dapat disentuh sama sekali oleh opsi sumber terbuka ini, di situlah Framia Pro masuk.
Framia Pro: Pilihan Anda untuk bekerja dengan model non-terbuka
Framia Pro adalah platform kreatif AI yang dibangun di sekitar kanvas alur kerja, tempat Anda menghubungkan model tertutup dari mitra seperti Seedream 5.0 Pro, Nano Banana Pro, Kling, Seedance 2.5, dan Veo 3.1 ke dalam satu ruang kerja alih-alih memilih satu mesin saja dan hidup dengan keterbatasannya. Anda mendeskripsikan apa yang Anda inginkan, dan Framia Pro menangani skrip, visual, dan perakitannya di seluruh node terhubung yang dapat Anda edit kapan saja dalam proses tersebut. Ini menyatukan pembuatan gambar, video, dan Marketing Studio lengkap ke dalam satu tempat, sehingga kreator yang membutuhkan hasil dari model yang bukan open source tidak perlu menggabungkan beberapa langganan untuk mencapainya.
Saya menghabiskan beberapa jam di Framia Pro bersama tujuh model di atas untuk melihat bagaimana perbandingan pengalaman model tertutup yang sebenarnya, dan saya telah mencatat di mana ia cocok dan di mana ia tidak cocok di bawah ini.
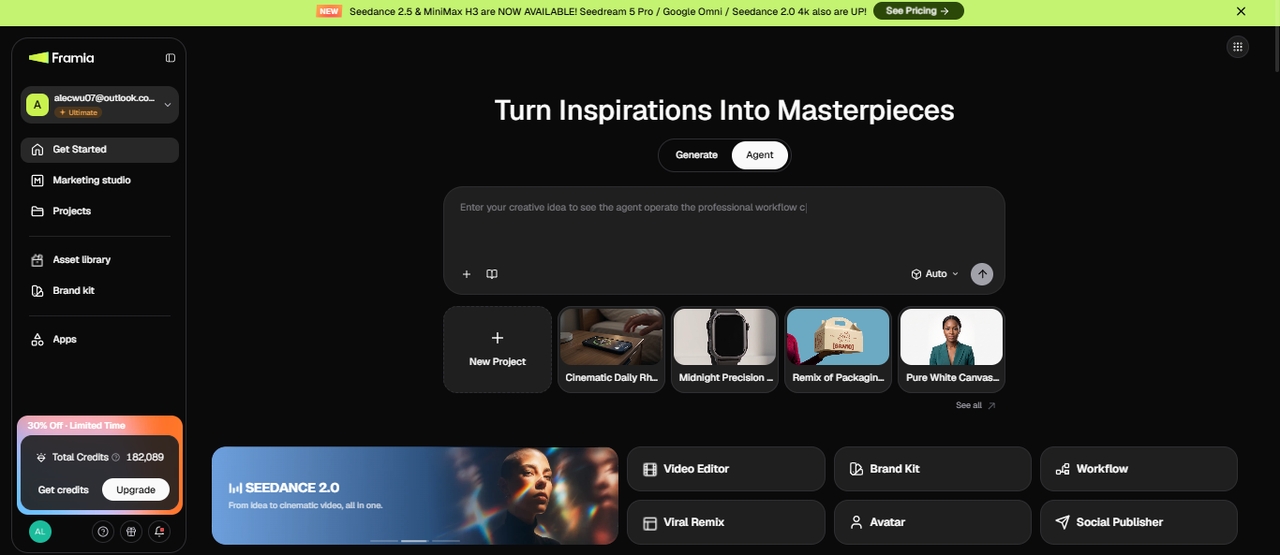
Fitur generator gambar Framia Pro
Framia Pro menyediakan satu ruang kerja tempat Anda dapat membuat dan mengedit gambar menggunakan berbagai model pembuatan gambar terbaik. Setiap fitur dirancang untuk memberi Anda kendali atas bagaimana gambar dibuat dan disempurnakan.
- Kanvas alur kerja yang menghubungkan setiap langkah
Kanvas Framia Pro menyusun proyek Anda sebagai node yang terhubung, skrip, gambar, video, dan audio, yang dapat Anda seret, tambahkan, atau hapus seiring berkembangnya proyek. Alih-alih membuat satu gambar dan memulai dari awal untuk aset berikutnya, Anda membangun urutan lengkap dan menjalankan kembali hanya node yang memerlukan perubahan.
- Beberapa model AI dalam satu ruang kerja
Framia Pro memberi Anda akses ke Nano Banana Pro, Qwen Image, Midjourney v7, Flux Max, dan Seedream 4.5 untuk gambar, ditambah Kling, Veo 3.1, dan Seedance untuk video, semuanya di dalam satu platform. Anda dapat beralih model tergantung pada hasil yang Anda inginkan dan membandingkan output secara berdampingan tanpa membuka alat yang terpisah.
- Brand Kit untuk visual yang konsisten
Generator Brand Kit Framia Pro membuat logo, palet warna, tipografi, dan templat sosial dari satu brief, lalu menjaga setiap gambar yang Anda buat setelahnya tetap terkunci pada panduan merek tersebut. Ini penting bagi tim pemasaran dan bisnis yang memproduksi visual dalam volume tinggi di berbagai kampanye.
- Templat tren untuk di-remix
Framia Pro menyediakan galeri templat yang sedang tren dan siap viral yang dapat Anda pilih dan remix dengan prompt Anda sendiri alih-alih membangun konsep dari kanvas kosong. Ini lebih ditujukan untuk konten sosial dengan pengerjaan cepat daripada gaya yang menjadi fokus panduan ini, tetapi ini patut diketahui jika Anda juga memproduksi video.
- Edit gambar melalui perintah obrolan sederhana
Anda dapat mendeskripsikan perubahan dalam bahasa sehari-hari, seperti mengganti latar belakang atau mengubah ukuran logo, dan Framia Pro menerapkannya langsung ke gambar. Pengeditan berbasis obrolan ini menghindari masking manual atau mengulang seluruh pembuatan gambar untuk perbaikan kecil.
Kesimpulan
Dalam artikel ini, kami menjelajahi 7 model pembuatan gambar open source teratas dan menunjukkan bagaimana berbagai alat menangani pembuatan gambar, performa, dan fleksibilitas. Setiap model menawarkan kekuatannya sendiri di berbagai bidang seperti kualitas visual, kecepatan, kebutuhan perangkat keras, dan dukungan untuk berbagai gaya. Framia Pro menyatukan beberapa model di satu tempat untuk memberi Anda lebih banyak pilihan untuk membuat dan mengedit gambar dalam satu alur kerja tanpa beralih di antara alat yang terpisah. Coba sekarang!
FAQ
Manakah generator gambar AI open source yang paling sering digunakan?
Stable Diffusion tetap menjadi salah satu generator gambar open-source yang paling banyak digunakan karena komunitasnya yang aktif dan dukungan alat yang luas. Di Framia Pro, Anda dapat mengakses berbagai model gambar dalam satu ruang kerja, yang menghilangkan kebutuhan untuk menyiapkan lingkungan terpisah untuk setiap generator dan memungkinkan peralihan yang lebih mudah di antara output.
Manakah model pembuatan gambar yang menghasilkan kualitas visual lebih tinggi?
Model-model yang lebih baru, seperti seri berbasis SDXL dan Flux, sering kali menghasilkan tekstur yang lebih jelas, pencahayaan yang lebih baik, dan komposisi yang lebih baik. Framia Pro memberi Anda akses ke model Nano Banana Pro, Seedream 4.5, Flux Max, Qwen Image, dan Midjourney v7 untuk memungkinkan Anda membuat gambar secara instan.
Manakah model yang paling baik bekerja untuk pembuatan gambar pada perangkat keras yang terbatas?
Versi model yang dioptimalkan atau ringan lebih cocok untuk sistem dengan VRAM terbatas. Framia Pro menangani akses model di backend, sehingga Anda dapat menjalankan model yang lebih berat tanpa mengelola pengaturan lokal, yang mengurangi kebutuhan akan perangkat keras berspesifikasi tinggi di pihak Anda.
Mana yang dianggap sebagai model pembuatan gambar sumber terbuka terbaik?
Model seperti Stable Diffusion, Waifu Diffusion, dan pengaturan berbasis ControlNet umumnya digunakan untuk berbagai tugas seperti realisme, seni anime, dan kontrol struktural. Framia Pro menyatukan opsi-opsi ini, memungkinkan Anda memilih dan menguji beberapa model dalam satu proyek.
Mana model gambar yang lebih disukai untuk kasus penggunaan profesional?
Alur kerja profesional sering kali memerlukan output yang stabil, hasil yang konsisten, dan dukungan untuk pengeditan. Framia Pro memberikan nilai tambah dengan menawarkan pengeditan gambar berbasis obrolan dan pembuatan batch, yang memungkinkan Anda menyempurnakan gambar dan menghasilkan beberapa variasi di satu tempat tanpa beralih alat.
Mana model pembuatan gambar gratis terbaik?
Stable Diffusion 3.5 adalah opsi gratis yang paling lengkap, karena varian Medium dan Large Turbo berjalan pada perangkat keras kelas konsumen dan lisensinya mencakup penggunaan komersial untuk bisnis yang lebih kecil. Z-Image-Turbo dan Qwen-Image-2512 juga sepenuhnya gratis di bawah Apache 2.0, dengan output yang lebih cepat tetapi komunitas yang dibangun di sekitarnya masih lebih kecil sejauh ini.
Apakah ada pembuat gambar AI lokal sumber terbuka yang tersedia?
Ya. Stable Diffusion 3.5, ControlNet 1.1, FLUX.2, Waifu Diffusion, dan Z-Image-Turbo semuanya berjalan secara lokal di perangkat keras Anda sendiri setelah diunduh, tanpa memerlukan akun cloud atau langganan. Persyaratan utamanya adalah VRAM yang cukup, umumnya 6GB hingga 24GB tergantung pada model yang Anda pilih.
Apakah saya dapat menggunakan model gambar sumber terbuka untuk proyek komersial?
Ya, tetapi itu tergantung pada lisensi model tersebut. Beberapa model mengizinkan penggunaan komersial, sementara yang lain memiliki batasan. Selalu tinjau ketentuan lisensi sebelum menggunakan gambar yang dihasilkan untuk pekerjaan klien, produk, atau kampanye berbayar.