공유


핵심 요약
- 오픈소스 이미지 생성 모델은 반복적인 구독이나 별도의 모델 라이선스 비용 없이 이미지를 생성하고 편집할 수 있는 방법을 제공할 수 있습니다.
- Hugging Face는 거의 109,255개의 텍스트-이미지 변환 모델을 호스팅하고 있어, 크리에이터들은 스타일, 속도 및 하드웨어 요구 사항에 따라 다양한 옵션을 선택할 수 있습니다.
- Stable Diffusion 3.5, FLUX 및 Qwen-Image-2512는 일반적인 창의적 작업, 프롬프트 정확도 및 상업적 라이선스 분야를 선도하고 있습니다.
- ControlNet 1.1과 Waifu Diffusion은 구조적 제어 및 애니메이션 스타일 아트와 같은 전문적인 요구 사항을 충족합니다.
- Z-Image-Turbo와 GLM-Image는 포스터 및 인포그래픽과 같이 텍스트가 많은 이미지 생성과 속도 면에서 뛰어납니다.
- Framia Pro는 로컬 설정을 관리하지 않고도 결과를 얻고자 하는 크리에이터를 위해 Nano Banana Pro, Midjourney v7, Seedream 4.5와 같은 폐쇄형 모델을 하나의 워크스페이스로 가져옵니다.
오픈소스 이미지 생성 모델은 크리에이터, 개발자 및 기업에게 완전히 새로운 세상을 열어주었습니다. 이제 텍스트를 이미지로 변환하고, 사진을 편집하고, 비디오를 제작하고, 3D 오브젝트를 생성할 수 있으며, 소프트웨어에 큰 비용을 들일 필요가 없습니다. 이 분야는 빠르게 성장하여, 거의 109,255개의 텍스트-이미지 변환 모델이 Hugging Face에서만 제공되고 있습니다. 오픈소스를 선택한다는 것은 구독이 없고, 데이터를 완전히 제어할 수 있으며, 필요한 대로 자유롭게 조정할 수 있음을 의미합니다. 이 가이드에서는 시중의 가장 우수한 모델들과 바로 시작하는 데 필요한 모든 것을 다룹니다.
무엇이 오픈소스 이미지 생성 모델인가요?
오픈소스 이미지 생성 모델은 작성된 설명으로부터 이미지를 생성하는 소프트웨어 프로그램입니다. 산 너머로 지는 일몰, 제품 목업, 만화 캐릭터 등 보고 싶은 내용을 입력하면 모델이 이를 이미지로 생성합니다.
평생 수백만 개의 그림, 사진, 일러스트를 공부한 아티스트를 고용하는 것이라고 생각해 보세요. 원하는 것을 설명하면 몇 초 만에 그려줍니다. 단, 이 아티스트는 잠을 자지 않고, 프로젝트당 비용을 청구하지 않으며, 사용자의 컴퓨터에 상주한다는 점이 다릅니다.
이들이 "오픈소스"인 이유는 코드가 공개되어 있기 때문입니다. 누구나 무료로 다운로드하고, 사용하고, 수정하거나, 이를 기반으로 빌드할 수 있습니다. 이는 소프트웨어 액세스 비용을 지불해야 하고 내부 작동 방식을 제어할 수 없는 Midjourney나 Adobe Firefly와 같은 유료 도구와 다릅니다.
이러한 모델은 수백만 개의 이미지로 학습되어 단어와 시각적 요소 간의 관계를 이해하도록 훈련되었습니다. 시간이 흐르면서 전문가 수준의 결과를 생성할 수 있을 만큼 발전했으며, 현재 가장 우수한 모델들은 고가의 상용 옵션과 경쟁할 만한 수준입니다.
폐쇄형보다 오픈소스를 선택해야 하는 이유: 이미지 모델
유료 이미지 모델은 편리하지만 실질적인 한계가 있습니다. 이미지당 비용을 지불해야 하고, 데이터를 타사 서버에 넘겨야 하며, 소프트웨어 작동 방식에 관여할 수 없습니다. 오픈소스 모델은 이 모든 문제를 해결합니다. 점점 더 많은 크리에이터와 개발자가 전환하는 이유는 다음과 같습니다.
- 출력물에 대한 완전한 제어
폐쇄형 도구를 사용하면 플랫폼이 생성할 수 있는 것과 생성할 수 없는 것을 결정합니다. 오픈소스 모델은 사용자의 자체 환경에서 실행되므로 사용자가 규칙을 설정합니다. 콘텐츠 필터나 플랫폼 제한의 방해 없이 요청한 결과를 정확히 얻을 수 있습니다.
- 모델 미세 조정(Fine-tuning) 가능
폐쇄형 모델은 잠겨 있어 특정 요구 사항에 맞게 변경할 수 없습니다. 하지만 오픈소스 모델은 사용자의 자체 이미지, 스타일 또는 브랜드 가이드라인에 따라 추가로 학습시킬 수 있습니다. 즉, 동일한 도구를 사용하는 다른 사람들과 똑같은 결과물이 아닌, 자신만의 고유한 스타일을 담은 결과물을 얻을 수 있습니다.
- 이미지당 비용 없음
대부분의 상용 도구는 이미지를 생성할 때마다 비용을 청구하므로 비용이 빠르게 누적됩니다. 하지만 오픈소스 모델을 사용하면 모든 작업을 자체 하드웨어에서 실행하고 원하는 만큼 이미지를 생성할 수 있습니다. 유일한 비용은 전기세와 작업을 수행하는 기기 비용뿐입니다.
- 개인정보 보호 및 오프라인 사용
클라우드 기반 도구를 사용하면 프롬프트와 이미지가 타사의 서버를 거치게 됩니다. 오픈소스 모델은 완전히 오프라인으로 실행할 수 있으므로 어떤 데이터도 사용자의 기기를 벗어나지 않습니다. 이는 민감한 프로젝트나 독점 콘텐츠를 다루는 기업에 매우 중요합니다.
- 대규모 커뮤니티 지원
오픈소스 모델은 전 세계 수천 명의 개발자, 연구원, 크리에이터들의 지원을 받습니다. 이들은 미세 조정된 버전, 튜토리얼, 플러그인 및 수정 사항을 매일 공유합니다. 문제가 발생하더라도 커뮤니티의 누군가가 이미 해결했을 가능성이 높습니다.
내가 이 모델들을 테스트하고 선택한 방법
나는 크리에이티브 AI 도구를 다루는 일을 하고 있으며, 모델의 GitHub 페이지에서 사양서만 그대로 복사해 붙여넣은 '최고의 모델' 목록들을 보는 것에 지쳐 있었다. 그래서 여기에 순위를 매기기 전에, 마케팅용 스크린샷 밖에서 각 모델이 실제로 어떻게 작동하는지 확인하기 위해 일주일 동안 직접 모든 모델을 실행해 보았다.
집에서 RTX 4090과 24GB VRAM이 장착된 여분의 데스크톱을 사용하고 있어서 그것이 나의 메인 테스트 장비가 되었다. 32B의 FLUX.2나 Qwen-Image-2512처럼 더 많은 메모리가 필요한 더 큰 모델들의 경우, 사양서만 보고 결과를 추측하는 대신 시간당 클라우드 GPU를 대여해 테스트했다.
나는 20개의 프롬프트 세트를 만들고 체리피킹 없이 모든 모델에 동일한 목록을 실행했다. 프롬프트는 다섯 가지 영역을 다루었다: 극사실적인 초상화, 평범한 배경 위의 제품 사진, 헤드라인과 작은 글씨가 있는 포스터, 애니메이션 스타일의 캐릭터, 그리고 여러 물체가 있는 복잡한 장면. 각 모델은 프롬프트당 세 번의 시도 기회를 가졌고, 대부분의 사람들이 실제로 이러한 도구를 사용하는 방식과 마찬가지로 세 번 중 가장 좋은 결과를 선택했다.
점수를 매기기 위해 모든 결과를 네 가지 항목에 대해 1점에서 5점까지 평가했다: 출력이 프롬프트와 얼마나 일치하는지, 전체 해상도에서 미세한 디테일이 얼마나 깔끔하게 보이는지, 내 하드웨어에서 생성하는 데 시간이 얼마나 걸리는지, 그리고 이미지 내부의 텍스트(프롬프트에서 요구한 경우)가 실제로 읽을 수 있게 나왔는지 여부이다. 오후 내내 테스트를 진행한 후 몇몇 모델들이 머릿속에서 뒤섞였기 때문에, 나중에 기억에 의존하는 대신 테스트를 진행하면서 스프레드시트에 숫자를 기록했다.
몇 가지 사실이 빠르게 눈에 띄었다. Z-Image-Turbo는 총 20개의 프롬프트 배치를 4분 미만 만에 완료한 반면, 32B의 FLUX 2는 대여한 GPU에서 40분에 가까운 시간이 걸렸다. GLM-Image와 Qwen-Image-2512는 포스터 프롬프트에서 글자가 깨지지 않고 작은 텍스트를 일관되게 올바르게 표현한 유일한 두 모델이었다. Waifu Diffusion은 애니메이션 프롬프트에서 큰 차이로 우승했지만, 극사실적인 초상화에서는 크게 고전했는데, 이는 좁은 데이터셋으로 학습된 모델에서 예상할 수 있는 결과와 일치했다.
나는 단순한 서류상의 사양이나 커뮤니티의 소문이 아닌, 해당 테스트를 바탕으로 아래의 7개 모델의 순위를 매겼으며, 적절한 배치 크기로 전체 파이프라인을 로드했을 때 모델의 실제 VRAM 사용량이 공식 최소 사양보다 높게 나타난 부분을 기록했다.
탑 7 오픈소스 이미지 생성 모델
서로 다른 오픈소스 AI 이미지 생성기들은 사실감, 속도, 구조 제어 또는 텍스트 정확성과 같은 서로 다른 강점에 초점을 맞춥니다. 아래는 각각 명확한 목적을 가진 널리 사용되는 7개의 모델입니다.
| 모델 | 아키텍처 | 최소 VRAM | 라이선스 | 주요 강점 | 가장 적합한 용도 |
| Stable Diffusion 3.5 | 잠재 확산 (DiT) | 8 GB+ | 상업용 | 거대한 생태계, LoRA 지원, 활발한 커뮤니티 | 일반적인 크리에이티브 작업, 초보자, 플러그인 기반 워크플로우 |
| ControlNet 1.1 | 조건부 SD 애드온 | 8 GB+ | Apache 2.0 | 포즈 제어, 깊이 맵, 에지 가이드 | 캐릭터 일관성, 건축 레이아웃, 가이드 생성 |
| FLUX.2 | 플로우 매칭 트랜스포머 (4B–32B) | 13 GB (4B) / 24 GB (32B) | BFL Commercial | 다중 이미지 참조 지원 및 강력한 프롬프트 준수 | 고품질 비주얼, 브랜드 자산, 마케팅 콘텐츠 |
| GLM-Image | 하이브리드 AR + DiT (9B + 7B) | ~16 GB | 연구용 / 커스텀 | 강력한 텍스트 렌더링, 중국어 타이포그래피 지원, 하나의 흐름에서 편집 + 생성 | 포스터, UI 목업, 이중 언어 디자인, 인포그래픽 |
| Qwen-Image-2512 | 확산 + 비전 언어 모델 (20B) | ~16 GB | Apache 2.0 | 다국어 텍스트, 레이어드 RGBA 편집, ControlNet 지원 | 상업용 워크플로우, 고급 편집, 다국어 콘텐츠 |
| Waifu Diffusion | Stable Diffusion 파인튜닝 (애니메이션 데이터셋) | 6 GB+ | CreativeML OpenRAIL | 애니메이션 스타일, 만화 비주얼, 캐릭터 중심 출력 | 게임, 비주얼 노벨, 애니메이션 스타일 아트워크 |
| Z-Image-Turbo | 증류된 확산 트랜스포머 (6B) | 16 GB | Apache 2.0 | 매우 낮은 지연 시간, 영어 + 중국어 지원, 배치 처리 | 실시간 앱, 대규모 파이프라인, 에지 배포 |
- Stable Diffusion 3.5
Stable Diffusion 3.5는 멀티모달 확산 트랜스포머(MMDiT) 텍스트-이미지 모델이며, Stability AI에 의해 개발되었습니다. 이는 이미지 품질, 타이포그래피, 프롬프트 이해 및 전반적인 성능을 향상시킵니다. 이 모델은 다양한 하드웨어 설정 및 사용 사례에 맞게 설계된 세 가지 크기로 제공됩니다. 이 이미지 생성을 위한 최고의 모델은 여전히 가장 널리 사용되는 오픈 이미지 생성 모델 중 하나이며, 대규모 개발자 커뮤니티와 콘텐츠 크리에이터들의 지원을 받고 있습니다.
주요 특징:
- 세 가지 모델 크기: Large (8B 파라미터), Large Turbo, Medium (~2.5B 파라미터)으로, 각각 서로 다른 성능 및 하드웨어 요구 사항에 적합함
- 고해상도 출력: Large 모델은 약 100만 화소 해상도에서 고품질 이미지 생성을 지원함
- 빠른 생성 변형 모델: Large Turbo는 적은 단계 수로도 고품질 결과를 생성함
- 파인튜닝 지원: 향상된 프롬프트 일관성으로 커스텀화에 맞게 구축됨
- 유연한 사용 라이선스: 개인 및 소규모 기업에는 무료이며, 대규모 조직을 위한 엔터프라이즈 라이선스 제공
나의 경험: 4.5/5
이 모델은 다섯 가지 프롬프트 카테고리 전체에서 가장 일관된 성능을 보여준 모델이었다. Large 모델은 거의 매번 첫 번째나 두 번째 시도 만에 제품 사진과 복잡한 장면 프롬프트를 완벽하게 소화해 냈으며, 전체 해상도에서도 내 4090에서 한 번도 충돌이 발생하지 않았다. 유일하게 감점된 부분은 텍스트 렌더링이었는데, 포스터 프롬프트의 작은 글씨가 여전히 약간 왜곡되어 출력되었다.
- ControlNet 1.1
ControlNet은 추가적인 조건을 더해 확산 모델을 제어하는 신경망 구조입니다. 이는 신경망 블록의 가중치를 고정된 복사본과 학습 가능한 복사본으로 복사합니다. 학습 가능한 복사본은 사용자의 조건을 학습하는 반면, 고정된 복사본은 원래 모델을 보존합니다. 연구자 lllyasviel이 발표한 이 모델은 자체적으로 이미지를 생성하지는 않습니다. 대신, 이 최고의 이미지 모델은 Stable Diffusion 위에 얹어져 생성되는 결과물에 대해 정밀한 구조적 제어를 제공합니다.
주요 특징:
- 다양한 컨디셔닝 유형: ControlNet은 canny 에지 검출, Midas 깊이 추정, HED 소프트 에지 검출, M-LSD 선 검출, 노멀 맵, OpenPose 인간 포즈 검출 및 시맨틱 세그멘테이션을 통한 제어를 지원합니다.
- 조합 가능한 제어: ControlNet은 여러 ControlNet을 동시에 결합하는 것을 지원합니다. 모든 프로덕션 준비 완료 모델은 여러 ControlNet이 결합된 상태에서 광범위하게 테스트되었으며, 공식 Multi-ControlNet 지원은 A1111 플러그인을 통해 제공됩니다.
- v1.1에서의 향상된 견고성: ControlNet 1.1은 새로운 소프트 에지 처리, Canny, Depth, Inpaint와 같은 여러 새로운 전처리기를 추가하고, 버전 1.0에 비해 모델의 전반적인 견고성과 이미지 품질을 강화합니다.
- 지시어 기반 편집: ControlNet 1.1에는 지시 프롬프트와 설명 프롬프트 모두로 학습된 Instruct Pix2Pix 데이터셋으로 학습된 모델이 포함되어 있습니다.
나의 경험: 4/5
ControlNet 1.1의 공식 가중치는 SD 3.5가 아닌 Stable Diffusion 1.5용으로 설계되었기 때문에 동일한 5개의 프롬프트에 대해 점수를 매기지 않았습니다. 대신 SD 3.5 실행과는 별도로 포즈 및 깊이 제어를 평가했습니다. 10번의 재생성 전반에 걸쳐 포즈 제어는 캐릭터의 위치를 안정적으로 유지했습니다. 이는 ControlNet 1.1이 호환되는 워크플로우에서 유용한 가이드를 제공할 수 있음을 시사하지만, 이러한 결과를 SD 3.5와의 직접적인 호환성의 증거로 받아들여서는 안 됩니다.
- FLUX 시리즈
FLUX 시리즈는 Black Forest Labs에서 개발했으며, 고품질 이미지 생성에 초점을 맞춥니다. 여기에는 실험 및 프로덕션 워크플로우 모두를 위해 설계된 여러 모델이 포함되어 있습니다.
주요 기능:
- 다양한 변형: FLUX.1 [schnell], [dev] 및 편집과 컨디셔닝을 위한 특화된 도구를 포함합니다.
- 컨텍스트 내 이미지 편집: 재학습 없이 텍스트 지시어를 사용하여 이미지를 변경할 수 있습니다.
- 전용 편집 도구: 이미지 인페인팅, 아웃페인팅 및 구조적 가이드 지원을 포함합니다.
- 오픈 가중치 제공: 로컬 배포 및 커스터마이징이 가능합니다.
- 유연한 배포 옵션: API, 로컬 설정 및 테스트 환경을 지원합니다.
나의 경험: 4.5/5
FLUX.2는 내가 테스트한 모델 중 가장 선명하고 미세한 디테일을 보여주었으며, 특히 소재 질감이 칠해진 것이 아니라 실제로 빛을 받는 것처럼 보였던 제품 촬영 프롬프트에서 두드러졌습니다. 32B 변형은 대여한 GPU에서 내 배치 중 가장 오랜 시간이 걸렸으며, 전체 20개 프롬프트 실행에 거의 40분이 소요되었으므로 서둘러야 하는 경우에는 적합하지 않습니다.
- GLM-Image
GLM-Image는 하이브리드 자기회귀 및 확산 디코더 아키텍처를 채택한 이미지 생성 모델입니다. 텍스트 렌더링 및 지식 집약적 생성 시나리오에서 강점을 보이며, 고정밀 및 미세 디테일 생성 능력이 뛰어납니다. Zhipu AI에서 개발한 이 모델은 다른 모델이 부족한 경향이 있는 사용 사례, 특히 이미지에 읽을 수 있는 텍스트나 정보 밀도가 높은 레이아웃이 포함되어야 하는 경우를 위해 구축되었습니다.
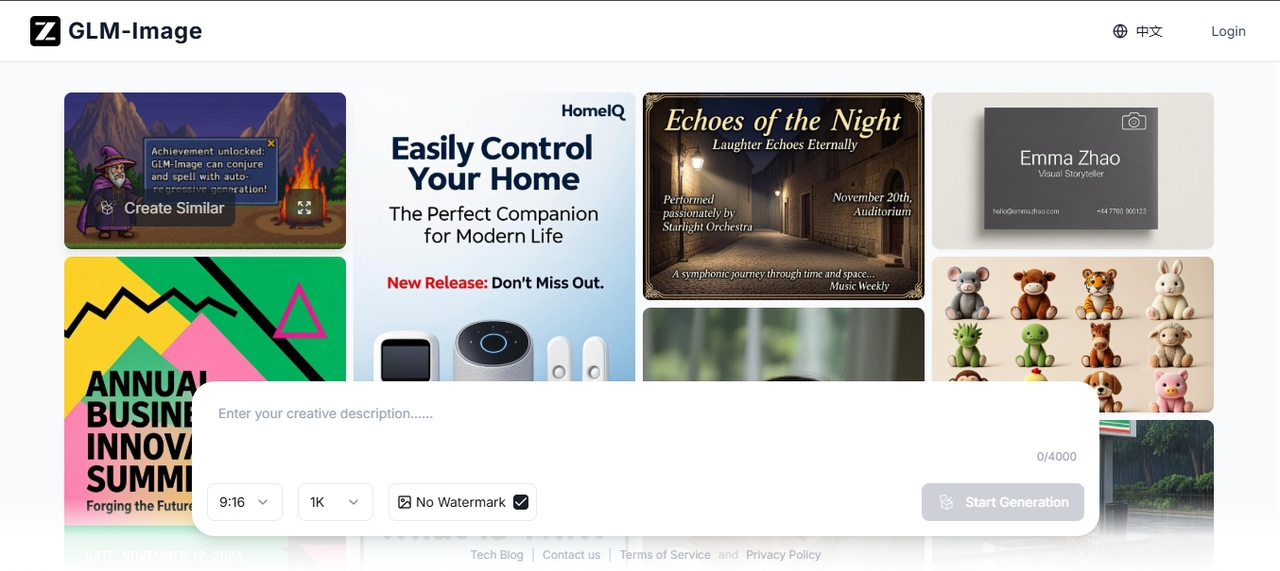
주요 기능:
- 하이브리드 아키텍처 디자인: 자기회귀 인코딩과 확산 디코딩을 결합합니다.
- 정확한 텍스트 렌더링: 이미지 내에 명확하고 읽을 수 있는 텍스트를 생성합니다.
- 복잡한 레이아웃 지원: 포스터, 인포그래픽 및 구조화된 시각 자료에 잘 작동합니다.
- 통합 생성 및 편집: 텍스트-투-이미지 및 이미지-투-이미지 작업을 모두 처리합니다.
- 사후 훈련 정제: 세부 정보와 정렬을 개선하기 위해 강화 학습을 사용합니다.
내 경험: 4/5
GLM-Image는 내 포스터 프롬프트의 작은 글씨를 완전히 읽을 수 있게 표현한 단 두 개의 모델 중 하나였으며, 글자가 서로 뭉개지지 않고 인포그래픽 스타일의 레이아웃을 잘 처리했습니다. 상업적 사용 전에 라이선스 조건을 자세히 읽어봐야 해서 설정에 다른 모델보다 시간이 더 걸렸는데, 이는 출력 품질보다는 편의성 면에서 감점 요인이 되었습니다.
- Qwen-Image-2512
Qwen-Image-2512는 Qwen-Image의 텍스트-이미지 변환 최고의 오픈 소스 이미지 생성 모델의 12월 업데이트 버전으로, 향상된 인물 사실감, 더 정밀한 자연스러운 세부 묘사, 개선된 텍스트 렌더링 정확도 및 품질을 특징으로 합니다. 품질, 신뢰성, 라이선스 명확성이 중요한 기업 및 상업적 사용 사례를 정조준하고 있습니다.
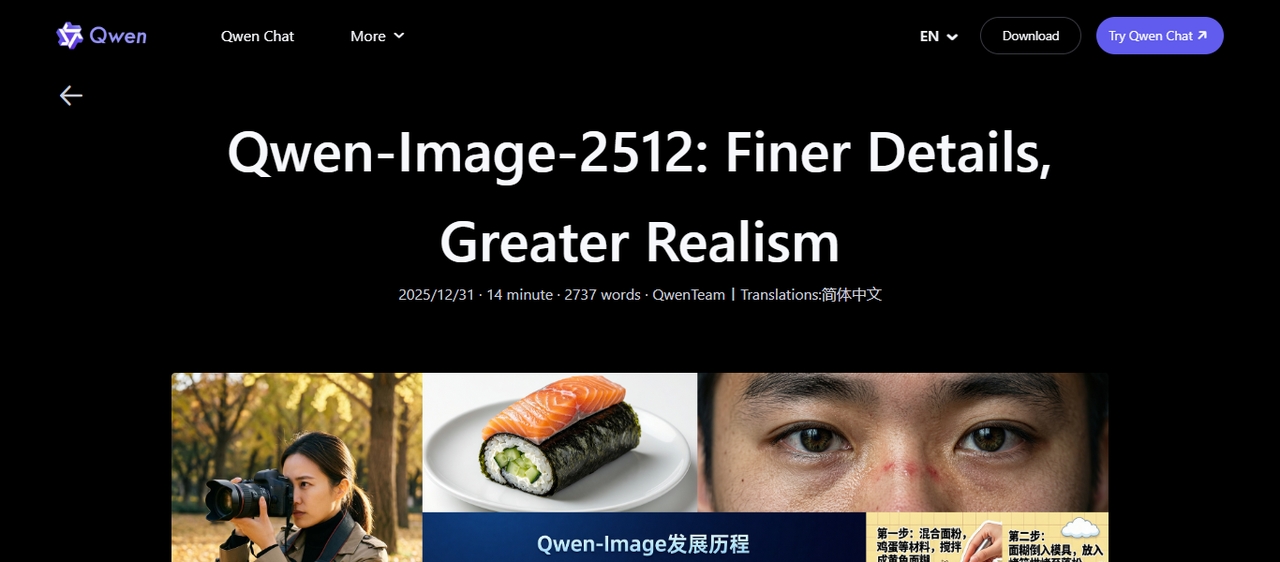
주요 특징:
- 향상된 시각적 사실감: 생성된 이미지에서 인위적인 느낌을 줄입니다.
- 더 나은 텍스트 정확도: 더 선명한 삽입 텍스트와 구조화된 레이아웃을 생성합니다.
- 상세한 장면 생성: 환경과 사물을 더 높은 선명도로 처리합니다.
- 개방형 상업용 라이선스: 자유로운 사용 및 수정을 위해 Apache 2.0 라이선스로 배포됩니다.
- 전체 모델 액세스: 배포를 위해 오픈 모델 플랫폼을 통해 제공됩니다.
내 경험: 4.5/5
Qwen-Image-2512는 포스터 프롬프트에서 작은 텍스트를 올바르게 읽어낸 또 다른 모델이었으며, 초상화 결과물은 다른 일부 디퓨전 모델에서 얻은 것보다 덜 인위적이고 가장 자연스러워 보였습니다. Apache 2.0 라이선스와 결합되어, 라이선스 논의 없이 빠르게 진행해야 하는 클라이언트 프로젝트에서 가장 먼저 선택하게 될 모델입니다.
- Waifu Diffusion
Waifu Diffusion은 Hakurei가 제작했으며 애니메이션 스타일의 이미지 생성에 초점을 맞추고 있습니다. 애니메이션 데이터셋으로 특별히 훈련되어 일관된 캐릭터 디자인과 스타일화된 비주얼을 생성할 수 있습니다. Stable Diffusion을 기반으로 구축되어 해당 생태계에 직접 통합되므로, 이미 해당 도구에 익숙한 아티스트들이 쉽게 사용할 수 있습니다.
주요 특징:
- 애니메이션 중심 훈련: 이 모델은 대규모 애니메이션 이미지 데이터셋으로 훈련되어, 애니메이션 예술에서 흔히 볼 수 있는 캐릭터 비율, 얼굴 표정, 스타일적 요소를 학습하는 데 도움이 됩니다.
- 일관된 캐릭터 품질: 서로 다른 프롬프트에서도 안정적인 얼굴 특징, 헤어스타일, 의상 세부 정보를 유지하므로, 여러 장면에 동일한 캐릭터를 생성할 때 유용합니다.
- 프롬프트를 통한 스타일 제어: 애니메이션 커뮤니티에서 흔히 사용되는 태그와 프롬프트 스타일을 사용하여 출력물을 가이드할 수 있습니다.
- SDXL 기반 변형: SDXL을 기반으로 구축된 최신 버전은 애니메이션 스타일을 그대로 유지하면서 해상도, 조명, 더 세밀한 디테일을 개선합니다.
- 오픈 액세스 라이선스: 특정 조건 하에 사용 및 재배포를 허용하는 CreativeML OpenRAIL-M 라이선스로 배포됩니다.
- 광범위한 커뮤니티 지원: 수많은 사전 훈련된 체크포인트, LoRAs 및 스타일 팩을 사용할 수 있습니다.
내 경험: 3.5/5
Waifu Diffusion은 내가 실행한 세 번의 시도 모두에서 캐릭터의 얼굴과 의상을 일관되게 유지함으로써 애니메이션 프롬프트 테스트에서 완전히 승리했습니다. 하지만 실사 같은 초상화 프롬프트를 입력했을 때는 어떻게 표현하든 결과물이 여전히 애니메이션에 가까운 스타일로 나왔는데, 이는 좁은 데이터셋으로 훈련된 모델에서 정확히 예상할 수 있는 결과입니다. 한 가지 작업에는 훌륭하지만, 나머지 작업에는 적합하지 않습니다.
- Z-Image-Turbo
Z-Image-Turbo는 Tongyi-MAI에서 개발했습니다. 속도와 효율성에 초점을 맞추고 있어 빠른 이미지 생성이 필요한 애플리케이션에 적합합니다. 매우 거대한 아키텍처에 의존하지 않고도 강력한 결과를 제공하도록 설계된 소형 모델 제품군의 일부입니다.
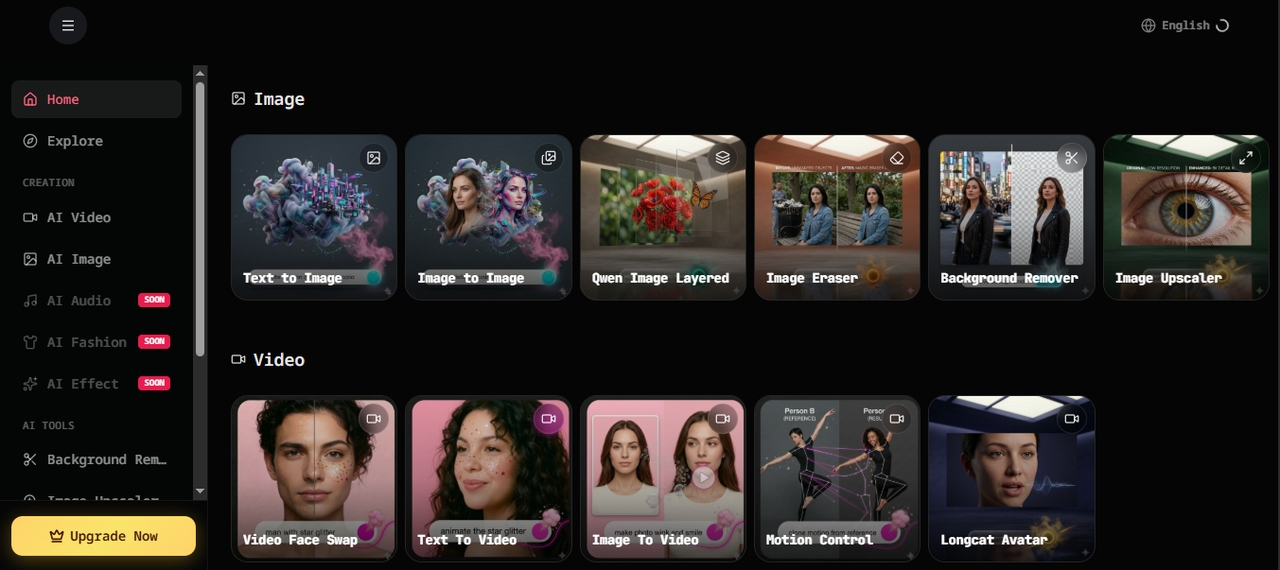
주요 특징:
- 1초 미만의 생성 속도: Z-Image-Turbo는 거대한 모델 크기에 의존하지 않고도 최상위 수준의 성능을 달성할 수 있음을 증명합니다.
- 이중 언어 텍스트 렌더링: 복잡한 중국어 및 영어 텍스트를 정확하게 렌더링하며, 포스터 디자인에서 강력한 구도 능력과 뛰어난 타이포그래피 감각을 보여줍니다.
- 프롬프트 향상 및 추론: 내장된 프롬프트 향상 기능이 모델에 추론 능력을 부여합니다.
- 효율적인 단일 스트림 아키텍처: Z-Image-Turbo는 텍스트, 시각적 의미론적 토큰, 이미지 VAE 토큰이 시퀀스 수준에서 하나의 통합된 입력 스트림으로 연결되는 Scalable Single-Stream DiT 아키텍처를 사용합니다.
나의 경험: 4/5
Z-Image-Turbo는 20개의 프롬프트 배치 전체를 4분 만에 처리해 냈으며, 이는 7개 모델 중 단연 가장 빠른 속도였습니다. 이중 언어 텍스트 렌더링은 포스터 프롬프트의 영어 및 중국어 버전 모두에서 잘 유지되었습니다. 복잡한 장면 프롬프트의 미세한 디테일은 Stable Diffusion 3.5 및 FLUX.2보다 한 단계 뒤처졌는데, 이는 모델 크기가 훨씬 작다는 점을 감안하면 당연한 결과입니다.
모델을 선택하기 전에 고려해야 할 주요 요소
하나를 결정하기 전에 확인해 볼 가치가 있는 몇 가지 실용적인 사항이 있습니다. 무엇을 살펴봐야 하고 그것이 왜 중요한지 소개합니다.
- 이미지 품질
이미지 품질은 요청한 내용과 비교하여 결과물이 얼마나 사실적이고 상세하며 정확하게 보이는지에 달려 있습니다. 일부 모델은 실사 같은 결과를 만들어내는 반면, 다른 모델은 더 스타일화된 경향을 보입니다. 올바른 선택은 프로젝트에 실제로 필요한 것이 무엇인지에 따라 달라집니다.
- 속도 (추론 시간)
추론 시간은 모델이 이미지 한 장을 생성하는 데 걸리는 시간입니다. 수백 개의 이미지를 일괄 생성하거나 실시간 도구를 구축하는 경우 속도가 매우 중요합니다. 훌륭한 결과를 내더라도 속도가 느린 모델은 항상 실용적이지는 않을 수 있습니다.
- VRAM 요구 사양
VRAM은 그래픽 카드가 모델을 실행하는 데 사용하는 메모리입니다. 더 큰 모델은 더 많은 메모리가 필요하며, 때로는 16GB 이상이 필요합니다. 하드웨어가 요구 사양을 충족하지 못하면 모델이 아예 실행되지 않거나, 너무 느리게 실행되어 유용하지 않을 수 있습니다.
- 텍스트 렌더링 능력
일부 모델은 이미지 내의 텍스트를 잘 처리하지만, 다른 모델은 완전히 엉망으로 만듭니다. 결과물에 표지판, 포스터, 라벨 또는 작성된 콘텐츠가 포함되는 경우 이는 중요한 요소가 됩니다. GLM-Image 및 Qwen-Image-2512와 같은 모델은 특히 이를 염두에 두고 구축되었습니다.
- 라이선스 (상업용 vs 제한됨)
일부 모델은 개인용 또는 연구용으로는 무료이지만 상업적 작업에는 유료 라이선스가 필요합니다. Z-Image-Turbo 및 Qwen-Image-2512와 같은 다른 모델들은 Apache 2.0에 따라 완전히 개방되어 있습니다. 클라이언트 프로젝트나 제품에 모델을 사용하기 전에 항상 라이선스를 확인하세요.
- 생태계 및 커뮤니티
강력한 커뮤니티는 더 많은 튜토리얼, 사전 구축된 파인튜닝, 플러그인, 문제가 발생했을 때의 더 빠른 해결책을 의미합니다. Stable Diffusion, 예를 들어, 수천 개의 커뮤니티 생성 리소스를 보유하고 있습니다. 더 새롭거나 틈새 시장을 겨냥한 모델은 인상적일 수 있지만 지원을 거의 받지 못할 수 있습니다.
이 여섯 가지 요소를 함께 고려해 보면 오픈 소스가 공짜 점심처럼 보이지 않기 시작합니다. 이미지 품질과 텍스트 렌더링을 완벽하게 처리하는 모델은 여러분에게 없는 16GB 이상의 VRAM을 요구할 수 있으며, 쓸 만한 결과물을 내기 전에 로컬 설정을 디버깅하는 데 실제 시간을 허비해야 할 수도 있습니다. 직접 모델을 호스팅하지 않고도 최상위 수준의 성능을 원하거나, 이러한 오픈 소스 옵션이 전혀 범접할 수 없는 폐쇄형 모델에 액세스하고 싶다면, 바로 그 자리에 Framia Pro가 적합합니다.
Framia Pro: 비오픈 소스 모델 작업을 위한 선택지
Framia Pro는 단일 엔진을 선택하고 그 한계에 갇히는 대신, Seedream 5.0 Pro, Nano Banana Pro, Kling, Seedance 2.5, Veo 3.1과 같은 파트너의 폐쇄형 모델들을 하나의 작업 공간에 연결하는 워크플로우 캔버스를 중심으로 구축된 AI 크리에이티브 플랫폼입니다. 원하는 것을 설명하면, Framia Pro가 프로세스의 어느 시점에서나 편집할 수 있는 연결된 노드 전반에서 스크립트, 비주얼, 조립을 처리합니다. 이미지 생성, 비디오, 그리고 전체 Marketing Studio를 한곳에 모아두어, 오픈 소스가 아닌 모델의 결과물이 필요한 크리에이터가 이를 위해 여러 개의 구독을 짜깁기할 필요가 없습니다.
저는 위의 7개 모델과 함께 Framia Pro에서 몇 시간을 보내며 폐쇄형 모델 경험이 실제로 어떻게 비교되는지 확인해 보았고, 아래에 적합한 부분과 그렇지 않은 부분을 정리해 두었습니다.
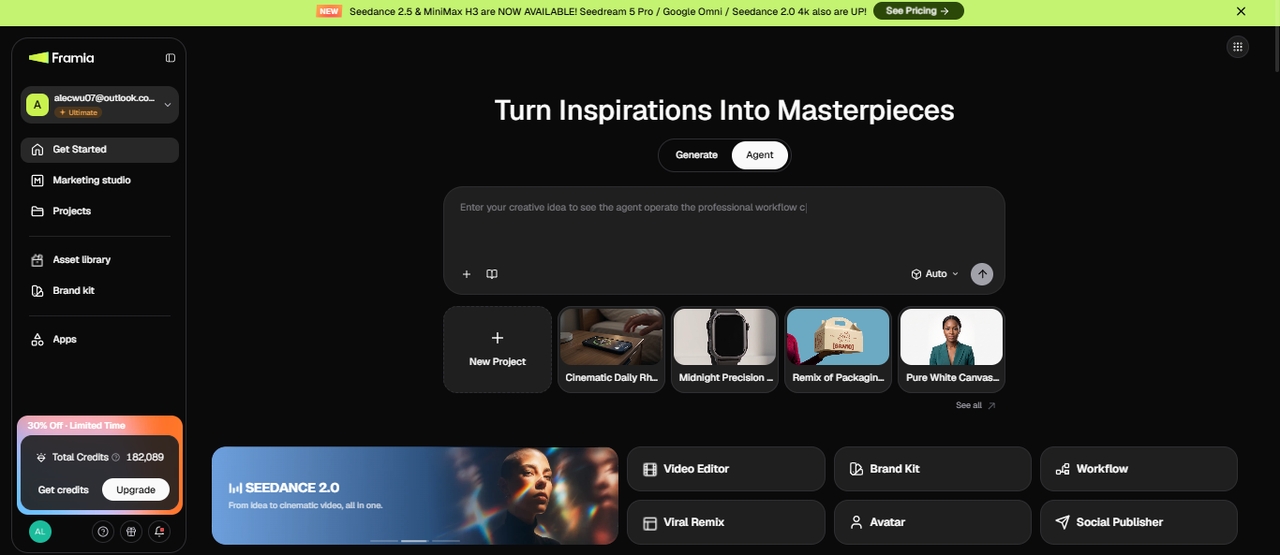
Framia Pro 이미지 생성기의 기능
Framia Pro는 다양한 최고의 이미지 생성 모델을 사용하여 이미지를 생성하고 편집할 수 있는 단일 작업 공간을 제공합니다. 각 기능은 이미지가 생성되고 정제되는 방식을 사용자가 제어할 수 있도록 설계되었습니다.
- 모든 단계를 연결하는 워크플로우 캔버스
Framia Pro의 캔버스는 프로젝트가 진행됨에 따라 드래그하고, 추가하거나, 제거할 수 있는 연결된 노드(스크립트, 이미지, 비디오, 오디오)로 프로젝트를 배치합니다. 하나의 이미지를 생성하고 다음 에셋을 위해 처음부터 다시 시작하는 대신, 전체 시퀀스를 빌드하고 변경이 필요한 노드만 다시 실행할 수 있습니다.
- 하나의 작업 공간에 있는 여러 AI 모델
Framia Pro는 단일 플랫폼 내에서 이미지를 위한 Nano Banana Pro, Qwen Image, Midjourney v7, Flux Max, Seedream 4.5뿐만 아니라 비디오를 위한 Kling, Veo 3.1, Seedance에 대한 액세스를 제공합니다. 원하는 결과에 따라 모델을 전환하고 별도의 도구를 열지 않고도 출력을 나란히 비교할 수 있습니다.
- 일관된 비주얼을 위한 Brand Kit
Framia Pro의 Brand Kit 생성기는 단일 브리프에서 로고, 색상 팔레트, 타이포그래피, 소셜 템플릿을 구축한 다음, 이후에 생성하는 모든 이미지를 해당 브랜드 가이드라인에 맞게 고정합니다. 이는 캠페인 전반에 걸쳐 대량의 비주얼을 제작하는 마케팅 팀과 기업에 중요합니다.
- 리믹스할 수 있는 트렌디한 템플릿
Framia Pro는 빈 캔버스에서 개념을 구축하는 대신 선택하여 자신만의 프롬프트로 리믹스할 수 있는 트렌디하고 바이럴 준비가 된 템플릿 갤러리를 유지합니다. 이는 이 가이드가 초점을 맞추는 스타일보다는 빠른 전환이 필요한 소셜 콘텐츠를 겨냥한 것이지만, 비디오도 제작하는 경우 알아둘 가치가 있습니다.
- 간단한 채팅 명령어로 이미지 편집
배경 교체나 로고 크기 조정과 같이 일상적인 언어로 변경 사항을 설명하면 Framia Pro가 이미지에 직접 적용합니다. 이 채팅 기반 편집은 수동 마스킹이나 작은 수정을 위해 전체 생성을 다시 수행하는 과정을 생략합니다.
결론
이 기사에서는 상위 7개의 오픈 소스 이미지 생성 모델을 살펴보고 다양한 도구가 이미지 생성, 성능 및 유연성을 어떻게 처리하는지 보여주었습니다. 각 모델은 시각적 품질, 속도, 하드웨어 요구 사항 및 다양한 스타일 지원과 같은 영역에서 고유한 강점을 제공합니다. Framia Pro는 여러 모델을 한곳에 모아 별도의 도구 간에 전환할 필요 없이 단일 워크플로우에서 이미지를 생성하고 편집할 수 있는 더 많은 옵션을 제공합니다. 지금 시도해 보세요!
자주 묻는 질문
어떤 오픈 소스 AI 이미지 생성기가 가장 자주 사용되나요?
Stable Diffusion은 활발한 커뮤니티와 광범위한 도구 지원 덕분에 가장 널리 사용되는 오픈 소스 이미지 생성기 중 하나로 남아 있습니다. Framia Pro에서는 하나의 작업 공간에서 다양한 이미지 모델에 액세스할 수 있으므로 각 생성기마다 별도의 환경을 설정할 필요가 없으며 출력 간 전환이 더 쉬워집니다.
어떤 이미지 생성 모델이 더 높은 시각적 품질을 생성하나요?
SDXL 기반 및 Flux 시리즈와 같은 최신 모델은 종종 더 선명한 텍스처, 개선된 조명 및 더 나은 구도를 생성합니다. Framia Pro는 Nano Banana Pro, Seedream 4.5, Flux Max, Qwen Image 및 Midjourney v7 모델에 대한 액세스를 제공하여 이미지를 즉시 생성할 수 있도록 합니다.
제한된 하드웨어에서 어떤 모델이 이미지 생성에 가장 적합한가요?
최적화되거나 경량화된 버전의 모델은 VRAM이 제한된 시스템에 더 적합합니다. Framia Pro는 백엔드에서 모델 액세스를 처리하므로, 로컬 설정을 관리할 필요 없이 더 무거운 모델을 실행할 수 있어 사용자 측의 고사양 하드웨어 필요성을 줄여줍니다.
어떤 모델이 최고의 오픈소스 이미지 생성 모델로 평가받나요?
Stable Diffusion, Waifu Diffusion, ControlNet 기반 설정과 같은 모델은 실사체, 애니메이션 아트, 구조적 제어 등 다양한 작업에 흔히 사용됩니다. Framia Pro는 이러한 옵션들을 한데 모아 단일 프로젝트 내에서 여러 모델을 선택하고 테스트할 수 있도록 지원합니다.
전문적인 사용 사례에서는 어떤 이미지 모델이 선호되나요?
전문적인 워크플로우에서는 종종 안정적인 출력, 일관된 결과, 편집 지원이 필요합니다. Framia Pro는 채팅 기반 이미지 편집 및 일괄 생성을 제공하여 도구를 전환하지 않고도 한 곳에서 이미지를 미세 조정하고 여러 변형을 생성할 수 있도록 가치를 더합니다.
가장 우수한 무료 이미지 생성 모델은 무엇인가요?
Stable Diffusion 3.5는 Medium 및 Large Turbo 변형이 소비자급 하드웨어에서 실행되고 라이선스가 소규모 비즈니스의 상업적 이용을 보장하므로 가장 완전한 무료 옵션입니다. Z-Image-Turbo 및 Qwen-Image-2512 역시 Apache 2.0에 따라 완전 무료이며, 더 빠른 출력을 제공하지만 현재까지 형성된 커뮤니티 규모는 더 작습니다.
로컬에서 실행 가능한 오픈소스 AI 이미지 생성기가 있나요?
네, 그렇습니다. Stable Diffusion 3.5, ControlNet 1.1, FLUX.2, Waifu Diffusion, Z-Image-Turbo는 다운로드 후 클라우드 계정이나 구독 없이도 자체 하드웨어에서 로컬로 실행됩니다. 주요 요구 사항은 충분한 VRAM이며, 선택하는 모델에 따라 일반적으로 6GB에서 24GB가 필요합니다.
오픈소스 이미지 모델을 상업적 프로젝트에 사용할 수 있나요?
네, 하지만 모델의 라이선스에 따라 다릅니다. 일부 모델은 상업적 이용을 허용하는 반면, 다른 모델은 제한이 있습니다. 생성된 이미지를 클라이언트 작업, 제품 또는 유료 캠페인에 사용하기 전에 항상 라이선스 약관을 검토하세요.