Compartilhar


- Modelos de geração de vídeo por IA transformam um prompt de texto, imagem ou clipe existente, eu armazenei minhas cores, em novas filmagens por meio de um processo de difusão que refina o ruído aleatório passo a passo até corresponder à sua descrição.
- Cinco modelos de código fechado lideram o grupo no momento, cada um com uma força diferente: Veo 3.1 (áudio nativo), Runway Gen-4.5 (controle criativo), Seedance 2.5 (clipes longos em plano-sequência), Kling 3.0 (movimento fisicamente preciso) e MiniMax H3 (entrada multimodal unificada).
- Wan 2.2, Mochi e HunyuanVideo oferecem mais controle e sem limites de uso, mas você precisará de um hardware mais potente e de algum tempo de configuração.
- O Framia Pro reúne vários desses modelos em um único painel, para que você possa alternar entre eles sem precisar lidar com logins e assinaturas separados.
O que são modelos de geração de vídeo por IA?
Modelos de geração de vídeo por IA são sistemas que criam vídeos a partir de um prompt, de uma imagem ou de um clipe existente, sem a necessidade de uma câmera ou de uma equipe envolvida.
Eles aprendem com enormes conjuntos de dados, milhões de clipes de vídeo combinados com descrições, e captam os padrões visuais que conectam uma frase como "um cachorro correndo na neve" ao que isso realmente parece na tela.
A técnica por trás disso é chamada de difusão. O modelo começa com ruído aleatório e o limpa ao longo de dezenas de etapas até que um vídeo apareça. Durante o treinamento, ele observou vídeos reais serem corrompidos em ruído e aprendeu a reverter esse processo. No momento da geração, seu prompt direciona cada etapa de limpeza para a cena que você descreveu.
A parte difícil não é um único quadro. É manter centenas de quadros consistentes entre si. Um rosto, uma roupa ou uma sombra precisam se manter estáveis ao longo de todo o clipe, e não apenas parecerem corretos isoladamente.
Modelos de vídeo processam sequências inteiras de quadros juntas para que cada quadro possa fazer referência aos outros, e é por isso que a geração de vídeo exige muito mais processamento do que uma única imagem.
Quais são os diferentes tipos de IA para modelos de vídeo?
Antes de começar a testar, precisei entender qual tipo de ferramenta eu estava realmente usando, já que nem todo gerador de vídeo por IA começa do mesmo ponto.
Modelos de IA de texto para vídeo
Modelos de texto para vídeo transformam uma descrição escrita em uma cena em movimento do zero. Você escreve o que deseja e o modelo cria os elementos visuais. Isso funciona melhor quando você tem uma ideia, mas nenhuma filmagem ou imagem de referência para começar, como o conceito de um produto, o ritmo de uma história curta ou uma cena.
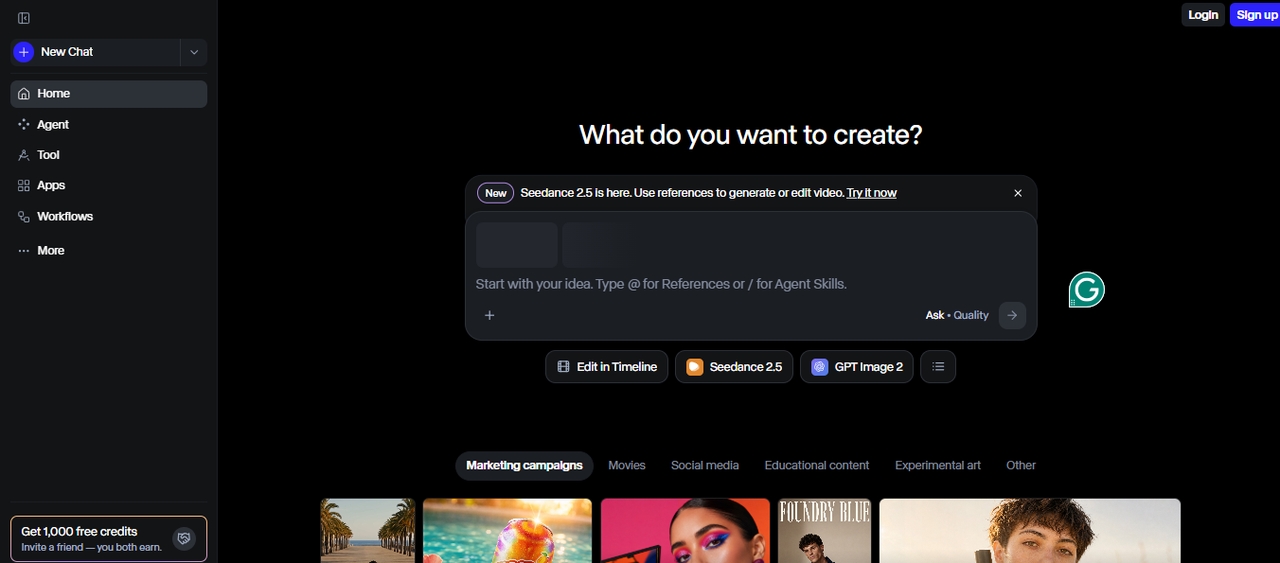
Modelos de imagem para vídeo
Modelos de imagem para vídeo começam a partir de uma imagem que você já possui e adicionam movimento, movimento de câmera ou pequenas alterações para dar vida a ela. Isso é ideal para demonstrações de produtos e postagens em redes sociais onde você deseja um movimento rápido sem precisar gerar tudo do zero.
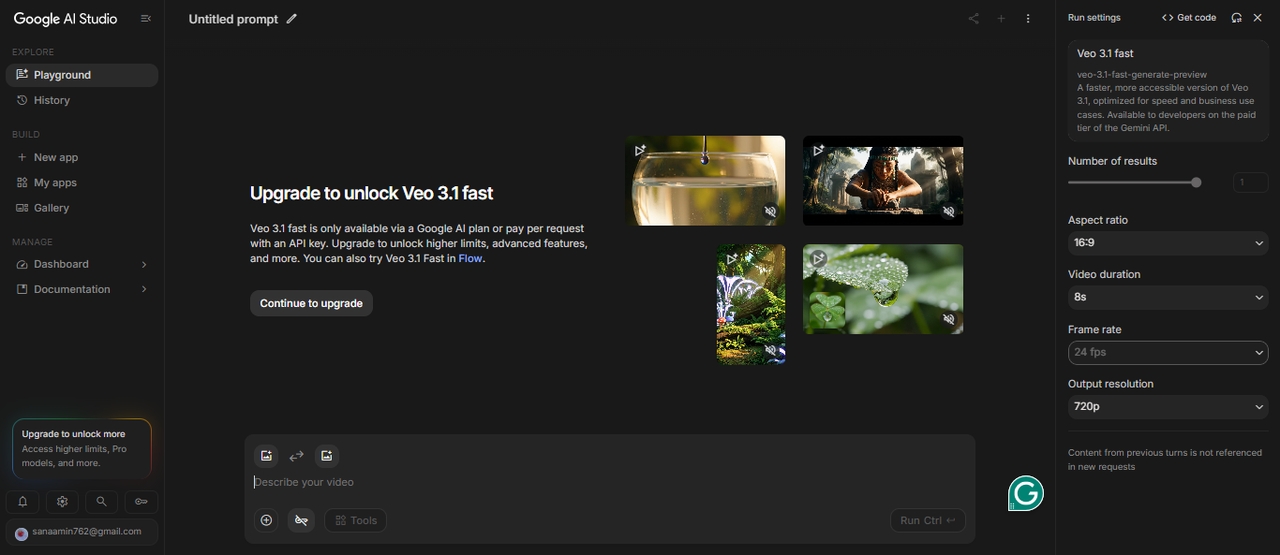
Modelos de vídeo multimodais
Esses modelos funcionam com mais de um tipo de entrada ao mesmo tempo. Você pode misturar texto, imagens, áudio e até clipes de vídeo existentes para guiar o resultado final.
Isso oferece mais controle sobre o resultado do vídeo. Você não está apenas descrevendo uma cena, está moldando-a com múltiplas entradas. Esse controle ajuda quando você deseja detalhes específicos, uma narrativa mais fluida ou um vídeo que siga uma direção clara.
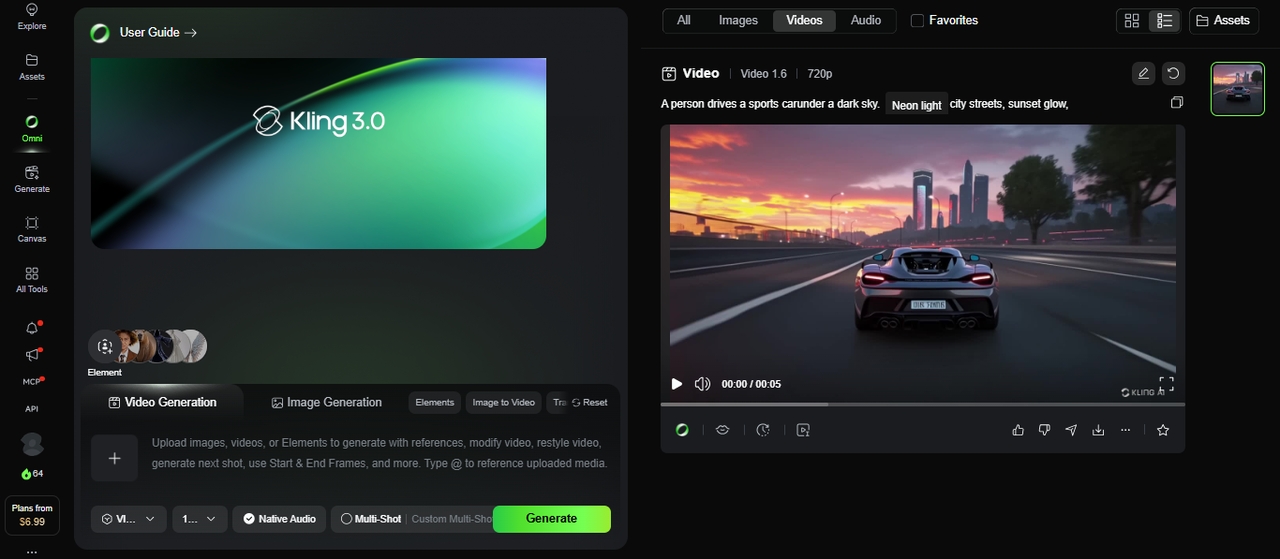
Como testamos cada modelo
Sou um estrategista de conteúdo que passou os últimos dois anos testando ferramentas criativas de IA para ganhar a vida, e passei cada modelo de geração de vídeo por IA pelos mesmos cinco prompts que incluem uma demonstração de produto, uma cena narrativa curta, um clipe de talking-head, uma sequência de ação e uma peça de arte estilizada.
Para cada modelo, gerei pelo menos três resultados por prompt e os avaliei quanto ao realismo, precisão de movimento, aderência ao prompt e qualidade de áudio, onde aplicável.
8 modelos de geração de vídeo por IA, e o que cada um faz de melhor
Após testar oito modelos de geração de vídeo por IA em demonstrações de produtos, cenas narrativas, clipes de busto falante (talking-head), sequências de ação e visuais estilizados, descobri que nenhum modelo individual teve o melhor desempenho em todas as categorias. O Veo 3.1 se destacou pelo áudio nativo, o Runway Gen-4.5 pelo controle criativo e consistência de cena, e o Seedance 2.5 por clipes mais longos de passagem única. O Kling 3.0 foi uma opção forte para cenas com muito movimento, enquanto o MiniMax H3 lidou bem com entradas mistas e áudio sincronizado. Wan 2.6, Mochi e HunyuanVideo ofereceram alternativas para usuários que preferem modelos de pesos abertos e fluxos de trabalho locais, embora os requisitos de hardware e a configuração possam ser fatores limitantes.
Estes resultados são baseadas em meus testes práticos, não em um ranking universal. A melhor escolha depende do seu tipo de vídeo, requisitos de saída, orçamento e se você prefere um serviço hospedado ou um modelo que você mesmo possa executar.
Abaixo, detalho os pontos fortes, recursos, prós e contras de cada modelo para ajudar você a escolher o ideal para o seu projeto.
Abaixo estão os principais modelos de código fechado que você deve conhecer agora.
| Recurso | Veo 3.1 | Runway Gen-4.5 | Seedance 2.5 | Kling 3.0 | MiniMax H3 |
| Resolução Máxima | 1080p | 1080p | 1080p nativo | 4K / 60fps, primeiro modelo a atingir 4K nativo a 60fps | 2K a 24fps, 768p também disponível |
| Duração Máxima do Clipe | 8 segundos nativamente, extensível via ferramentas de terceiros | Até 16 segundos no Gen-4 | Até 30 segundos em uma única tomada contínua | Até 2 minutos, extensível para 3 minutos | 5–15 segundos, extensível para 30 com a ferramenta Extend integrada |
| Taxa de Quadros | 24–30fps | 24fps | Ainda não publicado | 30fps | 24fps |
| Áudio Nativo | ✅ Diálogo, SFX, ambiente | ✅ Adicionado em Dez de 2025 | ✅ Mais de 10 idiomas | ✅ | ✅ Estéreo nativo |
| Entrada Multimodal | ✅ Até 3 refs de imagem | ❌ | ✅ Até 50 referências, 30 imagens, 10 vídeos, 10 áudios | ✅ Texto, imagem, áudio, vídeo | ✅ Texto, imagem, vídeo e áudio lidos como um único contexto |
| Multi-Shot | ❌ | ✅ | ✅ Tomada única contínua, sem emendas | ✅ Até 6 tomadas | ❌ |
| Motor de Física | ✅ | ❌ | Não especificado | ✅ | Não especificado |
| Modo Rápido / Rascunho | ✅ Veo 3 Fast | ✅ Gen-4 Turbo | Ainda não publicado | ✅ Até 20x mais rápido | ✅ Opção mais leve de 768p |
| Proporções | 16:9 e 9:16 | 16:9, 9:16, 1:1 | Ainda não publicado | 16:9, 9:16, 1:1 | 21:9, 16:9, 4:3, 1:1, 3:4, 9:16 |
| Plano Gratuito | ❌ | ❌ | Sendo lançado no Jimeng AI, Doubao, Dreamina | ✅ 66 créditos diários | Via aplicativo Hailuo AI |
| Melhor Para | Realismo + áudio | Controle cinematográfico | Clipes longos de tomada única + referências | 4K + formato longo | Edição multimodal + consistência |
- Veo 3.1
O Veo 3.1 é o modelo de geração de vídeo topo de linha do Google, e o áudio é onde ele se diferenciou do restante dos meus testes. Ele gera diálogos, efeitos sonoros e áudio ambiente na mesma passagem que o vídeo, tudo a partir de um único prompt. Ele se tornou o motor por trás de uma onda de clipes virais nas redes sociais após o lançamento em outubro de 2025, e sua integração com o Google Workspace facilitou sua adoção nas partes do meu fluxo de trabalho que já residem nesse ecossistema.
Recursos
- Áudio nativo: diálogo, SFX e som ambiente em uma única passagem.
- Resolução 4K: saída de até ultra-alta definição.
- Multi-referência: suporta até 3 imagens de referência.
- Longa duração: produz saídas de até um minuto completo.
- Diálogo no prompt: escreva a fala do personagem diretamente no seu prompt.
Prós
- Qualidade de áudio nativo incomparável.
- Excelente realismo e precisão de iluminação.
- Integração profunda com o ecossistema do Google.
- Forte precisão de prompt.
Contras
- Vídeos com marca d'água nos planos inferiores.
- Menos flexível para conteúdo estilizado ou não realista.
- Runway Gen-4.5
A Runway tem sido uma presença constante em modelos de vídeo de IA generativa há anos, e o Gen-4.5, lançado no final de 2025, é onde notei o maior salto em qualidade e sequenciamento multi-shot. Sua interface de chat me permitiu refinar um vídeo descrevendo as alterações em uma conversa, em vez de reescrever o prompt do zero. De tudo o que testei, este é o modelo que eu indicaria para um profissional de criação quando a consistência de cena e personagem é importante em várias tomadas.
Recursos
- Pincéis de movimento: pinte exatamente quais partes de uma cena devem se mover.
- Multi-shot: encadeie vários clipes em uma sequência coesa.
- Act-one: captura de expressão facial e movimento.
- Edição por chat: refine os resultados por meio de uma conversa natural.
- Saída em 4K: exportação em ultra-alta resolução.
Prós
- Melhor consistência de cena e personagem da categoria.
- Controles criativos poderosos para profissionais.
- Comunidade e ecossistema fortes.
Contras
- Caro nos níveis mais altos.
- Mais lento do que alguns concorrentes para conteúdo rápido de redes sociais.
- Curva de aprendizado mais íngreme para iniciantes.
- Seedance 2.5
O Seedance 2.5 é a continuação da ByteDance para o Seedance 2.0, que liderou o Artificial Analysis Video Arena tanto para text-to-video quanto para image-to-video no início de 2026. A nova versão estende a geração de passagem única de 15 segundos para 30 segundos completos, passa para 1080p nativo e aceita até 50 referências multimodais (uma mistura de imagens, vídeo e áudio) em uma única geração, em comparação com as 12 da versão anterior. Ela também adiciona áudio nativo em mais de 10 idiomas, e eu a testei enquanto estava sendo implementada no Jimeng AI, Doubao e Dreamina, com acesso à API disponível através do BytePlus ModelArk.
Recursos
- Geração de passagem única estendida: até 30 segundos em um clipe contínuo, sem necessidade de emendas.
- 1080p nativo: em comparação com os 720p da versão anterior.
- Suporte expandido a referências: até 50 referências multimodais (30 imagens, 10 vídeos, 10 áudios) em uma única geração.
- Áudio multilíngue nativo: diálogo e som em mais de 10 idiomas.
- Edição precisa: substitua um produto, estenda uma cena ou faça uma edição direcionada sem regenerar o clipe inteiro.
- Pré-visualização de modelo branco em 3D: planeje movimentos de câmera e tomadas antes de se comprometer com uma geração completa.
Prós
- Clipes longos em plano-sequência funcionam bem para dramas de formato curto e conteúdo serializado.
- Forte continuidade de câmera de plano para plano ao longo de uma tomada completa de 30 segundos.
- O número expandido de referências oferece mais controle sobre a consistência de personagens e produtos.
Contras
- A ByteDance ainda não publicou um relatório técnico completo, então algumas especificações vêm de demonstrações de lançamento em vez de testes independentes.
- O acesso completo à API não estava ativo em todos os lugares no momento dos testes.
- Kling 3.0
O Kling 3.0 foi lançado em 4 de fevereiro de 2026 e, em poucos dias, já estava sendo chamado de o maior salto na geração de vídeo por IA do ano. Ele roda em uma arquitetura Omni One que combina 3D Spacetime Joint Attention com raciocínio de cadeia de pensamento, que foi como conseguiu fazer com que a gravidade, o equilíbrio, a deformação e a inércia parecessem reais em vez de com aspecto de borracha nos meus testes. Ele aceita entrada multimodal de texto, imagens, áudio e vídeo, e gera áudio nativo em inglês, chinês, japonês, coreano e espanhol, com controle sobre o diálogo dos personagens e a ordem de fala.
Recursos
- Física Omni One: simulação real de gravidade, colisão e inércia.
- Áudio nativo: dublagens, sincronia labial, SFX e música.
- Storyboard de múltiplos planos: até 6 planos com controle de câmera de nível de diretor.
- Modo rascunho: gere até 20x mais rápido para prototipagem rápida.
- Saída 4K/60fps: com exportação HDR de 16 bits e EXR.
- Editor 7 em 1: adição de objetos, troca de fundo, transferência de estilo em uma única ferramenta.
Prós
- Física e movimento humano mais realistas disponíveis.
- Áudio multilíngue nativo com controle de dialeto e sotaque.
- Entrada acessível a $7,99/mês com um bom plano gratuito.
- Exporta diretamente para pipelines de VFX profissionais (Nuke, After Effects, DaVinci).
Contras
- A renderização de múltiplos planos de 15 segundos pode levar mais de 5 minutos.
- Saída 4K atualmente limitada a planos de nível superior.
- Períodos de alta demanda estendem as filas de renderização.
- MiniMax H3
O MiniMax H3, também conhecido como Hailuo 3.0, segue o Hailuo 02 na linha de vídeos da MiniMax. Em vez de tratar referências de texto, imagem, vídeo e áudio como entradas separadas, ele lê todas juntas como um contexto compartilhado e, em seguida, retorna vídeo e áudio sincronizados em um único resultado. A MiniMax disse que planeja lançar os pesos do modelo, embora eu tenha acessado através do aplicativo Hailuo AI, da API MiniMax Open Platform e de parceiros de hospedagem como fal.
Recursos
- Contexto multimodal unificado: referências de texto, imagem, vídeo e áudio resolvidas juntas em uma única geração.
- Áudio estéreo nativo: diálogo, música, efeitos e ambiente gerados junto com o vídeo, não adicionados em camadas depois.
- Até 2K de resolução a 24fps, com 768p também disponível como uma opção mais leve.
- Gerações de 5 a 15 segundos, extensíveis até 30 segundos com a ferramenta integrada Extend Video.
- Edição direcionada: troque ou remova personagens e objetos, altere a iluminação ou os fundos, ou revise o diálogo sem refazer o clipe inteiro.
- Múltiplas proporções de tela: 21:9, 16:9, 4:3, 1:1, 3:4 e 9:16.
Prós
- Forte consistência temporal; o movimento permanece estável durante todo o clipe em vez de se desviar no meio do caminho.
- O áudio estéreo nativo sai da mesma etapa de geração, sem uma etapa de som separada.
- O amplo suporte a proporções de tela se adapta a tudo, desde widescreen cinematográfico até conteúdo social vertical.
Contras
- A MiniMax ainda não publicou um relatório técnico completo, portanto, algumas alegações vêm da própria empresa, e não de benchmarks independentes.
- Executar a versão de pesos abertos localmente exigirá uma GPU de ponta com mais de 24 GB de VRAM assim que os pesos forem lançados.
| Recurso | Wan 2.2 | Mochi 1 (Genmo) | HunyuanVideo (Tencent) |
| Parâmetros | 1,3B / 14B | 10B | 13B |
| Resolução Máxima | 720p (1080p em 14B) | 480p (640x480) | 720p (1080p com v1.5) |
| Duração Máxima do Clipe | Até 10 segundos | Até 5,4 segundos a 30fps | Até 5 segundos (720p) |
| Taxa de Quadros | 16fps | 30fps | 24fps |
| VRAM Mínima | 8GB (modelo 1,3B) | 20GB+ em precisão total | 14GB (v1.5) / 60–80GB (original) |
| Velocidade de Geração | 1–2 min para clipe de 4–5 seg (GPU de 8GB) | 3–4 min para clipe de 5,4 seg | 6–10 min para clipe de 5 seg (GPU de 16GB) |
| Text-to-Video | ✅ | ✅ | ✅ |
| Image-to-Video | ✅ | ❌ | ✅ |
| Fine-Tuning LoRA | ✅ | ✅ | ✅ (alto processamento necessário) |
| Suporte ao ComfyUI | ✅ | ✅ | ✅ |
| Suporte ao Diffusers | ✅ | ❌ | ✅ |
| Prompts Bilíngues | ✅ Inglês + Chinês | ❌ | ❌ |
| Licença | Apache 2.0 | Apache 2.0 | Tencent Community License |
| Compatível com GPU de Consumo | ✅ Melhor da categoria | ❌ | ⚠️ apenas v1.5 |
| Melhor Para | Versatilidade + acessibilidade | Fotorrealismo + fine-tuning | Qualidade cinematográfica + rostos |
- Wan 2.6
O Wan 2.6 é a série de modelos de geração de vídeo da Alibaba, lançada em dezembro de 2025. Ele suporta geração text-to-video, image-to-video e reference-to-video. Seus principais pontos fortes incluem narrativa multi-shot, melhor seguimento de prompts e áudio que permanece sincronizado com os visuais. O modelo reference-to-video também pode usar um clipe de referência para preservar a aparência e a voz de uma pessoa ou objeto em cenas recém-geradas.
O Wan 2.6 continua sendo uma opção para criadores que desejam experimentar cenas geradas por IA, vídeos de produtos ou clipes baseados em diálogos.
Recursos
- Arquitetura MoE: especialistas dedicados para diferentes estágios de ruído.
- Híbrido T2V/I2V: entrada de texto e imagem em um modelo unificado.
- Quantização GGUF: roda em GPUs de consumo com 4GB de VRAM.
- Controles cinematográficos: rótulos de iluminação, contraste e tom de cor.
- Suporte bilíngue: processamento de prompts em inglês e chinês.
- Acesso hospedado: Use modelos Wan suportados através do Alibaba Cloud Model Studio
Prós
- Suporta vários fluxos de trabalho de geração de vídeo dentro de uma família de modelos.
- Controles multi-shot são adequados para histórias curtas, anúncios e demonstrações de produtos.
- A referência para vídeo pode ajudar a manter a identidade do personagem em cenas geradas.
- Oferece recursos de áudio e diálogo sincronizados em variantes suportadas.
Contras
- Os clipes são curtos, portanto, projetos mais longos podem exigir múltiplas gerações e edição.
- O acesso hospedado pode envolver cobranças de API ou restrições específicas do serviço.
- Mochi (Genmo)
O Mochi 1 é um modelo de 10 bilhões de parâmetros construído em uma nova arquitetura AsymmDiT, lançado sob a licença Apache 2.0. Ele se destacou no movimento fotorrealista de 30fps em meus testes, o que o torna ideal para filmagens em estilo documentário, ambientes naturais e movimentos humanos que precisam parecer reais. Foi um dos primeiros modelos de código aberto que me fez levar a sério a geração de vídeo local.
Recursos
- Backbone AsymmDiT: arquitetura construída especificamente para síntese de vídeo.
- Saída de 30fps: movimento suave na taxa de quadros nativa.
- Ajuste fino LoRA: personalize em seus próprios conjuntos de dados de vídeo.
- Licença Apache 2.0: aberto para pesquisa e uso comercial.
- Integração com o ComfyUI: suporte a fluxo de trabalho baseado em nós.
- Codificação T5-XXL: forte compreensão de texto e aderência ao prompt.
Prós
- O licenciamento mais permissivo de qualquer modelo aberto de alta qualidade.
- Excelente movimento fotorrealista e movimento natural.
- Comunidade forte com compartilhamento ativo de fine-tunes.
Contras
- Limitado à resolução de 480p; requer upscaling para saída em HD.
- Necessita de 20GB+ de VRAM em precisão total.
- HunyuanVideo (Tencent)
O HunyuanVideo é o principal modelo de vídeo de código aberto da Tencent, desenvolvido para geração de alta qualidade com forte consistência de movimento e uma estrutura de cena mais limpa do que a maioria das alternativas abertas que testei. Sua arquitetura baseada em transformer lida com dados visuais e temporais em conjunto, e eu recorri a ele sempre que queria mais controle sobre o processo de geração do que uma ferramenta hospedada me daria.
Recursos
- Maior escala de 1b na categoria de código aberto.
- Fusão de fluxo duplo: processamento separado de texto e vídeo antes da mesclagem.
- Paralelismo xDiT: paralelismo de sequência multi-GPU para inferência mais rápida.
- Quantização FP8: consumo de memória reduzido sem grande perda de qualidade.
- Diffusers + comfyUI: integração plug-and-play com o ecossistema.
- VAE 3D Causal: compressão espaço-temporal para movimento coerente.
Prós
- Melhor qualidade cinematográfica e realismo facial em código aberto.
- Ecossistema massivo de LoRA para personalização de estilo e personagens.
- Forte capacidade de lidar com múltiplas pessoas e cenas complexas.
Contras
- Um clipe de 5 segundos pode levar mais de 15 minutos, dependendo das configurações.
- Alta complexidade de configuração; não é adequado para iniciantes.
Explore os principais modelos de vídeo de IA no Framia Pro
Aqui está o problema real que enfrentei: eu não queria uma conta do Google para o Veo, uma assinatura da Runway para o Gen-4.5 e um login da Kuaishou para o Kling, e depois repetir essa configuração toda vez que um novo modelo fosse lançado. Essa é a razão pela qual mudei a maior parte destes testes para o Framia Pro.
O Framia Pro reúne o Veo 3.1, Kling 3.0, Seedance 2.5 e outros modelos de vídeo e imagem de ponta em um único espaço de trabalho. Eu podia começar com uma ideia e transformá-la em vídeo usando texto, imagens, áudio ou uma mistura dos três, sem alternar de aba ou pagar por uma conta separada para cada modelo. Agentes criativos integrados também cobrem casos de uso específicos, como videoclipes, anúncios e storytelling, então eu tinha um ponto de partida não importa o que estivesse criando.
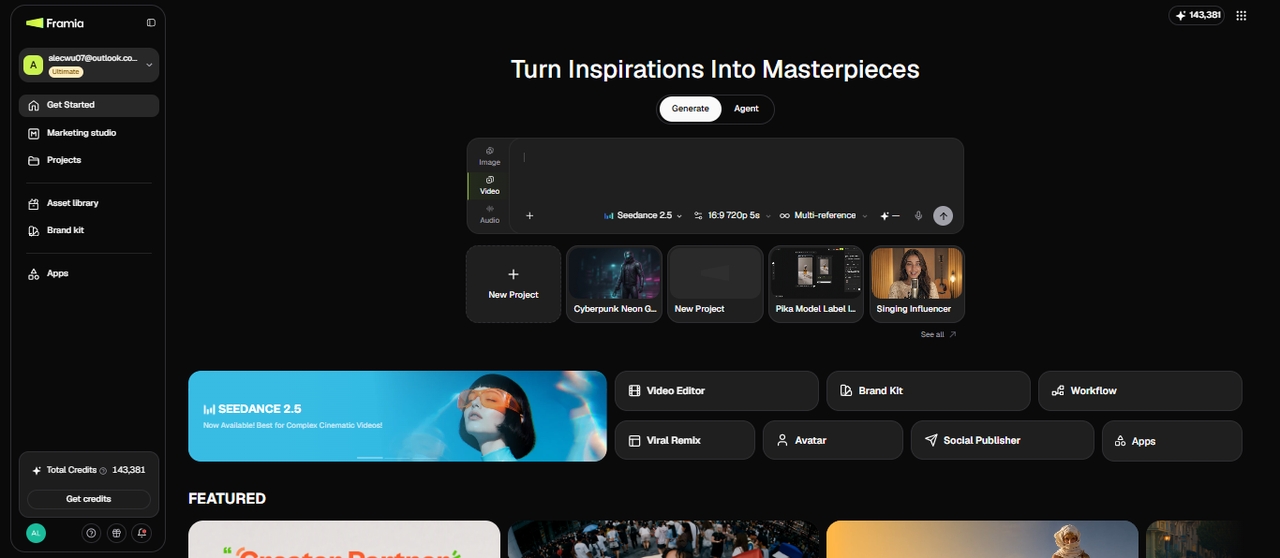
O que o Framia Pro traz para a mesa?
Tentei criar um vídeo de lançamento de produto de e-commerce na tela. Comecei com um agente de Imagem para gerar fotos limpas do produto, inseri-as em um nó de Vídeo que as transformou em um clipe de demonstração com o Kling ou Seedance, e depois direcionei o resultado através de um nó de Áudio para uma narração correspondente, tudo dentro de uma única tela em vez de quatro ferramentas separadas.
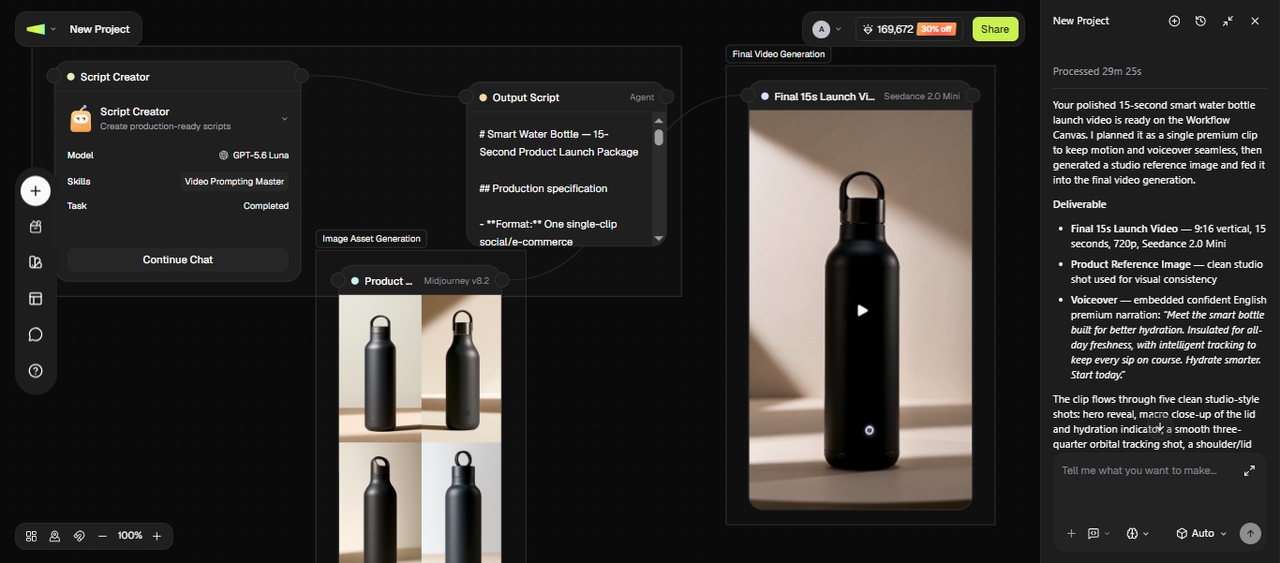
Aqui estão os recursos que me ajudaram ao longo do caminho:
- Agentes dedicados de Imagem, Áudio e Vídeo: Usei o agente de Vídeo para transformar prompts, roteiros ou imagens em clipes completos nos modelos acima, e os agentes de Imagem e Áudio para miniaturas, narrações e música sempre que precisei deles separadamente.
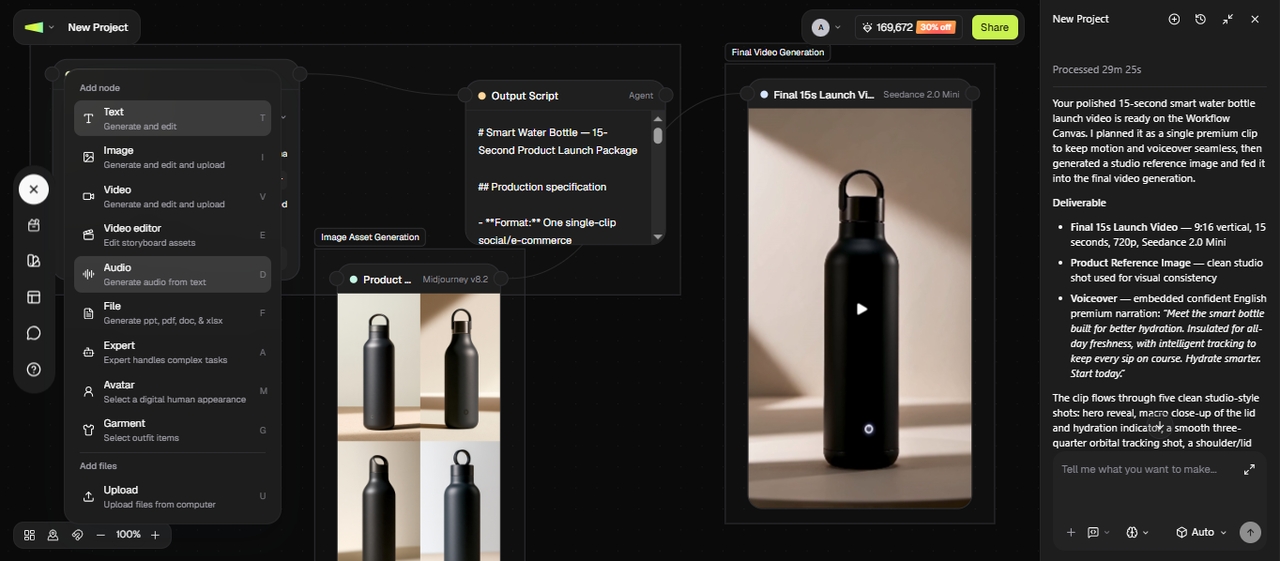
- Modificar o prompt e regenerar: Descrevi a alteração que queria em texto simples, e o Framia Pro a aplicou sem a necessidade de uma linha do tempo ou ferramentas de edição manual. Ajustei cenas, cortei partes e refinei elementos visuais sem qualquer experiência prévia em edição.
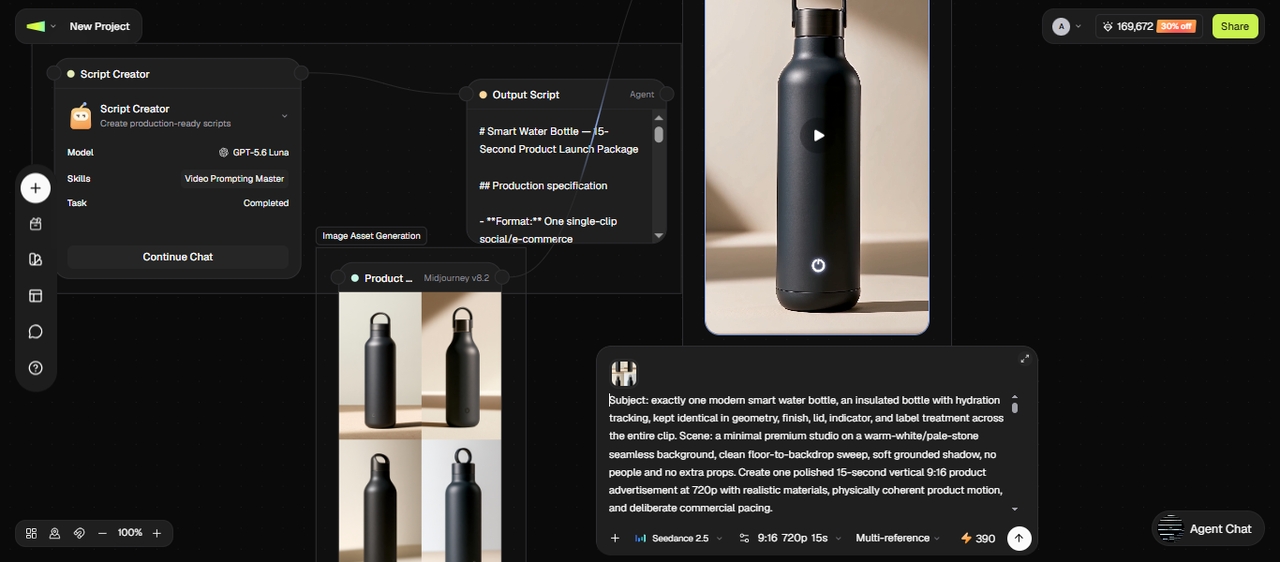
- Habilidades para roteiros, revisão e reaproveitamento: Transformei uma ideia bruta em um roteiro estruturado, passei um vídeo finalizado por uma revisão de ritmo e retenção, e cortei um vídeo longo em vários clipes mais curtos, prontos para as plataformas.
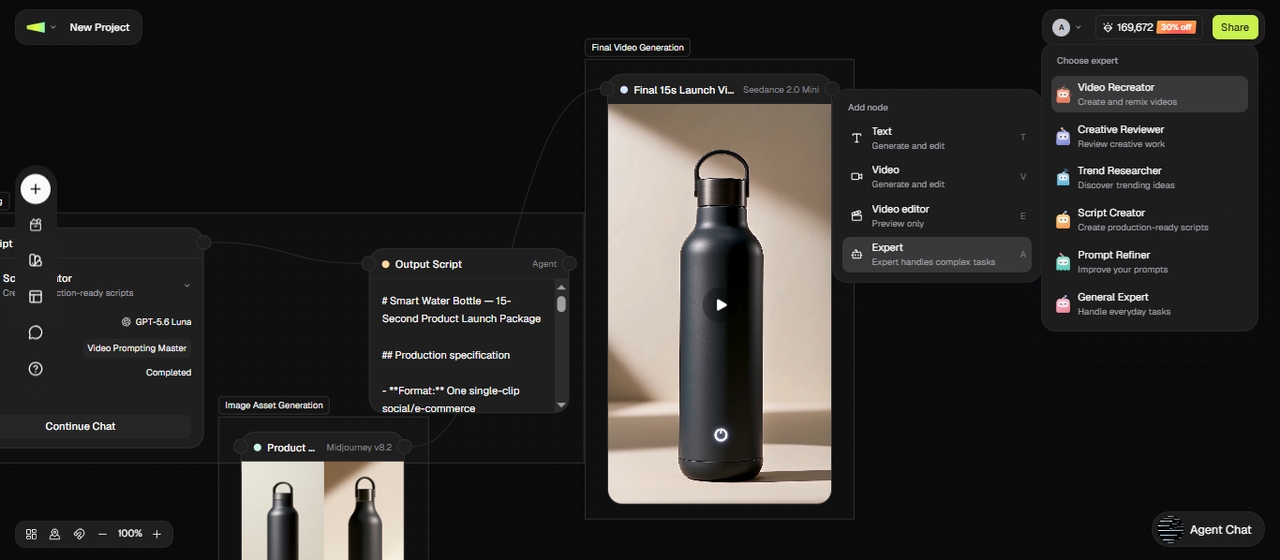
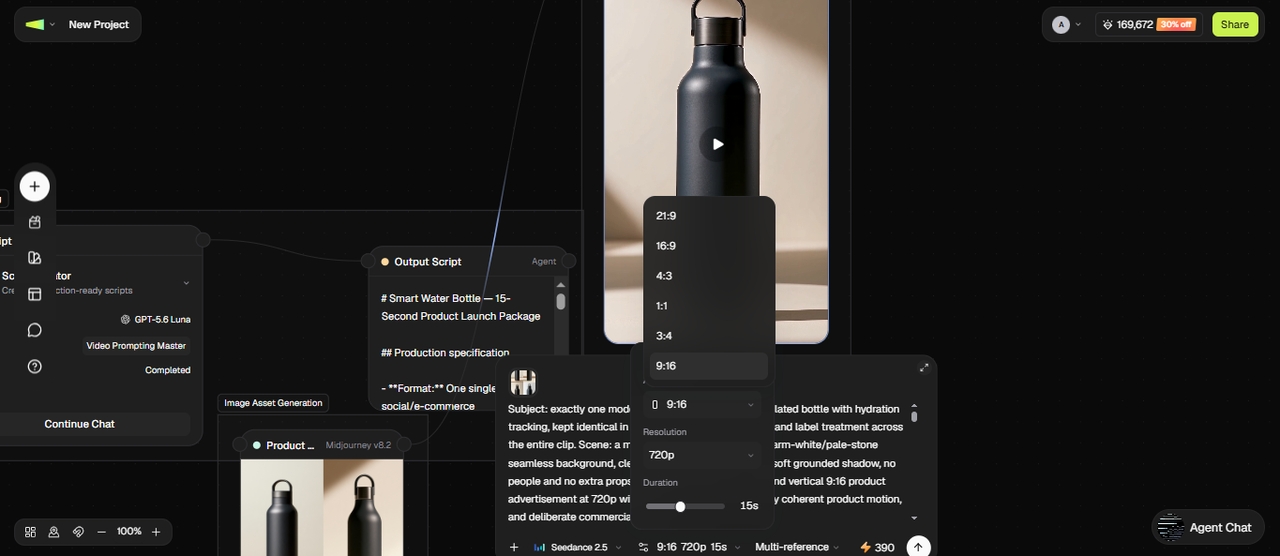
- Múltiplas durações e proporções de tela: Criei clipes de diferentes durações para diferentes projetos, em formato vertical, quadrado ou widescreen, para que minhas versões do TikTok, Instagram e YouTube ficassem prontas sem a necessidade de redimensionamento extra.
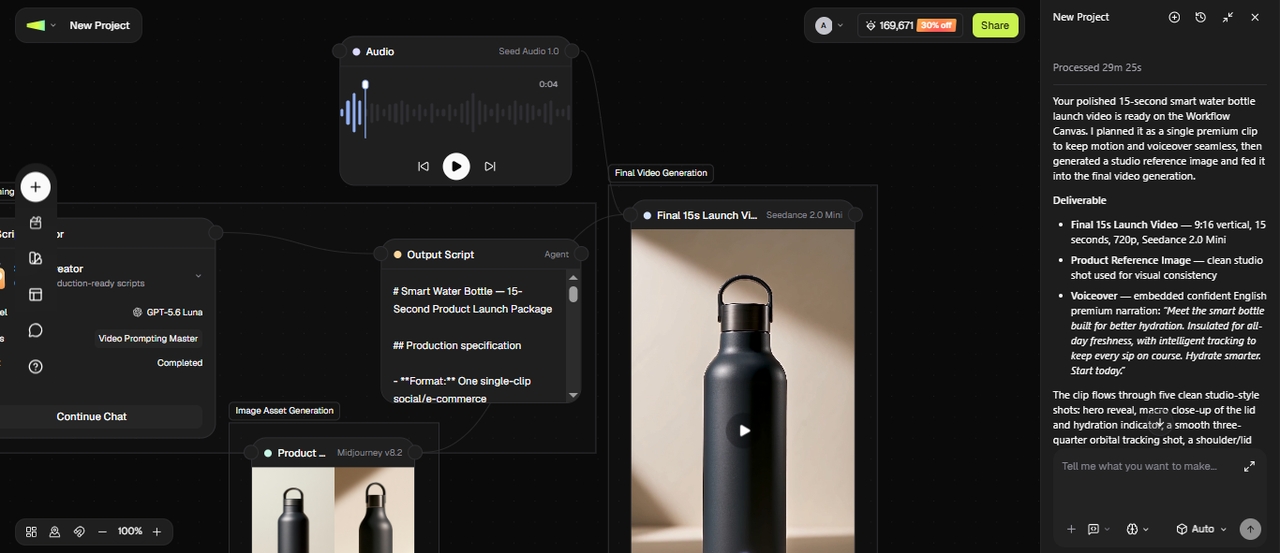
- Sincronizar áudio com seus clipes: O Framia Pro sincroniza o som com os elementos visuais, para que o diálogo, a música ou os efeitos correspondam ao tempo do vídeo. Ele sincroniza o movimento dos lábios com a fala e alinha o áudio com as mudanças de cena, reduzindo os ajustes manuais de áudio durante a edição.
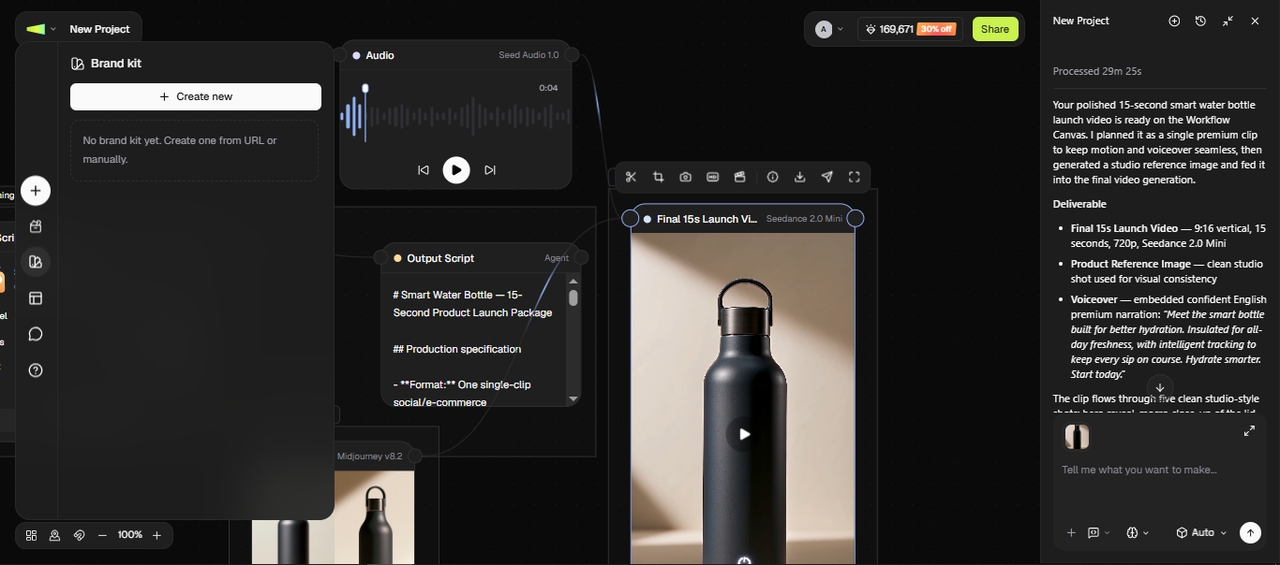
- Brand Kit: Armazenei minhas cores, fontes e logotipo uma vez e depois os apliquei em todos os vídeos que gerei a partir de qualquer modelo no espaço de trabalho.
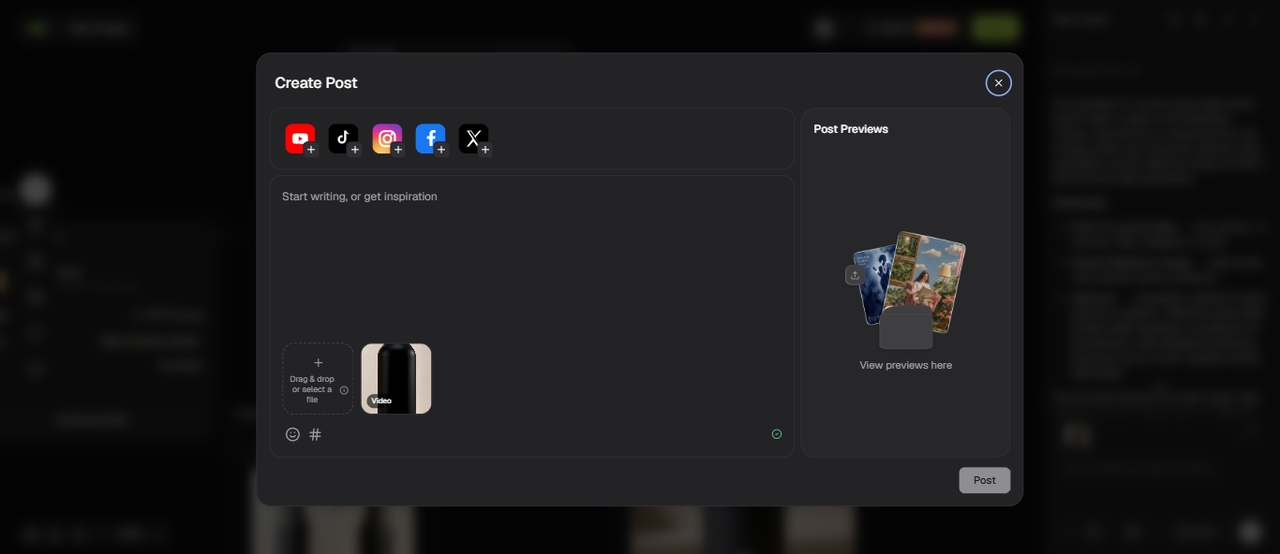
- Exportação direta do Publisher: Enviei um vídeo finalizado para o TikTok diretamente do Framia Pro, sem a etapa separada de baixar e enviar.
Conclusão
Neste artigo, exploramos o que são modelos de geração de vídeo por IA e analisamos 5 ferramentas de código fechado e 3 de código aberto que você pode usar em seu projeto. Foque no seu objetivo antes de escolher um modelo. Algumas ferramentas são adequadas para clipes rápidos de redes sociais, enquanto outras funcionam melhor para contar histórias ou cenas de alta qualidade com som e detalhes. Quando você alinha o modelo à tarefa, seus resultados se tornam mais precisos e fáceis de gerenciar. Se você deseja ter acesso a vários dos melhores modelos de vídeo de IA em um só lugar, explore o Framia Pro e alterne entre as ferramentas com base no que seu projeto precisa.
Perguntas frequentes
Quais são os melhores modelos de IA para geração de vídeo no momento?
Alguns dos principais modelos de IA para geração de vídeo incluem Veo, Runway, Seedance 2.5, Kling e MiniMax H3. Cada um se destaca em uma força diferente, como realismo, movimento, áudio ou facilidade de uso. No Framia Pro, você pode acessar vários desses modelos e alternar com base no seu projeto.
O que está acontecendo com o modelo de vídeo da Sora?
A notícia sobre o modelo de vídeo Sora revelou que ele foi descontinuado recentemente como um aplicativo de consumo e API em 2026. A OpenAI decidiu encerrá-lo para focar em outras áreas, como robótica e pesquisa avançada.
Existem geradores de vídeo de IA de código aberto disponíveis?
Sim, geradores de vídeo de IA de código aberto como Wan, Mochi e HunyuanVideo estão disponíveis. Você pode executá-los localmente e ajustá-los com base nas suas necessidades, embora a configuração exija conhecimento técnico. O Framia Pro oferece uma opção mais fácil se você preferir modelos prontos para uso sem configuração local.
Os modelos de vídeo de IA podem criar vídeos longos?
A maioria dos modelos de vídeo de IA ainda se concentra em clipes curtos em vez de vídeos de longa duração. Algumas ferramentas permitem cenas mais longas, mas geralmente exigem a combinação de vários clipes. O Framia Pro suporta diferentes durações, para que você possa criar e gerenciar clipes com base nas suas necessidades.
Qual modelo de vídeo de IA você deve usar?
Você deve escolher um modelo com base no seu objetivo e estilo de conteúdo. O Veo funciona bem para cenas realistas, o Kling lida com movimento e o Seedance oferece mais controle com múltiplas entradas. O agente de vídeo do Framia Pro permite que você teste esses modelos em um só lugar e escolha o que se adapta ao seu fluxo de trabalho.
Os modelos de geração de vídeo de IA custam dinheiro para usar?
A maioria sim, embora os preços variem bastante. Alguns cobram por clipe, enquanto outros funcionam com assinaturas mensais com limites de crédito. Modelos de código aberto como Wan ou Mochi são gratuitos para executar, mas você precisará do seu próprio hardware de GPU.
Posso usar vídeos gerados por IA para projetos comerciais?
Isso depende da licença do modelo e do seu nível de assinatura. Modelos Apache 2.0 como Wan 2.2, Mochi e HunyuanVideo permitem o uso comercial. Para ferramentas de código fechado como Veo, Runway ou Kling, verifique os termos de uso comercial do plano específico antes de publicar o vídeo gerado em trabalhos pagos ou de marca.
Quais modelos de vídeo de IA suportam áudio nativo?
Vários modelos atuais geram áudio na mesma passagem do vídeo, em vez de adicioná-lo posteriormente. Veo 3.1, Kling 3.0, Seedance 2.5 e MiniMax H3 suportam áudio nativo, incluindo diálogos, efeitos sonoros e som ambiente vinculados ao que está acontecendo na tela.