分享


- AI 视频生成模型通过扩散过程将文本提示词、图像或现有的我存储的颜色、剪辑转化为新的视频片段,该过程逐步细化随机噪声,直到其与您的描述相匹配。
- 目前有五款闭源模型处于领先地位,每款模型都各有优势:Veo 3.1(原生音频)、Runway Gen-4.5(创意控制)、Seedance 2.5(长单镜头剪辑)、Kling 3.0(符合物理规律的运动)以及 MiniMax H3(统一的多模态输入)。
- Wan 2.2、Mochi 和 HunyuanVideo 为您提供更多控制权且无使用限制,但您需要更强大的硬件和一些设置时间。
- Framia Pro 将其中几款模型整合到一个仪表板中,因此您可以轻松切换,而无需在不同的登录账号和订阅之间来回折腾。
什么是 AI 视频生成模型?
AI 视频生成模型是无需相机或摄制组参与,即可根据提示词、图像或现有剪辑构建视频的系统。
它们从庞大的数据集中学习,这些数据集包含数百万个配有描述的视频剪辑,并从中提取视觉模式,将诸如“一只在雪地里奔跑的狗”之类的短语与屏幕上的实际画面联系起来。
其背后的技术被称为扩散(diffusion)。 模型从随机噪声开始,经过数十个步骤进行清理,直到视频出现。在训练过程中,它观察真实视频如何损坏为噪声,并学会了逆转这一过程。在生成时,您的提示词会引导每个清理步骤朝着您描述的场景进行。
难点不在于单张画面。它需要保持数百个画面之间的一致性。 一张脸、一套衣服或一个阴影必须在整个剪辑中保持稳定,而不仅仅是孤立地看起来正确。
视频模型 共同处理整个帧序列,以便每一帧都可以参考其他帧,这就是为什么视频生成比单张图像需要多得多的计算量。
有哪些不同类型的 AI 视频模型?
在开始测试之前,我必须理清我实际使用的是哪种类型的工具,因为并非每个 AI 视频生成器都从同一个起点开始。
文本生成视频 AI 模型
文本生成视频模型 从头开始将书面描述转化为动态场景。您写下您想要的内容,模型就会构建出视觉效果。当您有想法但没有素材或参考图像作为起点时,这最合适,例如产品概念、简短的故事节奏或场景。
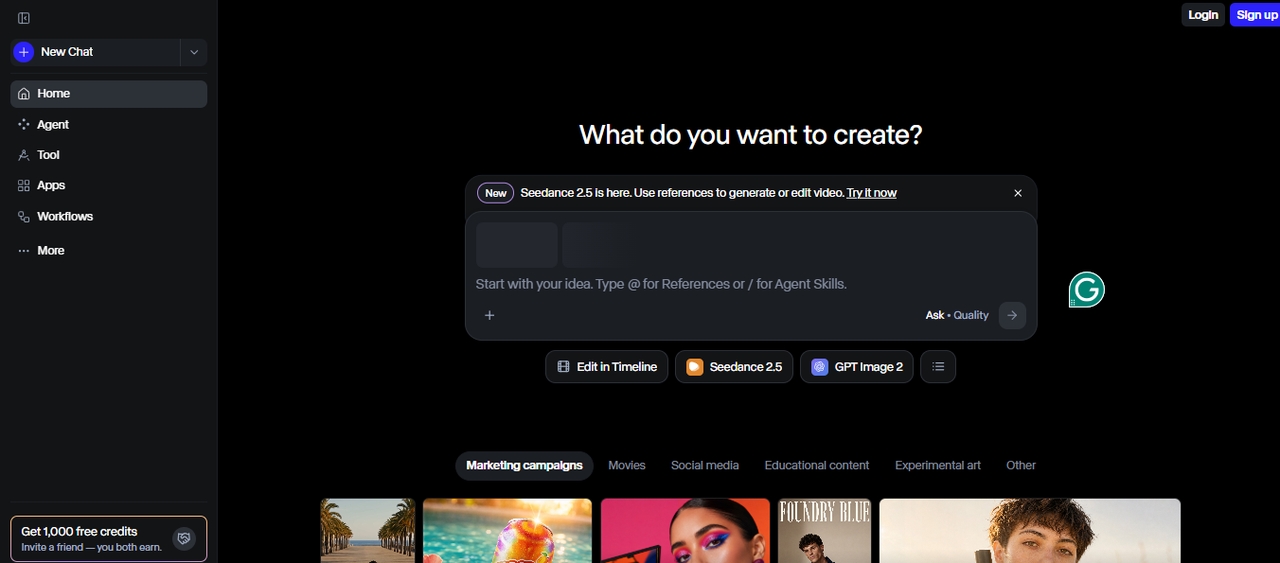
图像生成视频模型
图像生成视频模型 从您已有的图片开始,添加动作、镜头移动或微小的变化来使其栩栩如生。这适用于产品演示和社交帖子,在这些场景中您需要快速的动态,而无需从零开始生成所有内容。
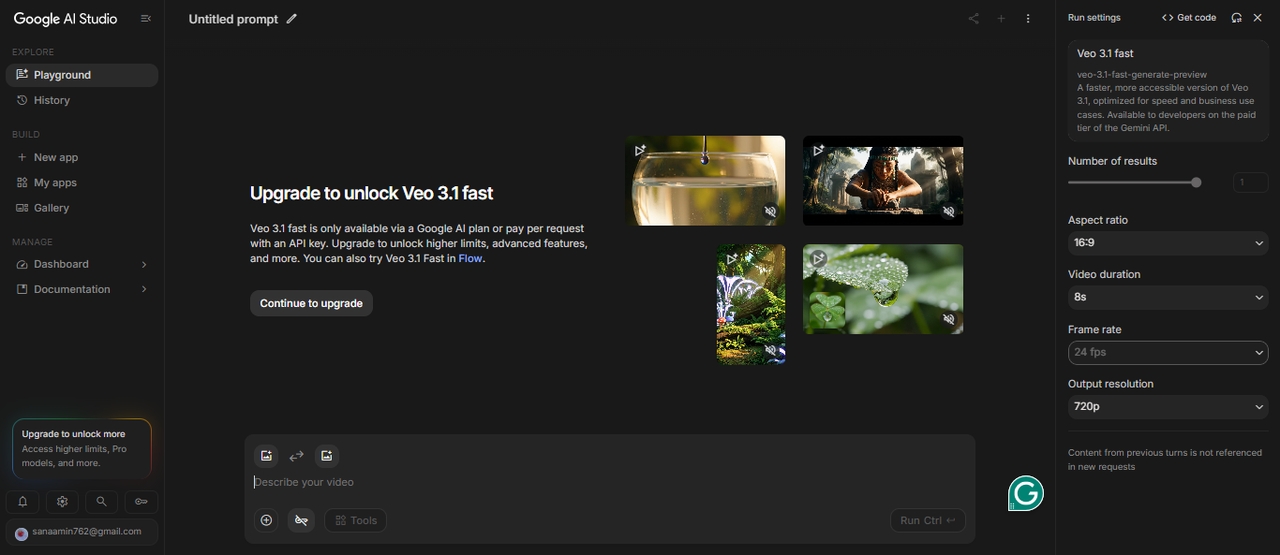
多模态视频模型
这些模型可以同时处理多种类型的输入。您可以混合文本、图像、音频甚至现有的视频剪辑来引导最终结果。
这让您可以更好地控制视频的最终呈现效果。您不仅仅是在描述一个场景,而是在用多种输入来塑造它。当您需要特定的细节、更流畅的叙事或遵循明确方向的视频时,这种控制力会很有帮助。
我们如何测试每款模型
我是一名内容策划师,过去两年一直以测试 AI 创意工具为生。我用相同的五个提示词运行了每款 AI 视频生成模型,这些提示词包括产品演示、简短的叙事场景、口播剪辑、动作序列和风格化的艺术作品。
对于每款模型,我针对每个提示词至少生成了三个输出,并在真实感、运动准确性、提示词遵循度以及适用时的音频质量方面进行了评分。
8 个 AI 视频生成模型,以及它们各自最擅长什么
在对产品演示、叙事场景、真人出镜片段、动作序列和风格化视觉效果等八个 AI 视频生成模型进行测试后,我发现没有哪一个模型在所有类别中都表现最好。Veo 3.1 在原生音频方面脱颖而出,Runway Gen-4.5 在创意控制和场景一致性方面表现优异,而 Seedance 2.5 则擅长更长的单次生成片段。Kling 3.0 是动作密集型场景的强力选择,而 MiniMax H3 则能很好地处理混合输入和同步音频。Wan 2.6、Mochi 和 HunyuanVideo 为更倾向于开源权重模型和本地工作流的用户提供了替代方案,尽管硬件要求和配置可能会成为限制因素。
这些结果基于我的亲手测试,而非通用排名。最佳选择取决于您的视频类型、输出要求、预算,以及您更倾向于托管服务还是可以自行运行的模型。
下面,我将详细分析每个模型的优势、特点、优缺点,以帮助您为自己的项目选择合适的模型。
以下是您目前应该了解的顶尖闭源模型。
| 功能 | Veo 3.1 | Runway Gen-4.5 | Seedance 2.5 | Kling 3.0 | MiniMax H3 |
| 最大分辨率 | 1080p | 1080p | 原生 1080p | 4K / 60fps,首个达到原生 4K 60fps 的模型 | 24fps 下为 2K,也提供 768p |
| 最大片段长度 | 原生 8 秒,可通过第三方工具扩展 | Gen-4 上最长可达 16 秒 | 单次连续镜头最长可达 30 秒 | 最长可达 2 分钟,可扩展至 3 分钟 | 5–15 秒,使用内置的 Extend 工具可扩展至 30 秒 |
| 帧率 | 24–30fps | 24fps | 尚未公布 | 30fps | 24fps |
| 原生音频 | ✅ 对话、音效、环境音 | ✅ 2025 年 12 月新增 | ✅ 10 多种语言 | ✅ | ✅ 原生立体声 |
| 多模态输入 | ✅ 最多 3 张参考图 | ❌ | ✅ 最多 50 个参考,30 张图片,10 个视频,10 个音频 | ✅ 文本、图片、音频、视频 | ✅ 文本、图片、视频和音频作为统一上下文读取 |
| 多镜头 | ❌ | ✅ | ✅ 单次连续镜头,无需拼接 | ✅ 最多 6 个镜头 | ❌ |
| 物理引擎 | ✅ | ❌ | 未说明 | ✅ | 未说明 |
| 快速 / 草稿模式 | ✅ Veo 3 Fast | ✅ Gen-4 Turbo | 尚未公布 | ✅ 最快可达 20 倍 | ✅ 768p 轻量级选项 |
| 宽高比 | 16:9 和 9:16 | 16:9、9:16、1:1 | 尚未公布 | 16:9、9:16、1:1 | 21:9、16:9、4:3、1:1、3:4、9:16 |
| 免费层级 | ❌ | ❌ | 正在即梦 AI、豆包、Dreamina 逐步推出 | ✅ 每日 66 积分 | 通过海螺 AI 应用 |
| 最适合 | 写实度 + 音频 | 电影级控制 | 长单镜头片段 + 参考 | 4K + 长视频 | 多模态编辑 + 一致性 |
- Veo 3.1
Veo 3.1 是 Google 的旗舰视频生成模型,而音频是它在我的测试中脱颖而出的地方。它可以在生成视频的同时,仅凭一个提示词就生成对话、音效和环境音。自 2025 年 10 月推出以来,它成为了社交平台上掀起病毒式传播热潮的幕后引擎,并且它与 Google Workspace 的结合,使其能够轻松融入我已在该生态系统中运行的工作流。
特点
- 原生音频: 一次性生成对话、音效和环境音。
- 4K 分辨率:最高可达超高清输出。
- 多参考: 支持最多 3 张参考图。
- 长时长: 生成最长达一整分钟的输出。
- 提示词对话: 直接在提示词中编写角色台词。
优点
- 无可比拟的原生音频质量。
- 极佳的写实度和光影准确性。
- 与 Google 生态系统的深度集成。
- 强大的提示词准确度。
缺点
- 较低档方案生成的视频带有水印。
- 对于风格化或非写实内容的灵活性较差。
- Runway Gen-4.5
Runway 多年来一直是 生成式 AI 视频模型 领域的常客,而在 2025 年底发布的 Gen-4.5 中,我注意到其质量和多镜头序列化有了最大的飞跃。它的对话界面允许我通过在对话中描述修改来微调视频,而无需从头重写提示词。在所有测试的模型中,当跨多个镜头的场景和角色一致性至关重要时,我会向创意专业人士推荐这款模型。
功能
- 运动画笔: 精确绘制场景中应该移动的部分。
- 多镜头:将多个片段串联成一个连贯的序列。
- Act-one: 面部表情和动作捕捉。
- 对话式编辑:通过自然对话微调输出。
- 4K 输出:超高分辨率导出。
优点
- 同类最佳的场景和角色一致性。
- 为专业人士提供强大的创意控制。
- 强大的社区和生态系统。
缺点
- 高级别订阅价格昂贵。
- 在制作快速社交内容方面比一些竞争对手慢。
- 初学者的学习曲线较陡峭。
- Seedance 2.5
Seedance 2.5 是 ByteDance 对 Seedance 2.0 的后续升级,后者在 2026 年早些时候曾登顶 Artificial Analysis Video Arena 的文本生成视频和图像生成视频榜单。新版本将单次生成时长从 15 秒延长至整整 30 秒,提升至原生 1080p,并在单次生成中支持多达 50 个多模态参考(图像、视频和音频的组合),而之前的版本仅支持 12 个。它还增加了 10 多种语言的原生音频。我在它于 Jimeng AI、Doubao 和 Dreamina 推广部署期间对其进行了测试,其 API 访问是通过 BytePlus ModelArk 提供的。
功能
- 延长的单次生成:在单个连续片段中长达 30 秒,无需拼接。
- 原生 1080p:较上一版本的 720p 有所提升。
- 扩展的参考支持: 单次生成中支持多达 50 个多模态参考(30 张图像、10 个视频、10 个音频)。
- 原生多语言音频:支持 10 多种语言的对话和声音。
- 精准编辑:更换产品、延长镜头或进行针对性编辑,而无需重新生成整个片段。
- 3D 白模预可视化:在进行完整生成之前,先规划好相机移动和镜头。
优势
- 长单镜头片段非常适合短剧和系列化内容。
- 在整个30秒的镜头中,镜头与镜头之间的摄像机连续性极强。
- 增加的参考数量使角色和产品的一致性控制力更强。
劣势
- ByteDance 尚未发布完整的技术报告,因此某些规格来自发布演示,而非独立测试。
- 测试时,完整的 API 访问权限尚未在所有地方上线。
- Kling 3.0
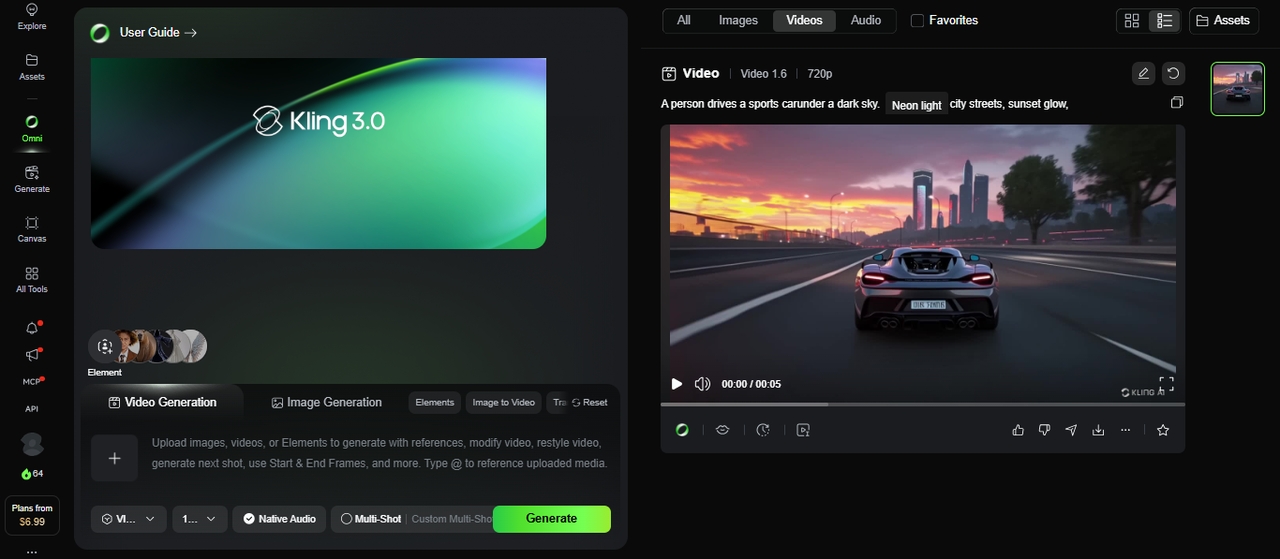
Kling 3.0 于 2026 年 2 月 4 日发布,几天内就被称为今年 AI 视频生成领域最大的飞跃。它运行在 Omni One 架构上,该架构将 3D 时空联合注意力与思维链推理相结合,这就是它在我的测试中能让重力、平衡、变形和惯性看起来真实而非橡胶般虚假的原因。它支持跨文本、图像、音频和视频的多模态输入,并生成英语、中文、日语、韩语和西班牙语的原生音频,同时支持对角色对话和发言顺序的控制。
功能特点
- Omni one 物理:真实的重力、碰撞和惯性模拟。
- 原生音频: 配音、对口型、SFX 和音乐。
- 多镜头分镜: 最多支持 6 个镜头,具备导演级的摄像机控制。
- 草稿模式: 生成速度提升高达 20 倍,用于快速原型制作。
- 4K/60fps 输出: 支持 16 位 HDR 和 EXR 导出。
- 七合一编辑器: 在一个工具中实现对象添加、背景更换和风格迁移。
优势
- 目前最真实的人体物理和动作模拟。
- 支持方言和口音控制的原生多语言音频。
- 起步价亲民,每月 7.99 美元,并提供实用的免费档位。
- 直接导出到专业的 VFX 工作流(Nuke、After Effects、DaVinci)。
劣势
- 渲染一段 15 秒的多镜头视频可能需要 5 分钟以上。
- 4K 输出目前仅限于更高档位的计划。
- 高需求时期会延长渲染队列。
- MiniMax H3
MiniMax H3,也称为 Hailuo 3.0,是 MiniMax 视频产品线中继 Hailuo 02 之后的型号。它没有将文本、图像、视频和音频参考视为单独的输入,而是将它们作为一个共享上下文一起读取,然后在单个结果中返回同步的视频和音频。MiniMax 表示计划发布模型权重,不过我是通过 Hailuo AI 应用、MiniMax 开放平台 API 以及像 fal 这样的托管合作伙伴访问它的。
特性
- 统一的多模态上下文:文本、图像、视频和音频参考在一次生成中共同解析。
- 原生立体声音频:对话、音乐、音效和环境音与视频同步生成,而不是事后叠加。
- 支持高达 2K 分辨率、24fps,同时还提供 768p 作为更轻量级的选项。
- 生成 5 到 15 秒的视频,使用内置的 Extend Video 工具可延长至 30 秒。
- 定向编辑:更换或移除角色和物体,改变光照或背景,或修改对话,而无需重新制作整个片段。
- 多种宽高比:21:9、16:9、4:3、1:1、3:4 和 9:16。
优点
- 强大的时间一致性;动作在整个片段中保持稳定,而不是在中途漂移。
- 原生立体声音频在同一次生成中输出,无需单独的配音步骤。
- 广泛的宽高比支持,适用于从电影宽屏到垂直社交内容的各种场景。
缺点
- MiniMax 尚未发布完整的技术报告,因此某些说法来自该公司,而非独立的基准测试。
- 一旦权重发布,在本地运行开源权重版本将需要配备 24GB+ 显存的高端 GPU。
| 特性 | Wan 2.2 | Mochi 1 (Genmo) | HunyuanVideo (Tencent) |
| 参数 | 1.3B / 14B | 10B | 13B |
| 最大分辨率 | 720p (14B 上为 1080p) | 480p (640x480) | 720p (v1.5 为 1080p) |
| 最大片段长度 | 长达 10 秒 | 在 30fps 下长达 5.4 秒 | 长达 5 秒 (720p) |
| 帧率 | 16fps | 30fps | 24fps |
| 最低显存 | 8GB (1.3B 模型) | 全精度下 20GB+ | 14GB (v1.5) / 60–80GB (原始) |
| 生成速度 | 4-5 秒片段需 1-2 分钟 (8GB GPU) | 5.4 秒片段需 3-4 分钟 | 5 秒片段需 6-10 分钟 (16GB GPU) |
| 文本生成视频 | ✅ | ✅ | ✅ |
| 图像生成视频 | ✅ | ❌ | ✅ |
| LoRA 微调 | ✅ | ✅ | ✅ (需要高算力) |
| ComfyUI 支持 | ✅ | ✅ | ✅ |
| Diffusers 支持 | ✅ | ❌ | ✅ |
| 双语提示词 | ✅ 英文 + 中文 | ❌ | ❌ |
| 许可证 | Apache 2.0 | Apache 2.0 | Tencent Community License |
| 消费级 GPU 友好 | ✅ 同类最佳 | ❌ | ⚠️ 仅限 v1.5 |
| 最适合 | 多功能性 + 易用性 | 照片级写实 + 微调 | 电影级画质 + 人脸 |
- Wan 2.6
Wan 2.6 是 Alibaba 的视频生成模型系列,于 2025 年 12 月发布。它支持文本生成视频、图像生成视频和参考视频生成。其主要优势包括多镜头叙事、改进的提示词遵循能力以及与视觉画面保持同步的音频。参考视频模型还可以使用参考片段,在全新生成的场景中保留人物或物体的外观和声音。
对于想要尝试 AI 生成场景、产品视频或对话驱动片段的创作者来说,Wan 2.6 仍然是一个选择。
特性
- MoE 架构: 针对不同噪声阶段的专业专家。
- 混合 T2V/I2V: 在一个统一模型中输入文本和图像。
- GGUF 量化:可在具有 4GB 显存的消费级 GPU 上运行。
- 电影级控制: 光照、对比度和色调标签。
- 双语支持: 英文和中文提示词处理。
- 托管访问:通过 Alibaba Cloud Model Studio 使用支持的 Wan 模型
优点
- 在同一个模型家族中支持多种视频生成工作流。
- 多镜头控制适用于短篇故事、广告和产品展示。
- 参考视频(Reference-to-video)有助于在生成的场景中保持角色一致性。
- 在支持的变体中提供同步音频和对话功能。
缺点
- 视频片段较短,因此较长的项目可能需要多次生成和编辑。
- 托管访问可能会产生 API 费用或受到特定服务的限制。
- Mochi (Genmo)
Mochi 1 是一个基于新型 AsymmDiT 架构构建的 100 亿参数模型,在 Apache 2.0 许可下发布。在我的测试中,它在写实的 30fps 运动画面上表现最强,这使其非常适合纪录片风格的镜头、自然环境以及需要表现得真实的人体运动。它是首批让我开始认真对待本地视频生成的开源模型之一。
功能特性
- AsymmDiT 骨干网络:专为视频合成构建的架构。
- 30fps 输出: 原生帧率下的平滑运动。
- LoRA 微调:在您自己的视频数据集上进行自定义。
- Apache 2.0 许可证: 开放用于研究和商业用途。
- ComfyUI 集成:支持基于节点的工作流。
- T5-XXL 编码: 强大的文本理解和提示词遵循能力。
优点
- 在所有高质量开源模型中拥有最宽松的许可。
- 出色的写实动态和自然运动。
- 强大的社区,活跃的微调分享。
缺点
- 分辨率上限为 480p;高清输出需要进行超分辨率放大。
- 全精度下需要 20GB+ 显存。
- HunyuanVideo (Tencent)
HunyuanVideo 是 Tencent 的旗舰开源视频模型,专为高质量生成而构建,与我尝试过的大多数开源替代方案相比,它具有更强的运动一致性和更干净的场景结构。其基于 transformer 的架构可以同时处理视觉和时间数据,每当我想比托管工具提供更多对生成过程的控制时,我都会倾向于使用它。
特点
- 开源类别中最大的 1B 规模。
- 双流融合:在合并前分别处理文本和视频。
- xDiT 并行:多 GPU 序列并行,实现更快的推理。
- FP8 量化:减少内存占用,且无重大质量损失。
- Diffusers + comfyUI:即插即用的生态系统集成。
- Causal 3D VAE:时空压缩以实现连贯的运动。
优点
- 开源中最佳的电影级质量和面部逼真度。
- 庞大的 LoRA 生态系统,用于风格和角色定制。
- 强大的多人和复杂场景处理能力。
缺点
- 根据设置的不同,一段 5 秒的视频片段可能需要超过 15 分钟。
- 设置复杂度极高;不适合初学者。
在 Framia Pro 上探索顶尖的 AI 视频模型
这是我遇到的实际问题:我不想为了 Veo 注册 Google 账号,为了 Gen-4.5 订阅 Runway,为了 Kling 登录 Kuaishou,然后在每次推出新模型时都重复这种设置。这就是我将大部分测试转移到 Framia Pro 上的原因。
Framia Pro 将 Veo 3.1、Kling 3.0、Seedance 2.5 以及其他顶尖的视频和图像模型整合到一个工作区中。我可以从一个想法开始,使用文本、图像、音频或这三者的结合将其转化为视频,而无需切换标签页或为每个模型支付单独的账户费用。内置的创意智能体也涵盖了特定的使用场景,例如 音乐视频、广告和故事创作,因此无论我制作什么,都有一个起点。
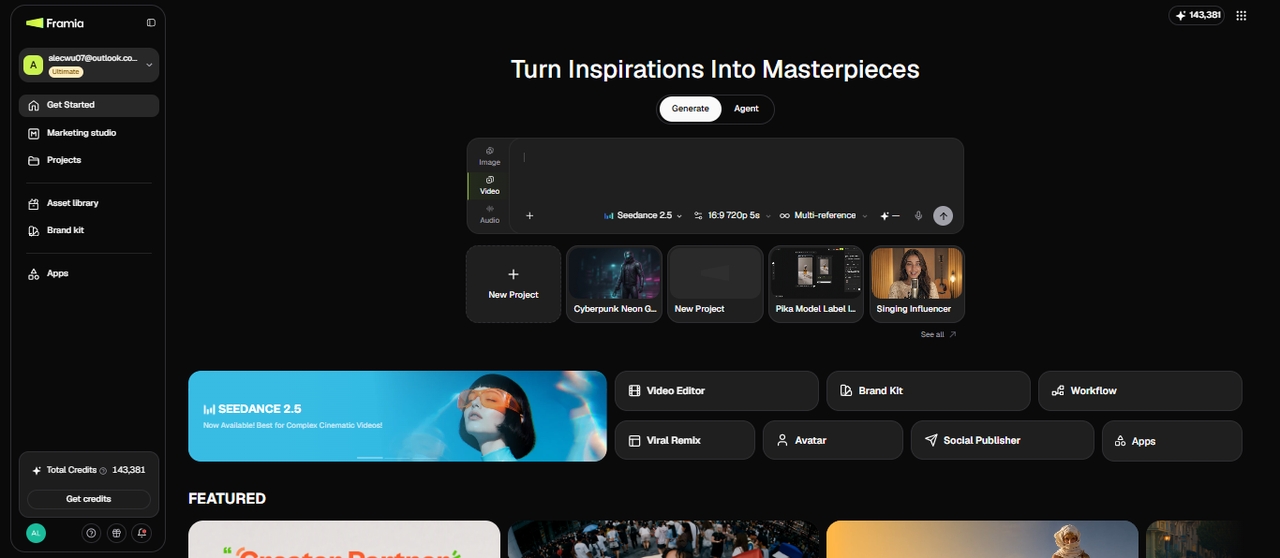
Framia Pro 带来了什么?
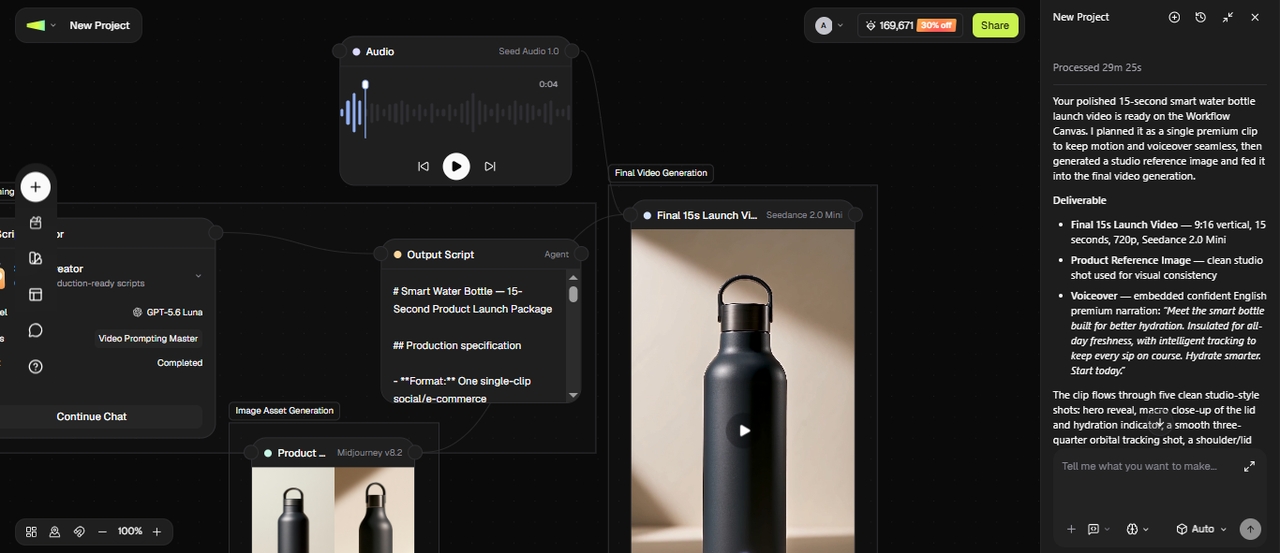
我尝试在画布上构建一个电子商务产品发布视频。我首先使用 Image 智能体生成干净的产品镜头,然后将这些镜头输入到 Video 节点中,使用 Kling 或 Seedance 将其转换为演示剪辑,接着将结果路由到 Audio 节点以生成匹配的配音,所有这些操作都在一个画布内完成,而不是使用四个独立的工具。
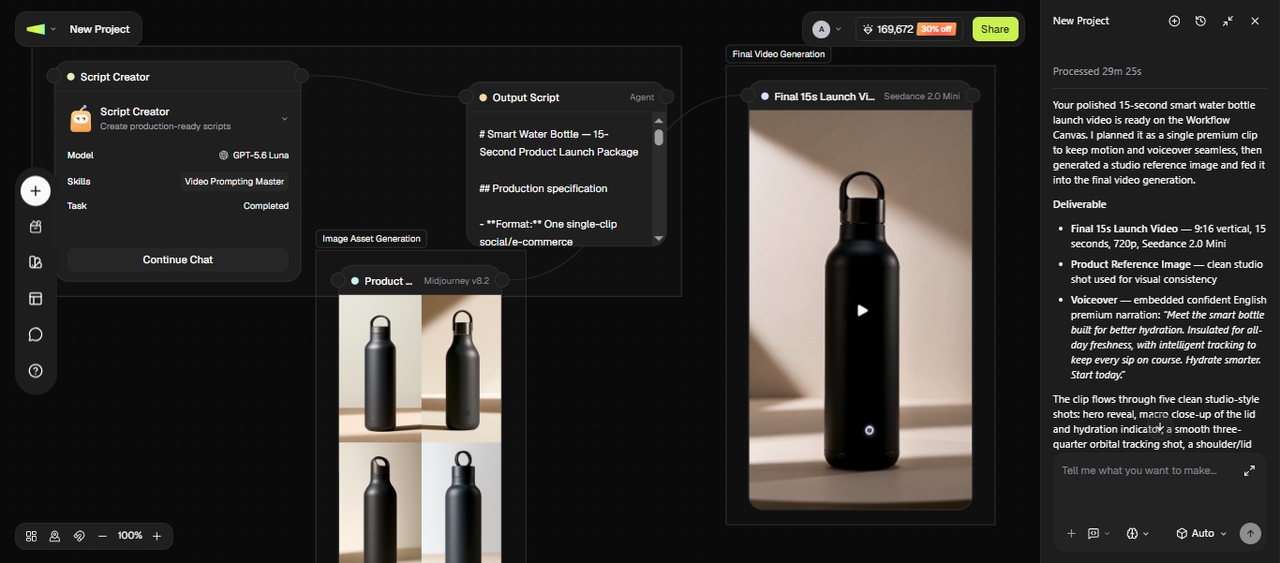
以下是在此过程中为我提供帮助的功能:
- 专用的 Image、Audio 和 Video 智能体: 我使用 Video 智能体将提示词、脚本或图像转换为上述各个模型中的完整剪辑,并在需要时分别使用 Image 和 Audio 智能体来制作缩略图、配音和音乐。
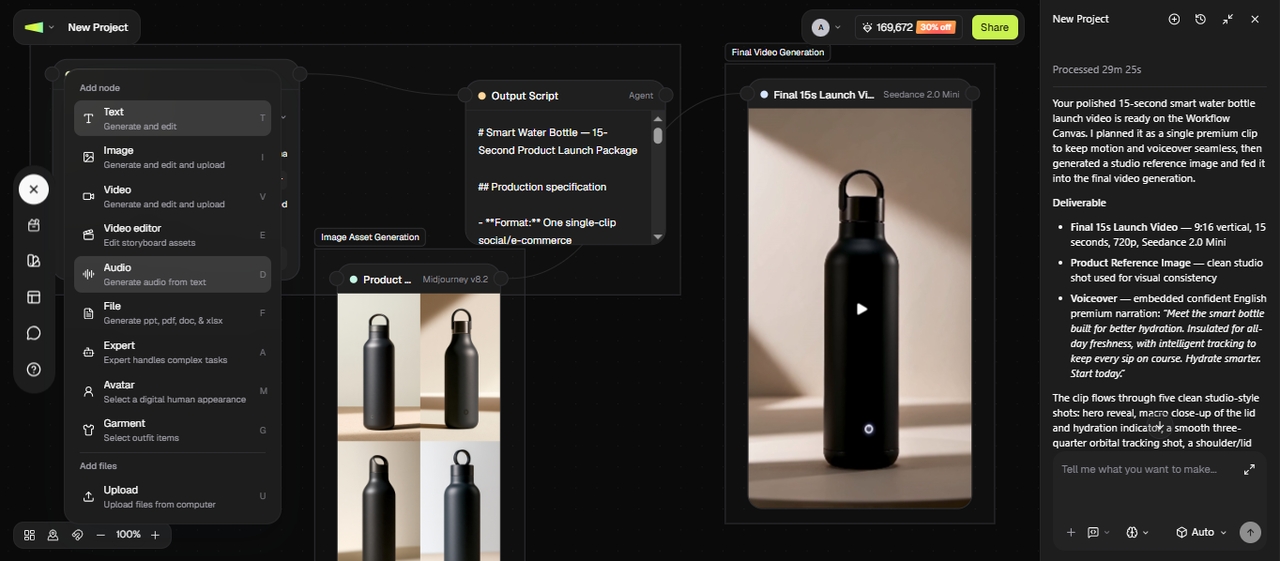
- 修改提示词并重新生成: 我用纯文本描述了我想要的修改,Framia Pro 就会应用它,无需时间线或手动编辑工具。我调整了场景、剪切了部分内容并优化了视觉效果,而无需任何先前的编辑经验。
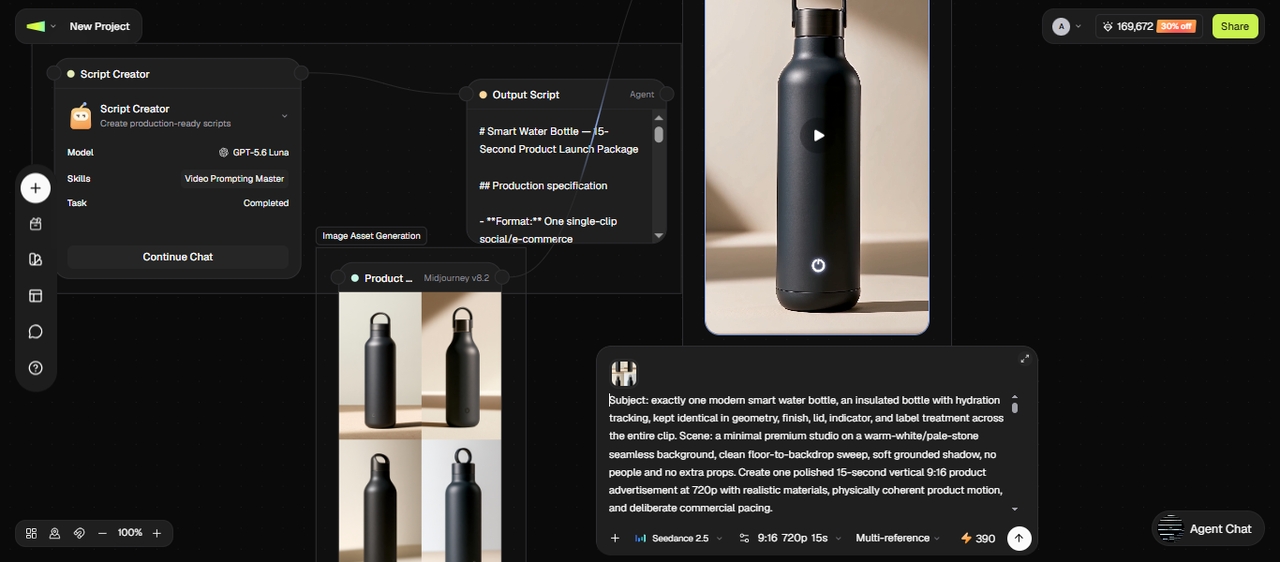
- 用于脚本、审核和二次创作的技能: 我将一个粗略的想法转化为结构化的脚本,对制作完成的视频进行节奏和留存率审核,并将一个长视频剪辑成几个适合不同平台的短视频。
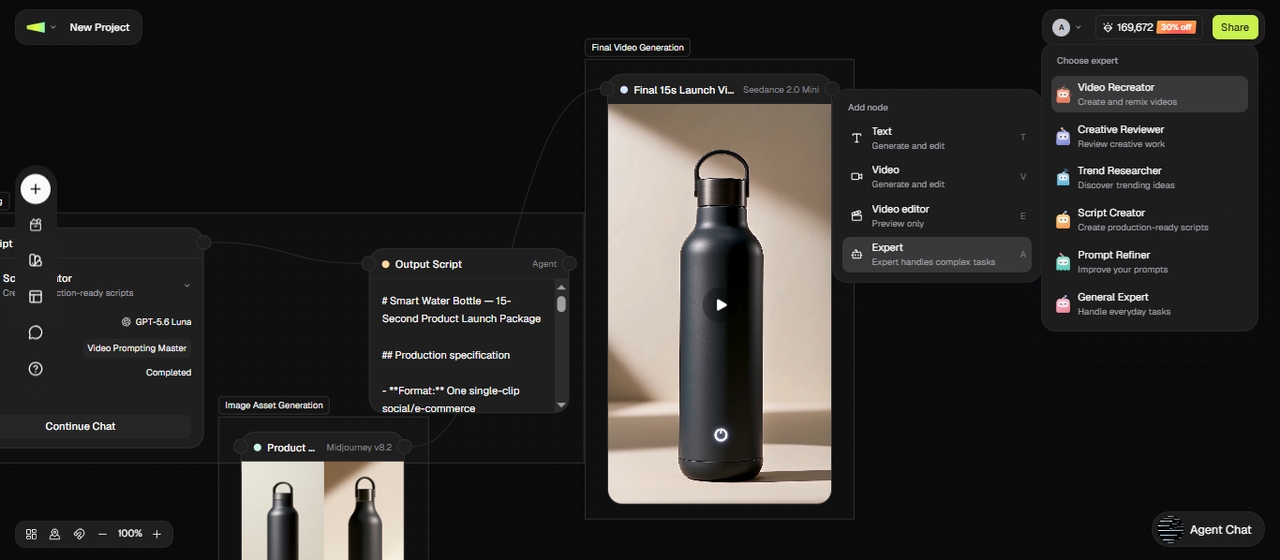
- 多种时长和宽高比:我为不同的项目创建了不同长度的剪辑,包括竖屏、正方形或宽屏,因此我的 TikTok、Instagram 和 YouTube 版本无需额外调整大小即可准备就绪。
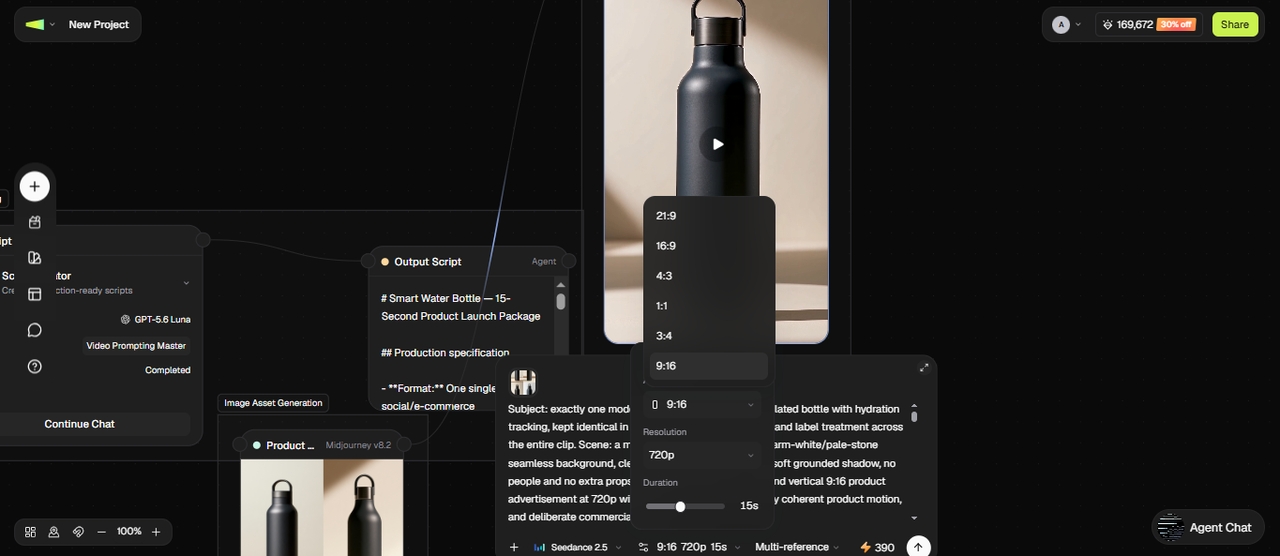
- 将音频与您的剪辑同步: Framia Pro 将声音与视觉效果同步,从而使对话、音乐或音效与视频的时间点相匹配。它可以将口型变化与语音相匹配,并将音频与场景转换对齐,从而减少了编辑过程中的手动音频调整。
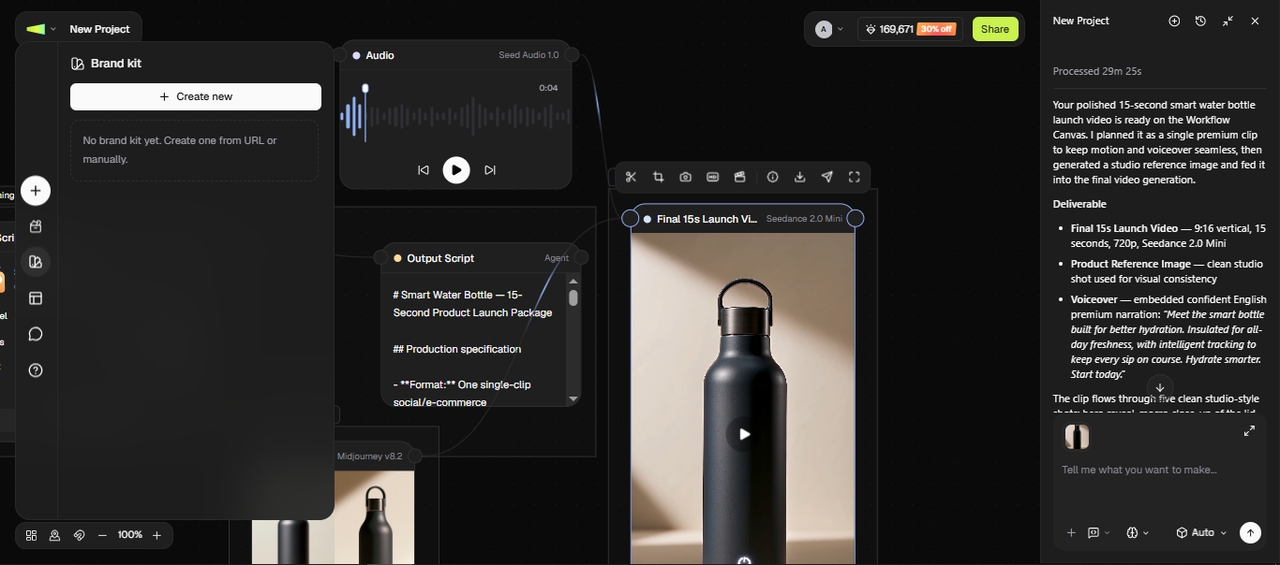
- 品牌套件: 我只需存储一次我的颜色、字体和徽标,然后就可以将它们应用到我在工作区中从任何模型生成的每个视频中。
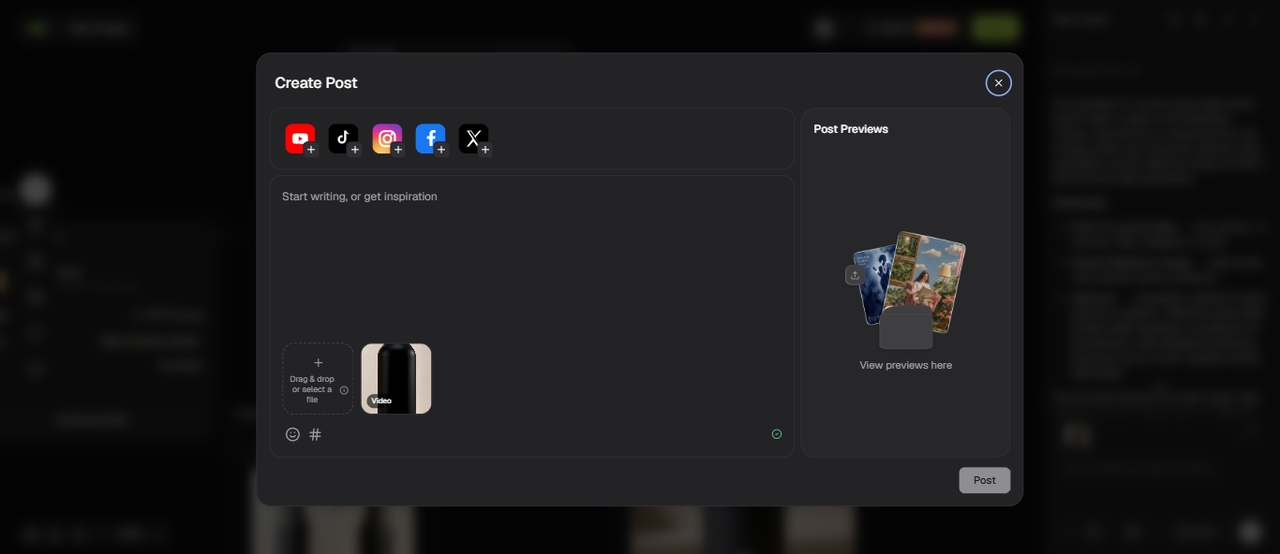
- 从发布器直接导出: 我直接从 Framia Pro 将制作完成的视频发送到 TikTok,无需单独的下载和上传步骤。
结论
在这篇文章中,我们探讨了什么是AI 视频生成模型,并回顾了 5 个闭源和 3 个开源工具,您可以将它们用于您的项目。在选择模型之前,请先专注于您的目标。有些工具适合快速制作社交媒体剪辑,而另一些工具则更适合叙事或具有声音和细节的高质量场景。当您将模型与任务相匹配时,您的结果会更准确且更容易管理。如果您想在一个地方访问多个顶尖的AI 视频模型,请探索 Framia Pro 并根据您的项目需求在工具之间进行切换。
常见问题解答
目前最好的用于视频生成的 AI 模型有哪些?
一些顶尖的用于视频生成的 AI 模型 包括 Veo、Runway、Seedance 2。5、Kling 和 MiniMax H3。每一个模型都有不同的侧重点,例如逼真度、动作、音频或易用性。在 Framia Pro 上,您可以访问其中几个模型,并根据您的项目进行切换。
Sora 的视频模型目前进展如何?
关于 Sora 视频模型的新闻 透露,该模型已于 2026 年作为消费级应用和 API 被停用。OpenAI 决定关闭它,以便专注于机器人技术和先进研究等其他领域。
是否有开源的 AI 视频生成器可用?
是的,有 Wan、Mochi 和 HunyuanVideo 等开源 AI 视频生成器可用。您可以本地运行它们并根据需要进行调整,不过配置需要一定的技术知识。如果您更喜欢无需本地配置、即开即用的模型,Framia Pro 提供了一个更简单的选择。
AI 视频模型可以创建长视频吗?
大多数 AI 视频模型仍然专注于短视频片段,而不是完整长度的视频。一些工具允许更长的场景,但它们通常需要合并多个片段。Framia Pro 支持不同的时长,因此您可以根据需要创建和管理片段。
您应该使用哪种 AI 视频模型?
您应该根据自己的目标和内容风格来选择模型。Veo 适用于写实场景,Kling 擅长处理动作,而 Seedance 通过多输入提供更多控制。Framia Pro 的 视频智能体 让您可以在一个地方测试这些模型,并选择适合您工作流程的模型。
使用 AI 视频生成模型需要付费吗?
大多数都需要,不过价格差异很大。有些按片段收费,而有些则采用有额度限制的月度订阅制。像 Wan 或 Mochi 这样的开源模型可以免费运行,但您需要自己的 GPU 硬件。
我可以将 AI 生成的视频用于商业项目吗?
这取决于模型的许可协议和您的订阅级别。像 Wan 2.2、Mochi 和 HunyuanVideo 这样采用 Apache 2.0 协议的模型允许商业用途。对于像 Veo、Runway 或 Kling 这样的闭源工具,在将生成的视频发布到付费或品牌作品中之前,请检查具体方案的商业使用条款。
哪些 AI 视频模型支持原生音频?
目前有几款模型可以在生成视频的同时生成音频,而不是事后添加。Veo 3.1、Kling 3.0、Seedance 2.5 和 MiniMax H3 都支持原生音频,包括与屏幕上发生的内容相关联的对话、音效和环境音。