分享


核心要点
- 开源图像生成模型可以提供一种无需定期订阅或单独模型许可费用即可创建和编辑图像的方法。
- Hugging Face 托管了近 109,255 个 文本到图像模型,因此创作者在风格、速度和硬件需求方面拥有广泛的选择。
- Stable Diffusion 3.5、FLUX 和 Qwen-Image-2512 在通用创意工作、提示词准确性和商业许可方面处于领先地位。
- ControlNet 1.1 和 Waifu Diffusion 涵盖了专业需求,例如结构控制和动漫风格艺术。
- Z-Image-Turbo 和 GLM-Image 在速度和多文本图像生成(如海报和信息图表)方面脱颖而出。
- Framia Pro 将 Nano Banana Pro、Midjourney v7 和 Seedream 4.5 等闭源模型整合到一个工作区中,适合那些希望获得结果而无需管理本地设置的创作者。
开源图像生成模型为创作者、开发人员和企业开辟了一个全新的世界。您现在可以将文本转换为图像、编辑照片、制作视频并创建 3D 对象,而无需在软件上花费巨资。该领域发展迅速,仅在 文本到图像模型 上就有近 109,255 个可用。Hugging Face。走向开源意味着无需订阅、完全控制您的数据,并可根据需要自由调整。本指南涵盖了目前最好的模型以及您开始使用所需的一切。
什么是 开源图像生成模型?
开源图像生成模型是根据书面描述创建图像的软件程序。您输入想要看到的内容,例如山上的落日、产品模型、卡通人物,模型就会将其生成为图像。
这就像雇佣了一位一生研究过数百万幅画作、照片和插图的艺术家。您描述您想要什么,他们就会在几秒钟内为您画出来。只不过这位艺术家从不睡觉,从不按项目收费,而且就住在您自己的电脑里。
使它们成为“开源”的原因是代码是公开可用的。任何人都可以免费下载、使用、修改或在其基础上进行构建。这与 Midjourney 或 Adobe Firefly 等付费工具不同,在这些工具中,您需要付费才能访问软件,并且无法控制其底层的运行方式。
这些模型是在数百万张图像上进行训练的,这教会了它们理解文字与视觉效果之间的关系。随着时间的推移,它们已经变得足够优秀,可以产生专业品质的结果,而最好的模型现在可以与昂贵的商业选择相媲美。
为什么选择开源而不是闭源 图像模型
付费 图像模型虽然方便,但它们有很大的局限性。您需要按图像付费,将数据交给第三方服务器,并且对软件的运行方式没有发言权。开源模型解决了所有这些问题。这就是为什么越来越多的创作者和开发人员正在做出转变。
- 完全控制输出
使用闭源工具,平台决定了您可以生成什么,不能生成什么。开源模型在您自己的设置上运行,因此由您来制定规则。您可以完全得到您所要求的内容,而不会受到内容过滤器或平台限制的阻碍。
- 微调模型的能力
闭源模型是锁定的,无法更改以满足您的特定需求。但是,您可以根据自己的图像、风格或品牌指南进一步训练开源模型。这意味着输出开始看起来和感觉起来像您自己的,而不是像其他使用相同工具的人那样。
- 无单张图像成本
大多数商业工具都会为您生成的每张图像收费,这很快就会累积起来。但是使用开源模型,您可以在自己的硬件上运行一切,并根据需要生成任意数量的图像。唯一的成本是电费和运行机器的费用。
- 隐私和离线使用
当您使用基于云的工具时,您的提示词和图像会通过其他人的服务器。开源模型可以完全离线运行,因此没有任何内容会离开您的机器。这对于处理敏感项目或专有内容的企业来说非常重要。
- 庞大的社区支持
开源模型得到了全球数千名开发人员、研究人员和创作者的支持。他们每天都会分享微调版本、教程、插件和修复程序。如果您遇到问题,社区中很可能已经有人解决了。
我如何测试并挑选这些模型
我从事创意 AI 工具的工作,我厌倦了看到那些只是复制模型 GitHub 页面规格表的“最佳”列表。因此,在对这里的任何模型进行排名之前,我花了一周时间亲自运行每个模型,看看它在营销截图之外的实际表现如何。
我在家里运行着一台配备 RTX 4090 和 24GB 显存的备用台式机,所以它成了我的主要测试平台。对于需要更多内存的更大模型,比如 32B 的 FLUX.2 和 Qwen-Image-2512,我按小时租用了云端 GPU,而不是仅仅根据规格表来猜测它们的输出。
我构建了一套包含 20 个提示词的方案,并在每个模型上运行了相同的列表,没有刻意挑选。这些提示词涵盖了五个领域:一张写实的人像、一张纯色背景的产品照、一张带有标题和小字的海报、一个动漫风格的角色,以及一个包含多个物体的繁忙场景。每个模型在每个提示词下有三次尝试机会,我保留了三次中最好的一个,这与大多数人实际使用这些工具的方式相同。
在评分方面,我针对四个维度对每个结果进行了 1 到 5 分的评级:输出与提示词的匹配程度、全分辨率下细节的干净程度、在我的硬件上生成所需的时间,以及图像内部的文本(当提示词要求时)是否真正清晰可读。我在测试过程中将数据记录在电子表格中,而不是事后依靠记忆,因为在经过一整个下午的测试后,有几个模型的效果有些混淆了。
有几点很快就显现出来。Z-Image-Turbo 在不到四分钟的时间内完成了全部 20 个提示词的批处理,而 32B 的 FLUX 2 在租用的 GPU 上花费了接近 40 分钟。GLM-Image 和 Qwen-Image-2512 是仅有的两个在海报提示词上始终能正确呈现小字且没有乱码的模型。Waifu Diffusion 在动漫提示词上以绝对优势胜出,但在写实人像上表现得非常吃力,这符合我对一个在窄数据集上训练的模型的预期。
我根据该测试对以下七个模型进行了排名,而不仅仅是根据纸面规格或社区炒作,并且我记录了在加载具有合适批次大小的完整管道后,模型的实际显存(VRAM)使用量何时高于其官方最低要求。
前 7 款 开源图像生成模型
不同的 开源 AI 图像生成器 专注于不同的优势,例如写实度、速度、结构控制或文本准确性。以下是七个广泛使用的模型,每个模型都有明确的用途。
| 模型 | 架构 | 最低显存 (VRAM) | 许可证 | 主要优势 | 最适合 |
| Stable Diffusion 3.5 | 潜空间扩散 (DiT) | 8 GB+ | 商业 | 庞大的生态系统、LoRA 支持、活跃的社区 | 通用创意工作、初学者、基于插件的工作流 |
| ControlNet 1.1 | 条件化 SD 插件 | 8 GB+ | Apache 2.0 | 姿态控制、深度图、边缘引导 | 角色一致性、建筑布局、引导式生成 |
| FLUX.2 | 流匹配 Transformer (4B–32B) | 13 GB (4B) / 24 GB (32B) | BFL 商业 | 多图参考支持和强大的提示词遵循能力 | 高质量视觉效果、品牌资产、营销内容 |
| GLM-Image | 混合 AR + DiT (9B + 7B) | ~16 GB | 研究 / 自定义 | 强大的文本渲染、支持中文排版、编辑与生成一体化流程 | 海报、UI 样机、双语设计、信息图表 |
| Qwen-Image-2512 | 扩散 + 视觉语言模型 (20B) | ~16 GB | Apache 2.0 | 多语言文本、分层 RGBA 编辑、ControlNet 支持 | 商业工作流、高级编辑、多语言内容 |
| Waifu Diffusion | Stable Diffusion 微调(动漫数据集) | 6 GB+ | CreativeML OpenRAIL | 动漫风格、漫画视觉效果、以角色为中心的输出 | 游戏、视觉小说、动漫风格艺术作品 |
| Z-Image-Turbo | 蒸馏扩散 Transformer (6B) | 16 GB | Apache 2.0 | 极低延迟、支持中英文、批处理 | 实时应用、大规模管道、边缘部署 |
- Stable Diffusion 3.5
Stable Diffusion 3.5 是一款多模态扩散 Transformer (MMDiT) 文本到图像模型,由 Stability AI 开发。它提高了图像质量、排版、提示词理解和整体性能。该模型有三种尺寸,专为不同的硬件配置和使用场景而设计。这款最适合生成图像的模型仍然是使用最广泛的开源图像生成模型之一,得到了庞大的开发者和内容创作者社区的支持。
关键特性:
- 三种模型尺寸:Large(8B 参数)、Large Turbo 和 Medium(~2.5B 参数),每种都适合不同的性能和硬件需求
- 高分辨率输出:Large 模型支持约 100 万像素分辨率的高质量图像生成
- 快速生成变体:Large Turbo 可以在较少的步骤内产生高质量的结果
- 微调支持:专为定制而设计,具有更好的提示词一致性
- 灵活的使用许可证:对个人和小型企业免费,对大型机构提供企业许可
我的体验:4.5/5
这是我在所有五个提示词类别中表现最一致的模型。Large 模型几乎每次都能在第一或第二次尝试中完美呈现产品照 and 繁忙场景提示词,而且即使在全分辨率下,它在我的 4090 上也从未崩溃过。唯一失分的地方是文本渲染,海报提示词上的小字仍然显得有些扭曲。
- ControlNet 1.1
ControlNet 是一种通过添加额外条件来控制扩散模型的神经网络结构。它将神经网络块的权重复制到一个锁定副本和一个可训练副本中。可训练的副本学习您的条件,而锁定的副本则保留原始模型。它由研究员 lllyasviel 发布,本身并不生成图像。相反,这款最佳图像模型运行在 Stable Diffusion 之上,让您能够对生成的内容进行精确的结构控制。
关键特性:
- 多种控制类型:ControlNet 支持通过 Canny 边缘检测、Midas 深度估计、HED 软边缘检测、M-LSD 线条检测、法线贴图、OpenPose 人体姿态检测以及语义分割进行控制。
- 可组合控制: ControlNet 支持同时组合多个 ControlNet。所有生产就绪的模型都经过了多个 ControlNet 组合的广泛测试,并且通过 A1111 插件提供官方的 Multi-ControlNet 支持。
- v1.1 中改进的鲁棒性:ControlNet 1.1 增加了新的软边缘处理、多个新的预处理器(如 Canny、Depth 和 Inpaint),并与 1.0 版本相比增强了模型的整体鲁棒性和图像质量。
- 基于指令的编辑:ControlNet 1.1 包含一个在 Instruct Pix2Pix 数据集上训练的模型,该模型同时使用指令提示词和描述提示词进行训练。
我的体验:4/5
我没有使用相同的五个提示词对 ControlNet 1.1 进行评分,因为它的官方权重是为 Stable Diffusion 1.5 而不是 SD 3.5 设计的。相反,我将它的姿态和深度控制与 SD 3.5 的运行分开进行了评估。在十次重新生成中,姿态控制保持了人物位置的稳定。这表明 ControlNet 1.1 可以在兼容的工作流中提供有用的引导,但这些结果不应被视为与 SD 3.5 直接兼容的证据。
- FLUX 系列
FLUX 系列由 Black Forest Labs 开发,专注于高质量图像生成,具有强大的提示词对齐能力。它包含多个专为实验和生产工作流设计的模型。
核心功能:
- 多种变体:包括 FLUX.1 [schnell]、[dev] 以及用于编辑和控制的专业工具。
- 上下文内图像编辑:允许使用文本指令更改图像,而无需重新训练。
- 专用编辑工具:包括对图像局部重绘、图像外延和结构引导的支持。
- 开放权重可用性:支持本地部署和自定义。
- 灵活的部署选项:支持 API、本地设置和测试环境。
我的体验:4.5/5
FLUX.2 在我测试的所有模型中提供了最清晰的微观细节,特别是在产品拍摄提示词上,材质纹理看起来确实有光照效果,而不是像画上去的。32B 变体在租用的 GPU 上运行我这批任务时耗时最长,完成全部 20 个提示词的运行接近 40 分钟,所以如果你赶时间,它不是首选。
- GLM-Image
GLM-Image 是一款采用混合自回归和扩散解码器架构的图像生成模型。它在文本渲染和知识密集型生成场景中表现出优势,具有强大的高保真和细粒度细节生成能力。该模型由 Zhipu AI 开发,专为其他模型往往表现不足的用例而构建,特别是当图像需要包含可读文本或信息密集型布局时。
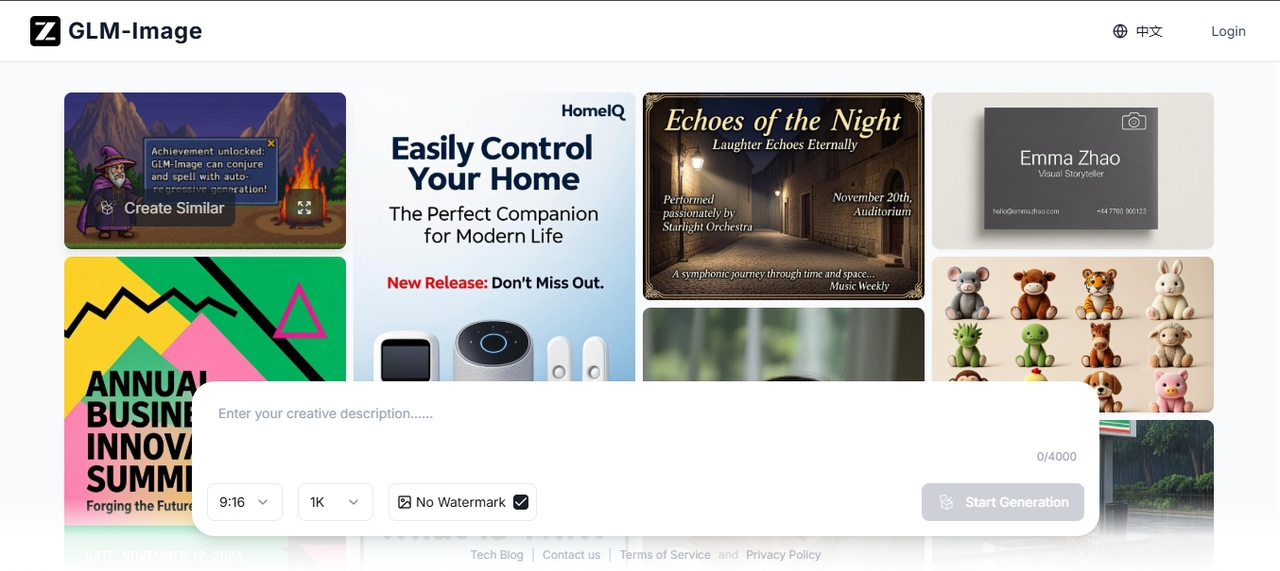
核心功能:
- 混合架构设计:将自回归编码与扩散解码相结合。
- 准确的文本渲染:在图像中生成清晰且可读的文本。
- 支持复杂布局:适用于海报、信息图表和结构化视觉效果。
- 统一的生成与编辑:同时处理文本生成图像和图像生成图像任务。
- 训练后精炼:使用强化学习来提高细节和对齐度。
我的体验:4/5
GLM-Image 是仅有的两个能让我海报提示词上的小字完全清晰可读的模型之一,并且它处理了信息图风格的布局,字母之间没有相互混杂。设置时间比大多数模型都要长,因为在商业使用前需要仔细阅读许可条款,这在便利性上扣了一分,而不是因为输出质量。
- Qwen-Image-2512
Qwen-Image-2512 是 Qwen-Image 文本生成图像的 12 月更新 最佳开源图像生成模型,其特点是增强了人物逼真度、更细腻的自然细节以及改进的文本渲染准确性和质量。它直接针对注重质量、可靠性和许可清晰度的企业和商业应用场景。
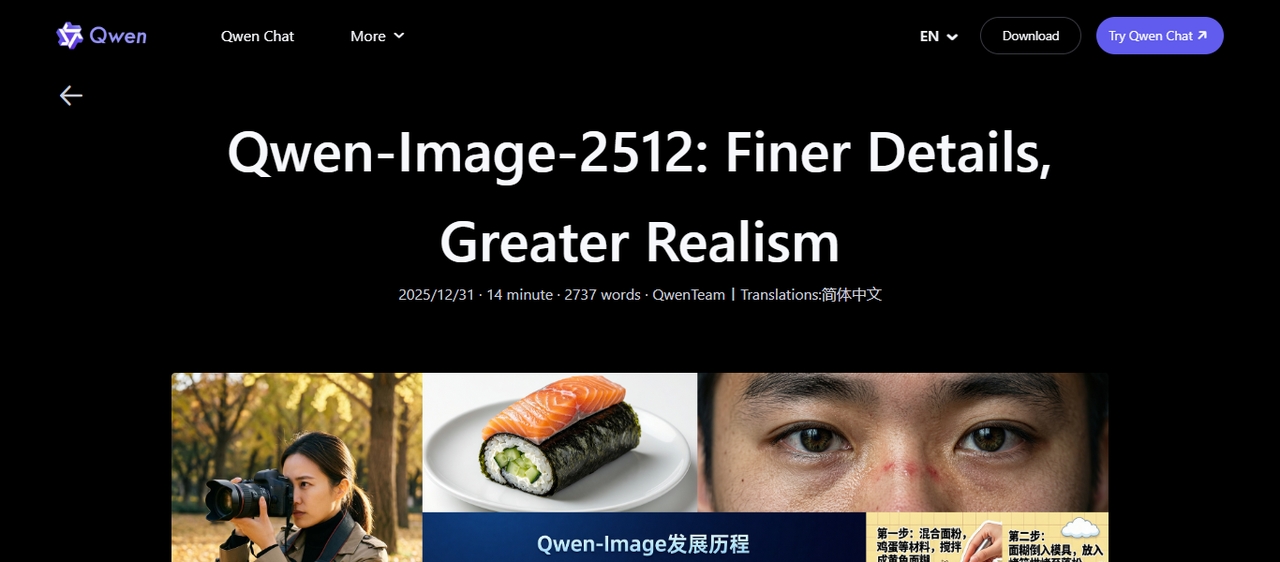
核心特性:
- 提高视觉逼真度:减少生成图像中的人工痕迹。
- 更好的文本准确性:产生更清晰的嵌入文本和结构化布局。
- 详细场景生成:以更高的清晰度处理环境和物体。
- 开放商业许可:在 Apache 2.0 许可下发布,可免费使用和修改。
- 完整的模型访问权限:可通过开放模型平台进行部署。
我的体验:4.5/5
Qwen-Image-2512 是另一个在海报提示词上正确读取小字的模型,而且它的人像效果在所有模型中看起来最自然,不像我从其他一些扩散模型中得到的那样有蜡质感。结合 Apache 2.0 许可,这是我在需要快速推进且无需进行许可谈判的客户项目中首选的模型。
- Waifu Diffusion
Waifu Diffusion 由 Hakurei 创建,专注于动漫风格的图像生成。它专门在动漫数据集上进行训练,这使其能够产生一致的角色设计和风格化的视觉效果。它基于 Stable Diffusion 构建,并直接融入其生态系统,这使得已经熟悉这些工具的艺术家可以轻松使用。
核心特性:
- 专注于动漫的训练:该模型在大型动漫图像数据集上进行训练,这有助于它学习动漫艺术中常见的角色比例、面部表情和风格元素。
- 一致的角色质量:它在不同的提示词中保持稳定的面部特征、发型和服装细节,这在多个场景中创建相同角色时非常有用。
- 通过提示词进行风格控制:您可以使用动漫社区中常用的标签和提示词风格来引导输出。
- 基于 SDXL 的变体:基于 SDXL 构建的新版本在保持动漫风格完整的同时,提高了分辨率、光影和更精细的细节。
- 开放获取许可:在 CreativeML OpenRAIL-M 许可下分发,允许在特定条件下使用和重新分发。
- 广泛的社区支持:提供大量的预训练检查点、LoRA 和风格包。
我的体验:3.5/5
Waifu Diffusion 在我运行的所有三次尝试中都保持了角色的面部和服装一致,从而彻底赢得了动漫提示词的测试。但当我让它生成写实人像提示词时,无论我如何措辞,结果仍然呈现出一种接近动漫的外观,这正是你对一个在窄数据集上训练的模型所期望的结果。擅长一项工作,但并非为其他工作而设计。
- Z-Image-Turbo
Z-Image-Turbo 是由 Tongyi-MAI 开发的。它专注于速度和效率,这使其适用于需要快速生成图像的应用。它是紧凑型模型系列的一部分,旨在不依赖超大架构的情况下提供强大的结果。
主要特性:
- 亚秒级生成速度:Z-Image-Turbo 证明了在不依赖庞大模型尺寸的情况下,也可以实现顶尖的性能。
- 双语文本渲染:准确渲染复杂的中文和英文文本,并在海报设计中展现出强大的排版构图能力和良好的字形美感。
- 提示词增强与推理: 内置的提示词增强器赋予了模型推理能力。
- 高效的单流架构: Z-Image-Turbo 采用了可扩展的单流 DiT 架构,其中文本、视觉语义 token 和图像 VAE token 在序列级别被拼接成一个统一的输入流。
我的体验:4/5
Z-Image-Turbo 在不到四分钟的时间内就完成了我整个包含 20 个提示词的批处理,是这七个模型中迄今为止最快的。双语文本渲染在我海报提示词的英文和中文版本上都表现良好。在繁杂场景提示词上的精细细节表现比 Stable Diffusion 3.5 和 FLUX.2 逊色一筹,考虑到该模型的尺寸要小得多,这也是合乎情理的。
选择模型前需要考虑的关键因素
在您决定选择某个模型之前,有一些实际情况值得检查。以下是需要关注的内容及其重要性。
- 图像质量
图像质量取决于输出结果与您要求的相比有多真实、细致和准确。有些模型能产生逼真的效果,而另一些则更偏向风格化。正确的选择取决于您项目的实际需求。
- 速度(推理时间)
推理时间是模型生成一张图像所需的时间。如果您正在批量生成数百张图像或构建实时工具,速度就非常重要。一个生成效果很好但速度较慢的模型并不总是实用的。
- 显存(VRAM)要求
显存(VRAM)是显卡运行模型时使用的内存。更大的模型需要更多的显存,有时需要 16 GB 或更多。如果您的硬件不满足要求,模型将根本无法运行,或者运行速度太慢而无法使用。
- 文本渲染能力
有些模型能很好地处理图像中的文本,而另一些则完全出错。如果您的输出包含标牌、海报、标签或任何书面内容,这将成为一个关键因素。像 GLM-Image 和 Qwen-Image-2512 这样的模型在构建时就专门考虑到了这一点。
- 许可(商业 vs 受限)
有些模型对个人或研究使用免费,但商业工作需要付费许可。其他模型如 Z-Image-Turbo 和 Qwen-Image-2512 在 Apache 2.0 协议下完全开源。在客户项目或产品中使用模型之前,请务必检查其许可协议。
- 生态系统与社区
强大的社区意味着更多的教程、预构建的微调模型、插件,以及在出现问题时更快的修复。例如,Stable Diffusion 拥有成千上万个社区创建的资源。一个更新或更小众的模型可能令人印象深刻,但能给您提供的支持却非常有限。
综合权衡这六个因素,开源开始显得不那么像免费的午餐了。一个在图像质量和文本渲染方面表现出色的模型可能需要您没有的 16GB+ 显存,而且在生成任何可用内容之前,还需要花费大量时间调试本地设置。如果您真正想要的是无需自己托管模型即可获得顶尖性能,或者访问这些开源选项根本无法企及的闭源模型,那么这就是 Framia Pro 的用武之地。
Framia Pro:您处理非开源模型的选择
Framia Pro 是一个围绕工作流画布构建的 AI 创意平台,在这里您可以将来自合作伙伴(如 Seedream 5.0 Pro、Nano Banana Pro、Kling、Seedance 2.5 和 Veo 3.1)的闭源模型连接到一个工作区中,而不是选择单一引擎并受其限制。您描述您的需求,Framia Pro 会处理脚本、视觉效果以及跨连接节点的组装,您可以在过程中的任何时间点对其进行编辑。它将图像生成、视频和完整的 Marketing Studio 整合到一个地方,因此需要非开源模型结果的创作者无需拼凑多个订阅即可实现目标。
我在 Framia Pro 中与上述七个模型一起体验了几个小时,以了解闭源模型体验的实际对比情况,并在下面记录了它适合和不适合的地方。
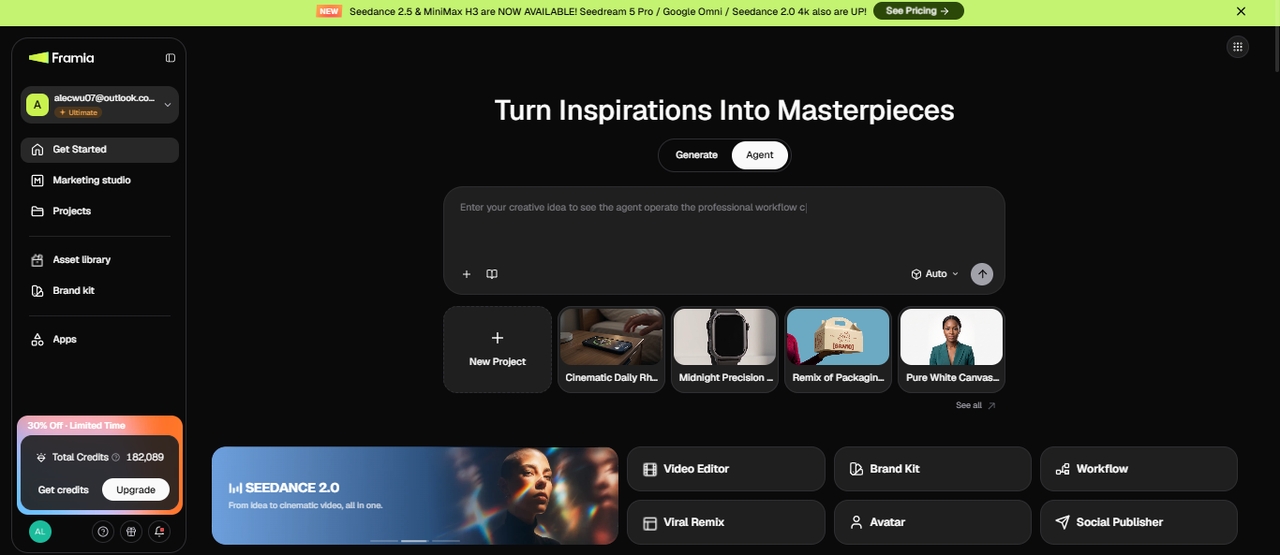
Framia Pro 图像生成器的功能
Framia Pro 提供了一个单一的工作区,您可以在其中使用不同的最佳图像生成模型来创建和编辑图像。每个功能都旨在让您控制图像的生成和细化方式。
- 连接每一步的工作流画布
Framia Pro 的画布将您的项目布局为连接的节点(脚本、图像、视频和音频),您可以随着项目的发展拖动、添加或删除这些节点。您无需生成一张图像然后为下一个资产重新开始,而是构建一个完整的序列,并仅重新运行需要更改的节点。
- 一个工作区中的多个 AI 模型
Framia Pro 让您可以在一个平台内访问用于图像的 Nano Banana Pro、Qwen Image、Midjourney v7、Flux Max 和 Seedream 4.5,以及用于视频的 Kling、Veo 3.1 和 Seedance。您可以根据想要的结果切换模型,并并排比较输出,而无需打开单独的工具。
- 用于保持视觉一致性的 Brand Kit
Framia Pro 的 Brand Kit 生成器可以根据单一简报构建徽标、调色板、排版和社交模板,然后使您之后生成的每张图像都锁定在这些品牌指南中。这对于在不同活动中制作大量视觉效果的营销团队和企业至关重要。
- 可供重混的热门模板
Framia Pro 保留了一个热门、易于传播的模板库,您可以选择这些模板并使用自己的提示词进行重混,而不是从空白画布构建概念。这更多是针对快速周转的社交内容,而不是本指南所侧重的风格,但如果您也制作视频,这值得了解。
- 通过简单的聊天命令编辑图像
您可以用通俗的语言描述更改,例如更换背景或调整徽标大小,Framia Pro 会直接将其应用到图像中。这种基于聊天的编辑跳过了手动遮罩或为了小修改而重新进行整个生成的过程。
结论
在这篇文章中,我们探索了排名前 7 的开源图像生成模型,并展示了不同工具如何处理图像创建、性能和灵活性。每个模型在视觉质量、速度、硬件需求以及对各种风格的支持等领域都提供了各自的优势。Framia Pro 将多个模型整合到一个地方,为您在单一工作流中生成和编辑图像提供更多选择,而无需在单独的工具之间切换。立即体验!
常见问题解答
哪种开源 AI 图像生成器最常用?
由于其活跃的社区和广泛的工具支持,Stable Diffusion 仍然是使用最广泛的开源图像生成器之一。在 Framia Pro 中,您可以在一个工作区中访问不同的图像模型,这消除了为每个生成器设置单独环境的需要,并允许在输出之间进行更轻松的切换。
哪些图像生成模型能产生更高的视觉质量?
较新的模型,例如基于 SDXL-based 和 Flux series 的模型,通常会生成更清晰的纹理、改进的光照和更好的构图。Framia Pro 让您可以访问 Nano Banana Pro、Seedream 4.5、Flux Max、Qwen Image 和 Midjourney v7 模型,让您即时创建图像。
在有限的硬件上,哪种模型最适合用于图像生成?
优化或轻量级的模型版本更适合显存(VRAM)有限的系统。Framia Pro 在后端处理模型访问,因此您无需管理本地设置即可运行更大型的模型,从而降低了您对高端硬件的需求。
哪些被认为是最佳的开源图像生成模型?
像 Stable Diffusion、Waifu Diffusion 和基于 ControlNet 的设置等模型通常用于不同的任务,例如写实、动漫艺术和结构控制。Framia Pro 将这些选项整合在一起,允许您在单个项目中选择并测试多个模型。
哪些图像模型在专业应用场景中更受欢迎?
专业工作流通常需要稳定的输出、一致的结果以及对编辑的支持。Framia Pro 通过提供基于聊天的图像编辑和批量生成来增加价值,这使您能够在同一个地方微调图像并生成多种变体,而无需切换工具。
哪款是最好的免费图像生成模型?
Stable Diffusion 3.5 是最完整的免费选择,因为 Medium 和 Large Turbo 变体可以在消费级硬件上运行,且其许可证涵盖了小型企业的商业用途。Z-Image-Turbo 和 Qwen-Image-2512 在 Apache 2.0 许可下也是完全免费的,输出速度更快,但目前围绕它们建立的社区较小。
有可用的开源本地 AI 图像生成器吗?
是的。Stable Diffusion 3.5、ControlNet 1.1、FLUX.2、Waifu Diffusion 和 Z-Image-Turbo 在下载后都可以在您自己的硬件上本地运行,无需云端账户或订阅。主要要求是足够的显存(VRAM),通常根据您选择的模型,需要 6GB 到 24GB 不等。
可以将开源图像模型用于商业项目吗?
可以,但这取决于模型的许可证。有些模型允许商业用途,而另一些则有限制。在将生成的图像用于客户工作、产品或付费活动之前,请务必仔细阅读许可条款。