Compartir


- Los modelos de generación de video con IA convierten una indicación de texto, una imagen o un clip existente guardé mis colores,clip en metraje nuevo a través de un proceso de difusión que refina el ruido aleatorio paso a paso hasta que coincide con tu descripción.
- Cinco modelos de código cerrado lideran el grupo en este momento, cada uno con una fortaleza diferente: Veo 3.1 (audio nativo), Runway Gen-4.5 (control creativo), Seedance 2.5 (clips largos de una sola toma), Kling 3.0 (movimiento físicamente preciso) y MiniMax H3 (entrada multimodal unificada).
- Wan 2.2, Mochi y HunyuanVideo te brindan más control y sin límites de uso, pero necesitarás un hardware más potente y algo de tiempo de configuración.
- Framia Pro reúne varios de estos modelos en un solo panel, para que puedas cambiar entre ellos sin tener que lidiar con inicios de sesión y suscripciones independientes.
¿Qué son los modelos de generación de video con IA?
Los modelos de generación de video con IA son sistemas que crean video a partir de una indicación, una imagen o un clip existente, sin necesidad de una cámara o un equipo de filmación.
Aprenden de enormes conjuntos de datos, millones de videoclips emparejados con descripciones, y captan los patrones visuales que conectan una frase como "un perro corriendo por la nieve" con cómo se ve realmente en pantalla.
La técnica detrás de esto se llama difusión. El modelo comienza con ruido aleatorio y lo limpia a lo largo de docenas de pasos hasta que aparece un video. Durante el entrenamiento, observó cómo videos reales se corrompían en ruido y aprendió a revertir ese proceso. Al momento de la generación, tu indicación guía cada paso de limpieza hacia la escena que describiste.
La parte difícil no es un solo fotograma. Mantiene cientos de fotogramas coherentes entre sí. Un rostro, un atuendo o una sombra deben mantenerse estables a lo largo de todo el clip, no solo verse bien de forma aislada.
Los modelos de video procesan secuencias completas de fotogramas juntas para que cada fotograma pueda hacer referencia a los demás, razón por la cual la generación de video requiere mucha más capacidad de cómputo que una sola imagen.
¿Cuáles son los diferentes tipos de modelos de video con IA?
Antes de comenzar a probar, tuve que determinar qué tipo de herramienta estaba usando realmente, ya que no todos los generadores de video con IA parten del mismo lugar.
Modelos de IA de texto a video
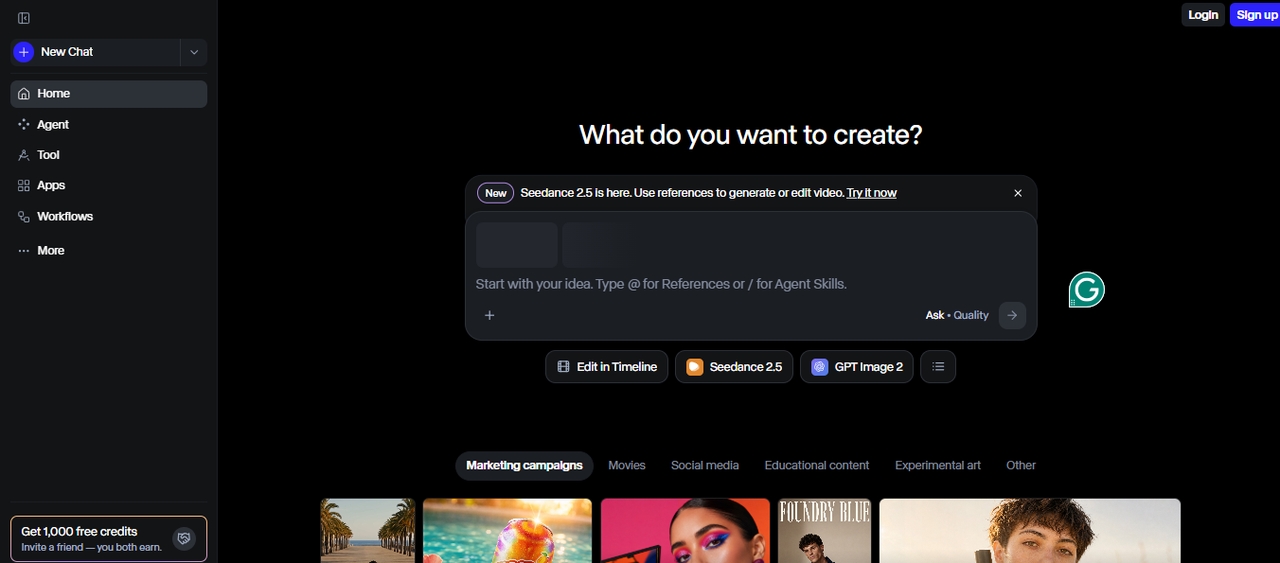
Los modelos de texto a video convierten una descripción escrita en una escena en movimiento desde cero. Escribes lo que quieres y el modelo crea los elementos visuales. Esto funciona mejor cuando tienes una idea pero no tienes metraje ni una imagen de referencia de la cual partir, como el concepto de un producto, el ritmo de una historia corta o una escena.
Modelos de imagen a video
Los modelos de imagen a video parten de una imagen que ya tienes y añaden movimiento, movimiento de cámara o pequeños cambios para darle vida. Esto es ideal para demostraciones de productos y publicaciones en redes sociales donde deseas un movimiento rápido sin generar todo desde cero.
Modelos de video multimodales
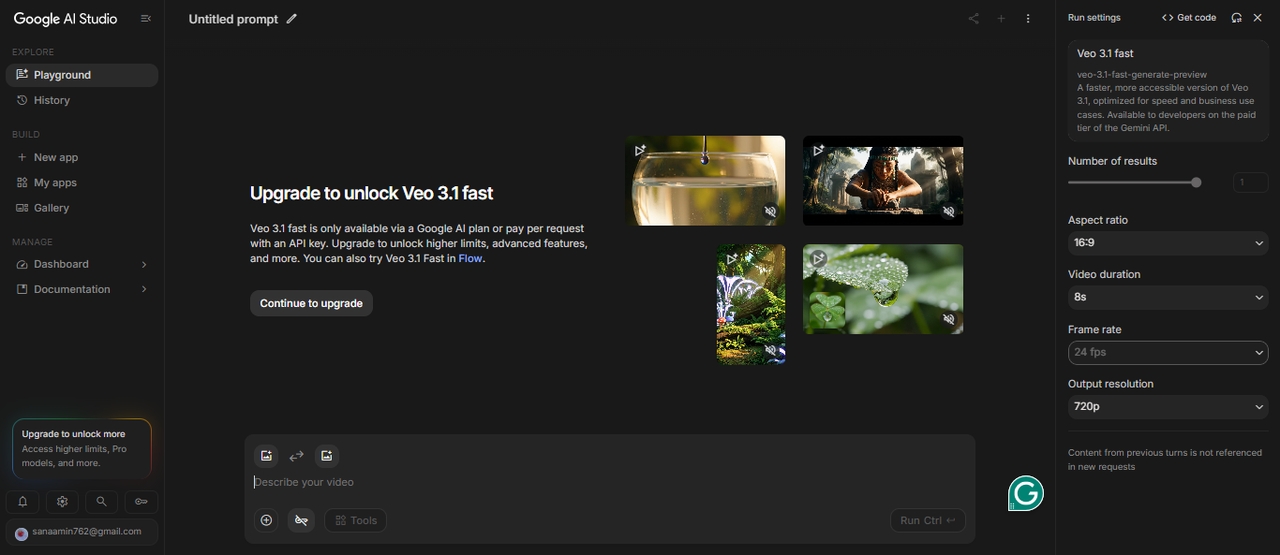
Estos modelos funcionan con más de un tipo de entrada al mismo tiempo. Puedes mezclar texto, imágenes, audio e incluso clips de video existentes para guiar el resultado final.
Esto te brinda más control sobre cómo resulta el video. No solo estás describiendo una escena, la estás moldeando con múltiples entradas. Ese control ayuda cuando deseas detalles específicos, una narración más fluida o un video que siga una dirección clara.
Cómo probamos cada modelo
Soy un estratega de contenido que ha pasado los últimos dos años probando herramientas creativas de IA para ganarse la vida, y sometí cada modelo de generación de video con IA a las mismas cinco indicaciones que incluyen una demostración de producto, una escena narrativa corta, un clip de busto parlante, una secuencia de acción y una pieza de arte estilizada.
Para cada modelo, generé al menos tres resultados por indicación y los califiqué según el realismo, la precisión del movimiento, el cumplimiento de la indicación y la calidad del audio cuando correspondía.
8 modelos de generación de video con IA, y en qué destaca cada uno
Después de probar ocho modelos de generación de video con IA en demostraciones de productos, escenas narrativas, clips de busto parlante, secuencias de acción y elementos visuales estilizados, descubrí que ningún modelo individual funcionó mejor en todas las categorías. Veo 3.1 se destacó por su audio nativo, Runway Gen-4.5 por su control creativo y consistencia de escena, y Seedance 2.5 por clips más largos de una sola pasada. Kling 3.0 fue una opción sólida para escenas con mucho movimiento, mientras que MiniMax H3 manejó entradas mixtas y audio sincronizado. Wan 2.6, Mochi y HunyuanVideo ofrecieron alternativas para los usuarios que prefieren modelos de pesos abiertos y flujos de trabajo locales, aunque los requisitos de hardware y la configuración pueden ser factores limitantes.
Estos resultados se basan en mis pruebas prácticas, no en una clasificación universal. La mejor elección depende de su tipo de video, requisitos de salida, presupuesto y de si prefiere un servicio alojado o un modelo que pueda ejecutar usted mismo.
A continuación, detallo las fortalezas, características, pros y contras de cada modelo para ayudarle a elegir el adecuado para su proyecto.
A continuación se presentan los mejores modelos de código cerrado que debe conocer en este momento.
| Característica | Veo 3.1 | Runway Gen-4.5 | Seedance 2.5 | Kling 3.0 | MiniMax H3 |
| Resolución máxima | 1080p | 1080p | 1080p nativo | 4K / 60 fps, primer modelo en alcanzar 4K nativo a 60 fps | 2K a 24 fps, 768p también disponible |
| Duración máxima del clip | 8 segundos de forma nativa, ampliable mediante herramientas de terceros | Hasta 16 segundos en Gen-4 | Hasta 30 segundos en una sola toma continua | Hasta 2 minutos, ampliable a 3 minutos | 5–15 segundos, ampliable a 30 con la herramienta Extend integrada |
| Velocidad de fotogramas | 24–30 fps | 24 fps | Aún no publicado | 30 fps | 24 fps |
| Audio nativo | ✅ Diálogo, SFX, ambiental | ✅ Añadido en dic. de 2025 | ✅ Más de 10 idiomas | ✅ | ✅ Estéreo nativo |
| Entrada multimodal | ✅ Hasta 3 referencias de imagen | ❌ | ✅ Hasta 50 referencias, 30 imágenes, 10 de video, 10 de audio | ✅ Texto, imagen, audio, video | ✅ Texto, imagen, video y audio leídos como un solo contexto |
| Multitoma | ❌ | ✅ | ✅ Toma única continua, sin costuras | ✅ Hasta 6 tomas | ❌ |
| Motor de física | ✅ | ❌ | No especificado | ✅ | No especificado |
| Modo rápido / borrador | ✅ Veo 3 Fast | ✅ Gen-4 Turbo | Aún no publicado | ✅ Hasta 20 veces más rápido | ✅ Opción de 768p más ligera |
| Relaciones de aspecto | 16:9 y 9:16 | 16:9, 9:16, 1:1 | Aún no publicado | 16:9, 9:16, 1:1 | 21:9, 16:9, 4:3, 1:1, 3:4, 9:16 |
| Nivel gratuito | ❌ | ❌ | Implementándose en Jimeng AI, Doubao, Dreamina | ✅ 66 créditos diarios | A través de la aplicación Hailuo AI |
| Ideal para | Realismo + audio | Control cinematográfico | Clips largos de toma única + referencias | 4K + formato largo | Edición multimodal + consistencia |
- Veo 3.1
Veo 3.1 es el modelo insignia de generación de video de Google, y el audio es donde se distanció del resto en mis pruebas. Genera diálogos, efectos de sonido y audio ambiental en la misma pasada que el video, todo a partir de una sola indicación. Se convirtió en el motor detrás de una ola de clips virales en plataformas sociales tras su lanzamiento en octubre de 2025, y su vinculación con Google Workspace hizo que se adaptara fácilmente a las partes de mi flujo de trabajo que ya residen en ese ecosistema.
Características
- Audio nativo: diálogo, SFX y sonido ambiental en una sola pasada.
- Resolución 4K: salida de hasta ultra alta definición.
- Multireferencia: admite hasta 3 imágenes de referencia.
- Larga duración: produce una salida de hasta un minuto completo.
- Diálogo en la indicación: escriba el discurso del personaje directamente en su indicación.
Pros
- Calidad de audio nativo inigualable.
- Excelente realismo y precisión de iluminación.
- Profunda integración con el ecosistema de Google.
- Sólida precisión de la indicación.
Contras
- Videos con marca de agua en los planes inferiores.
- Menos flexible para contenido estilizado o no realista.
- Runway Gen-4.5
Runway ha sido un elemento fijo en los modelos de video de IA generativa durante años, y Gen-4.5, lanzado a finales de 2025, es donde noté el mayor salto en calidad y secuenciación multitoma. Su interfaz de chat me permitió perfeccionar un video describiendo los cambios en una conversación en lugar de tener que reescribir la indicación desde cero. De todo lo que probé, este es el modelo que recomendaría a un profesional creativo cuando la consistencia de la escena y del personaje son importantes en múltiples tomas.
Características
- Pinceles de movimiento: pinta exactamente qué partes de una escena deben moverse.
- Multi-shot: encadena múltiples clips en una secuencia cohesiva.
- Act-one: captura de movimiento y expresión facial.
- Edición por chat: perfecciona los resultados a través de una conversación natural.
- Salida 4K: exportación en ultra alta resolución.
Pros
- La mejor consistencia de escena y personajes de su clase.
- Potentes controles creativos para profesionales.
- Sólida comunidad y ecosistema.
Contras
- Costoso en los niveles más altos.
- Más lento que algunos competidores para contenido rápido de redes sociales.
- Curva de aprendizaje más pronunciada para principiantes.
- Seedance 2.5
Seedance 2.5 es la continuación de ByteDance a Seedance 2.0, que había liderado la Artificial Analysis Video Arena tanto para texto a video como para imagen a video a principios de 2026. La nueva versión amplía la generación de una sola pasada de 15 segundos a un total de 30, pasa a 1080p nativo y acepta hasta 50 referencias multimodales (una mezcla de imágenes, video y audio) en una sola generación, en comparación con las 12 de la versión anterior. También añade audio nativo en más de 10 idiomas, y lo probé mientras se implementaba en Jimeng AI, Doubao y Dreamina, con acceso a la API a través de BytePlus ModelArk.
Características
- Generación de una sola pasada extendida: hasta 30 segundos en un clip continuo, sin necesidad de unión.
- 1080p nativo: frente a los 720p de la versión anterior.
- Soporte de referencias ampliado: hasta 50 referencias multimodales (30 imágenes, 10 videos, 10 de audio) en una sola generación.
- Audio multilingüe nativo: diálogo y sonido en más de 10 idiomas.
- Edición precisa: reemplaza un producto, extiende una toma o realiza una edición específica sin volver a generar todo el clip.
- Previsualización de modelo blanco en 3D: planifica los movimientos de cámara y las tomas antes de comprometerte con una generación completa.
Pros
- Los clips largos de una sola toma funcionan bien para dramas de formato corto y contenido serializado.
- Sólida continuidad de cámara de plano a plano a lo largo de una toma completa de 30 segundos.
- El número ampliado de referencias ofrece un mayor control sobre la consistencia de los personajes y productos.
Contras
- ByteDance aún no ha publicado un informe técnico completo, por lo que algunas especificaciones provienen de demostraciones de lanzamiento en lugar de pruebas independientes.
- El acceso completo a la API no estaba activo en todas partes en el momento de las pruebas.
- Kling 3.0
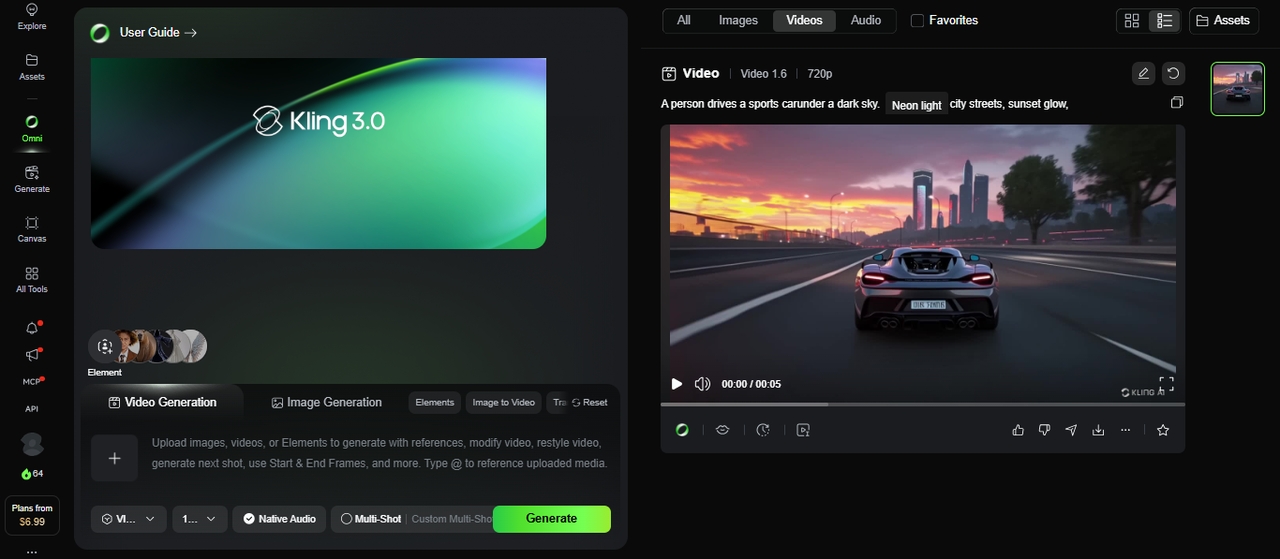
Kling 3.0 se lanzó el 4 de febrero de 2026 y, en cuestión de días, ya se le calificaba como el mayor salto del año en generación de video con IA. Funciona con una arquitectura Omni One que combina Atención Conjunta Espaciotemporal 3D con razonamiento de cadena de pensamiento, que es como logró que la gravedad, el equilibrio, la deformación y la inercia parecieran reales en lugar de gomosos en mis pruebas. Admite entrada multimodal de texto, imágenes, audio y video, y genera audio nativo en inglés, chino, japonés, coreano y español, con control sobre el diálogo de los personajes y el orden de habla.
Características
- Física de Omni One: simulación real de gravedad, colisión e inercia.
- Audio nativo: voces en off, lip-sync, SFX y música.
- Storyboard multi-toma: hasta 6 tomas con control de cámara a nivel de director.
- Modo borrador: genera hasta 20 veces más rápido para un prototipado rápido.
- Salida 4K/60fps: con exportación HDR de 16 bits y EXR.
- Editor 7 en 1: adición de objetos, cambio de fondo y transferencia de estilo en una sola herramienta.
Pros
- La física y el movimiento humano más realistas disponibles.
- Audio nativo multilingüe con control de dialecto y acento.
- Entrada asequible a $7.99/mes con un sólido nivel gratuito.
- Se exporta directamente a flujos de trabajo de VFX profesionales (Nuke, After Effects, DaVinci).
Contras
- Un renderizado multi-toma de 15 segundos puede tardar más de 5 minutos.
- La salida 4K está actualmente limitada a los planes de nivel superior.
- Los períodos de alta demanda extienden las colas de renderizado.
- MiniMax H3
MiniMax H3, también conocido como Hailuo 3.0, sigue a Hailuo 02 en la línea de videos de MiniMax. En lugar de tratar las referencias de texto, imagen, video y audio como entradas separadas, las lee todas juntas como un único contexto compartido, y luego devuelve video y audio sincronizados en un solo resultado. MiniMax ha dicho que planea lanzar los pesos del modelo, aunque yo accedí a él a través de la aplicación Hailuo AI, la API de MiniMax Open Platform y socios de alojamiento como fal.
Características
- Contexto multimodal unificado: referencias de texto, imagen, video y audio resueltas juntas en una sola generación.
- Audio estéreo nativo: diálogo, música, efectos y ambiente generados con el video, no añadidos en capas después.
- Resolución de hasta 2K a 24fps, con 768p también disponible como una opción más ligera.
- Generaciones de 5 a 15 segundos, ampliables hasta 30 segundos con la herramienta integrada Extend Video.
- Edición dirigida: intercambie o elimine personajes y objetos, cambie la iluminación o los fondos, o revise el diálogo sin tener que rehacer todo el clip.
- Múltiples relaciones de aspecto: 21:9, 16:9, 4:3, 1:1, 3:4 y 9:16.
Pros
- Fuerte consistencia temporal; el movimiento se mantiene estable durante todo el clip en lugar de desviarse a mitad de camino.
- El audio estéreo nativo proviene del mismo paso de generación, sin un paso de sonido separado.
- El soporte de relación de aspecto amplia se adapta a todo, desde pantalla ancha cinematográfica hasta contenido social vertical.
Contras
- MiniMax aún no ha publicado un informe técnico completo, por lo que algunas afirmaciones provienen de la empresa en lugar de evaluaciones comparativas independientes.
- Ejecutar la versión de pesos abiertos localmente requiere una GPU de gama alta con más de 24 GB de VRAM una vez que se liberen los pesos.
| Característica | Wan 2.2 | Mochi 1 (Genmo) | HunyuanVideo (Tencent) |
| Parámetros | 1.3B / 14B | 10B | 13B |
| Resolución máxima | 720p (1080p en 14B) | 480p (640x480) | 720p (1080p con v1.5) |
| Duración máxima del clip | Hasta 10 segundos | Hasta 5.4 segundos a 30fps | Hasta 5 segundos (720p) |
| Tasa de fotogramas | 16fps | 30fps | 24fps |
| VRAM mínima | 8GB (modelo 1.3B) | 20GB+ a precisión completa | 14GB (v1.5) / 60–80GB (original) |
| Velocidad de generación | 1–2 min para un clip de 4–5 s (GPU de 8GB) | 3–4 min para un clip de 5.4 s | 6–10 min para un clip de 5 s (GPU de 16GB) |
| Texto a video | ✅ | ✅ | ✅ |
| Imagen a video | ✅ | ❌ | ✅ |
| Ajuste fino LoRA | ✅ | ✅ | ✅ (se requiere alto cómputo) |
| Soporte de ComfyUI | ✅ | ✅ | ✅ |
| Soporte de Diffusers | ✅ | ❌ | ✅ |
| Prompts bilingües | ✅ Inglés + Chino | ❌ | ❌ |
| Licencia | Apache 2.0 | Apache 2.0 | Tencent Community License |
| Compatible con GPU de consumo | ✅ El mejor de su clase | ❌ | ⚠️ solo v1.5 |
| Ideal para | Versatilidad + accesibilidad | Fotorrealismo + ajuste fino | Calidad cinematográfica + rostros |
- Wan 2.6
Wan 2.6 es la serie de modelos de generación de video de Alibaba, lanzada en diciembre de 2025. Admite la generación de texto a video, imagen a video y referencia a video. Sus principales fortalezas incluyen la narración de múltiples tomas, un seguimiento de prompts mejorado y un audio que se mantiene sincronizado con las imágenes. El modelo de referencia a video también puede usar un clip de referencia para preservar la apariencia y la voz de una persona u objeto en escenas recién generadas.
Wan 2.6 sigue siendo una opción para los creadores que desean experimentar con escenas generadas por IA, videos de productos o clips basados en diálogos.
Características
- Arquitectura MoE: expertos especializados para diferentes etapas de ruido.
- Híbrido T2V/I2V: entrada de texto e imagen en un modelo unificado.
- Cuantización GGUF: se ejecuta en GPU de consumo con 4 GB de VRAM.
- Controles cinematográficos: etiquetas de iluminación, contraste y tono de color.
- Soporte bilingüe: manejo de prompts en inglés y chino.
- Acceso alojado: Utilice modelos Wan compatibles a través de Alibaba Cloud Model Studio
Pros
- Admite varios flujos de trabajo de generación de video dentro de una misma familia de modelos.
- Los controles de múltiples tomas se adaptan a historias cortas, anuncios y exhibiciones de productos.
- La referencia a video puede ayudar a mantener la identidad del personaje en las escenas generadas.
- Ofrece funciones de audio y diálogo sincronizados en las variantes compatibles.
Contras
- Los clips son cortos, por lo que los proyectos más largos pueden requerir múltiples generaciones y edición.
- El acceso alojado puede implicar cargos por API o restricciones específicas del servicio.
- Mochi (Genmo)
Mochi 1 es un modelo de 10 mil millones de parámetros construido sobre una novedosa arquitectura AsymmDiT, lanzado bajo Apache 2.0. En mis pruebas, destacó por su movimiento fotorrealista a 30 fps, lo que lo hace ideal para metraje de estilo documental, entornos naturales y movimiento humano que debe parecer real. Fue uno de los primeros modelos de código abierto que me hizo tomar en serio la generación de video local.
Features
- Base AsymmDiT: arquitectura diseñada específicamente para la síntesis de video.
- Salida a 30 fps: movimiento fluido a la tasa de fotogramas nativa.
- Ajuste fino con LoRA: personalice con sus propios conjuntos de datos de video.
- Licencia Apache 2.0: abierto para investigación y uso comercial.
- Integración con ComfyUI: soporte para flujos de trabajo basados en nodos.
- Codificación T5-XXL: sólida comprensión de texto y adherencia al prompt.
Pros
- La licencia más permisiva de cualquier modelo abierto de alta calidad.
- Excelente movimiento fotorrealista y movimiento natural.
- Comunidad sólida con intercambio activo de ajustes finos.
Contras
- Limitado a una resolución de 480p; requiere escalado para salida en HD.
- Requiere más de 20 GB de VRAM a precisión completa.
- HunyuanVideo (Tencent)
HunyuanVideo es el modelo de video de código abierto insignia de Tencent, creado para una generación de alta calidad con una sólida consistencia de movimiento y una estructura de escena más limpia que la mayoría de las alternativas abiertas que probé. Su arquitectura basada en transformers maneja datos visuales y temporales de forma conjunta, y recurrí a él cada vez que quería más control sobre el proceso de generación de lo que me ofrecería una herramienta alojada.
Características
- La escala más grande de 1B en la categoría de código abierto.
- Fusión de doble flujo: procesamiento separado de texto y video antes de la fusión.
- Paralelismo xDiT: paralelismo de secuencia multi-GPU para una inferencia más rápida.
- Cuantización FP8: huella de memoria reducida sin una pérdida importante de calidad.
- Diffusers + comfyUI: integración de ecosistema plug-and-play.
- Causal 3D VAE: compresión espacio-temporal para un movimiento coherente.
Pros
- La mejor calidad cinematográfica y realismo facial en código abierto.
- Enorme ecosistema de LoRA para la personalización de estilos y personajes.
- Sólido manejo de múltiples personas y escenas complejas.
Contras
- Un clip de 5 segundos puede tardar más de 15 minutos dependiendo de la configuración.
- Complejidad de configuración pronunciada; no apto para principiantes.
Explora los mejores modelos de video de IA en Framia Pro
Este es el problema real con el que me encontré: no quería una cuenta de Google para Veo, una suscripción de Runway para Gen-4.5 y un inicio de sesión de Kuaishou para Kling, y luego repetir esa configuración cada vez que se lanzara un nuevo modelo. Esa es la razón por la que trasladé la mayor parte de estas pruebas a Framia Pro.
Framia Pro reúne Veo 3.1, Kling 3.0, Seedance 2.5 y otros modelos destacados de video e imagen en un solo espacio de trabajo. Podía comenzar con una idea y convertirla en video usando texto, imágenes, audio o una mezcla de los tres, sin cambiar de pestaña ni pagar por una cuenta separada para cada modelo. Los agentes creativos integrados también cubren casos de uso específicos, como videos musicales, anuncios y narración de historias, por lo que tenía un punto de partida sin importar lo que estuviera creando.
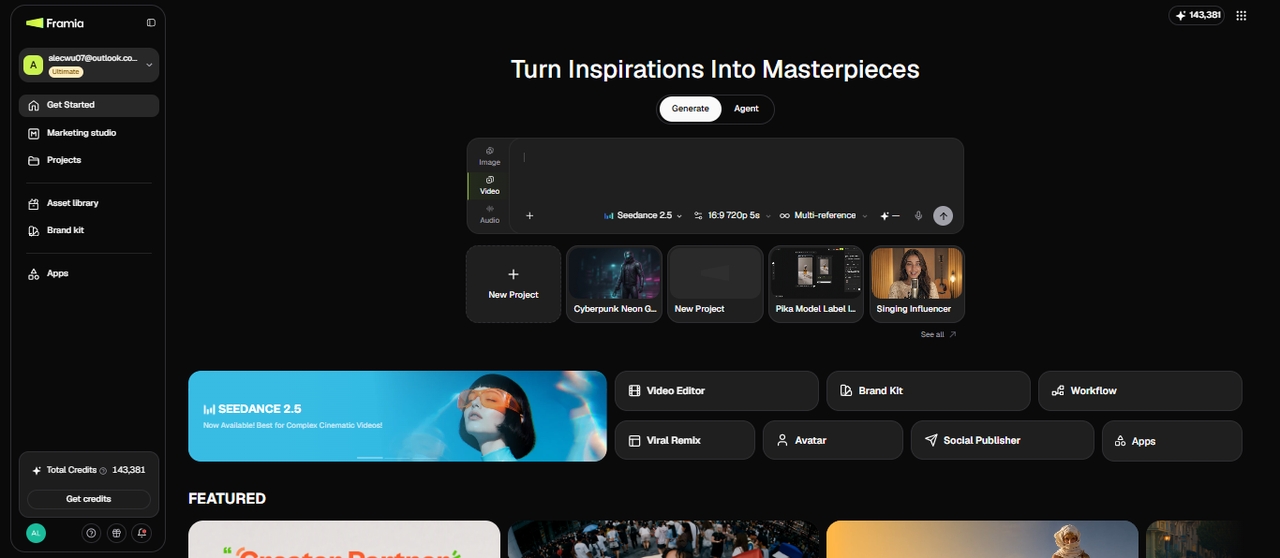
¿Qué trae Framia Pro a la mesa?
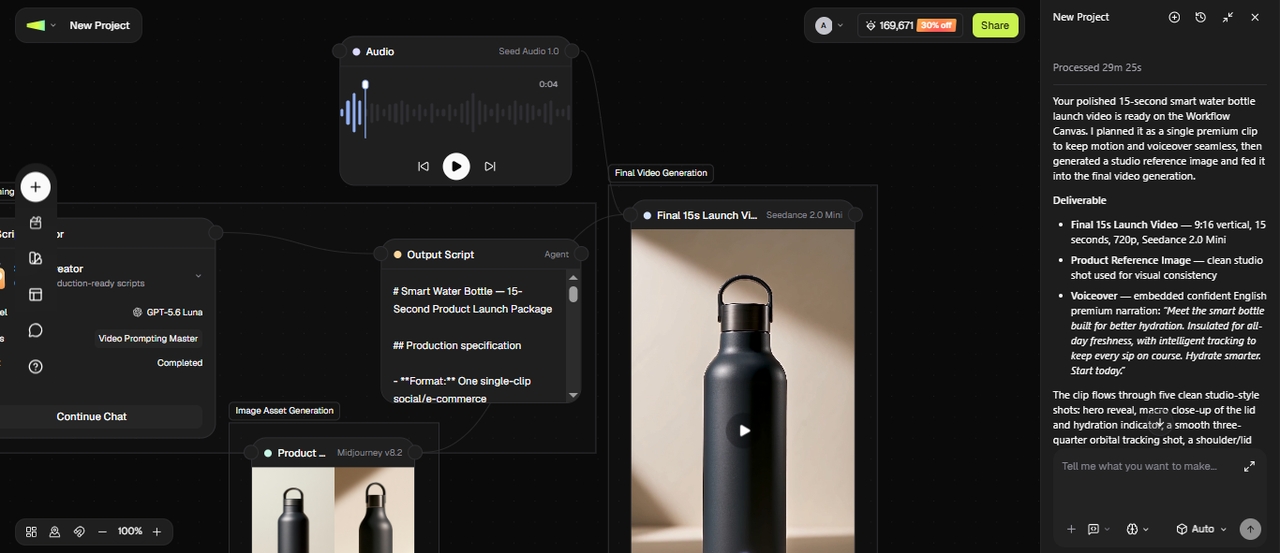
Intenté crear un video de lanzamiento de producto de comercio electrónico en el lienzo. Comencé con un agente de Imagen para generar tomas limpias del producto, las introduje en un nodo de Video que las convirtió en un clip de demostración con Kling o Seedance, luego dirigí el resultado a través de un nodo de Audio para una voz en off coincidente, todo dentro de un solo lienzo en lugar de cuatro herramientas separadas.
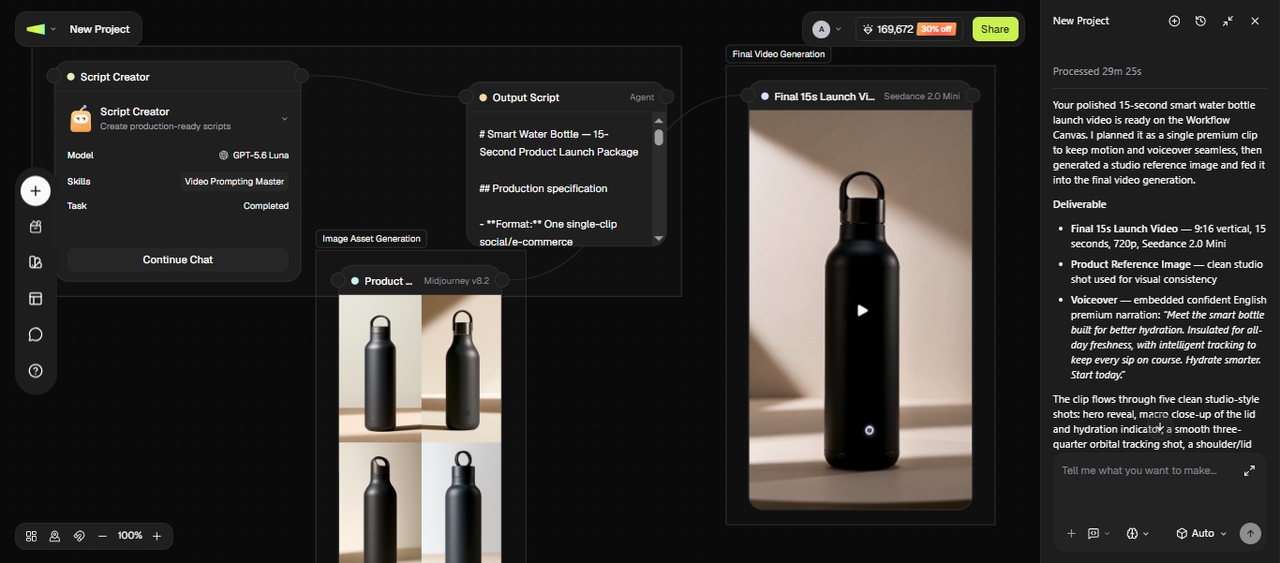
Aquí están las características que me ayudaron en el camino:
- Agentes dedicados de Imagen, Audio y Video: Utilicé el agente de Video para convertir instrucciones, guiones o imágenes en clips completos a través de los modelos anteriores, y los agentes de Imagen y Audio para miniaturas, voces en off y música cuando los necesitaba por separado.
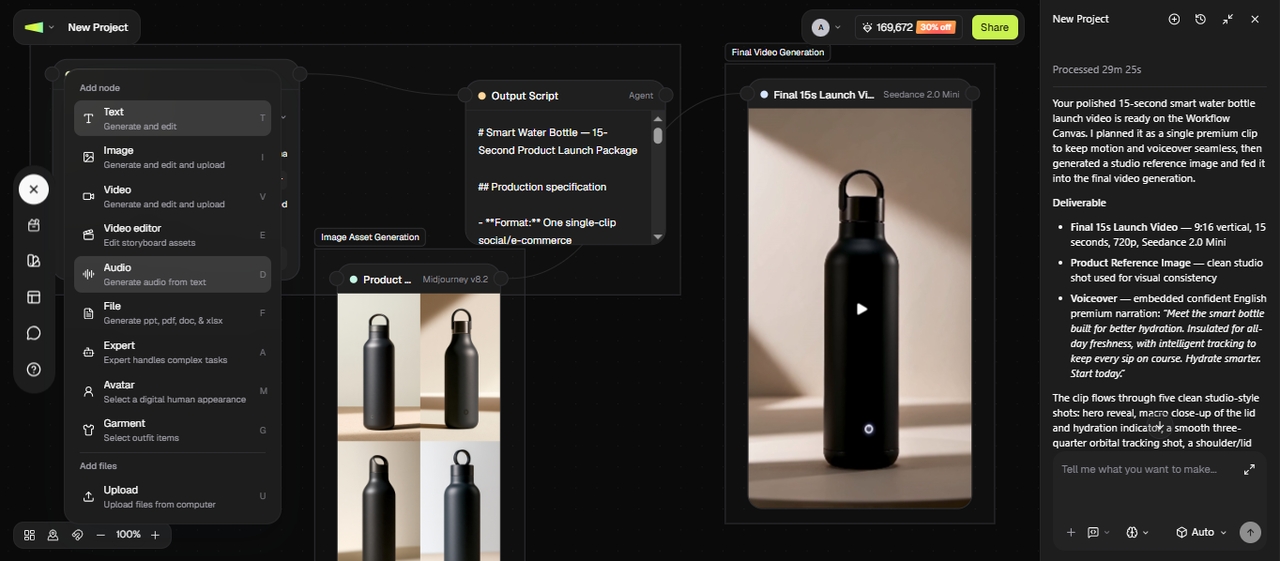
- Modificar el prompt y regenerar: Describí el cambio que quería en texto simple, y Framia Pro lo aplicó sin necesidad de una línea de tiempo o herramientas de edición manual. Ajusté escenas, corté partes y perfeccioné los elementos visuales sin ninguna experiencia previa en edición.
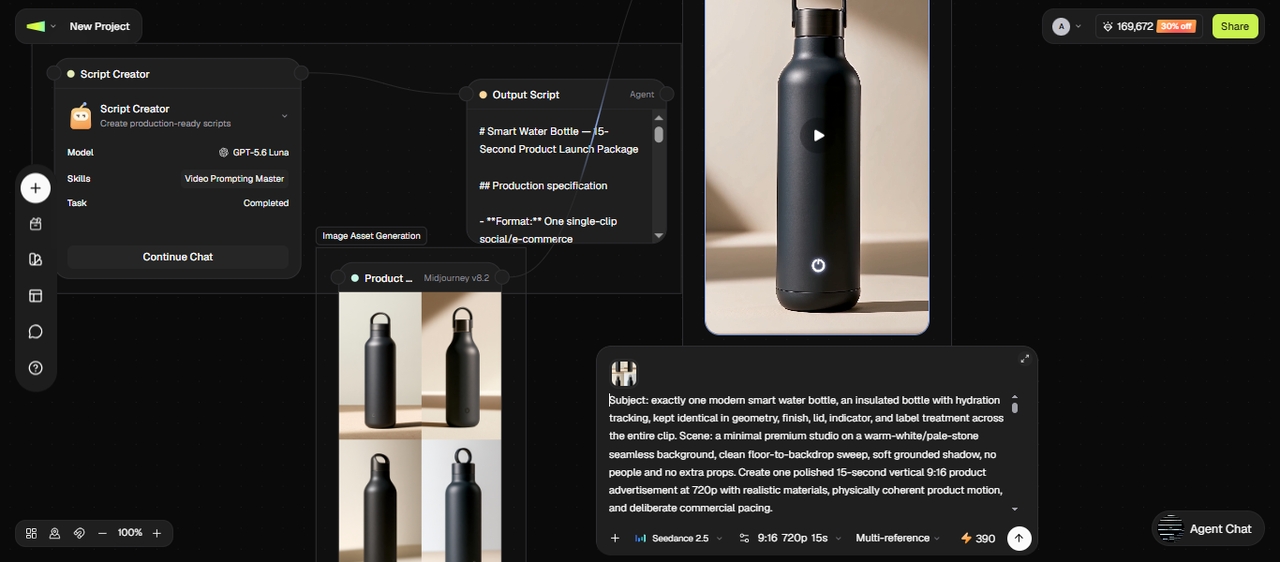
- Habilidades para guiones, revisión y reutilización: Convertí una idea general en un guion estructurado, pasé un video terminado por una revisión de ritmo y retención, y corté un video largo en varios clips más cortos listos para plataformas.
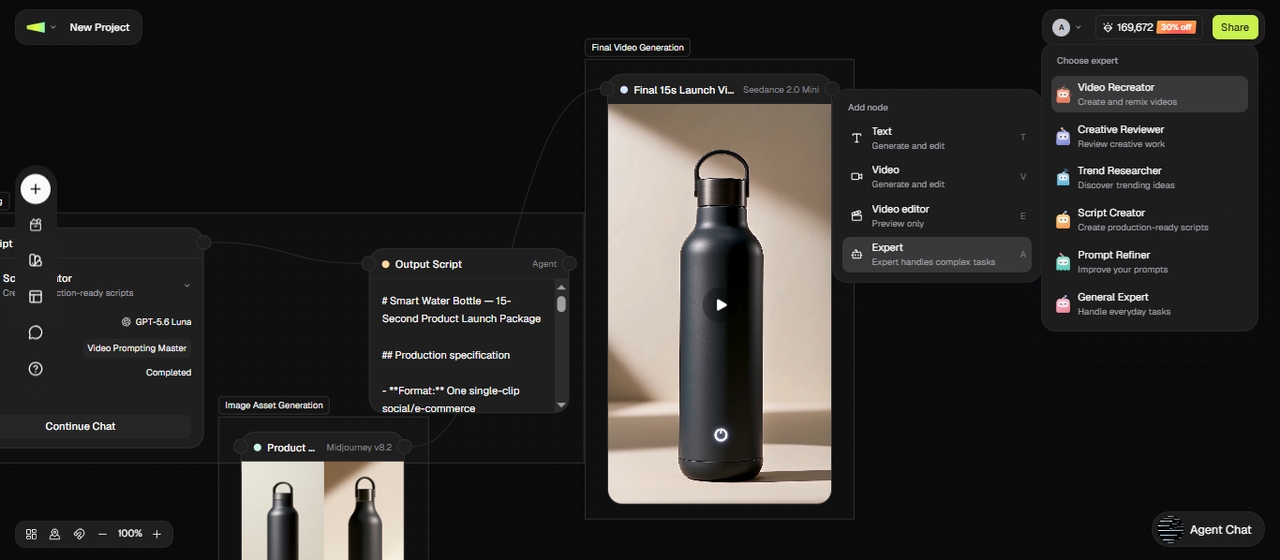
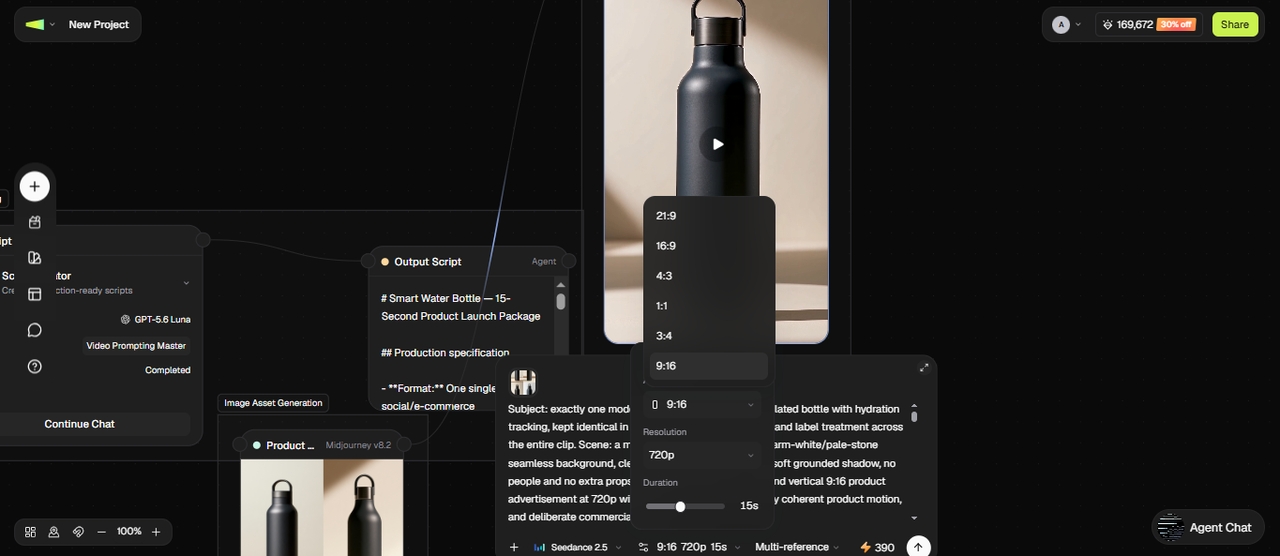
- Múltiples duraciones y relaciones de aspecto: Creé clips de diferentes duraciones para diferentes proyectos, en formato vertical, cuadrado o panorámico, de modo que mis versiones de TikTok, Instagram y YouTube estuvieran listas sin necesidad de cambiar el tamaño adicionalmente.
- Sincronizar audio con tus clips: Framia Pro sincroniza el sonido con los elementos visuales, de modo que el diálogo, la música o los efectos coincidan con el tiempo del video. Sincroniza el movimiento de los labios con el habla y alinea el audio con los cambios de escena, reduciendo los ajustes manuales de audio durante la edición.
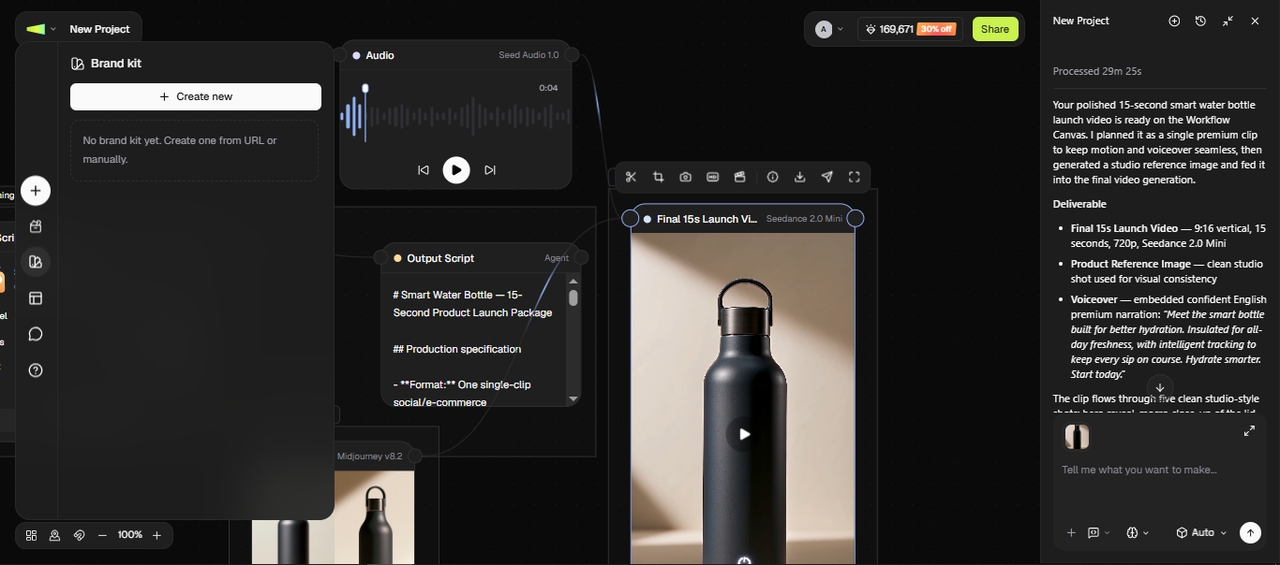
- Kit de marca: Guardé mis colores, fuentes y logotipo una vez, y luego los apliqué en cada video que generé desde cualquier modelo en el espacio de trabajo.
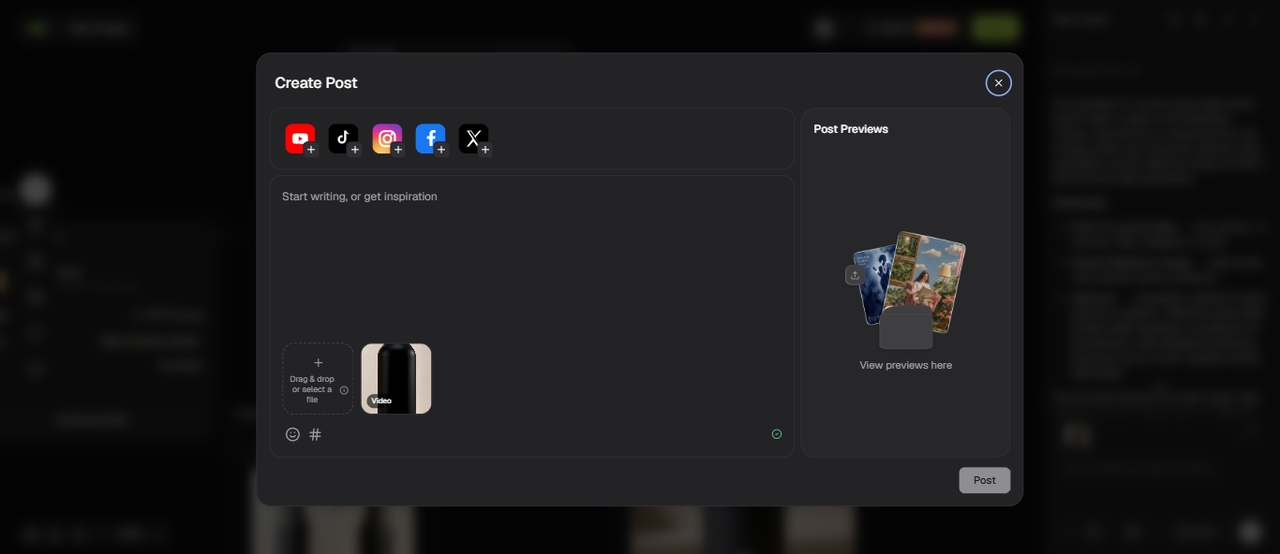
- Exportación directa desde Publisher: Envié un video terminado a TikTok directamente desde Framia Pro, sin un paso separado de descarga y carga.
Conclusión
En este artículo, exploramos qué son los modelos de generación de video de IA y revisamos 5 herramientas de código cerrado y 3 de código abierto que puedes usar para tu proyecto. Concéntrate en tu objetivo antes de elegir un modelo. Algunas herramientas se adaptan a clips rápidos para redes sociales, mientras que otras funcionan mejor para la narración de historias o escenas de alta calidad con sonido y detalle. Cuando adaptas el modelo a la tarea, tus resultados son más precisos y fáciles de gestionar. Si deseas acceder a varios de los mejores modelos de video de IA en un solo lugar, explora Framia Pro y cambia entre herramientas según lo que necesite tu proyecto.
Preguntas frecuentes
¿Cuáles son los mejores modelos de IA para la generación de video en este momento?
Algunos de los mejores modelos de IA para la generación de video incluyen Veo, Runway, Seedance 2.5, Kling y MiniMax H3. Cada uno se destaca en una fortaleza diferente, como el realismo, el movimiento, el audio o la facilidad de uso. En Framia Pro, puedes acceder a varios de estos modelos y cambiar según tu proyecto.
¿Qué está pasando con el modelo de video de Sora?
La noticia del modelo de video Sora reveló que recientemente ha sido descontinuado como aplicación de consumo y API en 2026. OpenAI decidió cerrarlo para enfocarse en otras áreas como la robótica y la investigación avanzada.
¿Hay generadores de video de IA de código abierto disponibles?
Sí, hay generadores de video de IA de código abierto disponibles como Wan, Mochi y HunyuanVideo. Puedes ejecutarlos localmente y ajustarlos según tus necesidades, aunque la configuración requiere conocimientos técnicos. Framia Pro ofrece una opción más sencilla si prefieres modelos listos para usar sin configuración local.
¿Pueden los modelos de video de IA crear videos largos?
La mayoría de los modelos de video de IA todavía se enfocan en clips cortos en lugar de videos de larga duración. Algunas herramientas permiten escenas más largas, pero a menudo requieren combinar múltiples clips. Framia Pro admite diferentes duraciones, por lo que puedes crear y administrar clips según tus necesidades.
¿Qué modelo de video de IA deberías usar?
Deberías elegir un modelo basado en tu objetivo y estilo de contenido. Veo funciona bien para escenas realistas, Kling maneja el movimiento y Seedance ofrece más control con múltiples entradas. El agente de video de Framia Pro te permite probar estos modelos en un solo lugar y elegir el que mejor se adapte a tu flujo de trabajo.
¿Cuesta dinero usar los modelos de generación de video de IA?
La mayoría sí, aunque los precios varían mucho. Algunos cobran por clip, mientras que otros funcionan con suscripciones mensuales con límites de créditos. Los modelos de código abierto como Wan o Mochi son gratuitos de ejecutar, pero necesitarás tu propio hardware de GPU.
¿Puedo usar videos generados por IA para proyectos comerciales?
Depende de la licencia del modelo y de tu nivel de suscripción. Los modelos Apache 2.0 como Wan 2.2, Mochi y HunyuanVideo permiten el uso comercial. Para herramientas de código cerrado como Veo, Runway o Kling, consulta los términos de uso comercial del plan específico antes de publicar videos generados en trabajos pagados o de marca.
¿Qué modelos de video de IA admiten audio nativo?
Varios modelos actuales generan audio en el mismo paso que el video en lugar de agregarlo después. Veo 3.1, Kling 3.0, Seedance 2.5 y MiniMax H3 admiten audio nativo, incluyendo diálogos, efectos de sonido y sonido ambiental vinculados a lo que sucede en la pantalla.