Les modèles de génération d'images open source ont ouvert un tout nouveau monde pour les créateurs, les développeurs et les entreprises. Vous pouvez désormais transformer du texte en images, modifier des photos, produire des vidéos et créer des objets 3D, sans dépenser une fortune en logiciels. Le secteur a connu une croissance rapide, avec plus de 90 000 modèles de texte-en-image disponibles uniquement sur Hugging Face. Passer à l'open source signifie aucun abonnement, un contrôle total sur vos données et la liberté d'ajuster les choses selon vos besoins. Ce guide présente les meilleurs modèles disponibles et tout ce dont vous avez besoin pour démarrer rapidement.
Que sont les modèles de génération d'images open source ?
Les modèles de génération d'images open source sont des programmes informatiques qui créent des images à partir de descriptions écrites. Vous saisissez ce que vous voulez voir, par exemple un coucher de soleil sur les montagnes, une maquette de produit, un personnage de dessin animé, et le modèle le produit sous forme d'image.
Pensez-y comme si vous embauchiez un artiste qui a étudié des millions de peintures, de photos et d'illustrations toute sa vie. Vous décrivez ce que vous voulez, et il le dessine pour vous en quelques secondes. Sauf que cet artiste ne dort jamais, ne facture jamais par projet et vit sur votre propre ordinateur.
Ce qui les rend « open source », c'est que le code est publiquement disponible. Tout le monde peut les télécharger, les utiliser, les modifier ou s'en inspirer gratuitement. C'est différent des outils payants comme Midjourney ou Adobe Firefly, où vous payez pour accéder au logiciel et n'avez aucun contrôle sur son fonctionnement interne.
Ces modèles sont entraînés sur des millions d'images, ce qui leur apprend à comprendre la relation entre les mots et les visuels. Au fil du temps, ils sont devenus assez performants pour produire des résultats de qualité professionnelle, et les meilleurs rivalisent désormais avec les options commerciales coûteuses.
Pourquoi choisir l'open source plutôt que des modèles d'images fermés ?
Les modèles d'images payants sont pratiques, mais ils s'accompagnent de réelles limites. Vous payez par image, confiez vos données à des serveurs tiers et n'avez pas votre mot à dire sur le fonctionnement du logiciel. Les modèles open source résolvent tout cela. Voici pourquoi de plus en plus de créateurs et de développeurs franchissent le pas.
- Contrôle total sur les résultats
Avec les outils fermés, la plateforme décide de ce que vous pouvez ou ne pouvez pas générer. Les modèles open source fonctionnent sur votre propre configuration, c'est donc vous qui fixez les règles. Vous obtenez exactement ce que vous demandez, sans filtres de contenu ni restrictions de plateforme pour vous gêner.
- Possibilité d'affiner les modèles
Les modèles fermés sont verrouillés et ne peuvent pas être modifiés pour répondre à vos besoins spécifiques. Cependant, vous pouvez entraîner davantage les modèles open source sur vos propres images, styles ou chartes graphiques. Cela signifie que le résultat commence à vous ressembler, et non à celui de tous les autres utilisateurs du même outil.
- Pas de coût par image
La plupart des outils commerciaux vous facturent pour chaque image générée, ce qui s'accumule rapidement. Mais avec les modèles open source, vous exécutez tout sur votre propre matériel et générez autant d'images que vous le souhaitez. Le seul coût est l'électricité et les machines qui font le travail.
- Confidentialité et utilisation hors ligne
Lorsque vous utilisez un outil basé sur le cloud, vos prompts et vos images transitent par les serveurs de quelqu'un d'autre. Les modèles open source peuvent fonctionner entièrement hors ligne, de sorte que rien ne quitte votre machine. Cela compte beaucoup pour les entreprises qui gèrent des projets sensibles ou du contenu propriétaire.
- Soutien d'une large communauté
Les modèles open source sont soutenus par des milliers de développeurs, de chercheurs et de créateurs à travers le monde. Ils partagent quotidiennement des versions affinées, des tutoriels, des plugins et des correctifs. Si vous rencontrez un problème, il est probable que quelqu'un dans la communauté l'ait déjà résolu.
Top 7 des modèles de génération d'images open source
Différents générateurs d'images IA open source se concentrent sur différentes forces telles que le réalisme, la vitesse, le contrôle de la structure ou la précision du texte. Vous trouverez ci-dessous sept modèles largement utilisés, chacun ayant un objectif clair.
| Modèle | Architecture | VRAM min. | Licence | Forces clés | Idéal pour |
| Stable Diffusion 3.5 | Diffusion latente (DiT) | 8 Go+ | Commerciale | Vaste écosystème, support LoRA, communauté active | Création générale, débutants, flux de travail basés sur des plugins |
| ControlNet 1.1 | Extension SD conditionnée | 8 Go+ | Apache 2.0 | Contrôle de pose, cartes de profondeur, guidage des contours | Cohérence des personnages, plans d'architecture, génération guidée |
| FLUX.2 | Transformer de mise en correspondance de flux (4B–32B) | 13 Go (4B) / 24 Go (32B) | BFL Commerciale | Référence multi-images, forte précision du prompt, rendu très rapide | Visuels de haute qualité, éléments de marque, contenu marketing |
| GLM-Image | Hybride AR + DiT (9B + 7B) | ~16 Go | Recherche / Personnalisée | Rendu de texte fort, prend en charge la typographie chinoise, édition + génération en un seul flux | Affiches, maquettes d'interface utilisateur, designs bilingues, infographies |
| Qwen-Image-2512 | Diffusion + modèle de langage de vision (20B) | ~16 Go | Apache 2.0 | Texte multilingue, édition RGBA par calques, support ControlNet | Flux de travail commerciaux, édition avancée, contenu multilingue |
| Waifu Diffusion | Stable Diffusion affiné (jeu de données anime) | 6 Go+ | CreativeML OpenRAIL | Style anime, visuels manga, rendus axés sur les personnages | Jeux, romans visuels, illustrations de style anime |
| Z-Image-Turbo | Transformer de diffusion distillé (6B) | 16 Go | Apache 2.0 | Très faible latence, prend en charge l'anglais + le chinois, traitement par lots | Applications en temps réel, pipelines à grande échelle, déploiement en périphérie (edge) |
- Stable Diffusion 3.5
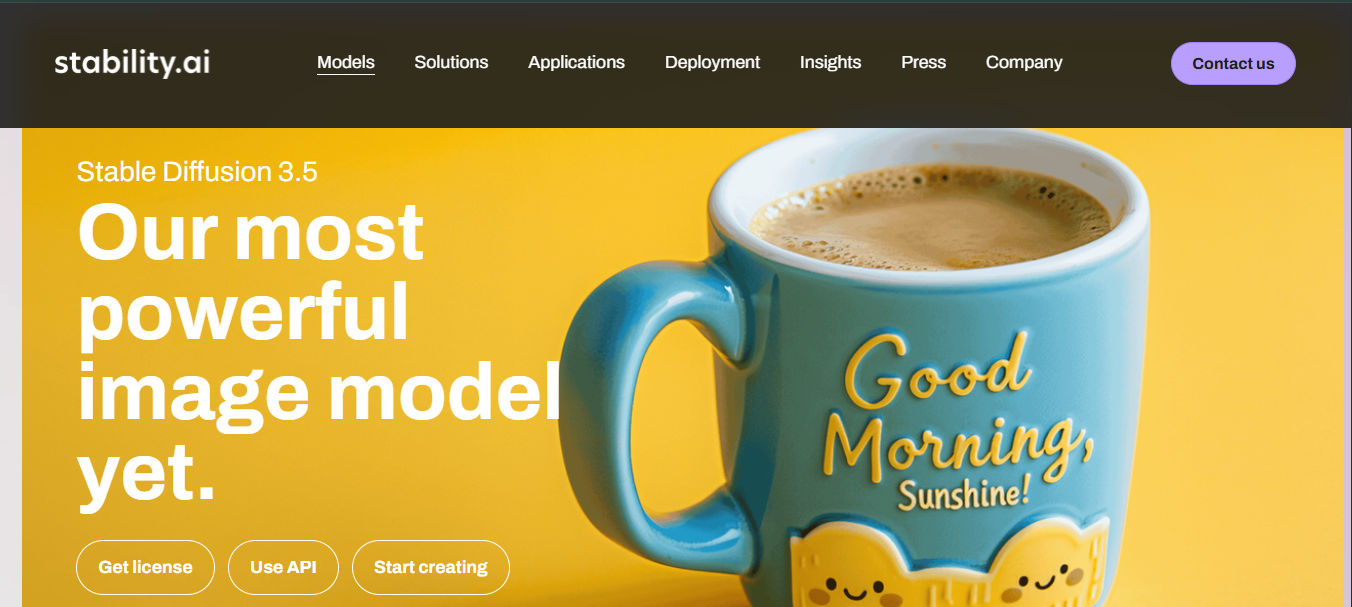
Stable Diffusion 3.5 est un modèle de texte-en-image de type Multimodal Diffusion Transformer (MMDiT) développé par Stability AI. Il améliore la qualité de l'image, la typographie, la compréhension des prompts et les performances globales. Le modèle est disponible en trois tailles, conçues pour différentes configurations matérielles et cas d'utilisation. Ce meilleur modèle pour générer des images reste l'un des modèles de génération d'images ouverts les plus largement utilisés, soutenu par une grande communauté de développeurs et de créateurs de contenu.
Fonctionnalités clés :
- Trois tailles de modèle: Large (8B paramètres), Large Turbo et Medium (~2,5B paramètres), chacun adapté à des besoins de performance et de matériel différents
- Sortie haute résolution: Le modèle Large prend en charge la génération d'images de haute qualité à une résolution d'environ 1 mégapixel
- Variante de génération rapide: Large Turbo produit des résultats de qualité en un petit nombre d'étapes
- Prise en charge du fine-tuning: Conçu pour la personnalisation avec une cohérence de prompt améliorée
- Licence d'utilisation flexible: Gratuit pour les particuliers et les petites entreprises, avec des licences d'entreprise pour les organisations plus grandes
- ControlNet 1.1
ControlNet est une structure de réseau de neurones qui contrôle les modèles de diffusion en ajoutant des conditions supplémentaires. Il copie les poids des blocs de réseau de neurones dans une copie verrouillée et une copie entraînable. La copie entraînable apprend votre condition, tandis que la copie verrouillée préserve le modèle original. Publié par le chercheur lllyasviel, il ne génère pas d'images par lui-même. Au lieu de cela, ce meilleur modèle d'image se superpose à Stable Diffusion et vous offre un contrôle structurel précis sur ce qui est généré.
Fonctionnalités clés :
- Plusieurs types de conditionnement : ControlNet prend en charge le contrôle via la détection de contours Canny, l'estimation de la profondeur Midas, la détection de contours doux HED, la détection de lignes M-LSD, les cartes de normales, la détection de poses humaines OpenPose et la segmentation sémantique.
- Contrôles composables : ControlNet prend en charge la combinaison de plusieurs ControlNets à la fois. Tous les modèles prêts pour la production sont testés de manière approfondie avec plusieurs ControlNets combinés, et la prise en charge officielle de Multi-ControlNet est disponible via le plugin A1111.
- Robustesse améliorée dans la v1.1 : ControlNet 1.1 ajoute un nouveau traitement des contours doux, plusieurs nouveaux préprocesseurs tels que Canny, Depth et Inpaint, et renforce la robustesse globale et la qualité d'image du modèle par rapport à la version 1.0.
- Édition basée sur des instructions : ControlNet 1.1 comprend un modèle entraîné sur le jeu de données Instruct Pix2Pix, entraîné à la fois avec des prompts d'instruction et des prompts de description.
- Série FLUX
La série FLUX est développée par Black Forest Labs et se concentre sur la génération d'images de haute qualité avec un fort alignement des prompts. Elle comprend plusieurs modèles conçus à la fois pour l'expérimentation et les flux de travail de production.
Fonctionnalités clés :
- Plusieurs variantes: Comprend FLUX.1 [schnell], [dev] et des outils spécialisés pour l'édition et le conditionnement.
- Édition d'images en contexte: Permet de modifier des images à l'aide d'instructions textuelles sans réentraînement.
- Outils d'édition dédiés: Comprend la prise en charge de l'inpainting d'image, de l'outpainting et du guidage structurel.
- Disponibilité des poids ouverts: Permet le déploiement local et la personnalisation.
- Options de déploiement flexibles: Prend en charge les API, les configurations locales et les environnements de test.
- GLM-Image
GLM-Image est un modèle de génération d'images qui adopte une architecture hybride de décodeur autorégressif et de diffusion. Il présente des avantages dans le rendu de texte et les scénarios de génération à forte intensité de connaissances, avec de solides capacités de génération de détails de haute fidélité et de précision. Développé par Zhipu AI, il est conçu pour des cas d'utilisation où d'autres modèles ont tendance à échouer, en particulier lorsque les images doivent inclure du texte lisible ou des mises en page denses en informations.
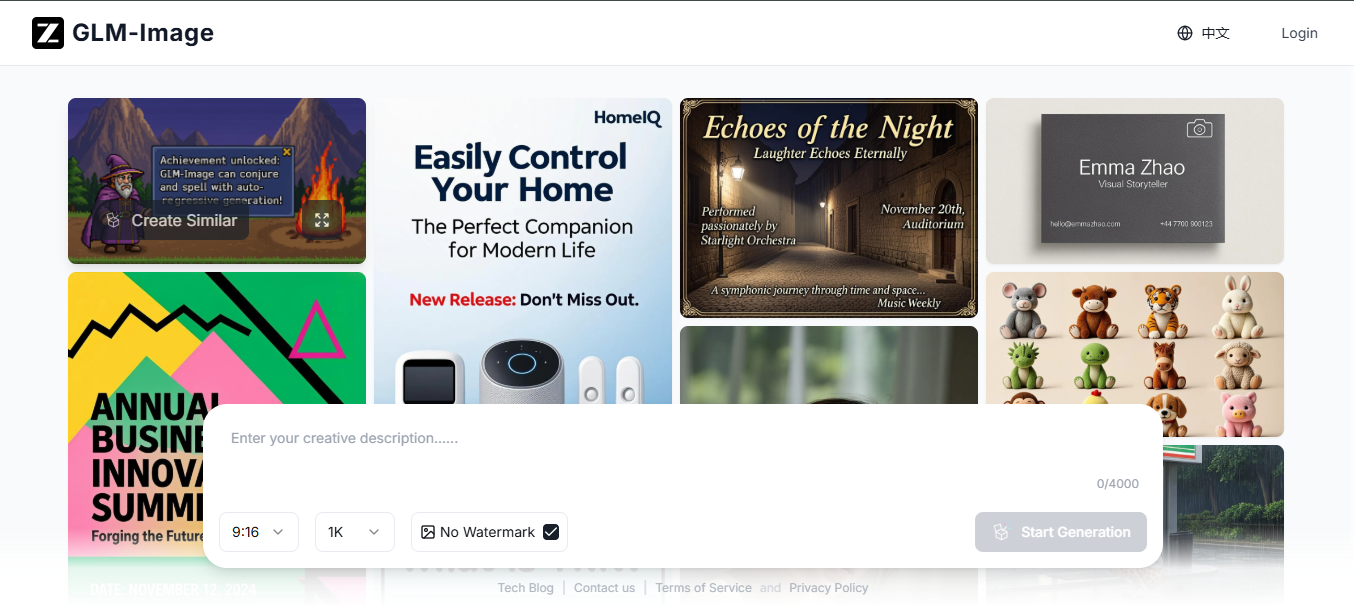
Fonctionnalités clés :
- Conception d'architecture hybride : combine le codage autorégressif avec le décodage par diffusion.
- Rendu de texte précis : produit du texte clair et lisible au sein des images.
- Prise en charge de mises en page complexes : fonctionne bien pour les affiches, les infographies et les visuels structurés.
- Génération et édition unifiées : gère à la fois les tâches de texte-à-image et d'image-à-image.
- Raffinement post-entraînement : utilise l'apprentissage par renforcement pour améliorer les détails et l'alignement.
- Qwen-Image-2512
Qwen-Image-2512 est la mise à jour de décembre du modèle de texte-à-image de Qwen-Image meilleur modèle de génération d'images open source, qui présente un réalisme humain amélioré, des détails naturels plus fins, ainsi qu'une précision et une qualité de rendu de texte améliorées. Il s'adresse directement aux cas d'utilisation d'entreprise et commerciaux où la qualité, la fiabilité et la clarté des licences importent.
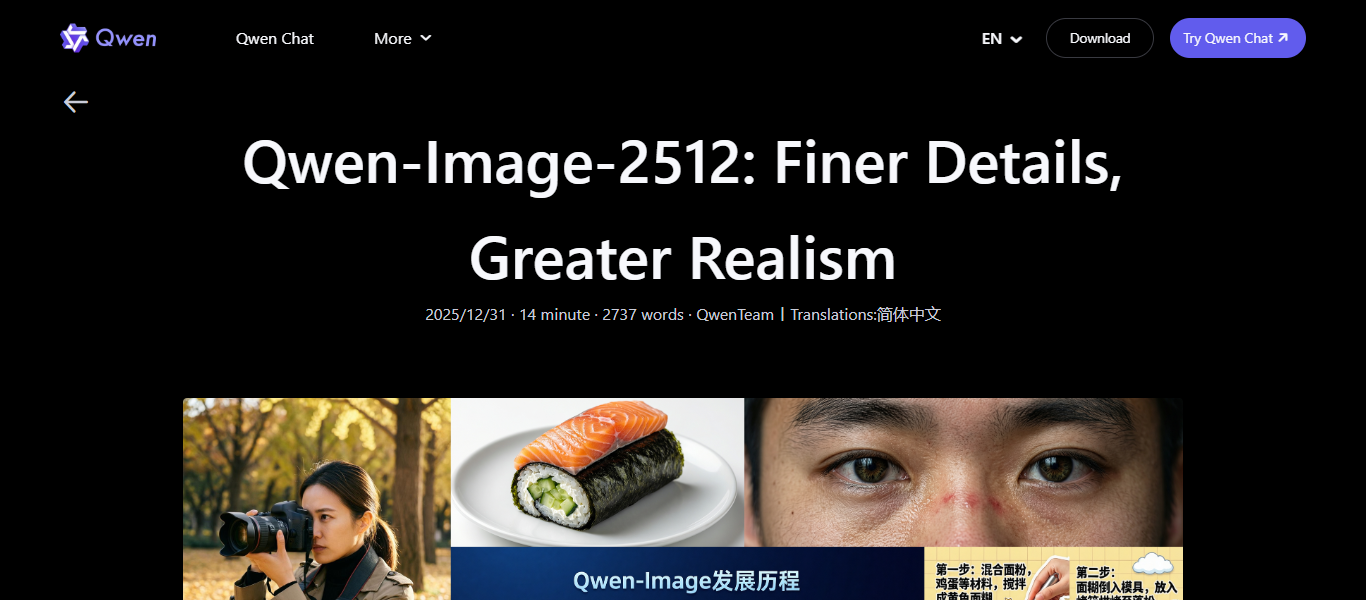
Fonctionnalité clé :
- Réalisme visuel amélioré : réduit l'aspect artificiel des images générées.
- Meilleure précision du texte : produit un texte intégré plus clair et des mises en page structurées.
- Génération de scènes détaillées : gère les environnements et les objets avec une plus grande clarté.
- Licence commerciale ouverte : publié sous licence Apache 2.0 pour une utilisation et une modification gratuites.
- Accès complet au modèle : disponible via des plateformes de modèles ouverts pour le déploiement.
- Waifu Diffusion
Waifu Diffusion est créé par Hakurei et se concentre sur la génération d'images de style anime. Il est entraîné spécifiquement sur des ensembles de données d'anime, ce qui lui permet de produire des conceptions de personnages cohérentes et des visuels stylisés. Il s'appuie sur Stable Diffusion et s'intègre directement dans son écosystème, ce qui le rend facile à utiliser pour les artistes déjà familiers avec ces outils.
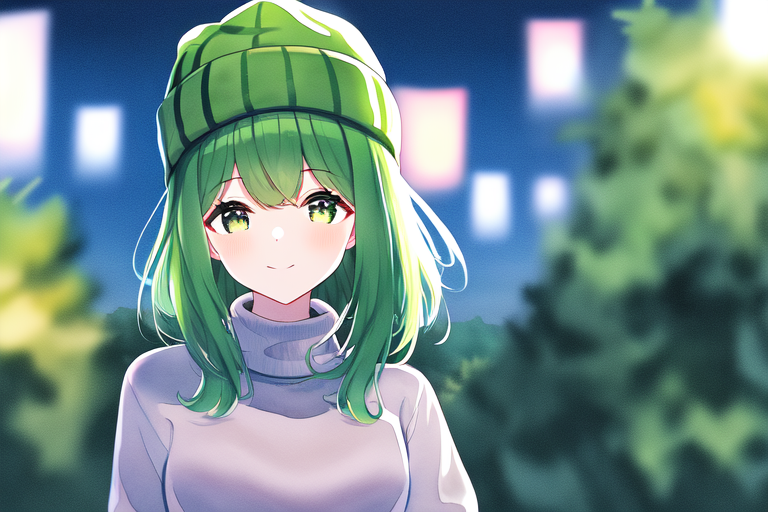
Fonctionnalités clés :
- Entraînement axé sur l'anime : le modèle est entraîné sur un large ensemble de données d'images d'anime, ce qui l'aide à apprendre les proportions des personnages, les expressions faciales et les éléments stylistiques courants dans l'art de l'anime.
- Qualité constante des personnages: Il maintient des traits du visage, des coiffures et des détails vestimentaires stables à travers différents prompts, ce qui est utile lors de la création du même personnage dans plusieurs scènes.
- Contrôle du style via les prompts: Vous pouvez guider le résultat en utilisant des balises et des styles de prompts couramment utilisés dans les communautés d'anime.
- Variante basée sur SDXL: La version la plus récente construite sur SDXL améliore la résolution, l'éclairage et les détails plus fins tout en préservant le style anime.
- Licence d'accès libre: Distribué sous CreativeML OpenRAIL-M, ce qui permet l'utilisation et la redistribution sous certaines conditions.
- Large soutien de la communauté: Un grand nombre de checkpoints pré-entraînés, de LoRAs et de packs de styles sont disponibles.
- Z-Image-Turbo
Z-Image-Turbo est développé par Tongyi-MAI. Il se concentre sur la vitesse et l'efficacité, ce qui le rend adapté aux applications nécessitant une génération rapide d'images. Il fait partie d'une famille de modèles compacts conçus pour fournir des résultats solides sans dépendre de très grandes architectures.
Caractéristiques clés :
- Vitesse de génération inférieure à la seconde : Z-Image-Turbo prouve qu'une performance de premier plan est réalisable sans dépendre de tailles de modèles énormes.
- Rendu de texte bilingue : Rend avec précision les textes complexes en chinois et en anglais, et démontre de solides compétences en composition et un bon sens de la typographie dans la conception d'affiches.
- Amélioration et raisonnement des prompts : Un outil d'amélioration des prompts intégré dote le modèle de capacités de raisonnement.
- Architecture à flux unique efficace : Z-Image-Turbo utilise une architecture DiT à flux unique évolutive (Scalable Single-Stream DiT) où le texte, les jetons sémantiques visuels et les jetons VAE d'image sont concaténés au niveau de la séquence en un flux d'entrée unifié.
Facteurs clés à considérer avant de choisir un modèle
Avant de vous engager, il y a quelques aspects pratiques qui valent la peine d'être vérifiés. Voici ce qu'il faut examiner et pourquoi cela compte.
- Qualité de l'image
La qualité de l'image dépend de l'aspect réaliste, détaillé et précis du résultat par rapport à ce que vous avez demandé. Certains modèles produisent des résultats réalistes tandis que d'autres sont plus stylisés. Le bon choix dépend de ce dont votre projet a réellement besoin.
- Vitesse (temps d'inférence)
Le temps d'inférence est le temps que prend le modèle pour produire une image. Si vous générez des centaines d'images par lot ou si vous créez un outil en temps réel, la vitesse compte beaucoup. Un modèle plus lent qui produit d'excellents résultats n'est pas toujours pratique.
- Exigences en VRAM
La VRAM est la mémoire que votre carte graphique utilise pour faire fonctionner le modèle. Les modèles plus grands en ont besoin de plus, parfois 16 Go ou plus. Si votre matériel ne répond pas à cette exigence, le modèle ne fonctionnera tout simplement pas, ou fonctionnera trop lentement pour être utile.
- Capacité de rendu de texte
Certains modèles gèrent bien le texte à l'intérieur des images, d'autres se trompent complètement. Si vos résultats incluent des panneaux, des affiches, des étiquettes ou tout autre contenu écrit, cela devient un facteur critique. Des modèles comme GLM-Image et Qwen-Image-2512 ont été conçus spécifiquement dans cette optique.
- Licences (commerciales vs restreintes)
Certains modèles sont gratuits pour un usage personnel ou de recherche, mais nécessitent une licence payante pour un travail commercial. D'autres comme Z-Image-Turbo et Qwen-Image-2512 sont entièrement ouverts sous Apache 2.0. Vérifiez toujours la licence avant d'utiliser un modèle dans un projet ou produit client.
- Écosystème et communauté
Une communauté forte signifie plus de tutoriels, de fine-tunes pré-intégrés, de plugins et des corrections plus rapides en cas de problème. Stable Diffusion, par exemple, dispose de milliers de ressources créées par la communauté. Un modèle plus récent ou plus de niche peut être impressionnant mais vous laisser avec très peu de support autour de lui.
Framia Pro : Votre option pour travailler avec des modèles non ouverts
Framia Pro est une plateforme créative d'IA qui vous permet de générer des images et des vidéos à l'aide de puissants modèles fermés de partenaires comme Google Gemini et d'autres moteurs avancés. Elle rassemble plusieurs modèles propriétaires dans un seul espace de travail afin que vous puissiez créer des visuels, modifier des conceptions d'images, et produire du contenu sans changer d'outils ni gérer des configurations complexes. Cela facilite la tâche des créateurs qui ont besoin de résultats provenant de modèles qui ne sont pas open source.
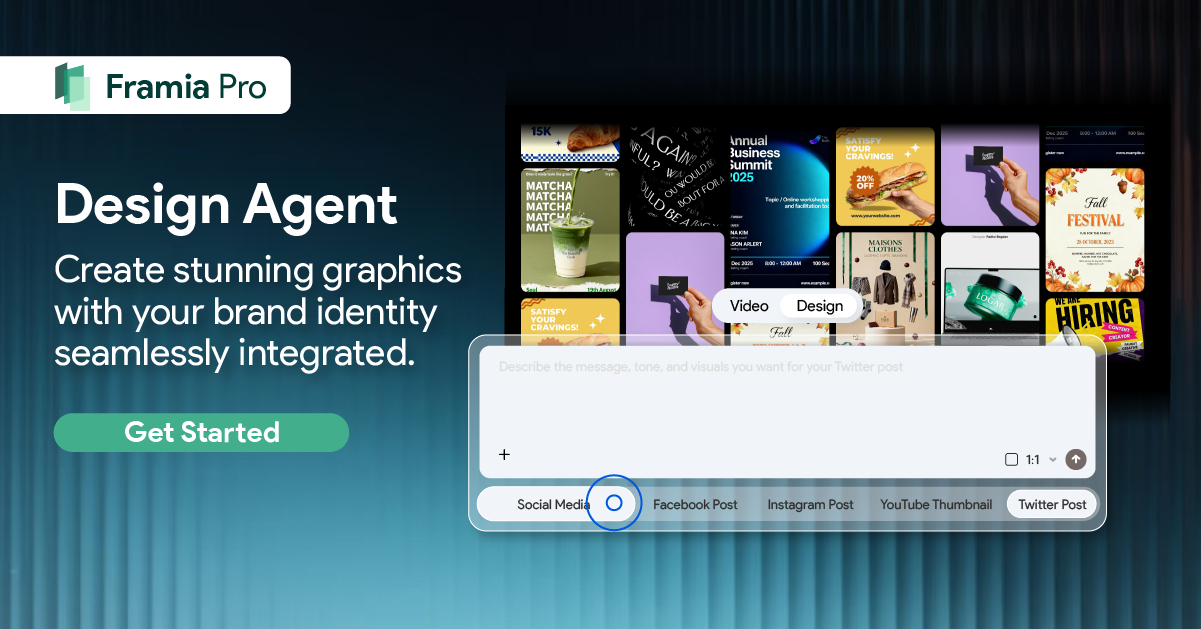
Fonctionnalités du générateur d'images Framia Pro
Framia Pro fournit un espace de travail unique où vous pouvez créer et modifier des images à l'aide de différents modèles d'images avancés. Chaque fonctionnalité est conçue pour vous donner le contrôle sur la façon dont les images sont générées et affinées.
- Plusieurs modèles d'images au choix
Framia Pro donne accès à Nano Banana Pro, Qwen Image, MidJourney v7, Flux Max et Seedream 4.5 au sein d'une seule plateforme. Vous pouvez basculer entre différents modèles en fonction du type de résultat souhaité, comme des visuels réalistes, des œuvres d'art stylisées ou des conceptions de concepts. Cette configuration élimine le besoin d'utiliser des outils distincts pour chaque modèle et permet une comparaison directe des résultats.
- Prend en charge n'importe quelle entrée
La plateforme accepte différents types d'entrées, notamment des invites textuelles, des images de référence et des entrées combinées. Vous pouvez décrire une scène en langage clair ou télécharger une image pour guider le résultat. De cette façon, vous pouvez contrôler la composition, la mise en page et les détails du sujet sans règles de formatage strictes.
- Modifier des images par chat
Framia Pro vous permet de modifier des images via une interface de chat. Vous pouvez décrire les changements dans des phrases simples, comme ajuster l'éclairage, supprimer des objets ou changer d'arrière-plan. Le système interprète vos instructions et applique les modifications directement à l'image.
- Fonctionne avec plusieurs styles
Vous pouvez générer des images dans différents styles visuels, allant des scènes réalistes aux illustrations, aux animés et aux designs abstraits. Vous pouvez gérer le style via des invites et la sélection du modèle. Cette fonctionnalité prend en charge les projets qui nécessitent un ton ou un thème visuel spécifique, tel que du contenu marketing, de l'art conceptuel ou des visuels pour les réseaux sociaux.
- Générer et traiter des images par lot
Framia Pro prend en charge le traitement par lot, ce qui vous permet de générer ou de modifier plusieurs images en une seule session. Vous pouvez soumettre plusieurs invites à la fois et recevoir des résultats sans répéter les mêmes étapes. Cela est utile pour créer variations d'un design, ce qui produit de grands ensembles d'actifs, ou pour tester rapidement différentes idées.
Comment générer des photos avec des modèles d'images sur Framia ?
Grâce à ces étapes, vous pouvez générer et affiner des images, des illustrations et des bannières à l'aide de Nano Banana Pro au sein de Framia Pro.
Étape 1 : Saisissez votre invite
- Ouvrez Framia Pro et commencez par une invite textuelle claire qui décrit la scène que vous souhaitez créer.
- Ajoutez des détails spécifiques tels que le sujet, l'arrière-plan, les couleurs, l'ambiance et les objets pour guider le résultat vers votre idée.
- Cliquez sur l'option "Plan" pour définir la disposition de la scène, la direction de l'éclairage et la composition globale avant le début de la génération.
- Activez l'option "Web" si vous souhaitez que le modèle utilise les données en direct de Google Search pour obtenir des résultats d'image plus sensibles au contexte.
Étape 2 : Générer l'image
- Sélectionnez n'importe quel modèle Pro parmi les modèles d'images disponibles sur la plateforme.
- Téléchargez plusieurs images pour guider la structure, le style ou la cohérence du sujet.
- Choisissez un format d'image adapté à votre cas d'utilisation, tel que carré, portrait, paysage, ou des résolutions de sortie allant jusqu'à 4K.
- Cliquez sur « Générer » pour créer l'image en fonction de votre prompt et de vos références.
Étape 3 : Modifier et exporter vers votre appareil
- Prévisualisez l'image générée et vérifiez la composition, l'éclairage et le placement des objets
- Utilisez des commandes basées sur le chat pour modifier des éléments tels que le remplacement d'objets, l'ajustement de l'éclairage ou le changement d'arrière-plan
- Demandez des modifications ciblées en décrivant les changements en texte brut au lieu d'utiliser des outils manuels
- Cliquez sur « Télécharger » pour exporter l'image finale vers votre appareil dans la résolution et le format sélectionnés
Conclusion
Dans cet article, nous avons exploré les 7 meilleurs modèles de génération d'images open source pour montrer comment différents outils gèrent la création d'images, les performances et la flexibilité. Chaque modèle offre ses propres forces dans des domaines tels que la qualité visuelle, la vitesse, les besoins matériels et la prise en charge de divers styles. Framia Pro rassemble plusieurs modèles en un seul endroit pour vous offrir plus d'options pour générer et modifier des images dans un flux de travail unique sans passer d'un outil distinct à un autre.
FAQ
- Quel générateur d'images IA open source est le plus souvent utilisé
Stable Diffusion reste l'un des générateurs d'images open source les plus largement utilisés en raison de sa communauté active et de sa large prise en charge d'outils. Dans Framia Pro, vous pouvez accéder à différents modèles d'images dans un seul espace de travail, ce qui élimine le besoin de configurer des environnements distincts pour chaque générateur et permet de basculer plus facilement entre les résultats.
- Quels modèles de génération d'images produisent une qualité visuelle supérieure
Les modèles plus récents, tels que ceux basés sur SDXL et la série Flux, génèrent souvent des textures plus claires, un meilleur éclairage et une meilleure composition. Framia Pro vous donne accès aux modèles Nano Banana Pro, Seedream 4.5, Flux Max, Qwen Image et Midjourney v7 pour vous permettre de créer des images instantanément.
- Quel modèle fonctionne le mieux pour la génération d'images sur du matériel limité
Les versions optimisées ou légères des modèles sont plus adaptées aux systèmes disposant d'une VRAM limitée. Framia Pro gère l'accès aux modèles sur le backend, vous pouvez donc exécuter des modèles plus lourds sans gérer de configuration locale, ce qui réduit le besoin de matériel haut de gamme de votre côté.
- Quels sont considérés comme les meilleurs modèles de génération d'images open source
Des modèles comme Stable Diffusion, Waifu Diffusion et les configurations basées sur ControlNet sont couramment utilisés pour différentes tâches telles que le réalisme, l'art anime et le contrôle structurel. Framia Pro rassemble ces options, vous permettant de sélectionner et de tester plusieurs modèles au sein d'un seul projet.
- Quels modèles d'images sont préférés pour les cas d'utilisation professionnels
Les flux de travail professionnels nécessitent souvent des résultats stables, des résultats cohérents et une prise en charge de l'édition. Framia Pro apporte de la valeur en proposant une édition d'images basée sur le chat et une génération par lots, ce qui vous permet d'affiner les images et de produire plusieurs variations en un seul endroit sans changer d'outil.