Bagikan


- Model generasi video AI mengubah prompt teks, gambar, atau klip saya menyimpan warna saya yang ada menjadi rekaman baru melalui proses difusi yang menyempurnakan noise acak langkah demi langkah hingga cocok dengan deskripsi Anda.
- Lima model closed-source memimpin saat ini, masing-masing dengan keunggulan berbeda: Veo 3.1 (audio asli), Runway Gen-4.5 (kontrol kreatif), Seedance 2.5 (klip sekali pengambilan yang panjang), Kling 3.0 (gerakan akurat secara fisika), dan MiniMax H3 (input multimodal terpadu).
- Wan 2.2, Mochi, dan HunyuanVideo memberi Anda lebih banyak kontrol dan tanpa batas penggunaan, tetapi Anda memerlukan perangkat keras yang lebih kuat dan waktu penyiapan.
- Framia Pro menyatukan beberapa model ini ke dalam satu dasbor, sehingga Anda dapat beralih di antaranya tanpa harus repot dengan login dan langganan yang terpisah.
Apa itu model generasi video AI?
Model generasi video AI adalah sistem yang membuat video dari prompt, gambar, atau klip yang ada, tanpa melibatkan kamera atau kru.
Mereka belajar dari kumpulan data yang sangat besar, jutaan klip video yang dipasangkan dengan deskripsi, dan menangkap pola visual yang menghubungkan frasa seperti "seekor anjing berlari menembus salju" dengan tampilan sebenarnya di layar.
Teknik di baliknya disebut difusi. Model dimulai dengan noise acak dan membersihkannya selama puluhan langkah hingga video muncul. Selama pelatihan, model melihat video nyata rusak menjadi noise dan belajar membalikkan proses tersebut. Pada saat pembuatan, prompt Anda mengarahkan setiap langkah pembersihan menuju adegan yang Anda deskripsikan.
Bagian yang sulit bukanlah satu frame. Model ini menjaga ratusan frame tetap konsisten satu sama lain. Wajah, pakaian, atau bayangan harus tetap stabil di seluruh klip, tidak hanya terlihat benar secara terpisah.
Model video memproses seluruh urutan frame secara bersamaan sehingga setiap frame dapat merujuk ke frame lainnya, itulah sebabnya pembuatan video membutuhkan komputasi yang jauh lebih besar daripada satu gambar.
Apa saja jenis-jenis model AI video?
Sebelum saya mulai menguji, saya harus memilah jenis alat apa yang sebenarnya saya gunakan, karena tidak setiap pembuat video AI memulai dari titik yang sama.
Model AI teks-ke-video
Model teks-ke-video mengubah deskripsi tertulis menjadi adegan bergerak dari awal. Anda menulis apa yang Anda inginkan, dan model membangun visualnya. Ini paling cocok ketika Anda memiliki ide tetapi tidak memiliki rekaman atau gambar referensi untuk memulai, seperti konsep produk, ketukan cerita pendek, atau sebuah adegan.
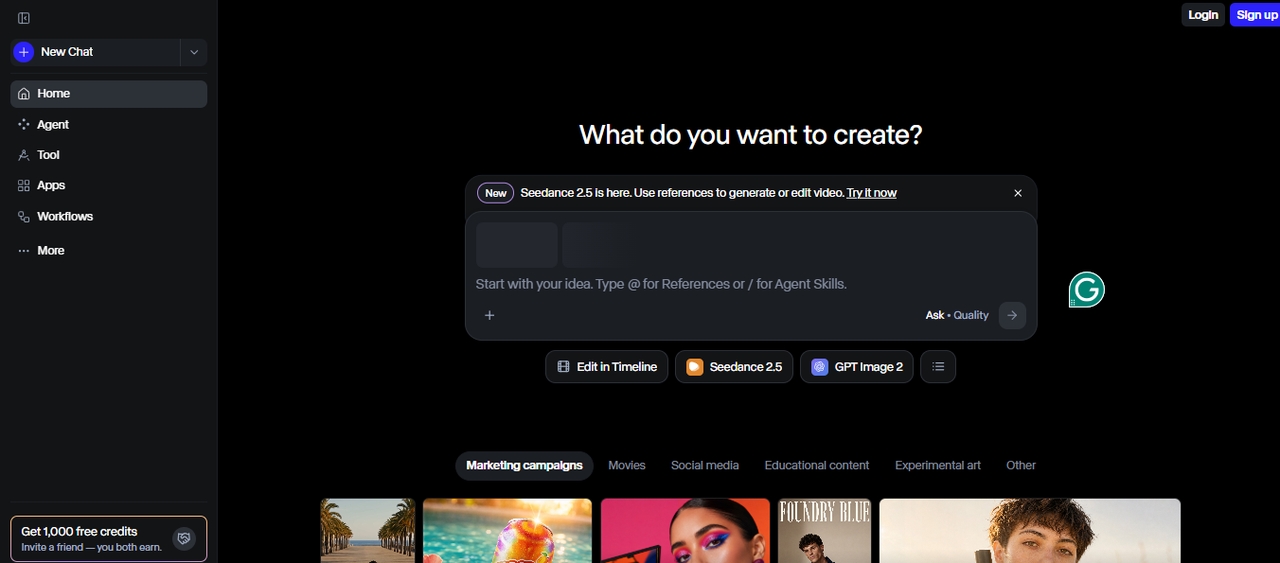
Model gambar-ke-video
Model gambar-ke-video mulai dari gambar yang sudah Anda miliki dan menambahkan gerakan, gerakan kamera, atau perubahan kecil untuk menghidupkannya. Ini cocok untuk demo produk dan postingan sosial di mana Anda menginginkan gerakan cepat tanpa membuat semuanya dari nol.
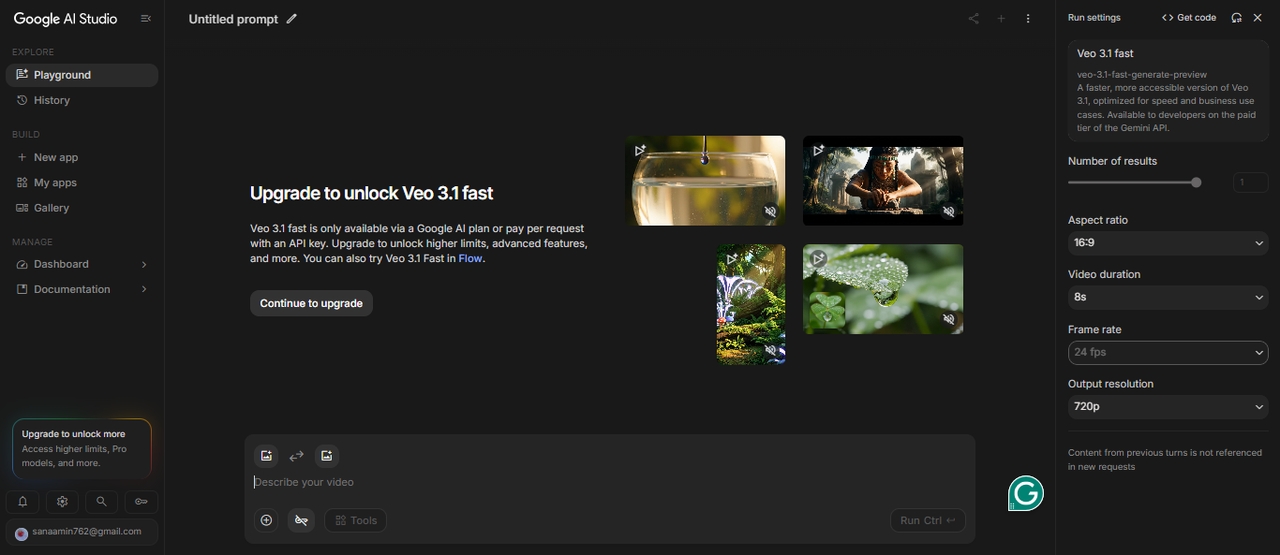
Model video multimodal
Model-model ini bekerja dengan lebih dari satu jenis input pada saat yang sama. Anda dapat mencampur teks, gambar, audio, dan bahkan klip video yang ada untuk memandu hasil akhir.
Ini memberi Anda lebih banyak kontrol atas bagaimana hasil video tersebut. Anda tidak hanya mendeskripsikan sebuah adegan, Anda membentuknya dengan beberapa input. Kontrol tersebut membantu ketika Anda menginginkan detail spesifik, penceritaan yang lebih lancar, atau video yang mengikuti arah yang jelas.
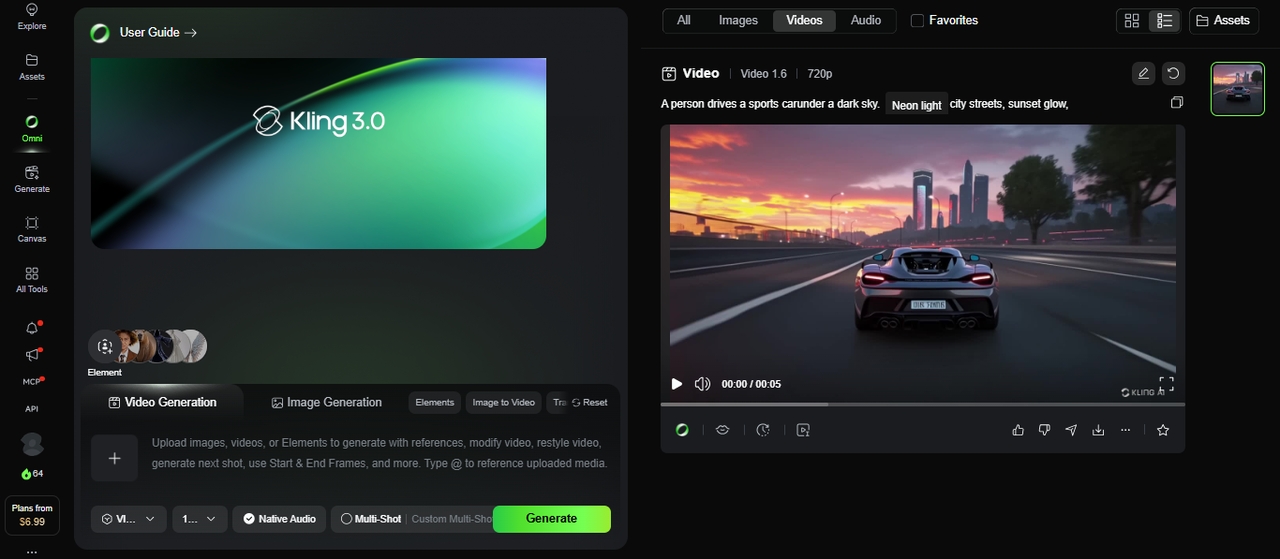
Bagaimana kami menguji setiap model
Saya seorang spesialis strategi konten yang telah menghabiskan dua tahun terakhir menguji alat kreatif AI untuk mencari nafkah, dan saya menjalankan setiap model generasi video AI melalui lima prompt yang sama yang mencakup demo produk, adegan naratif pendek, klip talking-head, urutan aksi, dan karya seni bergaya.
Untuk setiap model, saya menghasilkan setidaknya tiga output per prompt dan menilai mereka berdasarkan realisme, akurasi gerakan, kepatuhan terhadap prompt, dan kualitas audio jika berlaku.
8 model generasi video AI, dan apa yang paling baik dilakukan masing-masing
Setelah menguji delapan model generasi video AI pada demo produk, adegan naratif, klip talking-head, sekuens aksi, dan visual bergaya, saya menemukan bahwa tidak ada satu pun model yang berkinerja terbaik di setiap kategori. Veo 3.1 menonjol untuk audio bawaan, Runway Gen-4.5 untuk kontrol kreatif dan konsistensi adegan, dan Seedance 2.5 untuk klip sekali jalan yang lebih panjang. Kling 3.0 adalah pilihan kuat untuk adegan dengan banyak gerakan, sementara MiniMax H3 menangani input campuran dan audio yang disinkronkan. Wan 2.6, Mochi, dan HunyuanVideo menawarkan alternatif bagi pengguna yang lebih menyukai model open-weight dan alur kerja lokal, meskipun persyaratan perangkat keras dan pengaturan dapat menjadi faktor pembatas.
Hasil ini didasarkan pada pengujian langsung saya, bukan peringkat universal. Pilihan terbaik bergantung pada jenis video Anda, persyaratan output, anggaran, dan apakah Anda lebih menyukai layanan terpandu (hosted service) atau model yang dapat Anda jalankan sendiri.
Di bawah ini, saya menguraikan kekuatan, fitur, kelebihan, dan kekurangan dari masing-masing model untuk membantu Anda memilih model yang tepat untuk proyek Anda.
Di bawah ini adalah model-model closed-source teratas yang perlu Anda ketahui saat ini.
| Fitur | Veo 3.1 | Runway Gen-4.5 | Seedance 2.5 | Kling 3.0 | MiniMax H3 |
| Resolusi Maksimal | 1080p | 1080p | 1080p bawaan | 4K / 60fps, model pertama yang mencapai 4K bawaan pada 60fps | 2K pada 24fps, 768p juga tersedia |
| Durasi Klip Maksimal | 8 detik secara bawaan, dapat diperpanjang melalui alat pihak ketiga | Hingga 16 detik pada Gen-4 | Hingga 30 detik dalam satu pengambilan gambar berkelanjutan | Hingga 2 menit, dapat diperpanjang hingga 3 menit | 5–15 detik, dapat diperpanjang hingga 30 dengan alat Extend bawaan |
| Frame Rate | 24–30fps | 24fps | Belum dipublikasikan | 30fps | 24fps |
| Audio Bawaan | ✅ Dialog, SFX, ambien | ✅ Ditambahkan Des 2025 | ✅ 10+ bahasa | ✅ | ✅ Stereo bawaan |
| Input Multimodal | ✅ Hingga 3 referensi gambar | ❌ | ✅ Hingga 50 referensi, 30 gambar, 10 video, 10 audio | ✅ Teks, gambar, audio, video | ✅ Teks, gambar, video, dan audio dibaca sebagai satu konteks |
| Multi-Shot | ❌ | ✅ | ✅ Sekali pengambilan gambar berkelanjutan, tanpa penyambungan | ✅ Hingga 6 shot | ❌ |
| Mesin Fisika | ✅ | ❌ | Tidak ditentukan | ✅ | Tidak ditentukan |
| Mode Cepat / Draf | ✅ Veo 3 Fast | ✅ Gen-4 Turbo | Belum dipublikasikan | ✅ Hingga 20x lebih cepat | ✅ Opsi 768p yang lebih ringan |
| Rasio Aspek | 16:9 dan 9:16 | 16:9, 9:16, 1:1 | Belum dipublikasikan | 16:9, 9:16, 1:1 | 21:9, 16:9, 4:3, 1:1, 3:4, 9:16 |
| Tingkat Gratis | ❌ | ❌ | Mulai diluncurkan di Jimeng AI, Doubao, Dreamina | ✅ 66 kredit harian | Melalui aplikasi Hailuo AI |
| Terbaik Untuk | Realisme + audio | Kontrol sinematik | Klip sekali ambil yang panjang + referensi | 4K + format panjang | Pengeditan multimodal + konsistensi |
- Veo 3.1
Veo 3.1 adalah model generasi video unggulan dari Google, dan audio adalah aspek yang membedakannya dari pengujian saya yang lain. Model ini menghasilkan dialog, efek suara, dan audio ambien dalam proses yang sama dengan video, semuanya dari satu prompt. Model ini menjadi mesin di balik gelombang klip viral di berbagai platform sosial setelah diluncurkan pada Oktober 2025, dan keterkaitannya dengan Google Workspace membuatnya mudah cocok untuk bagian alur kerja saya yang sudah ada di ekosistem tersebut.
Fitur
- Audio bawaan: dialog, SFX, dan suara ambien dalam satu proses.
- Resolusi 4K: output hingga definisi ultra-tinggi.
- Multi-referensi: mendukung hingga 3 gambar referensi.
- Durasi panjang: menghasilkan output hingga satu menit penuh.
- Dialog prompt: tulis ucapan karakter secara langsung di prompt Anda.
Kelebihan
- Kualitas audio bawaan yang tiada tanding.
- Realisme dan akurasi pencahayaan yang sangat baik.
- Integrasi ekosistem Google yang mendalam.
- Akurasi prompt yang kuat.
Kekurangan
- Video dengan tanda air (watermark) pada paket yang lebih rendah.
- Kurang fleksibel untuk konten bergaya atau non-realistis.
- Runway Gen-4.5
Runway telah menjadi bagian penting dalam model video AI generatif selama bertahun-tahun, dan Gen-4.5, yang dirilis pada akhir tahun 2025, adalah model di mana saya melihat peningkatan kualitas dan pengurutan multi-shot yang paling jauh. Antarmuka obrolannya memungkinkan saya menyempurnakan video dengan menjelaskan perubahan dalam percakapan alih-alih menulis ulang prompt dari awal. Dari semua yang saya uji, ini adalah model yang akan saya rekomendasikan kepada profesional kreatif ketika konsistensi adegan dan karakter sangat penting di beberapa shot.
Fitur
- Motion brushes: lukis bagian mana saja dari adegan yang harus bergerak secara tepat.
- Multi-shot: rangkai beberapa klip menjadi satu urutan yang kohesif.
- Act-one: ekspresi wajah dan penangkapan gerak.
- Chat editing: sempurnakan hasil melalui percakapan alami.
- Output 4K: ekspor resolusi ultra-tinggi.
Kelebihan
- Konsistensi adegan dan karakter terbaik di kelasnya.
- Kontrol kreatif yang kuat untuk para profesional.
- Komunitas dan ekosistem yang kuat.
Kekurangan
- Mahal pada tingkatan yang lebih tinggi.
- Lebih lambat dibandingkan beberapa pesaing untuk konten sosial cepat.
- Kurva pembelajaran yang lebih curam untuk pemula.
- Seedance 2.5
Seedance 2.5 adalah kelanjutan dari ByteDance untuk Seedance 2.0, yang telah memuncaki Artificial Analysis Video Arena untuk text-to-video dan image-to-video di awal tahun 2026. Versi baru ini memperpanjang pembuatan sekali jalan dari 15 detik menjadi 30 detik penuh, meningkat ke 1080p asli, dan menerima hingga 50 referensi multimodal (campuran gambar, video, dan audio) dalam satu pembuatan, naik dari 12 pada versi sebelumnya. Versi ini juga menambahkan audio asli dalam lebih dari 10 bahasa, dan saya mengujinya saat diluncurkan di Jimeng AI, Doubao, dan Dreamina, dengan akses API yang hadir melalui BytePlus ModelArk.
Fitur
- Pembuatan sekali jalan yang diperpanjang: hingga 30 detik dalam satu klip berkelanjutan, tidak memerlukan penyambungan.
- 1080p Asli: meningkat dari 720p pada versi sebelumnya.
- Dukungan referensi yang diperluas: hingga 50 referensi multimodal (30 gambar, 10 video, 10 audio) dalam satu pembuatan.
- Audio multibahasa asli: dialog dan suara dalam lebih dari 10 bahasa.
- Pengeditan presisi: tukar produk, perpanjang bidikan, atau lakukan pengeditan terarah tanpa membuat ulang seluruh klip.
- Previsualisasi model-putih 3D: atur pergerakan kamera dan bidikan sebelum melakukan pembuatan penuh.
Kelebihan
- Klip satu pengambilan (single-take) yang panjang berfungsi dengan baik untuk drama berdurasi pendek dan konten bersambung.
- Kontinuitas kamera dari bidikan ke bidikan yang kuat di seluruh pengambilan gambar penuh berdurasi 30 detik.
- Jumlah referensi yang diperluas memberikan kontrol lebih besar atas konsistensi karakter dan produk.
Kekurangan
- ByteDance belum menerbitkan laporan teknis lengkap, sehingga beberapa spesifikasi berasal dari demo peluncuran alih-alih pengujian independen.
- Akses API penuh belum aktif di semua tempat pada saat pengujian.
- Kling 3.0
Kling 3.0 diluncurkan pada 4 Februari 2026, dan dalam hitungan hari disebut sebagai lompatan terbesar dalam pembuatan video AI tahun ini. Model ini berjalan pada arsitektur Omni One yang menggabungkan 3D Spacetime Joint Attention dengan penalaran chain-of-thought, yang membuatnya berhasil menampilkan gravitasi, keseimbangan, deformasi, dan inersia agar terlihat nyata alih-alih seperti karet dalam pengujian saya. Model ini menerima input multimodal berupa teks, gambar, audio, dan video, serta menghasilkan audio asli dalam bahasa Inggris, Mandarin, Jepang, Korea, dan Spanyol, dengan kontrol atas dialog karakter dan urutan berbicara.
Fitur
- Fisika Omni One: simulasi gravitasi, tabrakan, dan inersia yang nyata.
- Audio asli: sulih suara, sinkronisasi bibir, SFX, dan musik.
- Papan cerita multi-bidik: hingga 6 bidikan dengan kontrol kamera tingkat sutradara.
- Mode draf: menghasilkan hingga 20x lebih cepat untuk pembuatan prototipe cepat.
- Output 4K/60fps: dengan ekspor HDR 16-bit dan EXR.
- Editor 7-in-1: penambahan objek, pertukaran latar belakang, transfer gaya dalam satu alat.
Kelebihan
- Fisika dan gerakan manusia paling realistis yang tersedia.
- Audio multibahasa asli dengan kontrol dialek dan aksen.
- Biaya masuk yang terjangkau sebesar $7,99/bulan dengan tingkat gratis yang andal.
- Mengekspor langsung ke alur kerja VFX profesional (Nuke, After Effects, DaVinci).
Kekurangan
- Perenderan multi-bidik berdurasi 15 detik dapat memakan waktu lebih dari 5 menit.
- Output 4K saat ini terbatas pada paket tingkat yang lebih tinggi.
- Periode permintaan tinggi memperpanjang antrean render.
- MiniMax H3
MiniMax H3, juga dikenal sebagai Hailuo 3.0, mengikuti Hailuo 02 dalam jajaran video MiniMax. Alih-alih memperlakukan referensi teks, gambar, video, dan audio sebagai input terpisah, model ini membaca semuanya bersama-sama sebagai satu konteks bersama, lalu menghasilkan video dan audio yang disinkronkan dalam satu hasil tunggal. MiniMax menyatakan berencana untuk merilis bobot modelnya, meskipun saya mengaksesnya melalui aplikasi Hailuo AI, API MiniMax Open Platform, dan mitra hosting seperti fal.
Fitur
- Konteks multimodal terpadu: referensi teks, gambar, video, dan audio diselesaikan bersama dalam satu pembuatan.
- Audio stereo bawaan: dialog, musik, efek, dan suasana dihasilkan bersama dengan video, bukan ditambahkan setelahnya.
- Resolusi hingga 2K pada 24fps, dengan 768p juga tersedia sebagai opsi yang lebih ringan.
- Pembuatan berdurasi 5 hingga 15 detik, dapat diperpanjang hingga 30 detik dengan alat Extend Video bawaan.
- Pengeditan tertarget: tukar atau hapus karakter dan objek, ubah pencahayaan atau latar belakang, atau revisi dialog tanpa mengulang seluruh klip.
- Beberapa rasio aspek: 21:9, 16:9, 4:3, 1:1, 3:4, dan 9:16.
Kelebihan
- Konsistensi temporal yang kuat; gerakan tetap stabil di sepanjang klip alih-alih bergeser di tengah jalan.
- Audio stereo bawaan keluar dari proses pembuatan yang sama, tanpa langkah suara terpisah.
- Dukungan rasio aspek lebar cocok untuk semuanya, mulai dari layar lebar sinematik hingga konten sosial vertikal.
Kekurangan
- MiniMax belum menerbitkan laporan teknis lengkap, sehingga beberapa klaim berasal dari perusahaan alih-alih tolok ukur independen.
- Menjalankan versi open-weight secara lokal membutuhkan GPU kelas atas dengan VRAM 24GB+ setelah bobotnya dirilis.
| Fitur | Wan 2.2 | Mochi 1 (Genmo) | HunyuanVideo (Tencent) |
| Parameter | 1.3B / 14B | 10B | 13B |
| Resolusi Maksimum | 720p (1080p pada 14B) | 480p (640x480) | 720p (1080p dengan v1.5) |
| Panjang Klip Maksimum | Hingga 10 detik | Hingga 5,4 detik pada 30fps | Hingga 5 detik (720p) |
| Frame Rate | 16fps | 30fps | 24fps |
| VRAM Minimum | 8GB (model 1.3B) | 20GB+ pada presisi penuh | 14GB (v1.5) / 60–80GB (asli) |
| Kecepatan Pembuatan | 1–2 menit untuk klip 4–5 detik (GPU 8GB) | 3–4 menit untuk klip 5,4 detik | 6–10 menit untuk klip 5 detik (GPU 16GB) |
| Text-to-Video | ✅ | ✅ | ✅ |
| Image-to-Video | ✅ | ❌ | ✅ |
| Fine-Tuning LoRA | ✅ | ✅ | ✅ (dibutuhkan komputasi tinggi) |
| Dukungan ComfyUI | ✅ | ✅ | ✅ |
| Dukungan Diffusers | ✅ | ❌ | ✅ |
| Prompt Dwibahasa | ✅ Inggris + Mandarin | ❌ | ❌ |
| Lisensi | Apache 2.0 | Apache 2.0 | Tencent Community License |
| Ramah GPU Konsumen | ✅ Terbaik di kelasnya | ❌ | ⚠️ hanya v1.5 |
| Terbaik Untuk | Keserbagunaan + aksesibilitas | Fotorealisme + fine-tuning | Kualitas sinematik + wajah |
- Wan 2.6
Wan 2.6 adalah seri model pembuatan video dari Alibaba, yang dirilis pada Desember 2025. Model ini mendukung pembuatan text-to-video, image-to-video, dan reference-to-video. Kekuatan utamanya meliputi penceritaan multi-shot, kepatuhan prompt yang lebih baik, dan audio yang tetap sinkron dengan visual. Model reference-to-video juga dapat menggunakan klip referensi untuk mempertahankan penampilan dan suara seseorang atau objek dalam adegan yang baru dibuat.
Wan 2.6 tetap menjadi pilihan bagi para kreator yang ingin bereksperimen dengan adegan buatan AI, video produk, atau klip berbasis dialog.
Fitur
- Arsitektur MoE: pakar khusus untuk tahap noise yang berbeda.
- Hibrida T2V/I2V: input teks dan gambar dalam satu model terpadu.
- Kuantisasi GGUF: berjalan pada GPU konsumen dengan VRAM 4GB.
- Kontrol sinematik: label pencahayaan, kontras, dan nada warna.
- Dukungan dwibahasa: penanganan prompt bahasa Inggris dan Mandarin.
- Akses ter-host: Gunakan model Wan yang didukung melalui Alibaba Cloud Model Studio
Kelebihan
- Mendukung beberapa alur kerja pembuatan video dalam satu keluarga model.
- Kontrol multi-shot cocok untuk cerita pendek, iklan, dan pameran produk.
- Reference-to-video dapat membantu mempertahankan identitas karakter di seluruh adegan yang dihasilkan.
- Menawarkan fitur audio dan dialog yang disinkronkan dalam varian yang didukung.
Kekurangan
- Klip berdurasi pendek, sehingga proyek yang lebih panjang mungkin memerlukan beberapa kali pembuatan dan pengeditan.
- Akses ter-host mungkin melibatkan biaya API atau batasan khusus layanan.
- Mochi (Genmo)
Mochi 1 adalah model dengan 10 miliar parameter yang dibangun di atas arsitektur AsymmDiT baru, dirilis di bawah Apache 2.0. Model ini paling kuat dalam gerakan 30fps fotorealistik dalam pengujian saya, menjadikannya cocok untuk rekaman gaya dokumenter, lingkungan alam, dan gerakan manusia yang perlu terlihat nyata. Ini adalah salah satu model sumber terbuka pertama yang membuat saya menganggap serius pembuatan video lokal.
Fitur
- Backbone AsymmDiT: arsitektur yang dibuat khusus untuk sintesis video.
- Output 30fps: gerakan halus pada frame rate asli.
- Penyetelan halus LoRA: sesuaikan pada dataset video Anda sendiri.
- Lisensi Apache 2.0: terbuka untuk penelitian dan penggunaan komersial.
- Integrasi ComfyUI: dukungan alur kerja berbasis node.
- Pengodean T5-XXL: pemahaman teks dan kepatuhan prompt yang kuat.
Kelebihan
- Lisensi paling permisif dari semua model terbuka berkualitas tinggi.
- Gerakan fotorealistis yang luar biasa dan gerakan yang alami.
- Komunitas yang kuat dengan pembagian fine-tune yang aktif.
Kekurangan
- Dibatasi pada resolusi 480p; memerlukan upscaling untuk output HD.
- Membutuhkan 20GB+ VRAM pada presisi penuh.
- HunyuanVideo (Tencent)
HunyuanVideo adalah model video sumber terbuka unggulan dari Tencent, yang dibuat untuk pembuatan video berkualitas tinggi dengan konsistensi gerakan yang kuat dan struktur pemandangan yang lebih bersih daripada sebagian besar alternatif terbuka yang saya coba. Arsitektur berbasis transformernya menangani data visual dan temporal secara bersamaan, dan saya mengandalkannya setiap kali saya menginginkan kontrol lebih besar atas proses pembuatan video daripada yang diberikan oleh alat ter-host kepada saya.
Fitur
- Skala terbesar 1b dalam kategori sumber terbuka.
- Dual-stream fusion: pemrosesan teks dan video yang terpisah sebelum digabungkan.
- Paralelisme xDiT: paralelisme sekuens multi-GPU untuk inferensi yang lebih cepat.
- Kuantisasi FP8: pengurangan penggunaan memori tanpa penurunan kualitas yang signifikan.
- Diffusers + comfyUI: integrasi ekosistem plug-and-play.
- Causal 3D VAE: kompresi spasial-temporal untuk gerakan yang koheren.
Kelebihan
- Kualitas sinematik dan realisme wajah terbaik dalam kategori sumber terbuka.
- Ekosistem LoRA yang masif untuk kustomisasi gaya dan karakter.
- Penanganan multi-orang dan pemandangan kompleks yang kuat.
Kekurangan
- Klip berdurasi 5 detik dapat memakan waktu lebih dari 15 menit tergantung pada pengaturan.
- Kompleksitas penyiapan yang tinggi; tidak cocok untuk pemula.
Jelajahi model video AI terbaik di Framia Pro
Inilah masalah sebenarnya yang saya hadapi: Saya tidak ingin akun Google untuk Veo, langganan Runway untuk Gen-4.5, dan login Kuaishou untuk Kling, lalu mengulangi penyiapan tersebut setiap kali model baru diluncurkan. Itulah alasan saya memindahkan sebagian besar pengujian ini ke Framia Pro.
Framia Pro menghadirkan Veo 3.1, Kling 3.0, Seedance 2.5, dan model video serta gambar unggulan lainnya ke dalam satu ruang kerja. Saya dapat memulai dengan sebuah ide dan mengubahnya menjadi video menggunakan teks, gambar, audio, atau campuran ketiganya, tanpa harus berpindah tab atau membayar akun terpisah untuk setiap model. Agen kreatif bawaan juga mencakup kasus penggunaan tertentu, seperti video musik, iklan, dan penceritaan, sehingga saya memiliki titik awal apa pun yang saya buat.
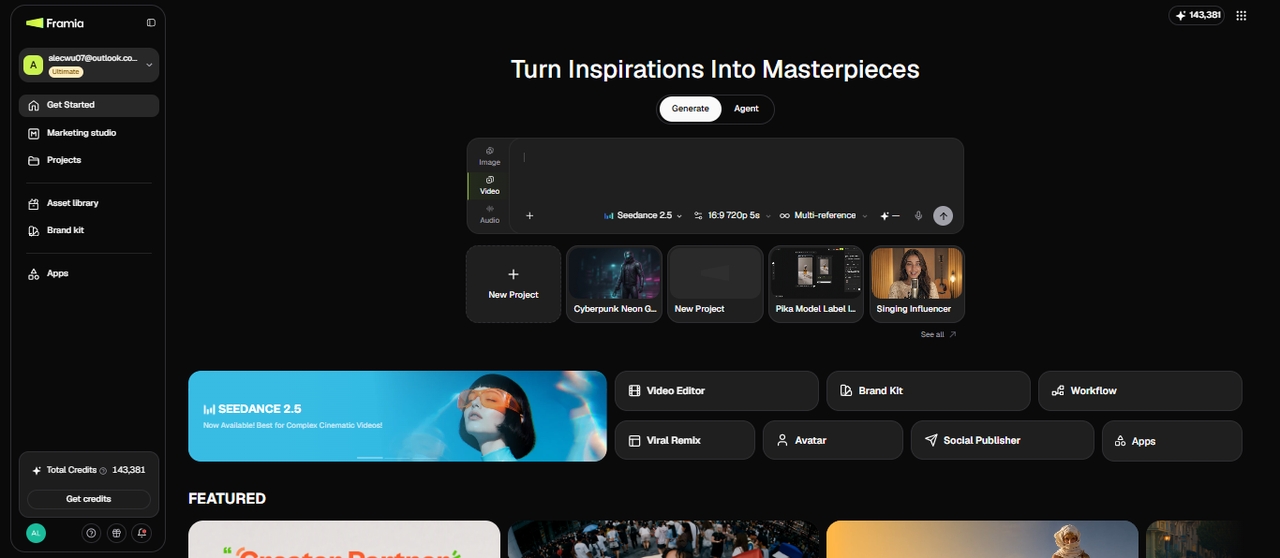
Apa yang ditawarkan oleh Framia Pro?
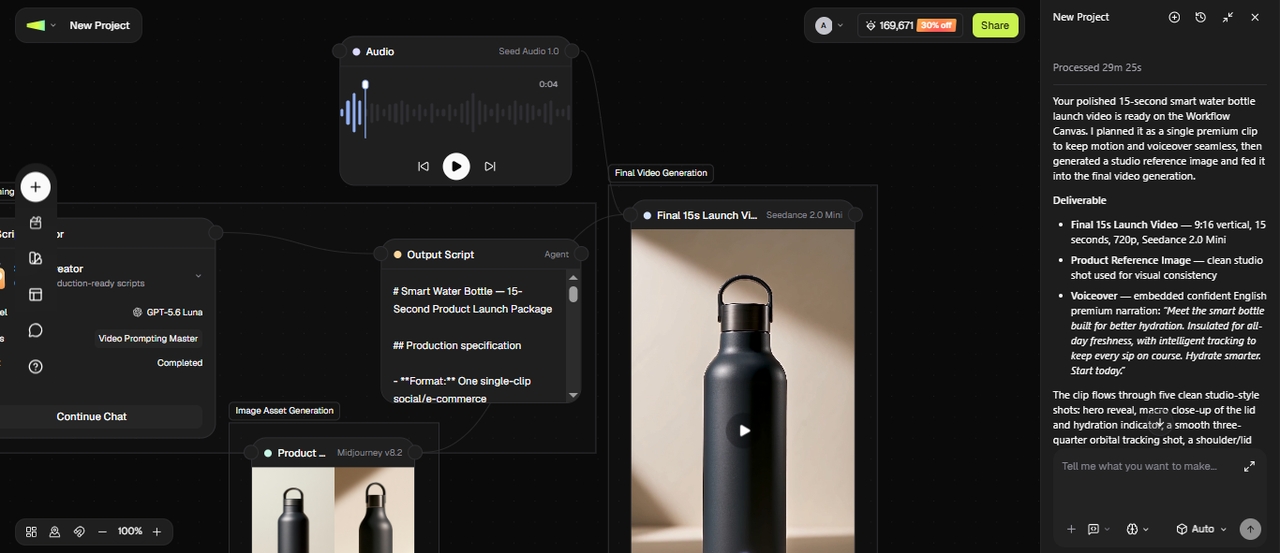
Saya mencoba membuat video peluncuran produk e-commerce di kanvas. Saya mulai dengan agen Image untuk menghasilkan foto produk yang bersih, memasukkannya ke dalam node Video yang mengubahnya menjadi klip demo dengan Kling atau Seedance, lalu mengarahkan hasilnya melalui node Audio untuk sulih suara yang cocok, semuanya di dalam satu kanvas, bukan empat alat terpisah.
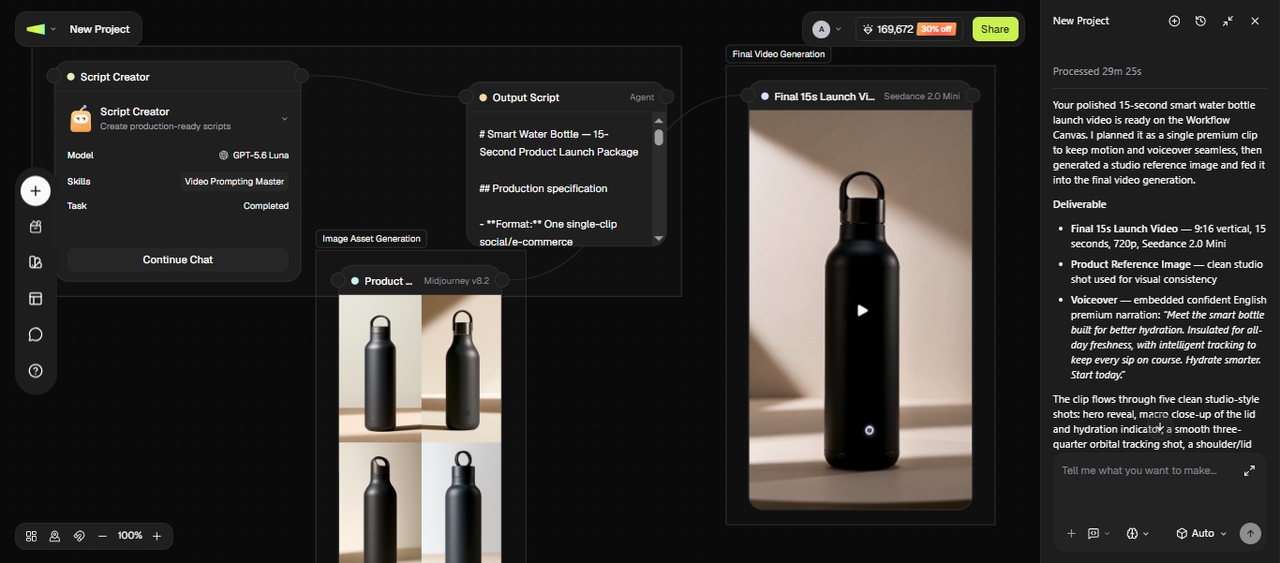
Berikut adalah fitur-fitur yang membantu saya selama proses tersebut:
- Agen Image, Audio, dan Video khusus: Saya menggunakan agen Video untuk mengubah perintah, skrip, atau gambar menjadi klip lengkap di seluruh model di atas, dan agen Image serta Audio untuk thumbnail, sulih suara, dan musik kapan pun saya membutuhkannya secara terpisah.
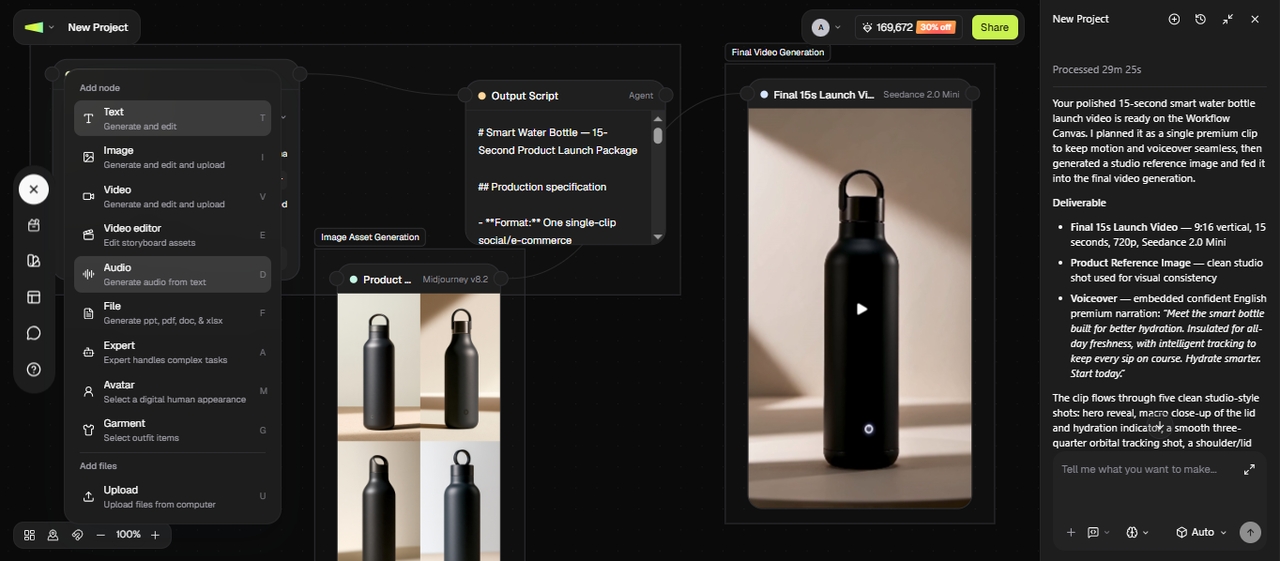
- Ubah perintah dan buat ulang: Saya menjelaskan perubahan yang saya inginkan dalam teks biasa, dan Framia Pro menerapkannya tanpa memerlukan lini masa atau alat pengeditan manual. Saya menyesuaikan adegan, memotong bagian, dan menyempurnakan visual tanpa pengalaman pengeditan sebelumnya.
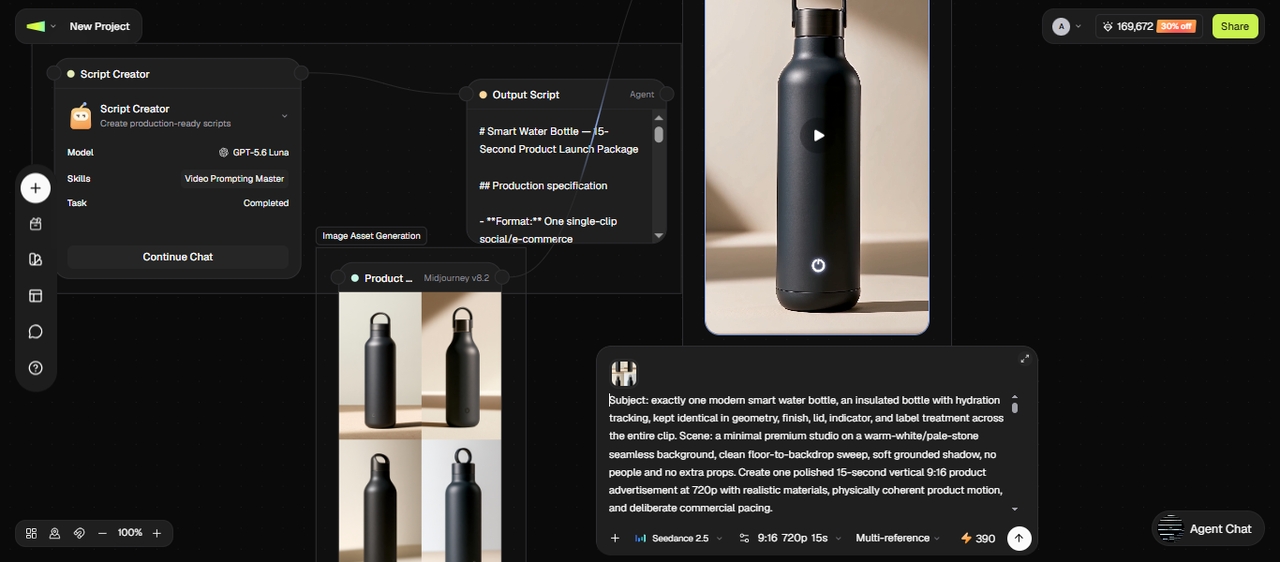
- Keahlian untuk skrip, ulasan, dan penggunaan kembali: Saya mengubah ide kasar menjadi skrip terstruktur, menjalankan video yang sudah selesai melalui ulasan ritme dan retensi, dan memotong satu video panjang menjadi beberapa klip pendek yang siap untuk platform.
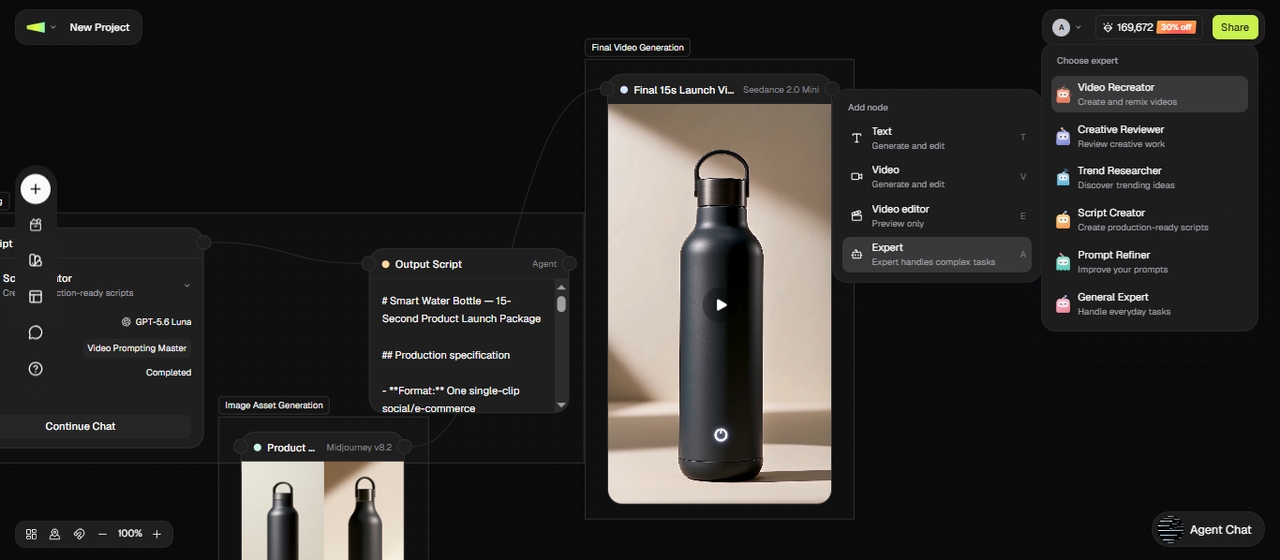
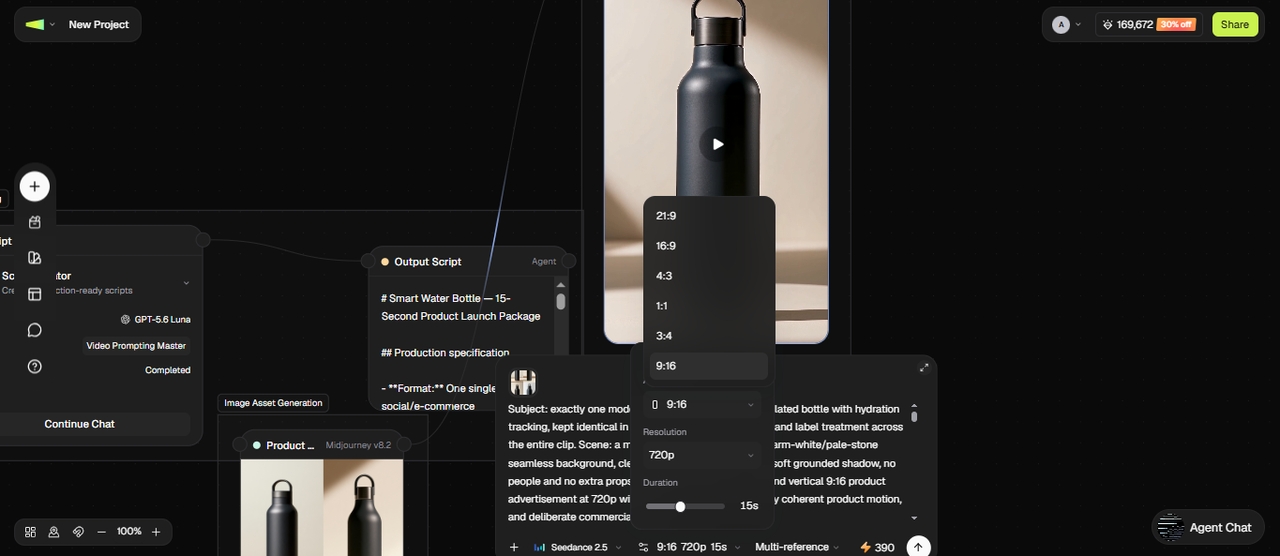
- Beberapa durasi dan rasio aspek: Saya membuat klip dengan panjang berbeda untuk proyek yang berbeda, dalam format vertikal, persegi, atau layar lebar, sehingga versi TikTok, Instagram, dan YouTube saya siap tanpa perlu mengubah ukuran tambahan.
- Sinkronkan audio dengan klip Anda: Framia Pro menyinkronkan suara dengan visual, sehingga dialog, musik, atau efek cocok dengan waktu video. Ini mencocokkan gerakan bibir dengan ucapan dan menyelaraskan audio dengan perubahan adegan, mengurangi penyesuaian audio manual selama pengeditan.
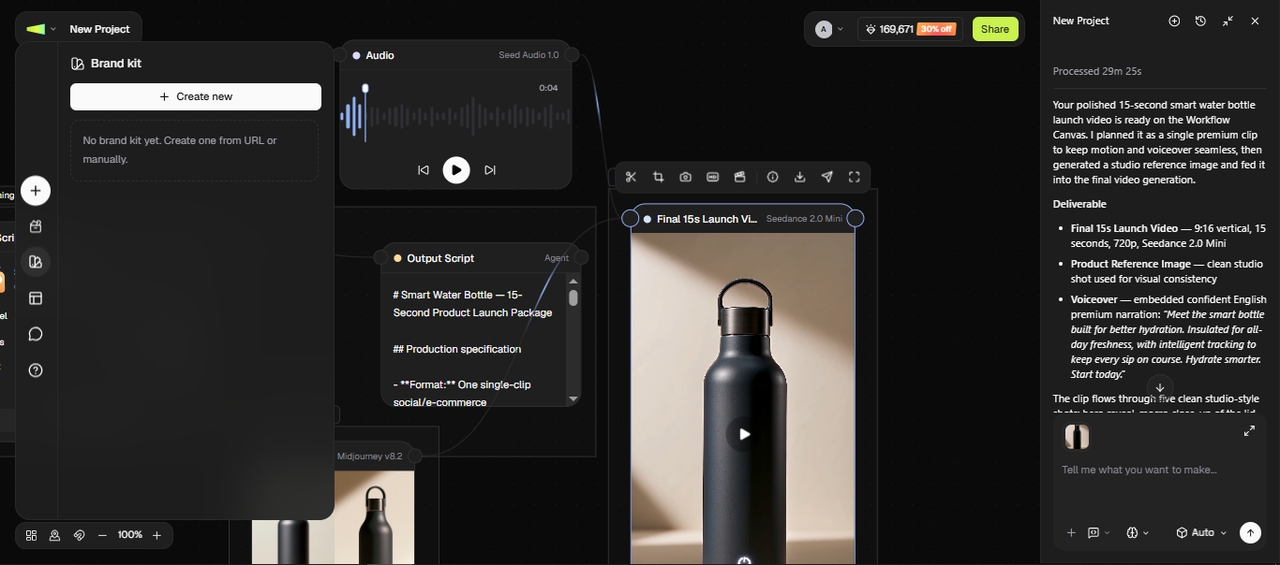
- Brand Kit: Saya menyimpan warna, font, dan logo saya sekali, lalu menerapkannya di setiap video yang saya hasilkan dari model apa pun di ruang kerja.
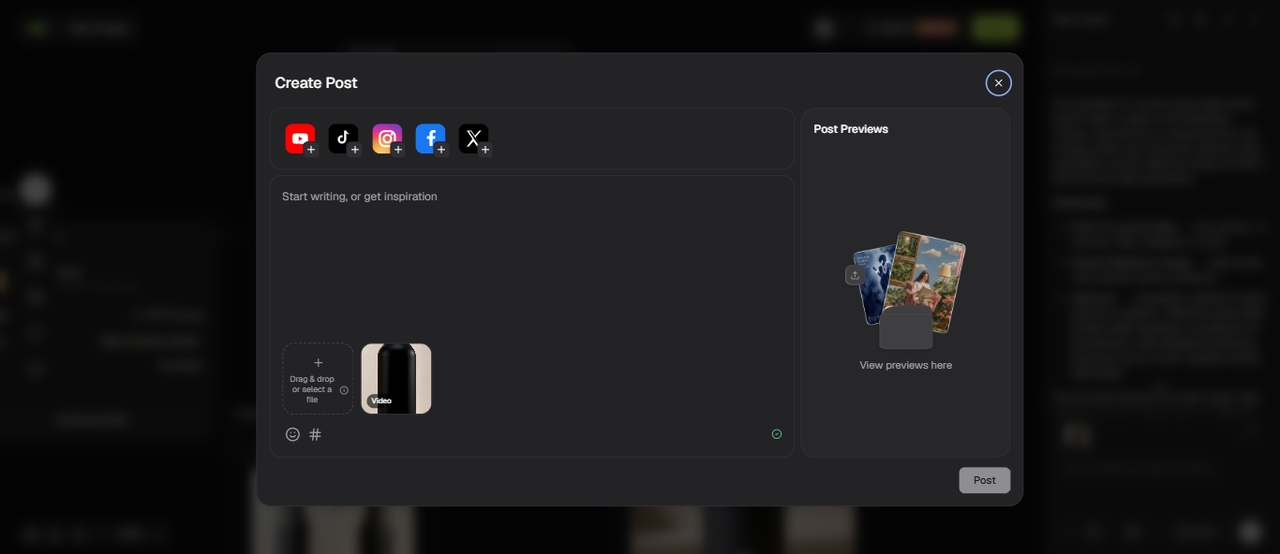
- Ekspor langsung dari Publisher: Saya mengirimkan video yang sudah selesai ke TikTok langsung dari Framia Pro, tanpa langkah pengunduhan dan pengunggahan terpisah.
Kesimpulan
Dalam artikel ini, kita menjelajahi apa itu model pembuatan video AI dan mengulas 5 alat sumber tertutup serta 3 alat sumber terbuka yang dapat Anda gunakan untuk proyek Anda. Fokuslah pada tujuan Anda sebelum memilih model. Beberapa alat cocok untuk klip sosial cepat, sementara yang lain bekerja lebih baik untuk penceritaan atau adegan berkualitas tinggi dengan suara dan detail. Ketika Anda mencocokkan model dengan tugasnya, hasil Anda akan keluar lebih akurat dan lebih mudah dikelola. Jika Anda ingin akses ke beberapa model video AI teratas di satu tempat, jelajahi Framia Pro dan beralihlah di antara alat-alat tersebut berdasarkan kebutuhan proyek Anda.
Pertanyaan yang sering diajukan
Mana yang merupakan model AI terbaik untuk pembuatan video saat ini?
Beberapa dari model AI teratas untuk pembuatan video mencakup Veo, Runway, Seedance 2.5, Kling, dan MiniMax H3. Masing-masing condong ke kekuatan yang berbeda, seperti realisme, gerakan, audio, atau kemudahan penggunaan. Di Framia Pro, Anda dapat mengakses beberapa model ini dan beralih berdasarkan proyek Anda.
Apa yang terjadi dengan model video Sora?
Berita model video Sora mengungkapkan bahwa model tersebut baru-baru ini dihentikan sebagai aplikasi konsumen dan API pada tahun 2026. OpenAI memutuskan untuk menutupnya agar dapat fokus pada bidang lain seperti robotika dan penelitian tingkat lanjut.
Apakah ada generator video AI sumber terbuka yang tersedia?
Ya, generator video AI sumber terbuka seperti Wan, Mochi, dan HunyuanVideo telah tersedia. Anda dapat menjalankannya secara lokal dan menyesuaikannya berdasarkan kebutuhan Anda, meskipun pengaturannya memerlukan pengetahuan teknis. Framia Pro menawarkan opsi yang lebih mudah jika Anda lebih menyukai model yang siap digunakan tanpa pengaturan lokal.
Apakah model video AI dapat membuat video berdurasi panjang?
Sebagian besar model video AI masih berfokus pada klip pendek alih-alih video berdurasi penuh. Beberapa alat memungkinkan adegan yang lebih panjang, tetapi sering kali memerlukan penggabungan beberapa klip. Framia Pro mendukung berbagai durasi, sehingga Anda dapat membuat dan mengelola klip berdasarkan kebutuhan Anda.
Model video AI mana yang sebaiknya Anda gunakan?
Anda harus memilih model berdasarkan tujuan dan gaya konten Anda. Veo berfungsi dengan baik untuk adegan realistis, Kling menangani gerakan, dan Seedance memberikan kontrol lebih besar dengan beberapa masukan. agen video Framia Pro memungkinkan Anda menguji model-model ini di satu tempat dan memilih apa yang sesuai dengan alur kerja Anda.
Apakah model pembuat video AI memerlukan biaya untuk digunakan?
Sebagian besar memerlukan biaya, meskipun harganya sangat bervariasi. Beberapa mengenakan biaya per klip, sementara yang lain berjalan dengan langganan bulanan dengan batas kredit. Model sumber terbuka seperti Wan atau Mochi gratis untuk dijalankan, tetapi Anda memerlukan perangkat keras GPU Anda sendiri.
Apakah saya dapat menggunakan video buatan AI untuk proyek komersial?
Hal ini tergantung pada lisensi model dan tingkat langganan Anda. Model Apache 2.0 seperti Wan 2.2, Mochi, dan HunyuanVideo mengizinkan penggunaan komersial. Untuk alat sumber tertutup seperti Veo, Runway, atau Kling, periksa ketentuan penggunaan komersial paket tertentu sebelum memublikasikan video yang dihasilkan dalam karya berbayar atau bermerek.
Model video AI mana yang mendukung audio bawaan?
Beberapa model saat ini menghasilkan audio dalam proses yang sama dengan video, alih-alih menambahkannya setelahnya. Veo 3.1, Kling 3.0, Seedance 2.5, dan MiniMax H3 semuanya mendukung audio bawaan, termasuk dialog, efek suara, dan suara sekitar yang terikat dengan apa yang terjadi di layar.