共有


主な要点
- オープンソースの画像生成モデルは、継続的なサブスクリプションや個別のモデルライセンス費用なしで、画像を生成および編集する方法を提供します。
- Hugging Faceは109,255近くのテキスト画像生成モデルをホストしているため、クリエイターはスタイル、速度、ハードウェア要件に応じて幅広い選択肢を利用できます。
- Stable Diffusion 3.5、FLUX、およびQwen-Image-2512は、一般的なクリエイティブワーク、プロンプトの正確性、および商用ライセンスの分野をリードしています。
- ControlNet 1.1とWaifu Diffusionは、構造制御やアニメ風のアートなど、専門的なニーズに対応しています。
- Z-Image-TurboとGLM-Imageは、速度や、ポスターやインフォグラフィックなどのテキストを多用する画像生成において際立っています。
- Framia Proは、ローカル環境のセットアップを管理することなく結果を得たいクリエイターのために、Nano Banana Pro、Midjourney v7、Seedream 4.5などのクローズドモデルを1つのワークスペースに統合します。
オープンソースの画像生成モデルは、クリエイター、開発者、ビジネスにまったく新しい世界を切り開きました。テキストを画像に変換したり、写真を編集したり、動画を制作したり、3Dオブジェクトを作成したりすることが、ソフトウェアに大金を費やすことなく可能になります。この分野は急速に成長しており、109,255近くの text-to-imageモデル が、Hugging Face上だけでも利用可能です。オープンソース化することは、サブスクリプションが不要になり、データを完全に制御でき、必要に応じて自由に調整できることを意味します。このガイドでは、現在利用可能な最高のモデルと、すぐに使い始めるために必要なその他すべての情報を紹介します。
オープンソースの画像生成モデルとは何ですか?
オープンソースの画像生成モデルとは、書かれた説明文から画像を生成するソフトウェアプログラムのことです。見たいもの(例えば、山に沈む夕日、製品のモックアップ、アニメのキャラクターなど)を入力すると、モデルがそれを画像として生成します。
生涯にわたって何百万もの絵画、写真、イラストを学んできたアーティストを雇うようなものだと考えてみてください。あなたが欲しいものを説明すると、彼らは数秒でそれを描いてくれます。ただし、このアーティストは眠ることもなく、プロジェクトごとに料金を請求することもなく、あなた自身のコンピュータの中に住んでいます。
これらが「オープンソース」と呼ばれる理由は、コードが一般に公開されているからです。誰でも無料でダウンロード、使用、変更、またはそれをベースに開発を行うことができます。これは、ソフトウェアへのアクセスにお金を払い、内部の仕組みを制御できないMidjourneyやAdobe Fireflyなどの有料ツールとは異なります。
これらのモデルは何百万もの画像でトレーニングされており、言葉とビジュアルの関係を理解するように学習しています。時間が経つにつれて、プロ品質の結果を出力できるほどに進化し、現在では最高のモデルは高価な商用オプションに匹敵するようになっています。
なぜクローズドな画像モデルよりもオープンソースを選ぶのか
有料の画像モデルは便利ですが、現実的な制限があります。画像ごとに料金を支払い、データをサードパーティのサーバーに引き渡し、ソフトウェアの動作方法について意見を言うことはできません。オープンソースモデルはこれらすべてを解決します。より多くのクリエイターや開発者が移行している理由はここにあります。
- 出力を完全に制御可能
クローズドなツールでは、生成できるものとできないものをプラットフォームが決定します。オープンソースモデルは独自のセットアップで動作するため、ルールは自分で設定します。コンテンツフィルターやプラットフォームの制限に邪魔されることなく、要求した通りのものを正確に得ることができます。
- モデルを微調整(ファインチューニング)できる能力
クローズドモデルはロックされており、特定のニーズに合わせて変更することはできません。しかし、オープンソースモデルは、独自の画像、スタイル、またはブランドガイドラインに基づいてさらにトレーニングすることができます。これにより、出力は同じツールを使用している他の誰のものでもなく、あなた自身のもののように見え、感じられるようになります。
- 画像ごとのコストが不要
ほとんどの商用ツールは生成する画像ごとに課金されるため、すぐに費用がかさみます。しかし、オープンソースモデルを使用すれば、すべてを独自のハードウェアで実行し、必要なだけ多くの画像を生成できます。唯一のコストは、電気代と作業を行うマシンだけです。
- プライバシーとオフラインでの使用
クラウドベースのツールを使用すると、プロンプトや画像が他人のサーバーを通過します。オープンソースモデルは完全にオフラインで実行できるため、マシンから何も送信されません。これは、機密性の高いプロジェクトや独自のコンテンツを扱う企業にとって非常に重要です。
- 大規模なコミュニティのサポート
オープンソースモデルは、世界中の何千人もの開発者、研究者、クリエイターによって支えられています。彼らは、微調整されたバージョン、チュートリアル、プラグイン、修正を日々共有しています。問題が発生した場合、コミュニティの誰かがすでに解決している可能性が高いです。
これらのモデルをどのようにテストし、選定したか
私はクリエイティブAIツールを扱っていますが、モデルのGitHubページからスペックシートをコピーしただけの「ベスト」リストを見るのにはうんざりしていました。そのため、ここでランキングを作成する前に、マーケティング用のスクリーンショット以外でどのように機能するかを確かめるべく、実際に各モデルを自分で1週間動かしてみました。
自宅でRTX 4090と24GBのVRAMを搭載した予備のデスクトップを稼働させているため、それをメインのテスト環境としました。32BのFLUX.2やQwen-Image-2512など、より多くのメモリを必要とする大規模なモデルについては、スペックシートだけで出力を推測するのではなく、クラウドGPUを時間単位でレンタルしました。
20個のプロンプトのセットを作成し、チェリーピッキング(都合の良いデータの選別)なしで、すべてのモデルに同じリストを実行しました。プロンプトは、フォトリアルなポートレート、無地の背景でのプロダクトショット、見出しと小さな文字が入ったポスター、アニメスタイルのキャラクター、複数のオブジェクトが配置された賑やかなシーンの5つの領域をカバーしています。各モデルはプロンプトごとに3回試行し、ほとんどの人が実際にこれらのツールを使用するのと同じように、3つのうち最良のものを採用しました。
スコアリングについては、出力がプロンプトにどれだけ一致しているか、フル解像度で細かいディテールがどれだけ綺麗に見えるか、私のハードウェアでの生成にどれだけ時間がかかったか、そして(プロンプトで要求された場合に)画像内のテキストが実際に読み取り可能に出力されたか、という4つの項目について、すべての結果を1から5で評価しました。丸一日のテストの後はいくつかのモデルの記憶が曖昧になってしまうため、後から記憶に頼るのではなく、テストを進めながらスプレッドシートに数値を記録しました。
いくつかの点がすぐに際立ちました。Z-Image-Turboは20個のプロンプトのバッチを合計4分未満で完了したのに対し、32BのFLUX 2はレンタルしたGPUで40分近くかかりました。GLM-ImageとQwen-Image-2512は、ポスターのプロンプトで文字化けすることなく、小さなテキストを一貫して正しく再現できた唯一の2つのモデルでした。Waifu Diffusionはアニメのプロンプトで大差をつけて勝利しましたが、フォトリアルなポートレートでは非常に苦戦しました。これは、限定されたデータセットでトレーニングされたモデルに期待される通りの結果でした。
私は、単なるスペックシートやコミュニティの誇大広告ではなく、そのテストに基づいて以下の7つのモデルをランク付けしました。また、適切なバッチサイズでフルパイプラインをロードした際に、モデルの実際のVRAM使用量が公式の最小要件よりも高くなった箇所についても指摘しました。
トップ7 オープンソース画像生成モデル
異なる オープンソースAI画像生成ジェネレーターは、リアリズム、速度、構造制御、テキストの正確性など、それぞれ異なる強みに焦点を当てています。以下は、それぞれ明確な目的を持つ、広く使用されている7つのモデルです。
| モデル | アーキテクチャ | 最小VRAM | ライセンス | 主な強み | 最適な用途 |
| Stable Diffusion 3.5 | 潜在拡散(DiT) | 8 GB以上 | 商用 | 大規模なエコシステム、LoRAサポート、活発なコミュニティ | 一般的なクリエイティブワーク、初心者、プラグインベースのワークフロー |
| ControlNet 1.1 | 条件付きSDアドオン | 8 GB以上 | Apache 2.0 | ポーズ制御、深度マップ、エッジガイダンス | キャラクターの一貫性、建築レイアウト、ガイド付き生成 |
| FLUX.2 | フローマッチングトランスフォーマー(4B–32B) | 13 GB (4B) / 24 GB (32B) | BFL商用 | 複数画像参照のサポートと強力なプロンプト準拠 | 高品質なビジュアル、ブランドアセット、マーケティングコンテンツ |
| GLM-Image | ハイブリッドAR + DiT(9B + 7B) | 約16 GB | 研究用 / カスタム | 強力なテキストレンダリング、中国語タイポグラフィのサポート、1つのフローでの編集+生成 | ポスター、UIモックアップ、バイリンガルデザイン、インフォグラフィック |
| Qwen-Image-2512 | 拡散+ビジョン言語モデル(20B) | 約16 GB | Apache 2.0 | 多言語テキスト、レイヤー化されたRGBA編集、ControlNetサポート | 商用ワークフロー、高度な編集、多言語コンテンツ |
| Waifu Diffusion | Stable Diffusion微調整(アニメデータセット) | 6 GB以上 | CreativeML OpenRAIL | アニメスタイル、マンガビジュアル、キャラクター重視の出力 | ゲーム、ビジュアルノベル、アニメスタイルのアートワーク |
| Z-Image-Turbo | 蒸留拡散トランスフォーマー(6B) | 16 GB | Apache 2.0 | 非常に低いレイテンシ、英語+中国語のサポート、バッチ処理 | リアルタイムアプリ、大規模パイプライン、エッジ展開 |
- Stable Diffusion 3.5
Stable Diffusion 3.5は、Multimodal Diffusion Transformer (MMDiT)のテキストから画像への変換モデルであり、Stability AIによって開発されました。画質、タイポグラフィ、プロンプトの理解、および全体的なパフォーマンスが向上しています。このモデルは、さまざまなハードウェア構成やユースケースに合わせて設計された3つのサイズで提供されています。この画像生成に最適なモデルは、開発者やコンテンツクリエイターの広大なコミュニティに支えられ、最も広く使用されているオープンな画像生成モデルの1つであり続けています。
主な特徴:
- 3つのモデルサイズ:Large(8Bパラメータ)、Large Turbo、およびMedium(約2.5Bパラメータ)があり、それぞれ異なるパフォーマンスとハードウェアのニーズに適しています
- 高解像度出力:Largeモデルは、約1メガピクセルの解像度で高品質な画像生成をサポートします
- 高速生成バリアント:Large Turboは、少ないステップ数で高品質な結果を生成します
- 微調整(ファインチューニング)のサポート:プロンプトの一貫性が向上し、カスタマイズ向けに構築されています
- 柔軟な使用ライセンス:個人および小規模企業は無料、大企業向けにはエンタープライズライセンスが用意されています
私の体験評価:4.5/5
これは、5つのプロンプトカテゴリすべてにおいて、最も一貫性のあるモデルでした。Largeモデルは、ほぼ毎回1回目または2回目の試行でプロダクトショットと賑やかなシーンのプロンプトを完璧にこなし、フル解像度であっても私の4090でクラッシュすることはありませんでした。唯一減点されたのはテキストレンダリングで、ポスタープロンプトの小さな文字が依然としてわずかに歪んで出力されました。
- ControlNet 1.1
ControlNetは、追加の条件を加えることで拡散モデルを制御するニューラルネットワーク構造です。ニューラルネットワークブロックの重みを、ロックされたコピーとトレーニング可能なコピーに複製します。トレーニング可能なコピーが条件を学習する一方で、ロックされたコピーは元のモデルを保持します。研究者のlllyasviel氏によってリリースされたこのモデルは、単体で画像を生成するわけではありません。代わりに、この最高の画像モデルはStable Diffusionの上に位置し、生成されるものに対して正確な構造制御を可能にします。
主な特徴:
- 複数の条件付けタイプ: ControlNetは、Cannyエッジ検出、Midas深度推定、HEDソフトエッジ検出、M-LSD直線検出、法線マップ、OpenPoseによる人物姿勢検出、およびセマンティックセグメンテーションによる制御をサポートしています。
- 組み合わせ可能な制御: ControlNetは、複数のControlNetを同時に組み合わせることをサポートしています。すべての本番環境対応モデルは、複数のControlNetを組み合わせた状態で広範囲にテストされており、A1111プラグインを介して公式のマルチControlNetサポートが利用可能です。
- v1.1における堅牢性の向上: ControlNet 1.1では、新しいソフトエッジ処理、Canny、Depth、Inpaintなどの複数の新しいプリプロセッサが追加され、バージョン1.0と比較してモデル全体の堅牢性と画質が強化されています。
- 指示ベースの編集: ControlNet 1.1には、指示プロンプトと記述プロンプトの両方でトレーニングされた、Instruct Pix2Pixデータセットでトレーニングされたモデルが含まれています。
私の体験: 4/5
ControlNet 1.1の公式ウェイトはSD 3.5ではなくStable Diffusion 1.5向けに設計されているため、同じ5つのプロンプトで評価は行いませんでした。代わりに、SD 3.5の実行とは別に、そのポーズと深度の制御を個別に評価しました。10回の再生成にわたり、ポーズ制御はキャラクターの位置を安定して維持しました。これは、ControlNet 1.1が互換性のあるワークフローにおいて有用なガイダンスを提供できることを示唆していますが、これらの結果をSD 3.5との直接的な互換性の証拠として捉えるべきではありません。
- FLUXシリーズ
FLUXシリーズはBlack Forest Labsによって開発され、高品質な画像生成と強力なプロンプト整合性に焦点を当てています。実験用と本番用ワークフローの両方向けに設計された複数のモデルが含まれています。
主な特徴:
- 複数のバリアント: FLUX.1 [schnell]、[dev]、および編集や条件付けのための専門ツールが含まれています。
- インコンテキスト画像編集: 再トレーニングなしで、テキスト指示を使用して画像を変更できます。
- 専用の編集ツール: 画像インペインティング、アウトペインティング、および構造的ガイダンスのサポート。
- オープンウェイトの提供: ローカル環境へのデプロイとカスタマイズが可能です。
- 柔軟なデプロイオプション: API、ローカルセットアップ、およびテスト環境をサポートしています。
私の体験: 4.5/5
FLUX.2は、テストしたすべてのモデルの中で最も鮮明で微細なディテールを提供してくれました。特に製品ショットのプロンプトでは、素材の質感が描かれたものというよりも、実際に光が当たっているように見えました。32Bバリアントは、レンタルしたGPUでのバッチ処理において、全20プロンプトの実行に40分近くかかり、私のテストしたモデルの中で最も時間がかかったため、急いでいるときに選ぶべきモデルではありません。
- GLM-Image
GLM-Imageは、ハイブリッド自己回帰および拡散デコーダーアーキテクチャを採用した画像生成モデルです。テキストレンダリングや知識集約型の生成シナリオにおいて強みを発揮し、高忠実度で微細なディテール生成において強力な能力を示します。Zhipu AIによって開発されたこのモデルは、他のモデルが苦手としがちなユースケース、特に画像に読み取り可能なテキストや情報密度の高いレイアウトを含める必要がある場合に向けて構築されています。
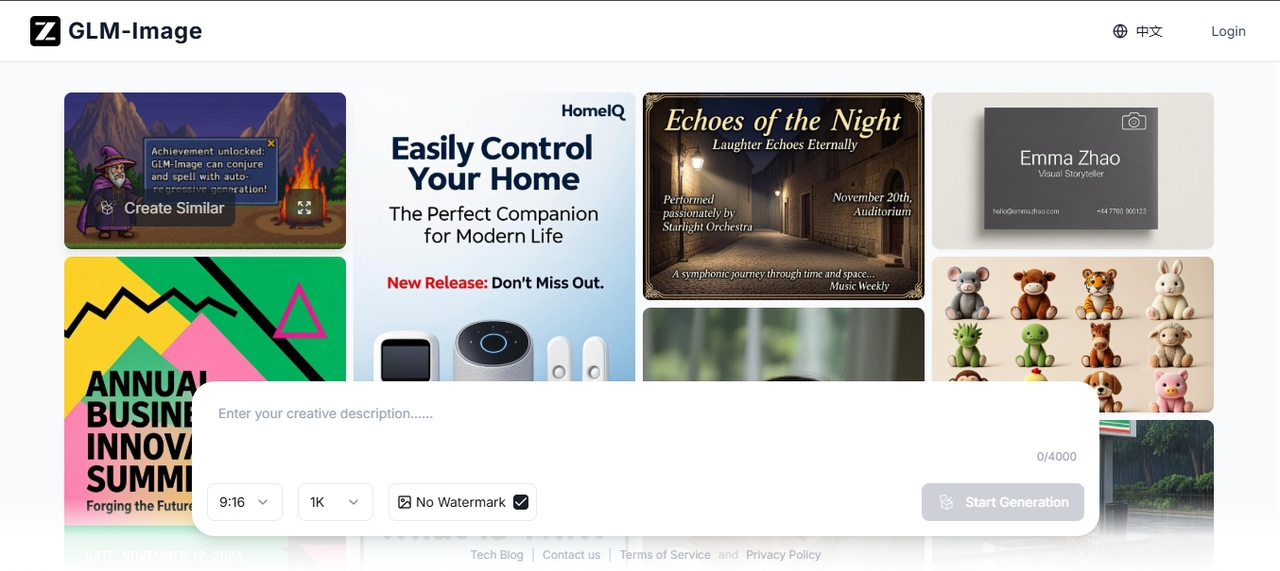
主な特徴:
- ハイブリッドアーキテクチャ設計: 自己回帰エンコーディングと拡散デコーディングを組み合わせています。
- 正確なテキストレンダリング: 画像内に鮮明で読み取り可能なテキストを生成します。
- 複雑なレイアウトのサポート: ポスター、インフォグラフィック、および構造化されたビジュアルに適しています。
- 統合された生成と編集: text-to-imageとimage-to-imageの両方のタスクを処理します。
- 事後学習による洗練: 詳細とアライメントを向上させるために強化学習を使用します。
私の体験: 4/5
GLM-Imageは、ポスターのプロンプトの小さな文字を完全に読める状態にできたわずか2つのモデルのうちの1つであり、文字が互いににじむことなくインフォグラフィック風のレイアウトを処理しました。商用利用の前にライセンス条項を詳しく読む必要があるため、セットアップには他よりも時間がかかり、出力の品質というよりは利便性の面で評価を1点下げることになりました。
- Qwen-Image-2512
Qwen-Image-2512は、Qwen-Imageのテキストから画像への変換モデルの12月のアップデートであり、最高のオープンソース画像生成モデル, 人物のリアリズムの向上、より微細な自然のディテール、そしてテキスト描画の正確性と品質の向上が特徴です。品質、信頼性、そしてライセンスの明確さが重要となるエンタープライズおよび商用のユースケースを明確にターゲットにしています。
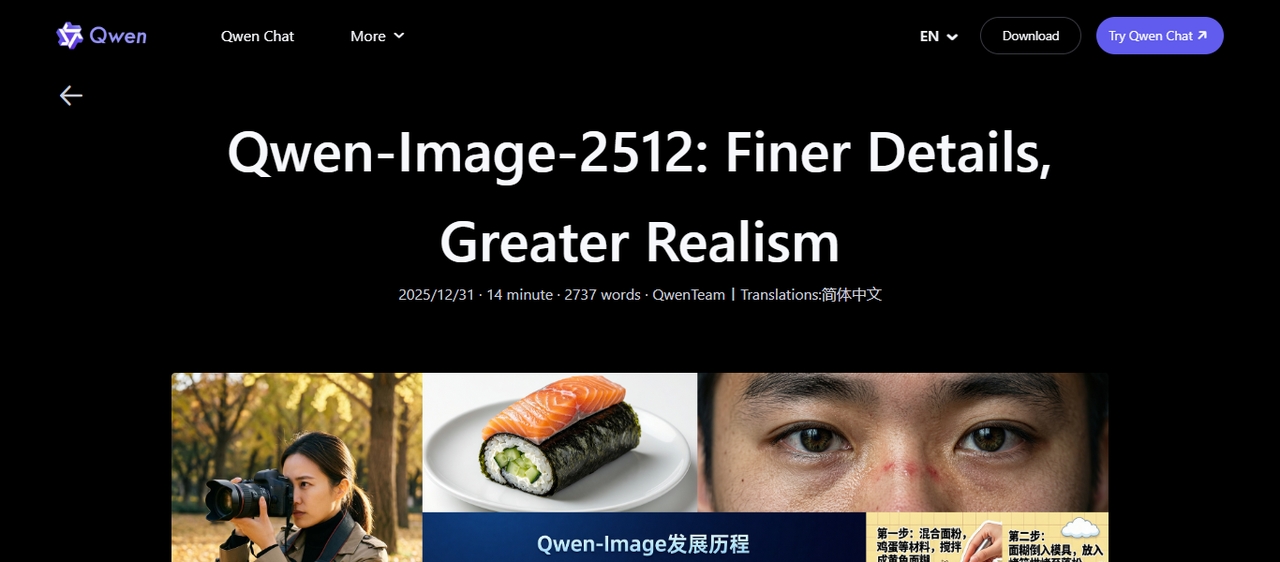
主な特徴:
- 視覚的リアリズムの向上: 生成された画像における不自然な見た目を低減します。
- テキストの正確性の向上: より鮮明な埋め込みテキストと構造化されたレイアウトを生成します。
- 詳細なシーン生成: 環境やオブジェクトをより高い鮮明さで処理します。
- オープンな商用ライセンス: 自由な使用と改変のためにApache 2.0ライセンスでリリースされています。
- フルモデルアクセス: デプロイのためにオープンモデルプラットフォームを通じて利用可能です。
私の体験: 4.5/5
Qwen-Image-2512は、ポスターのプロンプトで小さなテキストを正しく読み取れたもう1つのモデルであり、そのポートレートの結果は、他のいくつかの拡散モデルから得られたものよりも不自然なテカリが少なく、群を抜いて最も自然に見えました。Apache 2.0ライセンスと相まって、ライセンスに関する話し合いをすることなく迅速に進める必要があるクライアントプロジェクトで、私が最初に選ぶのはこれです。
- Waifu Diffusion
Waifu DiffusionはHakureiによって作成され、アニメスタイルの画像生成に焦点を当てています。アニメのデータセットに特化してトレーニングされているため、一貫したキャラクターデザインと様式化されたビジュアルを生成できます。Stable Diffusionをベースにしており、そのエコシステムに直接適合するため、すでにそれらのツールに慣れているアーティストにとって使いやすくなっています。
主な特徴:
- アニメに焦点を当てたトレーニング: このモデルはアニメ画像の膨大なデータセットでトレーニングされており、アニメアートで一般的なキャラクターの比率、表情、スタイルの要素を学習するのに役立ちます。
- 一貫したキャラクター品質: さまざまなプロンプトにわたって安定した顔の特徴、髪型、衣服の詳細を維持するため、複数のシーンで同じキャラクターを作成する際に役立ちます。
- プロンプトによるスタイル制御: アニメコミュニティで一般的に使用されるタグやプロンプトスタイルを使用して、出力をガイドできます。
- SDXLベースのバリアント: SDXLをベースに構築された新しいバージョンは、アニメスタイルをそのまま維持しながら、解像度、照明、より微細なディテールを向上させています。
- オープンアクセスライセンス: 特定の条件下での使用と再配布を許可するCreativeML OpenRAIL-Mの下で配布されています。
- 幅広いコミュニティサポート: 多数の事前学習済みチェックポイント、LoRA、スタイルパックが利用可能です。
私の体験: 3.5/5
Waifu Diffusionは、私が実行した3回すべての試行でキャラクターの顔と衣装の一貫性を維持することにより、アニメのプロンプトで完全に勝利しました。しかし、実写のようなポートレートのプロンプトに向けると、どのように言葉を表現しても、結果はやはりアニメに近い見た目になりました。これは、狭いデータセットでトレーニングされたモデルにまさに期待される通りのことです。1つの仕事には優れていますが、それ以外には作られていません。
- Z-Image-Turbo
Z-Image-TurboはTongyi-MAIによって開発されています。スピードと効率性に焦点を当てており、迅速な画像生成を必要とするアプリケーションに適しています。非常に大規模なアーキテクチャに依存することなく、強力な結果を提供するように設計されたコンパクトなモデルファミリーの一部です。
主な特徴:
- 1秒未満の生成スピード: Z-Image-Turboは、巨大なモデルサイズに依存することなく、トップクラスのパフォーマンスを達成できることを証明しています。
- バイリンガルテキストレンダリング: 複雑な中国語と英語のテキストを正確にレンダリングし、ポスターデザインにおいては強力な構成力と優れたタイポグラフィのセンスを発揮します。
- プロンプトの強化と推論: 内蔵されたプロンプトエンハンサーにより、モデルに推論機能が備わっています。
- 効率的なシングルストリームアーキテクチャ: Z-Image-Turboは、テキスト、視覚的セマンティックトークン、および画像VAEトークンがシーケンスレベルで結合されて統一された入力ストリームになる、スケーラブルなシングルストリームDiTアーキテクチャを使用しています。
私の体験:4/5
Z-Image-Turboは、20個のプロンプトバッチ全体を4分未満で処理し、7つのモデルの中で群を抜いて最速でした。バイリンガルテキストレンダリングは、ポスタープロンプトの英語版と中国語版の両方でうまく機能しました。混雑したシーンのプロンプトにおける細かいディテールは、Stable Diffusion 3.5やFLUX.2に一歩及びませんでしたが、モデルのサイズがはるかに小さいことを考えれば納得がいきます。
モデルを選択する前に考慮すべき重要な要素
1つのモデルに決める前に、確認しておく価値のある実用的な事項がいくつかあります。ここでは、何に注目すべきか、そしてなぜそれが重要なのかを説明します。
- 画質
画質とは、出力された画像が、求めたものに対してどれだけリアルで、詳細で、正確に見えるかということです。本物そっくりの結果を出すモデルもあれば、より様式化された表現を得意とするモデルもあります。適切な選択は、プロジェクトが実際に何を必要としているかによって異なります。
- 速度(推論時間)
推論時間とは、モデルが1枚の画像を生成するのにかかる時間のことです。バッチで何百枚もの画像を生成する場合や、リアルタイムツールを構築する場合、速度は非常に重要になります。素晴らしい結果を出すものの速度が遅いモデルは、必ずしも実用的とは言えない場合があります。
- VRAM要件
VRAMは、グラフィックカードがモデルを実行するために使用するメモリです。大規模なモデルほど多くのVRAMを必要とし、16 GB以上必要になることもあります。ハードウェアが要件を満たしていない場合、モデルはまったく動作しないか、遅すぎて使い物になりません。
- テキストレンダリング能力
画像内のテキストをうまく処理できるモデルもあれば、完全に間違えてしまうモデルもあります。出力に看板、ポスター、ラベル、または書かれたコンテンツが含まれる場合、これは極めて重要な要素になります。GLM-ImageやQwen-Image-2512のようなモデルは、まさにこの点を考慮して構築されました。
- ライセンス(商用 vs 制限付き)
個人利用や研究目的には無料であっても、商用利用には有料ライセンスが必要なモデルもあります。一方で、Z-Image-TurboやQwen-Image-2512のように、Apache 2.0の下で完全にオープンなものもあります。クライアントのプロジェクトや製品でモデルを使用する前には、必ずライセンスを確認してください。
- エコシステムとコミュニティ
強力なコミュニティがあるということは、チュートリアル、事前に構築された微調整(ファインチューニング)モデル、プラグインが多く存在し、問題が発生した際の修正も早いことを意味します。例えば、Stable Diffusionには、コミュニティが作成した何千ものリソースがあります。より新しく、あるいはよりニッチなモデルは印象的かもしれませんが、サポートはほとんど得られない可能性があります。
これら6つの要素を総合的に考えると、オープンソースが必ずしも「ただ飯(無料のうまい話)」ではないことが見えてきます。画質とテキストレンダリングを完璧にこなすモデルであっても、手元にない16GB以上のVRAMが必要だったり、実際に使えるものを出力する前にローカル環境のデバッグに多大な時間を費やすことになったりします。もしあなたが本当に求めているのが、自分でモデルをホストすることなくトップクラスのパフォーマンスを得ることや、これらのオープンソースの選択肢では到底及ばないクローズドモデルへのアクセスであるなら、まさにそこに Framia Pro が適しています。
Framia Pro: 非オープンモデルを扱うための選択肢
Framia Proは、ワークフローキャンバスを中心に構築されたAIクリエイティブプラットフォームであり、単一のエンジンを選択してその制限に甘んじるのではなく、Seedream 5.0 Pro、Nano Banana Pro、Kling、Seedance 2.5、Veo 3.1といったパートナーのクローズドモデルを1つのワークスペースに接続できます。あなたが望むものを説明すると、Framia Proがスクリプト、ビジュアル、そしてプロセス内の任意の時点で編集可能な接続されたノード全体の組み立てを処理します。画像生成、動画、そして完全なMarketing Studioを1つの場所に集約するため、オープンソースではないモデルからの成果を必要とするクリエイターが、それを実現するために複数のサブスクリプションを組み合わせる必要がなくなります。
私はFramia Proで上記の7つのモデルとともに数時間を過ごし、クローズドモデルの体験が実際にどのように比較されるかを確認しました。そして、それがどこに適していて、どこに適していないかを以下にまとめました。
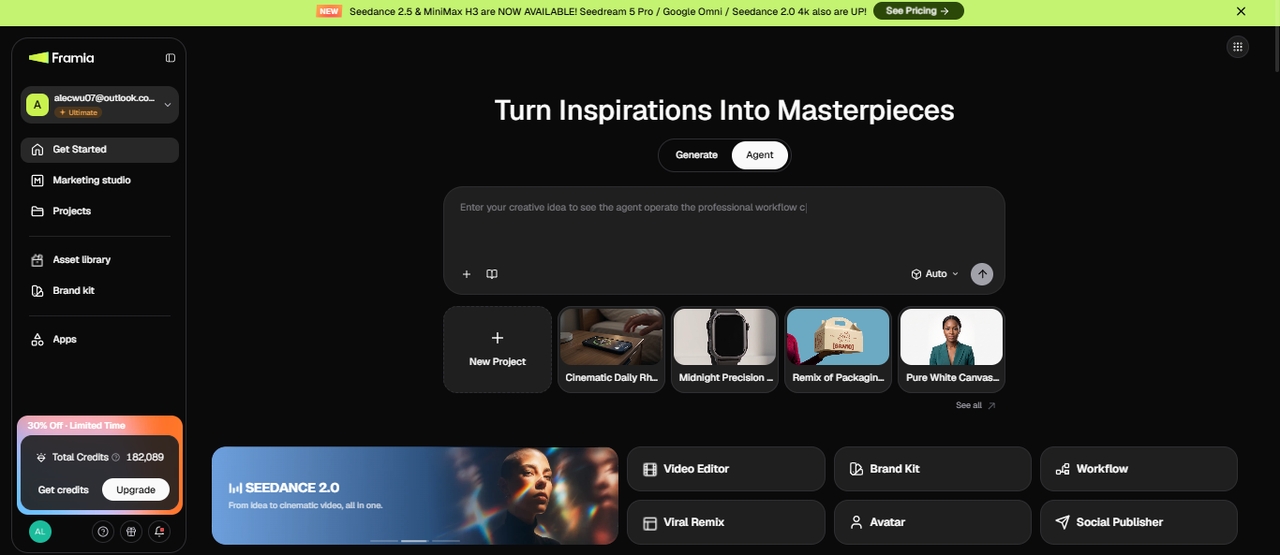
Framia Pro画像生成機能の特徴
Framia Proは、さまざまな最高の画像生成モデルを使用して画像を作成および編集できる単一のワークスペースを提供します。各機能は、画像の生成方法と洗練方法をコントロールできるように設計されています。
- すべてのステップを接続するワークフローキャンバス
Framia Proのキャンバスは、プロジェクトの進行に合わせてドラッグ、追加、または削除できる、接続されたノード(スクリプト、画像、動画、音声)としてプロジェクトをレイアウトします。1つの画像を生成して次のアセットのために最初からやり直すのではなく、完全なシーケンスを構築し、変更が必要なノードだけを再実行します。
- 1つのワークスペースに複数のAIモデル
Framia Proを使用すると、画像用のNano Banana Pro、Qwen Image、Midjourney v7、Flux Max、Seedream 4.5に加えて、動画用のKling、Veo 3.1、Seedanceにすべて単一のプラットフォーム内でアクセスできます。求める結果に応じてモデルを切り替え、個別のツールを開くことなく出力を並べて比較できます。
- 一貫したビジュアルのためのBrand Kit
Framia ProのBrand Kitジェネレーターは、単一のブリーフからロゴ、カラーパレット、タイポグラフィ、ソーシャルテンプレートを構築し、その後生成するすべての画像をそれらのブランドガイドラインに固定します。これは、キャンペーン全体で大量のビジュアルを制作するマーケティングチームや企業にとって重要です。
- リミックス可能なトレンドテンプレート
Framia Proは、白紙のキャンバスからコンセプトを構築する代わりに、選択して独自のプロンプトでリミックスできる、トレンドのバイラル対応テンプレートのギャラリーを維持しています。これは、このガイドが焦点を当てているスタイルよりも、迅速な対応が必要なソーシャルコンテンツを対象としていますが、動画も制作する場合は知っておく価値があります。
- シンプルなチャットコマンドによる画像編集
背景の入れ替えやロゴのサイズ変更など、変更内容をプレーンな言葉で説明するだけで、Framia Proがそれを画像に直接適用します。このチャットベースの編集により、手動でのマスキングや、小さな修正のために生成全体をやり直す手間が省けます。
結論
この記事では、上位7つのオープンソース画像生成モデルを探索し、さまざまなツールが画像の作成、パフォーマンス、柔軟性をどのように処理するかを示しました。各モデルは、ビジュアル品質、速度、ハードウェア要件、さまざまなスタイルへの対応などの分野で、それぞれ独自の強みを持っています。Framia Proは、複数のモデルを1つの場所に集約し、個別のツールを切り替えることなく、単一のワークフローで画像を生成および編集するためのより多くの選択肢を提供します。今すぐお試しください!
FAQs
どのオープンソースAI画像生成ツールが最も頻繁に使用されていますか?
Stable Diffusionは、活発なコミュニティと幅広いツールサポートにより、最も広く使用されているオープンソースの画像生成ツールの1つであり続けています。Framia Proでは、1つのワークスペースで異なる画像モデルにアクセスできるため、ジェネレーターごとに個別の環境をセットアップする必要がなくなり、出力間の切り替えがより簡単になります。
どの画像生成モデルがより高いビジュアル品質を提供しますか?
SDXLベースやFluxシリーズなどの新しいモデルは、多くの場合、より鮮明なテクスチャ、改善されたライティング、および優れた構図を生成します。Framia Proでは、Nano Banana Pro、Seedream 4.5、Flux Max、Qwen Image、およびMidjourney v7モデルにアクセスして、画像を即座に作成できます。
限られたハードウェアで画像生成に最適なモデルはどれですか?
最適化されたモデルや軽量版のモデルは、VRAMが限られているシステムにより適しています。Framia Proはバックエンドでモデルへのアクセスを処理するため、ローカル環境のセットアップを管理することなく、より重いモデルを実行でき、ユーザー側のハイエンドハードウェアへの必要性を減らすことができます。
どれが最高のオープンソース画像生成モデルとされていますか?
Stable Diffusion、Waifu Diffusion、およびControlNetベースのセットアップなどのモデルは、リアリズムやアニメアート、構造制御など、さまざまなタスクに一般的に使用されています。Framia Proはこれらのオプションを統合し、単一のプロジェクト内で複数のモデルを選択してテストできるようにします。
どの画像モデルがプロフェッショナルなユースケースで好まれますか?
プロフェッショナルなワークフローでは、安定した出力、一貫した結果、そして編集のサポートが求められることがよくあります。Framia Proは、チャットベースの画像編集やバッチ生成を提供することで価値を加え、ツールを切り替えることなく、1つの場所で画像を微調整し、複数のバリエーションを作成できるようにします。
最も優れた無料の画像生成モデルはどれですか?
Stable Diffusion 3.5は、MediumおよびLarge Turboバリアントがコンシューマー向けのハードウェアで動作し、ライセンスが小規模ビジネス向けの商用利用をカバーしているため、最も完全な無料のオプションです。Z-Image-TurboおよびQwen-Image-2512もApache 2.0の下で完全に無料であり、出力はより高速ですが、これまでのところ構築されているコミュニティは小規模です。
オープンソースのローカルAI画像生成ツールはありますか?
はい。Stable Diffusion 3.5、ControlNet 1.1、FLUX.2、Waifu Diffusion、およびZ-Image-Turboはすべて、ダウンロードすればクラウドのアカウントやサブスクリプションを必要とせず、自身のハードウェア上でローカルに動作します。主な要件は十分なVRAMであり、選択するモデルに応じて通常6GBから24GBが必要です。
オープンソースの画像モデルを商用プロジェクトに使用できますか?
はい、ただしモデルのライセンスによります。一部のモデルは商用利用を許可していますが、他のモデルには制限があります。生成された画像をクライアントの仕事、製品、または有料キャンペーンに使用する前に、必ずライセンス条項を確認してください。