Поделиться


- Модели генерации видео на базе ИИ превращают текстовый промпт, изображение или существующий сохраненный мной цвета,клип в новые кадры с помощью процесса диффузии, который шаг за шагом очищает случайный шум, пока он не будет соответствовать вашему описанию.
- Пять моделей с закрытым исходным кодом сейчас лидируют, каждая со своими сильными сторонами: Veo 3.1 (встроенный звук), Runway Gen-4.5 (творческий контроль), Seedance 2.5 (длинные клипы, снятые одним дублем), Kling 3.0 (физически точное движение) и MiniMax H3 (единый мультимодальный ввод).
- Wan 2.2, Mochi и HunyuanVideo дают вам больше контроля и не имеют лимитов на использование, но вам понадобится более мощное оборудование и некоторое время на настройку.
- Framia Pro объединяет несколько таких моделей в одной панели управления, так что вы можете переключаться между ними без необходимости жонглировать отдельными учетными записями и подписками.
Что такое модели генерации видео на базе ИИ?
Модели генерации видео на базе ИИ — это системы, которые создают видео на основе промпта, изображения или существующего клипа без участия камеры или съемочной группы.
Они обучаются на огромных наборах данных, миллионах видеоклипов в паре с описаниями, и улавливают визуальные паттерны, которые связывают фразу вроде «собака бежит по снегу» с тем, как это на самом деле выглядит на экране.
Технология, лежащая в основе этого, называется диффузией. Модель начинает со случайного шума и очищает его в течение десятков шагов, пока не появится видео. Во время обучения она наблюдала, как реальные видео превращаются в шум, и научилась обращать этот процесс вспять. В момент генерации ваш промпт направляет каждый шаг очистки к описанной вами сцене.
Самое сложное — это не один кадр. Модель сохраняет согласованность сотен кадров друг с другом. Лицо, одежда или тень должны оставаться неизменными на протяжении всего клипа, а не просто выглядеть правильно по отдельности.
Видеомодели обрабатывают целые последовательности кадров вместе, чтобы каждый кадр мог ссылаться на другие, именно поэтому генерация видео требует гораздо больше вычислительных ресурсов, чем одно изображение.
Какие существуют различные типы ИИ-видеомоделей?
Прежде чем начать тестирование, мне пришлось разобраться, какой именно тип инструмента я использую, поскольку не каждый ИИ-генератор видео начинает с одного и того же.
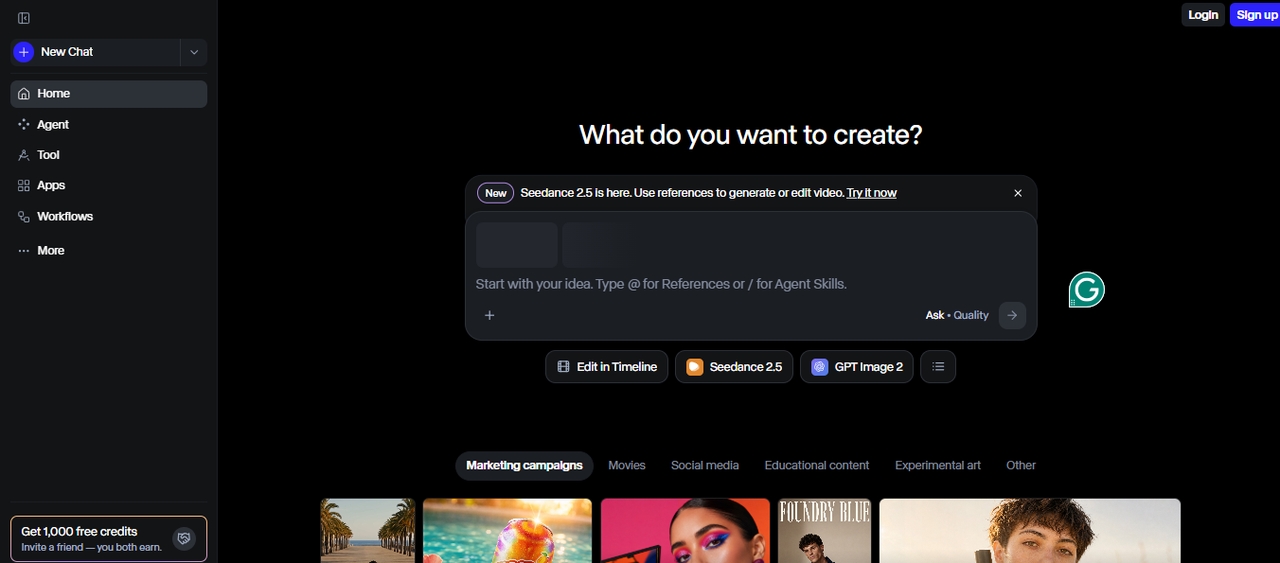
ИИ-модели генерации видео по тексту
Модели генерации видео по тексту превращают письменное описание в движущуюся сцену с нуля. Вы пишете то, что хотите, а модель создает визуальный ряд. Это лучше всего подходит, когда у вас есть идея, но нет исходных кадров или референсного изображения для начала, например, для концепта продукта, короткого сюжетного момента или сцены.
Модели генерации видео по изображению
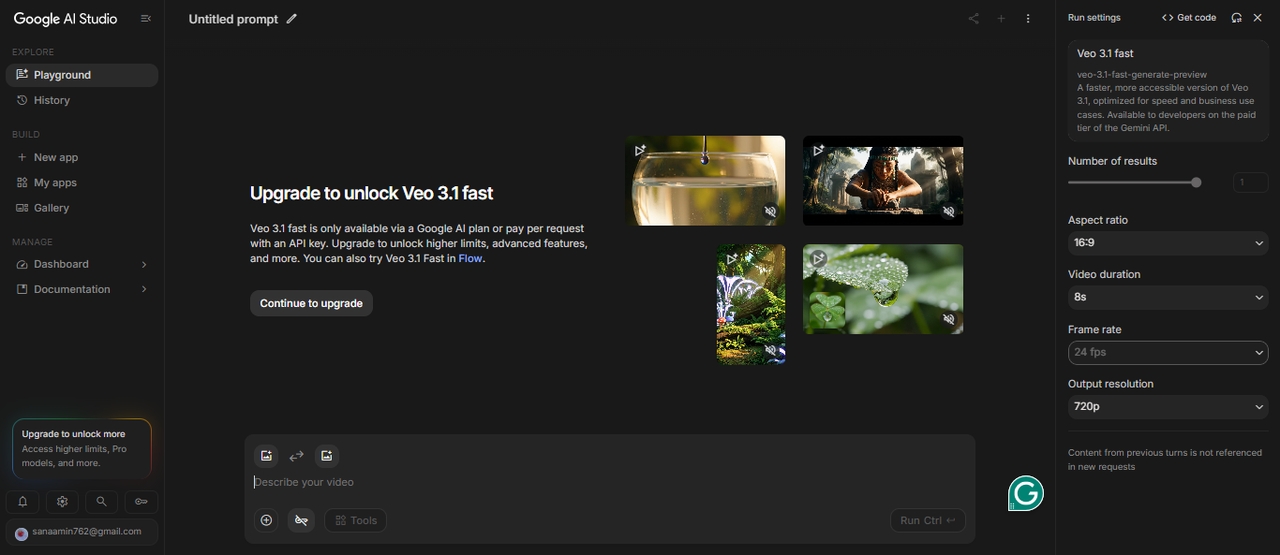
Модели генерации видео по изображению начинают с уже имеющейся у вас картинки и добавляют движение, перемещение камеры или небольшие изменения, чтобы оживить ее. Это подходит для демонстрации продуктов и постов в социальных сетях, где вам нужно быстрое движение без генерации всего с нуля.
Мультимодальные видеомодели
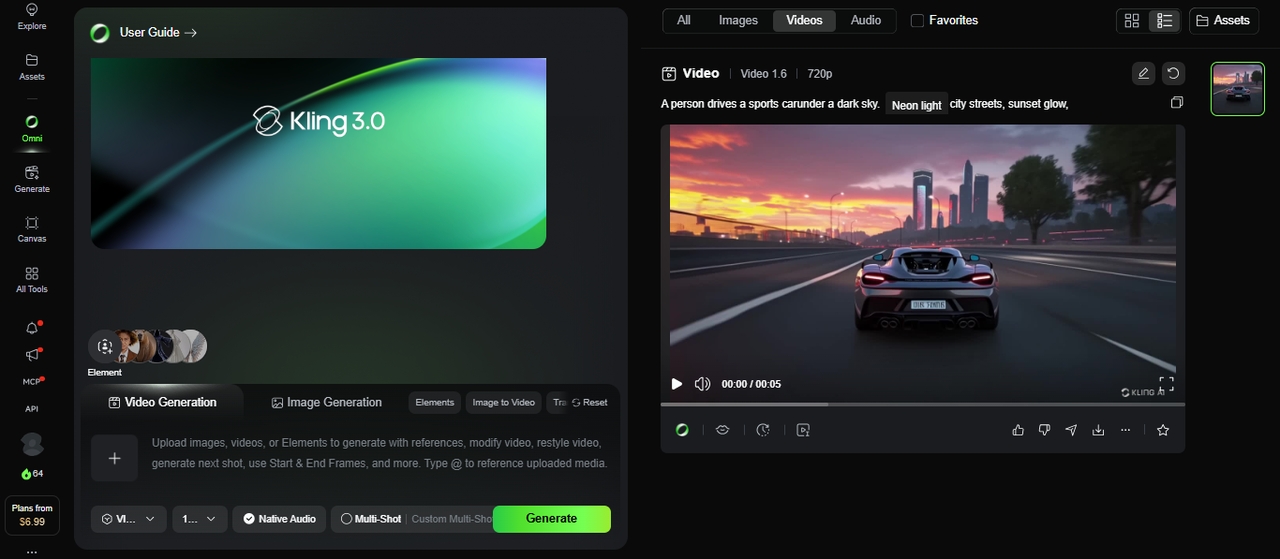
Эти модели работают более чем с одним типом входных данных одновременно. Вы можете смешивать текст, изображения, аудио и даже существующие видеоклипы, чтобы направлять конечный результат.
Это дает вам больше контроля над тем, каким получится видео. Вы не просто описываете сцену, вы формируете ее с помощью нескольких входных данных. Этот контроль помогает, когда вам нужны конкретные детали, более плавное повествование или видео, следующее четкому направлению.
Как мы тестировали каждую модель
Я контент-стратег, который последние два года зарабатывает на жизнь тестированием творческих инструментов ИИ, и я протестировал каждую ИИ-модель генерации видео с помощью одних и тех же пяти промптов, которые включают демонстрацию продукта, короткую сюжетную сцену, клип с говорящей головой, экшн-сцену и стилизованное художественное произведение.
Для каждой модели я сгенерировал как минимум три варианта на один промпт и оценил их по реалистичности, точности движений, соответствию промпту и качеству звука, где это было применимо.
8 ИИ-моделей генерации видео, и в чем каждая из них лучшая
После тестирования восьми ИИ-моделей генерации видео на демонстрациях продуктов, повествовательных сценах, клипах с говорящей головой, экшн-сценах и стилизованных визуальных эффектах я обнаружил, что ни одна модель не показала себя лучше всех во всех категориях. Veo 3.1 выделилась встроенным аудио, Runway Gen-4.5 — творческим контролем и согласованностью сцен, а Seedance 2.5 — более длинными клипами за один проход. Kling 3.0 оказалась отличным вариантом для сцен с активным движением, в то время как MiniMax H3 хорошо справлялась со смешанными входными данными и синхронизированным аудио. Wan 2.6, Mochi и HunyuanVideo предложили альтернативы для пользователей, предпочитающих модели с открытыми весами и локальные рабочие процессы, хотя требования к оборудованию и настройка могут быть ограничивающими факторами.
Эти результаты основаны на моих практических тестах, а не на универсальном рейтинге. Лучший выбор зависит от типа вашего видео, требований к результату, бюджета и того, предпочитаете ли вы облачный сервис или модель, которую можете запустить самостоятельно.
Ниже я подробно описываю сильные стороны, функции, плюсы и минусы каждой модели, чтобы помочь вам выбрать подходящую для вашего проекта.
Ниже представлены лучшие модели с закрытым исходным кодом, о которых вам следует знать прямо сейчас.
| Функция | Veo 3.1 | Runway Gen-4.5 | Seedance 2.5 | Kling 3.0 | MiniMax H3 |
| Макс. разрешение | 1080p | 1080p | 1080p нативное | 4K / 60 кадров/с, первая модель, достигшая нативного 4K при 60 кадрах/с | 2K при 24 кадрах/с, также доступно 768p |
| Макс. длина клипа | 8 секунд нативно, расширяется с помощью сторонних инструментов | До 16 секунд на Gen-4 | До 30 секунд в одном непрерывном дубле | До 2 минут, расширяется до 3 минут | 5–15 секунд, расширяется до 30 с помощью встроенного инструмента Extend |
| Частота кадров | 24–30 кадров/с | 24 кадра/с | Еще не опубликовано | 30 кадров/с | 24 кадра/с |
| Встроенное аудио | ✅ Диалоги, звуковые эффекты, фоновый звук | ✅ Добавлено в декабре 2025 | ✅ Более 10 языков | ✅ | ✅ Встроенное стерео |
| Мультимодальный ввод | ✅ До 3 референсных изображений | ❌ | ✅ До 50 референсов, 30 изображений, 10 видео, 10 аудио | ✅ Текст, изображение, аудио, видео | ✅ Текст, изображение, видео и аудио считываются как единый контекст |
| Многокадровая съемка | ❌ | ✅ | ✅ Один непрерывный дубль, без склеек | ✅ До 6 кадров | ❌ |
| Физический движок | ✅ | ❌ | Не указано | ✅ | Не указано |
| Быстрый / Черновой режим | ✅ Veo 3 Fast | ✅ Gen-4 Turbo | Еще не опубликовано | ✅ До 20 раз быстрее | ✅ Более легкий вариант 768p |
| Соотношение сторон | 16:9 и 9:16 | 16:9, 9:16, 1:1 | Еще не опубликовано | 16:9, 9:16, 1:1 | 21:9, 16:9, 4:3, 1:1, 3:4, 9:16 |
| Бесплатный тариф | ❌ | ❌ | Внедряется на Jimeng AI, Doubao, Dreamina | ✅ 66 ежедневных кредитов | Через приложение Hailuo AI |
| Лучше всего для | Реализм + аудио | Кинематографический контроль | Длинные клипы одним дублем + референсы | 4K + длинный формат | Мультимодальное редактирование + согласованность |
- Veo 3.1
Veo 3.1 — это флагманская модель генерации видео от Google, и именно аудио выделило ее среди остальных в ходе моего тестирования. Она генерирует диалоги, звуковые эффекты и фоновый звук за тот же проход, что и видео, и все это по одному промпту. После запуска в октябре 2025 года она стала движущей силой волны вирусных роликов в социальных сетях, а ее интеграция с Google Workspace позволила легко вписать ее в те части моего рабочего процесса, которые уже существуют в этой экосистеме.
Функции
- Встроенное аудио: диалоги, звуковые эффекты и фоновый звук за один проход.
- Разрешение 4K: вывод в сверхвысоком разрешении.
- Мультиреференс: поддерживает до 3 референсных изображений.
- Большая длительность: создание видео длительностью до одной полной минуты.
- Диалог в промпте: написание речи персонажа прямо в промпте.
Плюсы
- Непревзойденное качество встроенного аудио.
- Отличный реализм и точность освещения.
- Глубокая интеграция с экосистемой Google.
- Высокая точность следования промпту.
Минусы
- Видео с водяными знаками на более дешевых тарифах.
- Менее гибкая для стилизованного или нереалистичного контента.
- Runway Gen-4.5
Компания Runway уже много лет является заметным игроком в сфере генеративных ИИ-моделей видео, и именно в Gen-4.5, выпущенной в конце 2025 года, я заметил наибольший скачок в качестве и многокадровой последовательности. Ее чат-интерфейс позволил мне дорабатывать видео, описывая изменения в диалоге, вместо того чтобы переписывать промпт с нуля. Из всего, что я протестировал, это модель, которую я бы порекомендовал творческому профессионалу, когда важна согласованность сцен и персонажей в нескольких кадрах.
Функции
- Кисти движения: точно закрашивайте те части сцены, которые должны двигаться.
- Мультикадр: объединяйте несколько клипов в одну связную последовательность.
- Act-one: захват мимики и движений.
- Редактирование через чат: улучшайте результаты с помощью обычного диалога.
- Вывод в 4K: экспорт в ультравысоком разрешении.
Плюсы
- Лучшая в своем классе согласованность сцен и персонажей.
- Мощные инструменты творческого контроля для профессионалов.
- Сильное сообщество и экосистема.
Минусы
- Дорого на более высоких тарифных планах.
- Медленнее, чем некоторые конкуренты, при создании быстрого контента для соцсетей.
- Более сложный процесс освоения для новичков.
- Seedance 2.5
Seedance 2.5 — это продолжение Seedance 2.0 от ByteDance, которая возглавляла Artificial Analysis Video Arena как в категории text-to-video, так и в image-to-video ранее в 2026 году. Новая версия увеличивает продолжительность генерации за один проход с 15 секунд до полных 30, переходит на нативное разрешение 1080p и принимает до 50 мультимодальных референсов (смесь изображений, видео и аудио) за одну генерацию по сравнению с 12 в предыдущей версии. Она также добавляет нативное аудио на более чем 10 языках, и я протестировал ее во время развертывания в Jimeng AI, Doubao и Dreamina, а доступ к API предоставляется через BytePlus ModelArk.
Функции
- Увеличенная генерация за один проход: до 30 секунд в одном непрерывном клипе, склейка не требуется.
- Нативное разрешение 1080p: по сравнению с 720p в предыдущей версии.
- Расширенная поддержка референсов: до 50 мультимодальных референсов (30 изображений, 10 видео, 10 аудио) за одну генерацию.
- Нативное мультиязычное аудио: диалоги и звук на более чем 10 языках.
- Точное редактирование: заменяйте продукт, удлиняйте кадр или вносите точечные изменения без повторной генерации всего клипа.
- Предварительная визуализация 3D-белой модели: намечайте движения камеры и кадры перед тем, как запускать полную генерацию.
Плюсы
- Длинные клипы, снятые одним дублем, хорошо подходят для короткометражных драм и сериального контента.
- Отличная непрерывность движения камеры от кадра к кадру на протяжении всего 30-секундного дубля.
- Увеличенное количество референсов дает больше контроля над согласованностью персонажей и продуктов.
Минусы
- ByteDance еще не опубликовала полный технический отчет, поэтому некоторые характеристики взяты из демонстраций запуска, а не из независимого тестирования.
- На момент тестирования полный доступ к API был запущен еще не везде.
- Kling 3.0
Kling 3.0 была запущена 4 февраля 2026 года, и уже через несколько дней ее назвали крупнейшим прорывом года в области генерации ИИ-видео. Она работает на архитектуре Omni One, которая сочетает в себе 3D Spacetime Joint Attention с цепочкой рассуждений (chain-of-thought), благодаря чему гравитация, баланс, деформация и инерция в моих тестах выглядели реалистично, а не как резина. Модель принимает мультимодальные входные данные (текст, изображения, аудио и видео) и генерирует нативное аудио на английском, китайском, японском, корейском и испанском языках, позволяя управлять диалогами персонажей и очередностью их реплик.
Особенности
- Физика Omni One: реалистичная симуляция гравитации, столкновений и инерции.
- Нативное аудио: закадровый голос, синхронизация губ (lip-sync), звуковые эффекты (SFX) и музыка.
- Многокадровая раскадровка: до 6 кадров с режиссерским контролем камеры.
- Черновой режим: генерация до 20 раз быстрее для быстрого прототипирования.
- Вывод в 4K/60fps: с поддержкой 16-битного HDR и экспорта в EXR.
- Редактор 7-в-1: добавление объектов, замена фона, перенос стиля в одном инструменте.
Плюсы
- Самая реалистичная физика и движения человека из доступных.
- Нативное многоязычное аудио с контролем диалектов и акцентов.
- Доступный порог входа от $7.99/месяц с хорошим бесплатным тарифом.
- Экспорт напрямую в профессиональные пайплайны VFX (Nuke, After Effects, DaVinci).
Минусы
- Рендеринг 15-секундного многокадрового видео может занять более 5 минут.
- Вывод в 4K на данный момент доступен только на более дорогих тарифных планах.
- Периоды высокого спроса увеличивают очереди на рендеринг.
- MiniMax H3
MiniMax H3, также известная как Hailuo 3.0, следует за Hailuo 02 в линейке видеомоделей MiniMax. Вместо того чтобы обрабатывать текстовые, графические, видео- и аудиореференсы как отдельные входные данные, она считывает их все вместе как единый общий контекст, а затем возвращает синхронизированное видео и аудио в одном результате. MiniMax заявила, что планирует опубликовать веса модели, хотя я получил к ней доступ через приложение Hailuo AI, API MiniMax Open Platform и хостинг-партнеров, таких как fal.
Особенности
- Единый мультимодальный контекст: текстовые, графические, видео- и аудиореференсы обрабатываются вместе в рамках одной генерации.
- Встроенное стереоаудио: диалоги, музыка, эффекты и атмосфера создаются вместе с видео, а не накладываются поверх позже.
- Разрешение до 2K при 24 кадрах в секунду, также доступно разрешение 768p в качестве более легкого варианта.
- Генерации длительностью от 5 до 15 секунд, которые можно увеличить до 30 секунд с помощью встроенного инструмента Extend Video.
- Целевое редактирование: заменяйте или удаляйте персонажей и объекты, меняйте освещение или фон, либо корректируйте диалоги без необходимости переделывать весь клип.
- Несколько соотношений сторон: 21:9, 16:9, 4:3, 1:1, 3:4 и 9:16.
Плюсы
- Высокая временная согласованность; движение остается стабильным на протяжении всего клипа, а не искажается на полпути.
- Встроенное стереоаудио создается за тот же проход генерации, без отдельного этапа озвучивания.
- Поддержка широкого диапазона соотношений сторон подходит для всего: от кинематографического широкоэкранного формата до вертикального контента для соцсетей.
Минусы
- MiniMax еще не опубликовала полный технический отчет, поэтому некоторые заявления исходят от самой компании, а не из независимых тестов.
- Для локального запуска версии с открытыми весами после их релиза потребуется высокопроизводительный графический процессор с объемом видеопамяти (VRAM) от 24 ГБ.
| Характеристика | Wan 2.2 | Mochi 1 (Genmo) | HunyuanVideo (Tencent) |
| Параметры | 1.3B / 14B | 10B | 13B |
| Макс. разрешение | 720p (1080p на 14B) | 480p (640x480) | 720p (1080p с v1.5) |
| Макс. длина клипа | До 10 секунд | До 5.4 секунд при 30 кадрах/сек | До 5 секунд (720p) |
| Частота кадров | 16 кадров/сек | 30 кадров/сек | 24 кадра/сек |
| Мин. объем видеопамяти (VRAM) | 8 ГБ (модель 1.3B) | Более 20 ГБ при полной точности | 14 ГБ (v1.5) / 60–80 ГБ (оригинальная) |
| Скорость генерации | 1–2 мин для клипа 4–5 сек (GPU 8 ГБ) | 3–4 мин для клипа 5.4 сек | 6–10 мин для клипа 5 сек (GPU 16 ГБ) |
| Text-to-Video | ✅ | ✅ | ✅ |
| Image-to-Video | ✅ | ❌ | ✅ |
| Тонкая настройка LoRA | ✅ | ✅ | ✅ (требуются высокие вычислительные мощности) |
| Поддержка ComfyUI | ✅ | ✅ | ✅ |
| Поддержка Diffusers | ✅ | ❌ | ✅ |
| Двуязычные промпты | ✅ Английский + Китайский | ❌ | ❌ |
| Лицензия | Apache 2.0 | Apache 2.0 | Tencent Community License |
| Подходит для потребительских GPU | ✅ Лучший в своем классе | ❌ | ⚠️ только v1.5 |
| Лучше всего подходит для | Универсальность + доступность | Фотореализм + тонкая настройка | Кинематографическое качество + лица |
- Wan 2.6
Wan 2.6 — это серия моделей генерации видео от Alibaba, выпущенная в декабре 2025 года. Она поддерживает генерацию text-to-video, image-to-video и reference-to-video. Ее основные преимущества включают многокадровое повествование, улучшенное следование промптам и аудио, которое остается синхронизированным с визуальным рядом. Модель reference-to-video также может использовать референсный клип для сохранения внешнего вида и голоса человека или объекта в новых сгенерированных сценах.
Wan 2.6 остается отличным вариантом для создателей контента, которые хотят поэкспериментировать со сгенерированными ИИ сценами, видеороликами о продуктах или клипами с диалогами.
Особенности
- Архитектура MoE: специализированные эксперты для различных стадий шума.
- Гибридный T2V/I2V: текстовый и графический ввод в одной унифицированной модели.
- Квантование GGUF: работает на потребительских GPU с 4 ГБ VRAM.
- Кинематографическое управление: метки освещения, контраста и цветового тона.
- Двуязычная поддержка: обработка промптов на английском и китайском языках.
- Хостинг-доступ: Используйте поддерживаемые модели Wan через Alibaba Cloud Model Studio
Плюсы
- Поддерживает несколько рабочих процессов генерации видео в рамках одного семейства моделей.
- Мультикадровое управление подходит для коротких историй, рекламы и демонстрации продуктов.
- Функция Reference-to-video помогает сохранить идентичность персонажа в генерируемых сценах.
- Предлагает функции синхронизированного аудио и диалогов в поддерживаемых вариантах.
Минусы
- Клипы короткие, поэтому для более длинных проектов может потребоваться несколько генераций и монтаж.
- Хостинг-доступ может повлечь за собой плату за API или ограничения, специфичные для сервиса.
- Mochi (Genmo)
Mochi 1 — это модель с 10 миллиардами параметров, построенная на новой архитектуре AsymmDiT и выпущенная под лицензией Apache 2.0. В моих тестах она показала себя лучше всего при создании фотореалистичного движения с частотой 30 кадров в секунду, что делает ее подходящей для кадров в документальном стиле, природных ландшафтов и движений человека, которые должны выглядеть реалистично. Это была одна из первых моделей с открытым исходным кодом, которая заставила меня серьезно отнестись к локальной генерации видео.
Особенности
- Основа AsymmDiT: специально разработанная архитектура для видеосинтеза.
- Вывод 30 кадров/с: плавное движение при исходной частоте кадров.
- Тонкая настройка LoRA: настройка на собственных наборах видеоданных.
- Лицензия Apache 2.0: открыта для исследований и коммерческого использования.
- Интеграция с ComfyUI: поддержка рабочих процессов на основе узлов.
- Кодирование T5-XXL: отличное понимание текста и следование промптам.
Плюсы
- Самое мягкое лицензирование среди всех высококачественных открытых моделей.
- Отличное фотореалистичное движение и естественные движения.
- Сильное сообщество с активным обменом моделями тонкой настройки.
Минусы
- Ограничение разрешения 480p; требуется апскейлинг для вывода в HD.
- Требуется более 20 ГБ видеопамяти (VRAM) при полной точности.
- HunyuanVideo (Tencent)
HunyuanVideo — это флагманская видеомодель с открытым исходным кодом от Tencent, созданная для высококачественной генерации с высокой согласованностью движений и более чистой структурой сцены, чем у большинства открытых альтернатив, которые я пробовал. Ее архитектура на базе трансформера обрабатывает визуальные и временные данные вместе, и я прибегал к ней всякий раз, когда мне требовалось больше контроля над процессом генерации, чем мог предоставить облачный инструмент.
Особенности
- Крупнейший масштаб 1B в категории моделей с открытым исходным кодом.
- Двухпотоковое слияние: раздельная обработка текста и видео перед объединением.
- Параллелизм xDiT: последовательный параллелизм на нескольких GPU для более быстрого вывода.
- Квантование FP8: снижение потребления памяти без существенной потери качества.
- Diffusers + comfyUI: интеграция в экосистему по принципу plug-and-play.
- Causal 3D VAE: пространственно-временное сжатие для согласованного движения.
Плюсы
- Лучшее кинематографическое качество и реализм лиц среди моделей с открытым исходным кодом.
- Огромная экосистема LoRA для кастомизации стилей и персонажей.
- Отличная обработка сцен с несколькими людьми и сложных сцен.
Минусы
- Создание 5-секундного клипа может занять более 15 минут в зависимости от настроек.
- Высокая сложность настройки; не подходит для новичков.
Изучите лучшие ИИ-видеомодели на Framia Pro
Вот реальная проблема, с которой я столкнулся: я не хотел заводить аккаунт Google для Veo, подписку Runway для Gen-4.5 и логин Kuaishou для Kling, а затем повторять эту настройку каждый раз при выходе новой модели. Именно поэтому я перенес большую часть этого тестирования на Framia Pro.
Framia Pro объединяет Veo 3.1, Kling 3.0, Seedance 2.5 и другие ведущие модели видео и изображений в одном рабочем пространстве. Я мог начать с идеи и превратить ее в видео, используя текст, изображения, аудио или смесь всех трех компонентов, не переключая вкладки и не оплачивая отдельный аккаунт для каждой модели. Встроенные творческие агенты также охватывают конкретные сценарии использования, такие как музыкальные клипы, реклама и сторителлинг, так что у меня была отправная точка независимо от того, что я создавал.
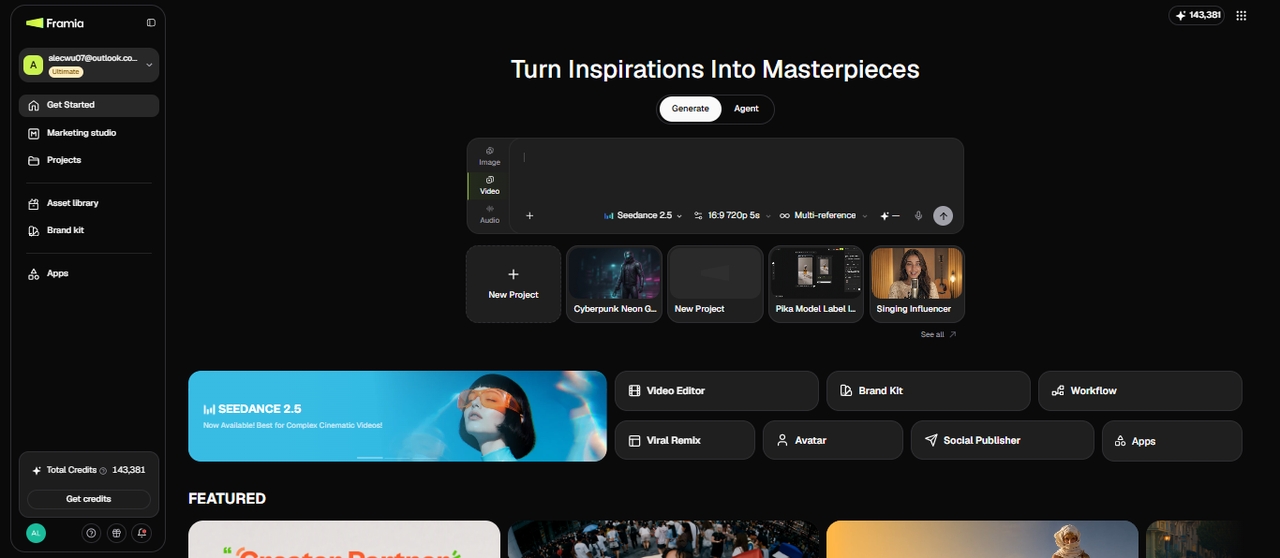
Что предлагает Framia Pro?
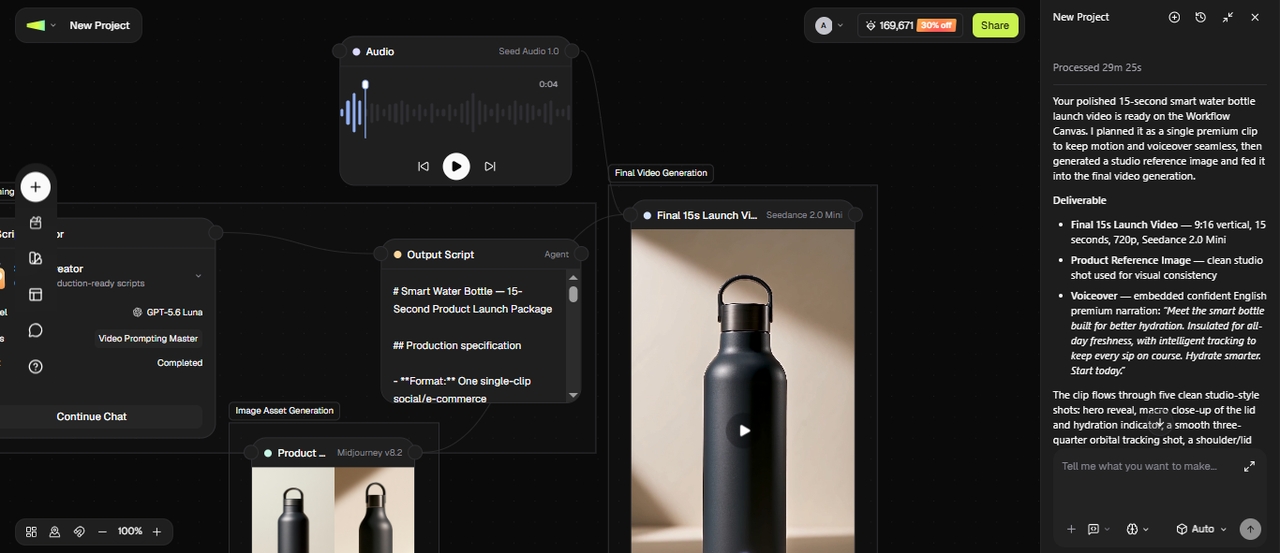
Я попробовал создать видео для запуска продукта электронной коммерции на холсте. Я начал с агента Image для генерации чистых снимков продукта, передал их в узел Video, который превратил их в демонстрационный ролик с помощью Kling или Seedance, а затем направил результат через узел Audio для соответствующей озвучки — и все это на одном холсте вместо четырех отдельных инструментов.
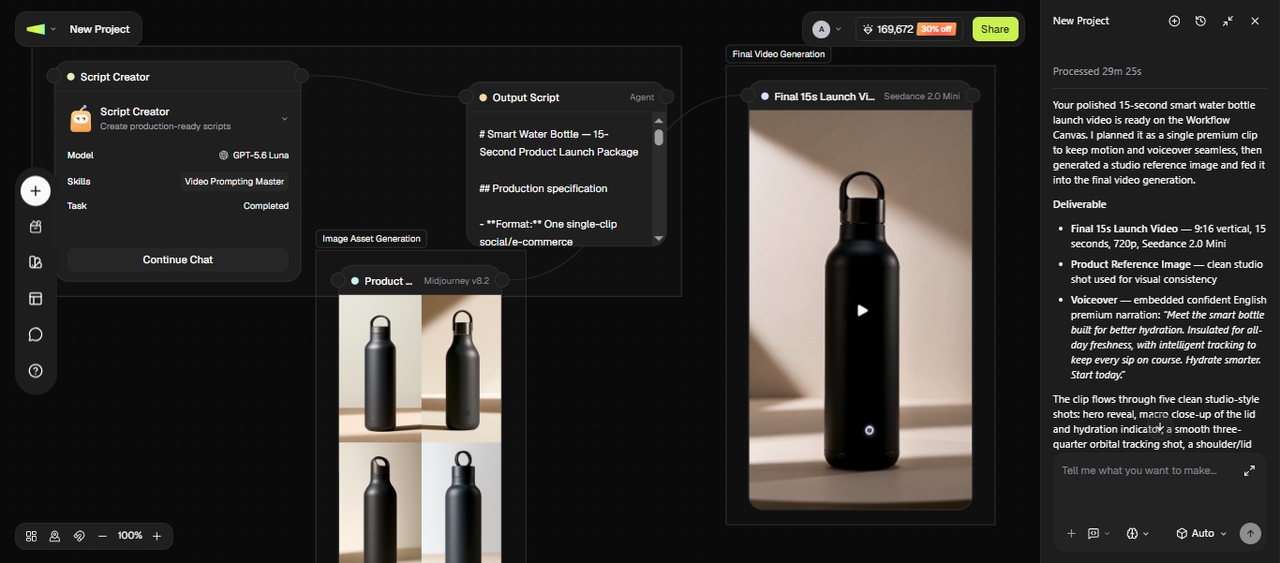
Вот функции, которые помогли мне в процессе:
- Выделенные агенты Image, Audio и Video: Я использовал агент Video для превращения промптов, сценариев или изображений в полноценные клипы с помощью моделей, указанных выше, а агенты Image и Audio — для создания миниатюр, озвучки и музыки, когда они требовались мне отдельно.
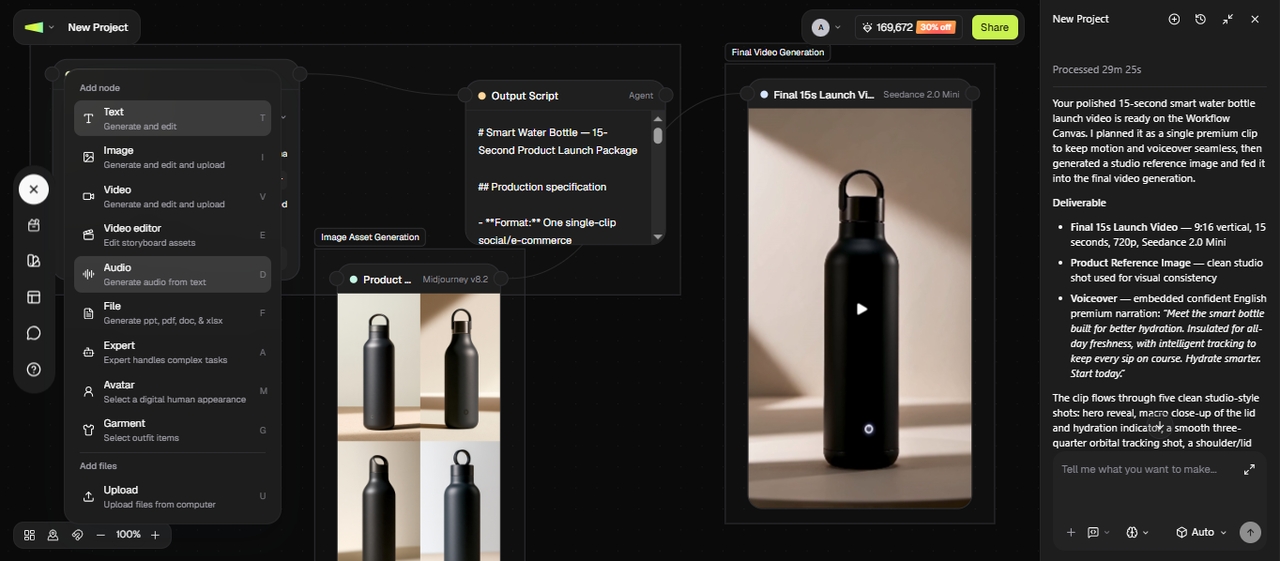
- Изменение промпта и повторная генерация: Я описал желаемое изменение простым текстом, и Framia Pro применил его без необходимости использования таймлайна или инструментов ручного редактирования. Я корректировал сцены, вырезал части и улучшал визуальные эффекты без какого-либо предварительного опыта монтажа.
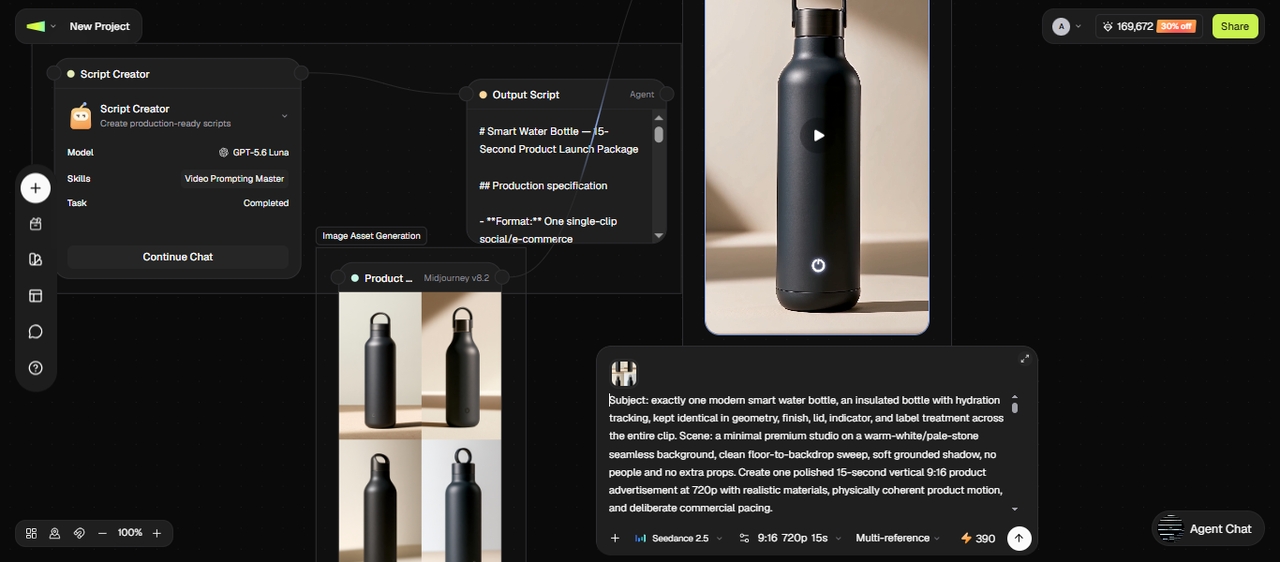
- Навыки для сценариев, обзора и адаптации контента: Я превратил черновую идею в структурированный сценарий, прогнал готовое видео через анализ темпа и удержания внимания, а также нарезал одно длинное видео на несколько более коротких клипов, готовых для публикации на платформах.
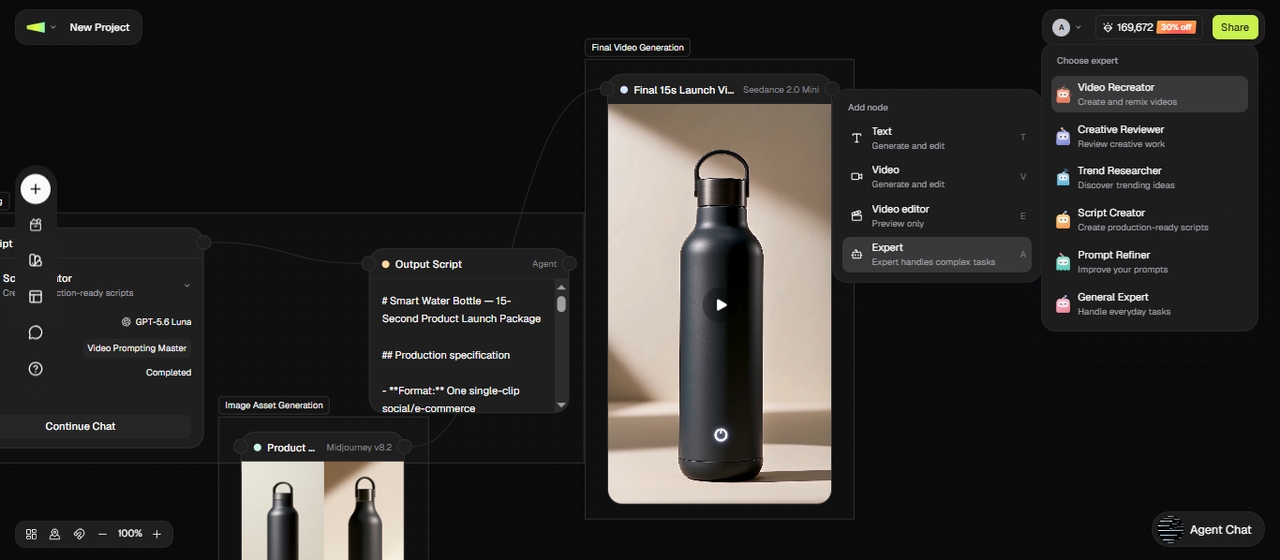
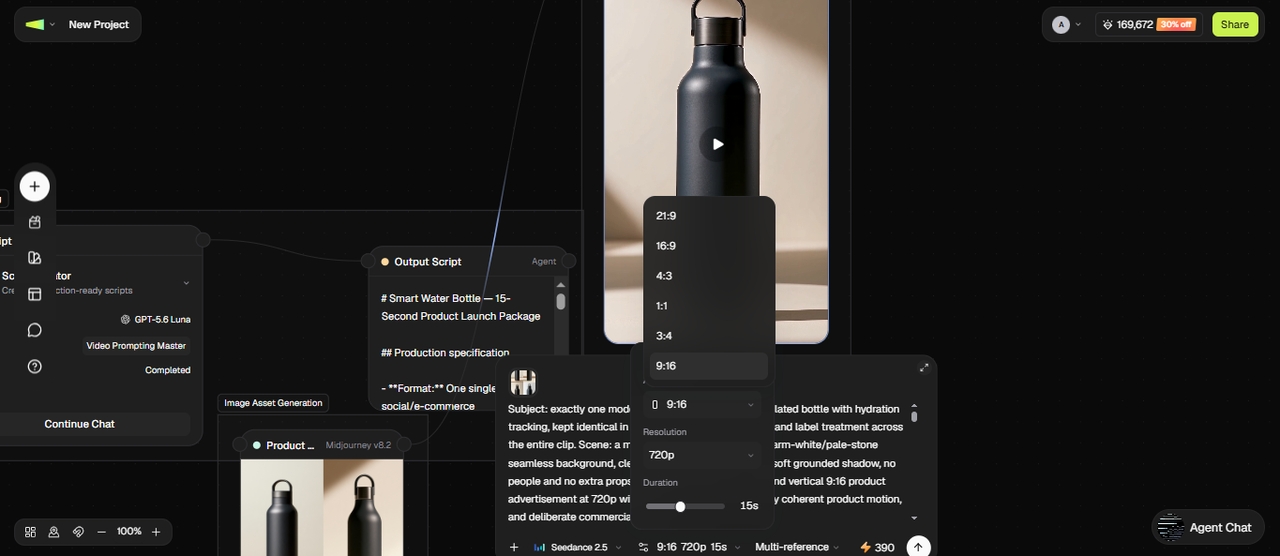
- Различная длительность и соотношения сторон: Я создавал клипы разной длины для разных проектов — в вертикальном, квадратном или широкоэкранном формате, поэтому версии для TikTok, Instagram и YouTube были готовы без дополнительного изменения размера.
- Синхронизация аудио с вашими клипами: Framia Pro синхронизирует звук с визуальным рядом, поэтому диалоги, музыка или эффекты соответствуют таймингу видео. Он сопоставляет движения губ с речью и выравнивает звук по изменениям сцен, сокращая необходимость ручной настройки аудио при монтаже.
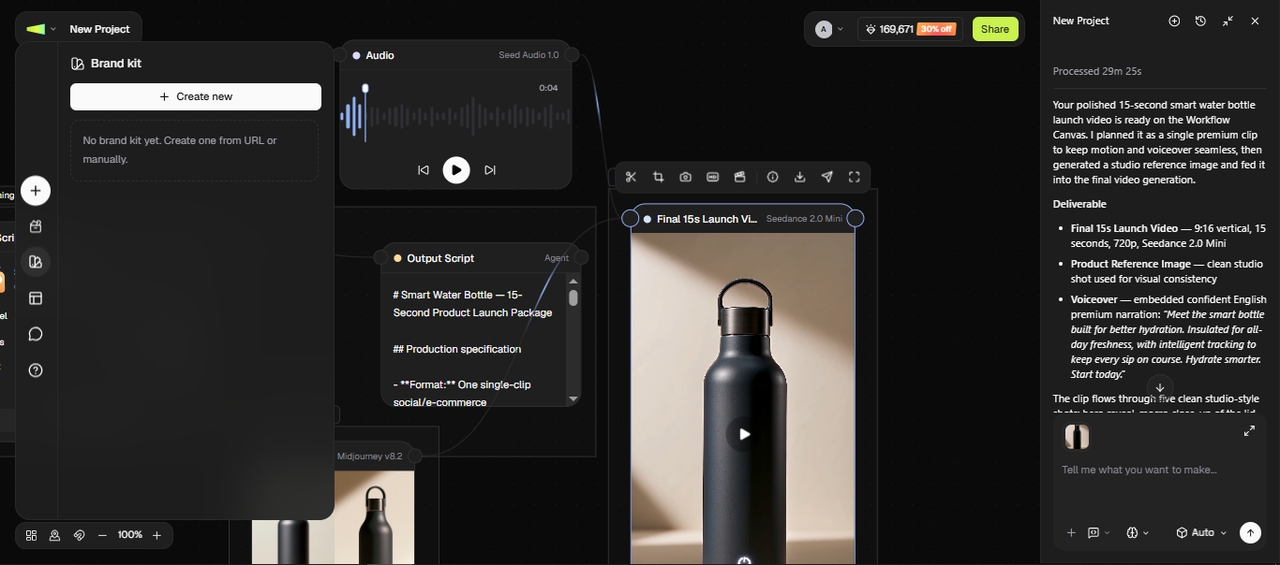
- Brand Kit: Я один раз сохранил свои цвета, шрифты и логотип, а затем применял их ко всем видео, сгенерированным с помощью любой модели в рабочем пространстве.
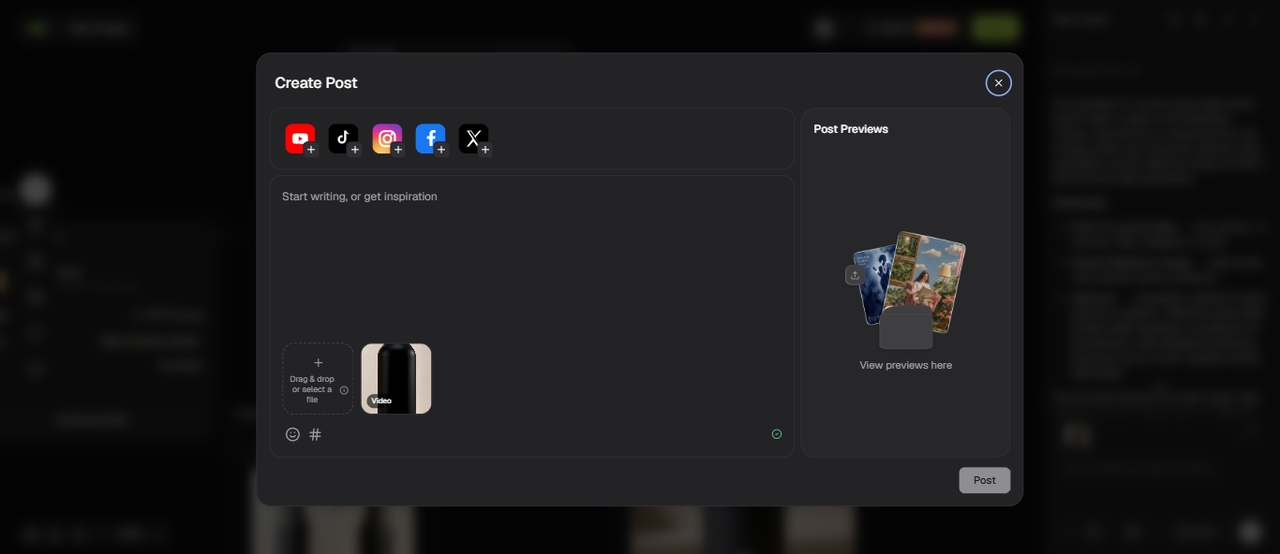
- Прямой экспорт из Publisher: Я отправил готовое видео в TikTok прямо из Framia Pro, без отдельного шага скачивания и загрузки.
Заключение
В этой статье мы изучили, что такое модели генерации AI-видео и рассмотрели 5 коммерческих и 3 инструмента с открытым исходным кодом, которые вы можете использовать для своего проекта. Прежде чем выбирать модель, сфокусируйтесь на своей цели. Некоторые инструменты подходят для быстрых роликов для соцсетей, в то время как другие лучше работают для сторителлинга или высококачественных сцен со звуком и детализацией. Когда вы подбираете модель под конкретную задачу, результаты получаются более точными, а управлять процессом становится проще. Если вы хотите получить доступ к нескольким ведущим AI-видеомоделям в одном месте, попробуйте Framia Pro и переключайтесь между инструментами в зависимости от потребностей вашего проекта.
Часто задаваемые вопросы
Какие AI-модели для генерации видео лучшие на данный момент?
В число лучших AI-моделей для генерации видео входят Veo, Runway, Seedance 2.5, Kling и MiniMax H3. Каждая из них имеет свои сильные стороны, такие как реализм, движение, звук или простота использования. На Framia Pro вы можете получить доступ к нескольким из этих моделей и переключаться между ними в зависимости от вашего проекта.
Что происходит с видеомоделью Sora?
Новость о видеомодели Sora раскрыла, что в 2026 году её поддержка в качестве потребительского приложения и API была прекращена. OpenAI решила закрыть её, чтобы сосредоточиться на других областях, таких как робототехника и передовые исследования.
Доступны ли генераторы видео на базе ИИ с открытым исходным кодом?
Да, доступны генераторы видео на базе ИИ с открытым исходным кодом, такие как Wan, Mochi и HunyuanVideo. Вы можете запускать их локально и настраивать под свои нужды, хотя настройка требует технических знаний. Framia Pro предлагает более простой вариант, если вы предпочитаете готовые к использованию модели без локальной установки.
Могут ли ИИ-модели для создания видео генерировать длинные видео?
Большинство ИИ-моделей для создания видео по-прежнему ориентированы на короткие клипы, а не на полнометражные видео. Некоторые инструменты позволяют создавать более длинные сцены, но часто требуют объединения нескольких клипов. Framia Pro поддерживает различную длительность, поэтому вы можете создавать клипы и управлять ими в соответствии со своими потребностями.
Какую ИИ-модель для создания видео вам следует использовать?
Вам следует выбирать модель на основе ваших целей и стиля контента. Veo отлично подходит для реалистичных сцен, Kling хорошо справляется с движением, а Seedance дает больше контроля благодаря нескольким входным параметрам. видеоагент Framia Pro позволяет вам тестировать эти модели в одном месте и выбирать то, что подходит для вашего рабочего процесса.
Платное ли использование ИИ-моделей для генерации видео?
Большинство из них платны, хотя цены сильно различаются. Некоторые взимают плату за клип, в то время как другие работают по ежемесячной подписке с лимитом кредитов. Модели с открытым исходным кодом, такие как Wan или Mochi, можно запускать бесплатно, но вам потребуется собственное графическое оборудование (GPU).
Могу ли я использовать созданные ИИ видео в коммерческих проектах?
Это зависит от лицензии модели и вашего уровня подписки. Модели с лицензией Apache 2.0, такие как Wan 2.2, Mochi и HunyuanVideo, разрешают коммерческое использование. Для инструментов с закрытым исходным кодом, таких как Veo, Runway или Kling, ознакомьтесь с условиями коммерческого использования конкретного тарифного плана перед публикацией созданного видео в платных или брендированных проектах.
Какие ИИ-модели для создания видео поддерживают встроенное аудио?
Несколько современных моделей генерируют аудио одновременно с видео, а не добавляют его после. Veo 3.1, Kling 3.0, Seedance 2.5 и MiniMax H3 поддерживают встроенное аудио, включая диалоги, звуковые эффекты и фоновые звуки, привязанные к происходящему на экране.