Поделиться


Ключевые выводы
- Модели генерации изображений с открытым исходным кодом позволяют создавать и редактировать изображения без регулярной подписки или отдельных лицензионных сборов за использование моделей.
- На Hugging Face размещено почти 109 255 моделей text-to-image, поэтому у создателей контента есть широкий выбор вариантов в зависимости от стиля, скорости и требований к оборудованию.
- Stable Diffusion 3.5, FLUX и Qwen-Image-2512 лидируют в сфере общей творческой работы, точности следования промптам и коммерческого лицензирования.
- ControlNet 1.1 и Waifu Diffusion закрывают специализированные потребности, такие как структурный контроль и искусство в стиле аниме.
- Z-Image-Turbo и GLM-Image выделяются своей скоростью и генерацией изображений с большим количеством текста, таких как постеры и инфографика.
- Framia Pro объединяет закрытые модели, такие как Nano Banana Pro, Midjourney v7 и Seedream 4.5, в одном рабочем пространстве для создателей контента, которые хотят получать результаты без необходимости настройки локального окружения.
Модели генерации изображений с открытым исходным кодом открыли совершенно новый мир для создателей контента, разработчиков и бизнеса. Теперь вы можете превращать текст в изображения, редактировать фотографии, создавать видео и 3D-объекты, не тратя целое состояние на программное обеспечение. Эта сфера быстро развивается: только на моделей text-to-image доступно на Hugging Face. Переход на открытый исходный код означает отсутствие подписок, полный контроль над вашими данными и свободу настраивать все так, как вам нужно. В этом руководстве рассматриваются лучшие модели и все остальное, что вам нужно для быстрого старта.
Что такое модели генерации изображений с открытым исходным кодом?
Модели генерации изображений с открытым исходным кодом — это программное обеспечение, которое создает изображения на основе письменных описаний. Вы вводите то, что хотите увидеть, например, закат в горах, макет продукта или персонажа мультфильма, и модель выдает это в виде изображения.
Представьте, что вы нанимаете художника, который всю жизнь изучал миллионы картин, фотографий и иллюстраций. Вы описываете то, что хотите, и он рисует это для вас за секунды. Только этот художник никогда не спит, не берет плату за проект и живет на вашем собственном компьютере.
Что делает их «открытыми» (open source), так это то, что их код общедоступен. Любой желающий может бесплатно скачать, использовать, изменить или доработать их. Это отличается от платных инструментов, таких как Midjourney или Adobe Firefly, где вы платите за доступ к программному обеспечению и не можете контролировать, как оно работает изнутри.
Эти модели обучаются на миллионах изображений, что помогает им понимать связь между словами и визуальными образами. Со временем они стали достаточно хороши, чтобы выдавать результаты профессионального качества, а лучшие из них теперь конкурируют с дорогими коммерческими аналогами.
Почему стоит выбрать открытый исходный код вместо закрытых моделей изображений
Платные модели изображений удобны, но имеют существенные ограничения. Вы платите за каждое изображение, передаете свои данные на сторонние серверы и никак не влияете на работу программного обеспечения. Модели с открытым исходным кодом решают все эти проблемы. Вот почему все больше создателей контента и разработчиков делают выбор в их пользу.
- Полный контроль над результатами
В случае с закрытыми инструментами платформа сама решает, что вы можете генерировать, а что нет. Модели с открытым исходным кодом работают на вашем собственном оборудовании, поэтому правила устанавливаете вы. Вы получаете именно то, что просите, без контент-фильтров и ограничений платформы.
- Возможность тонкой настройки моделей
Закрытые модели заблокированы, и их нельзя изменить под ваши конкретные нужды. Однако вы можете дополнительно обучить модели с открытым исходным кодом на собственных изображениях, стилях или руководствах по бренду. Это означает, что результат будет выглядеть уникальным и соответствовать вашему стилю, а не стилю всех остальных, кто использует тот же инструмент.
- Отсутствие платы за каждое изображение
Большинство коммерческих инструментов берут плату за каждое сгенерированное изображение, что быстро складывается в приличную сумму. Но с моделями с открытым исходным кодом вы запускаете все на собственном оборудовании и генерируете столько изображений, сколько хотите. Единственные затраты — это электричество и работа ваших компьютеров.
- Конфиденциальность и автономное использование
Когда вы используете облачный инструмент, ваши промпты и изображения проходят через чужие серверы. Модели с открытым исходным кодом могут работать полностью в автономном режиме, поэтому ничто не покидает ваш компьютер. Это имеет огромное значение для компаний, работающих с конфиденциальными проектами или проприетарным контентом.
- Поддержка огромного сообщества
За моделями с открытым исходным кодом стоят тысячи разработчиков, исследователей и создателей контента по всему миру. Они ежедневно делятся тонко настроенными версиями, руководствами, плагинами и исправлениями. Если вы столкнетесь с проблемой, скорее всего, кто-то в сообществе ее уже решил.
Как я тестировал и выбирал эти модели
Я работаю с творческими инструментами ИИ, и мне надоело видеть списки «лучших», которые просто копируют спецификации со страницы модели на GitHub. Поэтому, прежде чем составлять этот рейтинг, я провел неделю, лично запуская каждую модель, чтобы посмотреть, как она работает в реальности, а не на маркетинговых скриншотах.
Дома у меня есть дополнительный настольный компьютер с RTX 4090 и 24 ГБ видеопамяти (VRAM), который и стал моим основным тестовым стендом. Для более крупных моделей, требующих больше памяти, таких как FLUX.2 на 32B и Qwen-Image-2512, я арендовал облачный графический процессор с почасовой оплатой, вместо того чтобы гадать об их результатах только по спецификациям.
Я составил набор из 20 промптов и прогнал один и тот же список через каждую модель без какого-либо предвзятого отбора. Промпты охватывали пять областей: фотореалистичный портрет, снимок продукта на однотонном фоне, плакат с заголовком и мелким шрифтом, персонаж в стиле аниме и сложная сцена с несколькими объектами. Каждая модель получила по три попытки на промпт, и я оставил лучший из трех вариантов — именно так большинство людей и используют эти инструменты на практике.
Для оценки я выставлял каждому результату балл от 1 до 5 по четырем критериям: насколько точно результат соответствует промпту, насколько четко выглядят мелкие детали в полном разрешении, сколько времени заняла генерация на моем оборудовании и получился ли текст внутри изображения (когда этого требовал промпт) действительно читаемым. Я записывал результаты в таблицу по ходу дела, а не полагался на память потом, так как после целого дня тестирования некоторые модели начали сливаться в одну.
Кое-что сразу бросилось в глаза. Z-Image-Turbo справилась с пакетом из 20 промптов менее чем за четыре минуты в общей сложности, в то время как FLUX 2 на 32B на арендованном графическом процессоре потребовалось около 40 минут. GLM-Image и Qwen-Image-2512 оказались единственными двумя моделями, которые стабильно правильно передавали мелкий текст на плакате без искажения букв. Waifu Diffusion с большим отрывом победила в категории аниме, но сильно уступила в фотореалистичном портрете, что вполне ожидаемо от модели, обученной на узком наборе данных.
Я составил рейтинг из семи моделей ниже на основе этого тестирования, а не просто по бумажным характеристикам или хайпу в сообществе, и отметил случаи, когда реальное использование видеопамяти (VRAM) моделью оказывалось выше официального минимума после загрузки полного конвейера с приличным размером пакета.
Топ-7 моделей генерации изображений с открытым исходным кодом
Различные генераторы изображений на базе ИИ с открытым исходным кодом ориентированы на разные сильные стороны, такие как реализм, скорость, контроль структуры или точность текста. Ниже представлены семь широко используемых моделей, каждая из которых имеет четкое назначение.
| Модель | Архитектура | Мин. VRAM | Лицензия | Ключевые преимущества | Лучше всего подходит для |
| Stable Diffusion 3.5 | Латентная диффузия (DiT) | 8 ГБ+ | Коммерческая | Большая экосистема, поддержка LoRA, активное сообщество | Общая творческая работа, новички, рабочие процессы на основе плагинов |
| ControlNet 1.1 | Обусловленное дополнение для SD | 8 ГБ+ | Apache 2.0 | Контроль позы, карты глубины, ведение по контурам | Согласованность персонажей, архитектурные макеты, направляемая генерация |
| FLUX.2 | Трансформер сопоставления потоков (4B–32B) | 13 GB (4B) / 24 GB (32B) | BFL Commercial | Поддержка нескольких референсных изображений и точное следование промпту | Высококачественные визуальные эффекты, брендированные материалы, маркетинговый контент |
| GLM-Image | Гибридная AR + DiT (9B + 7B) | ~16 ГБ | Исследовательская / Пользовательская | Качественный рендеринг текста, поддержка китайской типографики, редактирование и генерация в одном процессе | Плакаты, макеты интерфейсов, двуязычный дизайн, инфографика |
| Qwen-Image-2512 | Диффузия + визуально-языковая модель (20B) | ~16 ГБ | Apache 2.0 | Мультиязычный текст, послойное редактирование RGBA, поддержка ControlNet | Коммерческие рабочие процессы, продвинутое редактирование, мультиязычный контент |
| Waifu Diffusion | Тонко настроенная Stable Diffusion (набор данных аниме) | 6 ГБ+ | CreativeML OpenRAIL | Стиль аниме, графика манги, фокус на персонажах | Игры, визуальные новеллы, иллюстрации в стиле аниме |
| Z-Image-Turbo | Дистиллированный диффузионный трансформер (6B) | 16 ГБ | Apache 2.0 | Очень низкая задержка, поддержка английского и китайского языков, пакетная обработка | Приложения реального времени, крупномасштабные конвейеры, развертывание на конечных устройствах |
- Stable Diffusion 3.5
Stable Diffusion 3.5 — это мультимодальный диффузионный трансформер (MMDiT) модель преобразования текста в изображение, разработанная компанией Stability AI. Она улучшает качество изображений, типографику, понимание промптов и общую производительность. Модель поставляется в трех размерах, разработанных для различных конфигураций оборудования и сценариев использования. Эта лучшая модель для генерации изображений остается одной из самых широко используемых открытых моделей генерации изображений, поддерживаемой большим сообществом разработчиков и создателей контента.
Ключевые особенности:
- Три размера модели: Large (8B параметров), Large Turbo и Medium (~2.5B параметров), каждый из которых подходит для различных требований к производительности и оборудованию
- Вывод в высоком разрешении: Модель Large поддерживает генерацию высококачественных изображений с разрешением около 1 мегапикселя
- Быстрый вариант генерации: Large Turbo выдает качественные результаты за небольшое количество шагов
- Поддержка тонкой настройки: Создана для кастомизации с улучшенной точностью следования промпту
- Гибкая лицензия на использование: Бесплатно для физических лиц и небольших компаний, с корпоративным лицензированием для крупных организаций
Мой опыт: 4.5/5
Это была моя самая стабильная модель во всех пяти категориях промптов. Модель Large практически каждый раз справлялась со снимком продукта и сложной сценой с первой или второй попытки, и она ни разу не зависла на моей 4090 даже при полном разрешении. Единственное, в чем она потеряла баллы, — это рендеринг текста, где мелкий шрифт на плакате все же получался слегка искаженным.
- ControlNet 1.1
ControlNet — это структура нейронной сети, которая управляет диффузионными моделями путем добавления дополнительных условий. Она копирует веса блоков нейронной сети в заблокированную и обучаемую копии. Обучаемая копия изучает ваше условие, в то время как заблокированная сохраняет исходную модель. Выпущенная исследователем lllyasviel, она не генерирует изображения сама по себе. Вместо этого эта лучшая модель изображений работает поверх Stable Diffusion и дает вам точный структурный контроль над тем, что генерируется.
Ключевые особенности:
- Несколько типов кондиционирования: ControlNet поддерживает управление с помощью обнаружения краев Canny, оценки глубины Midas, обнаружения мягких краев HED, обнаружения линий M-LSD, карт нормалей, распознавания поз человека OpenPose и семантической сегментации.
- Комбинируемые элементы управления: ControlNet поддерживает одновременное объединение нескольких ControlNet. Все готовые к использованию модели тщательно протестированы с объединением нескольких ControlNet, а официальная поддержка Multi-ControlNet доступна через плагин A1111.
- Улучшенная стабильность в версии 1.1: ControlNet 1.1 добавляет новую обработку мягких краев, несколько новых препроцессоров, таких как Canny, Depth и Inpaint, а также повышает общую стабильность модели и качество изображений по сравнению с версией 1.0.
- Редактирование на основе инструкций: ControlNet 1.1 включает модель, обученную на наборе данных Instruct Pix2Pix, с использованием как текстовых инструкций, так и текстовых описаний.
Мой опыт: 4/5
Я не оценивал ControlNet 1.1 по тем же пяти промптам, поскольку его официальные веса разработаны для Stable Diffusion 1.5, а не для SD 3.5. Вместо этого я оценивал управление позой и глубиной отдельно от запусков SD 3.5. В ходе десяти генераций управление позой сохраняло положение персонажа стабильным. Это говорит о том, что ControlNet 1.1 может служить полезным ориентиром в совместимом рабочем процессе, но эти результаты не следует рассматривать как доказательство прямой совместимости с SD 3.5.
- Серия FLUX
Серия FLUX разработана Black Forest Labs и ориентирована на высококачественную генерацию изображений с точным соответствием промптам. Она включает в себя несколько моделей, предназначенных как для экспериментов, так и для рабочих процессов производства.
Ключевые особенности:
- Несколько вариантов: включает FLUX.1 [schnell], [dev] и специализированные инструменты для редактирования и кондиционирования.
- Контекстное редактирование изображений: позволяет изменять изображения с помощью текстовых инструкций без переобучения.
- Специализированные инструменты редактирования: включают поддержку дорисовки изображений, аутпейнтинга и структурного руководства.
- Доступность открытых весов: позволяет выполнять локальное развертывание и настройку.
- Гибкие варианты развертывания: поддерживает API, локальные конфигурации и среды тестирования.
Мой опыт: 4.5/5
FLUX.2 показал наиболее четкие мелкие детали среди всех протестированных мной моделей, особенно в промпте для предметной съемки, где текстура материала действительно выглядела освещенной, а не нарисованной. Вариант 32B занял больше всего времени среди всех моделей в моей партии на арендованном GPU — почти 40 минут на полный запуск из 20 промптов, так что это не лучший выбор, если вы торопитесь.
- GLM-Image
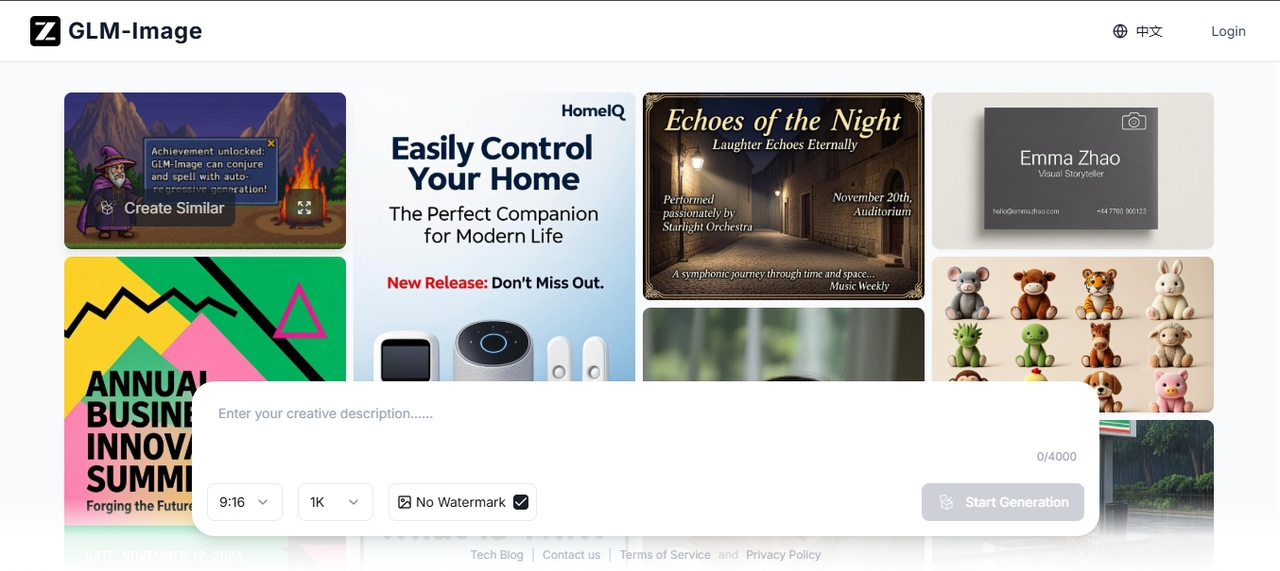
GLM-Image — это модель генерации изображений, использующая гибридную архитектуру авторегрессионного и диффузионного декодера. Она демонстрирует преимущества в сценариях рендеринга текста и наукоемкой генерации, обладая сильными возможностями в создании высокоточных и детализированных изображений. Разработанная Zhipu AI, она создана для случаев использования, в которых другие модели обычно не справляются, особенно когда изображения должны содержать читаемый текст или информационно насыщенные макеты.
Ключевые особенности:
- Гибридный дизайн архитектуры: объединяет авторегрессионное кодирование с диффузионным декодированием.
- Точный рендеринг текста: создает четкий и читаемый текст внутри изображений.
- Поддержка сложных макетов: хорошо подходит для плакатов, инфографики и структурированных визуальных материалов.
- Единая генерация и редактирование: справляется как с задачами генерации текста в изображение (text-to-image), так и изображения в изображение (image-to-image).
- Пост-тренировочная доработка: использует обучение с подкреплением для улучшения детализации и соответствия.
Мой опыт: 4/5
GLM-Image оказалась одной из двух моделей, у которых мелкий шрифт на моем постере получился полностью читаемым, и она справилась с макетом в стиле инфографики без наползания букв друг на друга. Настройка заняла больше времени, чем у большинства других, так как условия лицензии требуют более внимательного изучения перед коммерческим использованием, что снизило оценку за удобство, а не за качество результата.
- Qwen-Image-2512
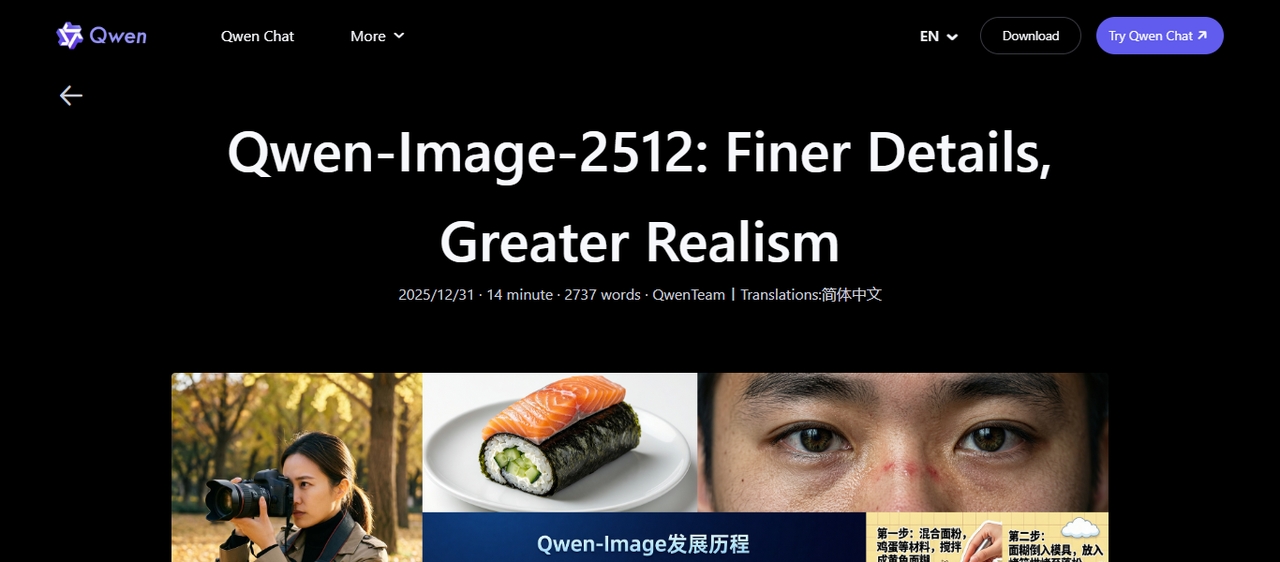
Qwen-Image-2512 — это декабрьское обновление text-to-image модели Qwen-Image, лучшей модели генерации изображений с открытым исходным кодом, которая отличается повышенным реализмом людей, более тонкими природными деталями, а также улучшенной точностью и качеством рендеринга текста. Она ориентирована непосредственно на корпоративные и коммерческие сценарии использования, где важны качество, надежность и ясность лицензирования.
Ключевая особенность:
- Улучшенный визуальный реализм: снижает эффект искусственности в сгенерированных изображениях.
- Более высокая точность текста: создает более четкий встроенный текст и структурированные макеты.
- Детализированная генерация сцен: обрабатывает окружение и объекты с более высокой четкостью.
- Открытая коммерческая лицензия: выпущена под лицензией Apache 2.0 для бесплатного использования и изменения.
- Полный доступ к модели: доступна через открытые платформы моделей для развертывания.
Мой опыт: 4.5/5
Qwen-Image-2512 стала второй моделью, которая правильно распознала мелкий текст на постере, а результаты ее портретной съемки выглядели наиболее естественно из всех, менее «восковыми», чем у некоторых других диффузионных моделей. В сочетании с лицензией Apache 2.0 это та модель, к которой я бы обратился в первую очередь при работе над клиентским проектом, где нужно двигаться быстро и без лишних разговоров о лицензировании.
- Waifu Diffusion
Waifu Diffusion создана Hakurei и ориентирована на генерацию изображений в стиле аниме. Она обучена специально на наборах данных аниме, что позволяет ей создавать согласованный дизайн персонажей и стилизованные визуальные эффекты. Она построена на базе Stable Diffusion и напрямую встраивается в ее экосистему, что делает ее простой в использовании для художников, уже знакомых с этими инструментами.
Ключевые особенности:
- Обучение с фокусом на аниме: модель обучена на большом наборе данных аниме-изображений, что помогает ей усваивать пропорции персонажей, мимику и стилистические элементы, характерные для аниме-арта.
- Стабильное качество персонажей: она сохраняет стабильные черты лица, прически и детали одежды в различных промптах, что полезно при создании одного и того же персонажа в нескольких сценах.
- Управление стилем через промпты: вы можете направлять результат с помощью тегов и стилей промптов, обычно используемых в аниме-сообществах.
- Вариант на базе SDXL: более новая версия, построенная на SDXL, улучшает разрешение, освещение и мелкие детали, сохраняя при этом стиль аниме нетронутым.
- Лицензия открытого доступа: распространяется под лицензией CreativeML OpenRAIL-M, которая разрешает использование и перераспространение при определенных условиях.
- Широкая поддержка сообщества: доступно большое количество предварительно обученных чекпоинтов, LoRA и пакетов стилей.
Мой опыт: 3.5/5
Waifu Diffusion безоговорочно выиграла в промпте с аниме, сохранив лицо и наряд персонажа неизменными во всех трех попытках, которые я запустил. Но когда я направил ее на промпт с фотореалистичным портретом, результат все равно получился близким к аниме, независимо от того, как я формулировал запрос, — именно этого и следовало ожидать от модели, обученной на узком наборе данных. Отлично справляется с одной задачей, но не создана для остальных.
- Z-Image-Turbo
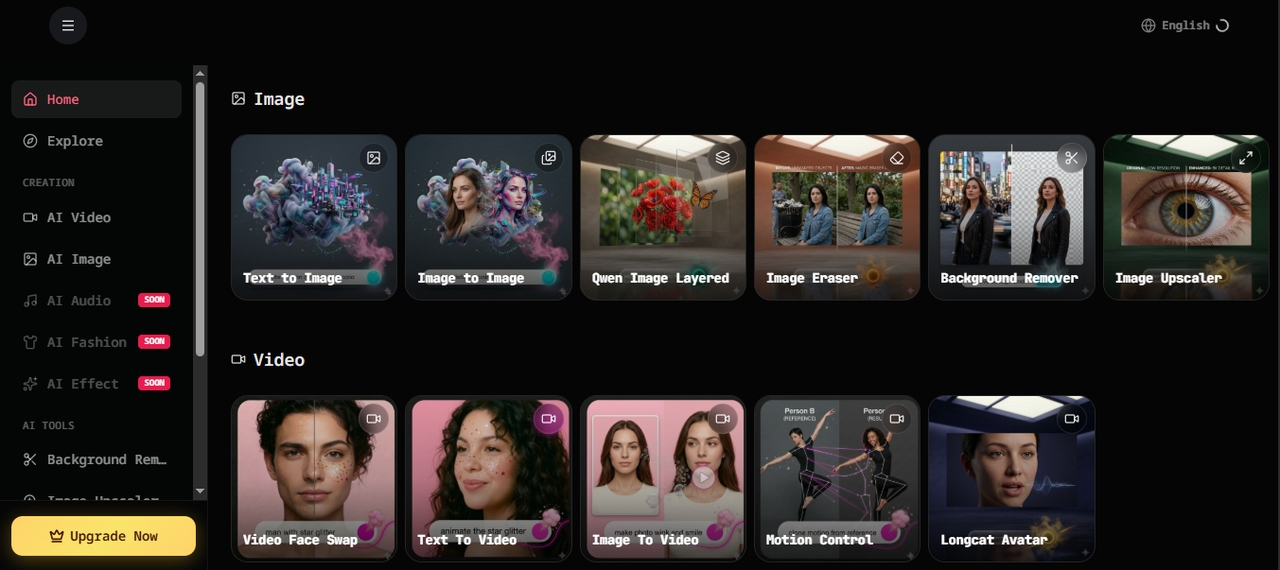
Z-Image-Turbo разработан Tongyi-MAI. Он ориентирован на скорость и эффективность, что делает его подходящим для приложений, требующих быстрого создания изображений. Он является частью семейства компактных моделей, разработанных для обеспечения высоких результатов без использования очень больших архитектур.
Ключевые особенности:
- Субсекундная скорость генерации: Z-Image-Turbo доказывает, что производительность высшего уровня достижима без использования огромных размеров моделей.
- Двуязычный рендеринг текста: Точно воспроизводит сложный китайский и английский текст, а в дизайне плакатов демонстрирует сильные композиционные навыки и хорошее чувство типографики.
- Улучшение промптов и рассуждение: Встроенный инструмент улучшения промптов наделяет модель способностью к рассуждению.
- Эффективная однопоточная архитектура: Z-Image-Turbo использует масштабируемую однопоточную архитектуру DiT, в которой текст, визуальные семантические токены и VAE-токены изображений объединяются на уровне последовательности в единый входной поток.
Мой опыт: 4/5
Z-Image-Turbo справился со всем моим пакетом из 20 промптов менее чем за четыре минуты, оказавшись самым быстрым из семи с большим отрывом. Двуязычный рендеринг текста хорошо показал себя как в английской, так и в китайской версиях моего промпта для плаката. Мелкие детали в промпте со сложной сценой оказались на шаг позади Stable Diffusion 3.5 и FLUX.2, что вполне закономерно, учитывая, насколько меньше эта модель.
Ключевые факторы, которые следует учитывать перед выбором модели
Прежде чем сделать выбор в пользу одной из них, стоит проверить несколько практических моментов. Вот на что следует обратить внимание и почему это важно.
- Качество изображения
Качество изображения сводится к тому, насколько реалистичным, детализированным и точным выглядит результат по сравнению с тем, что вы запрашивали. Некоторые модели создают реалистичные результаты, в то время как другие склоняются к большей стилизации. Правильный выбор зависит от того, что действительно нужно вашему проекту.
- Скорость (время инференса)
Время инференса — это время, необходимое модели для создания одного изображения. Если вы генерируете сотни изображений в пакете или создаете инструмент, работающий в реальном времени, скорость имеет огромное значение. Более медленная модель, которая дает отличные результаты, не всегда может быть практичной.
- Требования к VRAM
VRAM — это память, которую ваша видеокарта использует для запуска модели. Более крупным моделям требуется больше памяти, иногда 16 ГБ или более. Если ваше оборудование не соответствует требованиям, модель просто не запустится или будет работать слишком медленно, чтобы быть полезной.
- Способность к рендерингу текста
Некоторые модели хорошо справляются с текстом внутри изображений, другие же делают в нем грубые ошибки. Если ваши результаты включают вывески, плакаты, этикетки или любой письменный контент, это становится критическим фактором. Такие модели, как GLM-Image и Qwen-Image-2512, были созданы специально с учетом этого.
- Лицензирование (коммерческое против ограниченного)
Некоторые модели бесплатны для личного или исследовательского использования, но требуют платной лицензии для коммерческой работы. Другие, такие как Z-Image-Turbo и Qwen-Image-2512, полностью открыты под лицензией Apache 2.0. Всегда проверяйте лицензию перед использованием модели в клиентском проекте или продукте.
- Экосистема и сообщество
Сильное сообщество означает больше руководств, готовых тонких настроек (файнтюнов), плагинов и более быстрое исправление ошибок в случае возникновения проблем. У Stable Diffusion, например, есть тысячи ресурсов, созданных сообществом. Более новая или нишевая модель может впечатлять, но при этом вы останетесь практически без поддержки.
Взвесьте эти шесть факторов вместе, и открытый исходный код перестанет казаться легким и бесплатным решением. Модели, которая отлично справляется с качеством изображения и рендерингом текста, может потребоваться более 16 ГБ VRAM, которых у вас нет, плюс реальное время, потраченное на отладку локальной среды, прежде чем она выдаст что-то пригодное для использования. Если на самом деле вам нужна производительность высшего уровня без самостоятельного хостинга модели или доступ к закрытым моделям, с которыми эти варианты с открытым исходным кодом вообще не могут сравниться, то именно здесь на помощь приходит Framia Pro.
Framia Pro: ваш вариант для работы с закрытыми моделями
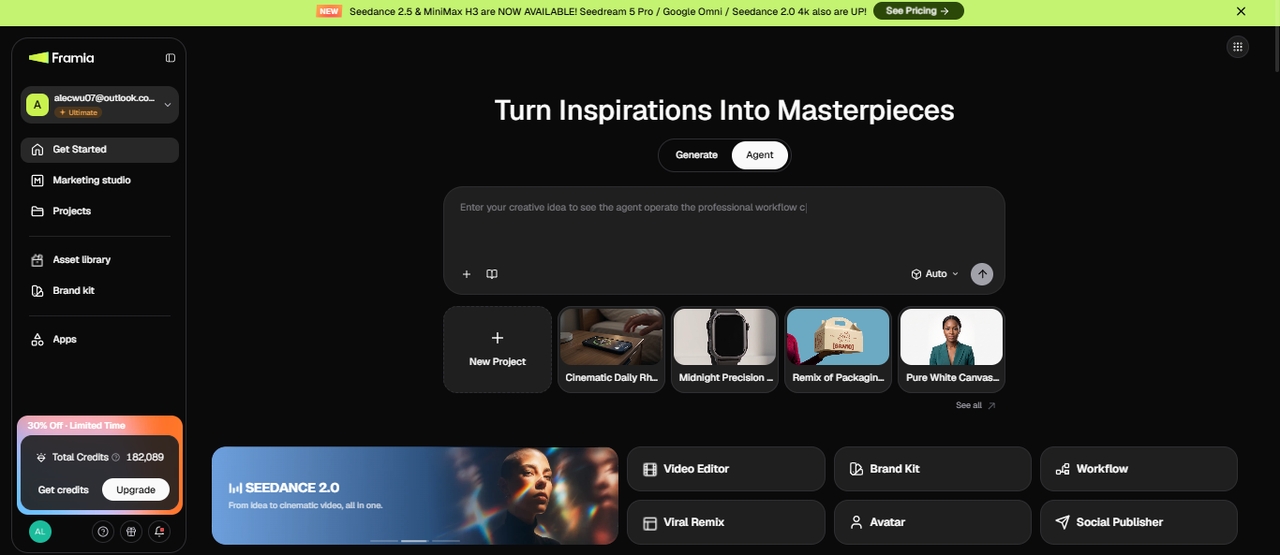
Framia Pro — это творческая ИИ-платформа, построенная вокруг холста рабочего процесса, где вы объединяете закрытые модели от партнеров, таких как Seedream 5.0 Pro, Nano Banana Pro, Kling, Seedance 2.5 и Veo 3.1, в одно рабочее пространство, вместо того чтобы выбирать один движок и мириться с его ограничениями. Вы описываете то, что хотите, а Framia Pro берет на себя сценарий, визуальные эффекты и сборку по подключенным узлам, которые вы можете редактировать на любом этапе процесса. Она объединяет генерацию изображений, видео и полноценную Marketing Studio в одном месте, поэтому создателям, которым нужны результаты от моделей с закрытым исходным кодом, не приходится собирать воедино несколько подписок для достижения этой цели.
Я провел несколько часов в Framia Pro вместе с семью моделями, упомянутыми выше, чтобы увидеть, как на самом деле выглядит опыт работы с закрытыми моделями, и ниже я отметил, где это подходит, а где нет.
Возможности генератора изображений Framia Pro
Framia Pro предоставляет единое рабочее пространство, где вы можете создавать и редактировать изображения, используя различные лучшие модели генерации изображений. Каждая функция разработана для того, чтобы дать вам контроль над тем, как генерируются и дорабатываются изображения.
- Холст рабочего процесса, который соединяет каждый шаг
Холст Framia Pro представляет ваш проект в виде связанных узлов — сценария, изображения, видео и аудио, которые вы можете перетаскивать, добавлять или удалять по мере развития проекта. Вместо того чтобы генерировать одно изображение и начинать заново для следующего ресурса, вы выстраиваете полную последовательность и перезапускаете только тот узел, который требует изменений.
- Несколько моделей ИИ в одном рабочем пространстве
Framia Pro дает вам доступ к Nano Banana Pro, Qwen Image, Midjourney v7, Flux Max и Seedream 4.5 для изображений, а также к Kling, Veo 3.1 и Seedance для видео — и все это на одной платформе. Вы можете переключать модели в зависимости от желаемого результата и сравнивать результаты бок о бок, не открывая отдельные инструменты.
- Brand Kit для единообразия визуальных эффектов
Генератор Brand Kit во Framia Pro создает логотипы, цветовые палитры, типографику и шаблоны для соцсетей на основе одного брифа, а затем привязывает каждое последующее сгенерированное изображение к этим правилам бренда. Это важно для маркетинговых команд и компаний, создающих большой объем визуального контента для кампаний.
- Трендовые шаблоны для ремиксов
Framia Pro содержит галерею трендовых, готовых к вирусному распространению шаблонов, которые вы можете выбрать и изменить с помощью собственного промпта, вместо того чтобы создавать концепцию с чистого листа. Это больше ориентировано на быстро создаваемый контент для соцсетей, чем на стили, которым посвящен этот гид, но об этом стоит знать, если вы также создаете видео.
- Редактирование изображений с помощью простых команд в чате
Вы можете описать изменение простым языком, например, заменить фон или изменить размер логотипа, и Framia Pro применит его непосредственно к изображению. Такое редактирование на основе чата позволяет избежать ручного маскирования или повторной генерации всего изображения ради небольшого исправления.
Заключение
В этой статье мы рассмотрели 7 лучших моделей генерации изображений с открытым исходным кодом и показали, как различные инструменты справляются с созданием изображений, производительностью и гибкостью. Каждая модель предлагает свои сильные стороны в таких областях, как визуальное качество, скорость, требования к оборудованию и поддержка различных стилей. Framia Pro объединяет несколько моделей в одном месте, чтобы предоставить вам больше возможностей для генерации и редактирования изображений в рамках единого рабочего процесса без переключения между отдельными инструментами. Попробуйте прямо сейчас!
Часто задаваемые вопросы
Какой ИИ-генератор изображений с открытым исходным кодом используется чаще всего?
Stable Diffusion остается одним из наиболее широко используемых генераторов изображений с открытым исходным кодом благодаря активному сообществу и широкой поддержке инструментов. Во Framia Pro вы можете получить доступ к различным моделям изображений в одном рабочем пространстве, что избавляет от необходимости настраивать отдельные среды для каждого генератора и позволяет проще переключаться между результатами.
Какие модели генерации изображений обеспечивают более высокое визуальное качество?
Более новые модели, такие как серии на базе SDXL и Flux, часто генерируют более четкие текстуры, улучшенное освещение и лучшую композицию. Framia Pro дает вам доступ к моделям Nano Banana Pro, Seedream 4.5, Flux Max, Qwen Image и Midjourney v7, чтобы вы могли мгновенно создавать изображения.
Какая модель лучше всего подходит для генерации изображений на ограниченном оборудовании?
Оптимизированные или облегченные версии моделей лучше подходят для систем с ограниченным объемом VRAM. Framia Pro обрабатывает доступ к моделям на бэкенде, поэтому вы можете запускать более тяжелые модели без настройки локальной среды, что снижает потребность в высокопроизводительном оборудовании с вашей стороны.
Какие модели считаются лучшими моделями генерации изображений с открытым исходным кодом?
Модели вроде Stable Diffusion, Waifu Diffusion и конфигурации на базе ControlNet обычно используются для различных задач, таких как реализм, аниме-арт, и структурный контроль. Framia Pro объединяет эти возможности, позволяя вам выбирать и тестировать несколько моделей в рамках одного проекта.
Какие модели изображений предпочтительны для профессионального использования?
Профессиональные рабочие процессы часто требуют стабильных результатов, согласованности и поддержки редактирования. Framia Pro повышает эффективность, предлагая редактирование изображений на основе чата и пакетную генерацию, что позволяет вам дорабатывать изображения и создавать несколько вариантов в одном месте без переключения между инструментами.
Какая бесплатная модель генерации изображений является лучшей?
Stable Diffusion 3.5 — это наиболее полный бесплатный вариант, поскольку версии Medium и Large Turbo работают на оборудовании потребительского класса, а лицензия покрывает коммерческое использование для малого бизнеса. Z-Image-Turbo и Qwen-Image-2512 также полностью бесплатны по лицензии Apache 2.0, обеспечивая более быструю генерацию, но вокруг них пока сформировалось меньшее сообщество.
Существует ли локальный генератор изображений на базе ИИ с открытым исходным кодом?
Да. Stable Diffusion 3.5, ControlNet 1.1, FLUX.2, Waifu Diffusion и Z-Image-Turbo работают локально на вашем собственном оборудовании после загрузки, без необходимости создания облачного аккаунта или подписки. Основное требование — достаточный объем VRAM, обычно от 6 ГБ до 24 ГБ в зависимости от выбранной модели.
Могу ли я использовать модели изображений с открытым исходным кодом для коммерческих проектов?
Да, но это зависит от лицензии модели. Некоторые модели разрешают коммерческое использование, в то время как другие имеют ограничения. Всегда проверяйте условия лицензии перед использованием сгенерированных изображений для клиентских проектов, продуктов или платных кампаний.