分享


- AI 影片生成模型 透過擴散過程將文字提示、圖像或現有的我儲存的顏色、剪輯片段轉化為新的素材,該過程會逐步精細化隨機雜訊,直到其符合您的描述。
- 目前有五款閉源模型處於領先地位,每款模型各有不同的優勢:Veo 3.1(原生音訊)、Runway Gen-4.5(創意控制)、Seedance 2.5(長單鏡頭剪輯)、Kling 3.0(符合物理規律的運動)以及 MiniMax H3(統一的多模態輸入)。
- Wan 2.2、Mochi 和 HunyuanVideo 提供您更多控制權且無使用限制,但您需要更強大的硬體和一些設定時間。
- Framia Pro 將其中幾款模型整合到單一儀表板中,因此您可以輕鬆切換,無需在不同的登入帳號和訂閱之間奔波。
什麼是 AI 影片生成模型?
AI 影片生成模型 是指在沒有相機或工作人員參與的情況下,從提示詞、圖像或現有剪輯片段建立影片的系統。
它們從龐大的數據集中學習,這些數據集包含數百萬個配有描述的影片剪輯,並從中掌握視覺模式,將「一隻狗在雪地中奔跑」之類的短語與螢幕上的實際畫面聯繫起來。
其背後的技術稱為擴散。 模型從隨機雜訊開始,經過數十個步驟進行清理,直到影片出現。在訓練過程中,它觀察真實影片如何損壞為雜訊,並學會逆轉該過程。在生成時,您的提示詞會引導每個清理步驟朝向您描述的場景發展。
困難的部分不在於單一影格。它必須保持數百個影格之間的一致性。 臉部、服裝或陰影必須在整個剪輯中保持穩定,而不僅僅是單獨看起來沒問題。
影片模型 會同時處理整個影格序列,以便每個影格都可以互相參考,這就是為什麼影片生成比單一圖像需要多得多的運算量。
有哪些不同類型的 AI 影片模型?
在開始測試之前,我必須先理清自己實際使用的是哪一類型的工具,因為並非每個 AI 影片產生器都是從同一個起點開始的。
文字生成影片 AI 模型
文字生成影片模型 從頭開始將書面描述轉化為動態場景。您寫下您想要的內容,模型就會建立視覺效果。這最適合當您有想法但沒有素材或參考圖像可以開始時,例如產品概念、簡短的故事節奏或場景。
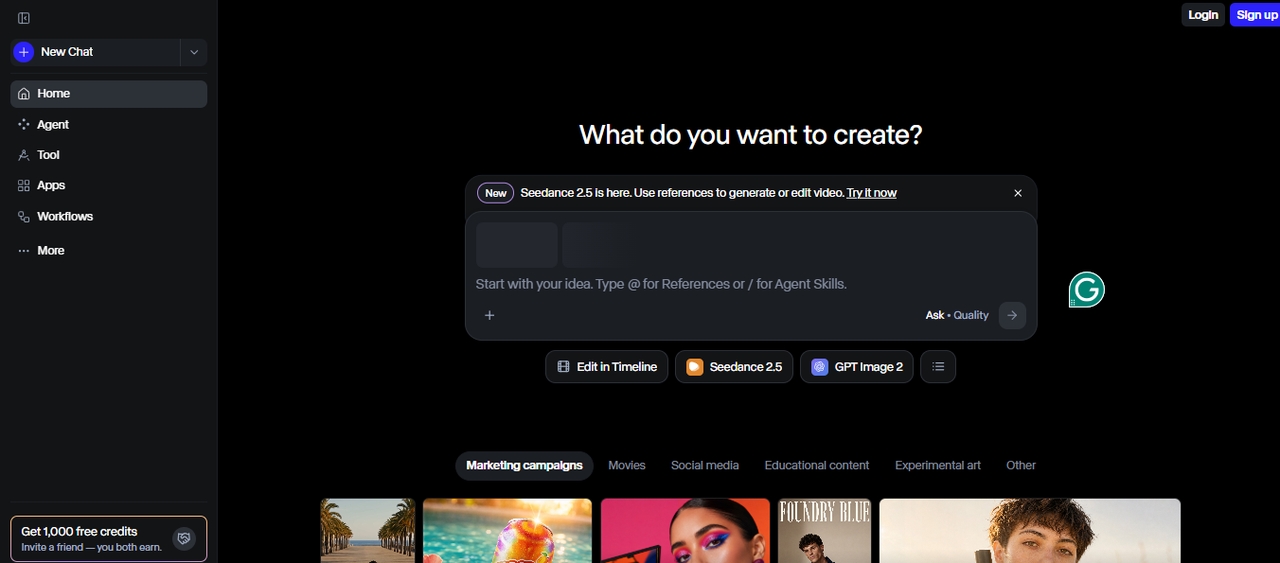
圖像生成影片模型
圖像生成影片模型 從您已有的圖片開始,加入動作、鏡頭移動或微小的變化來使其栩栩如生。這適用於產品演示和社群貼文,在這些場景中您需要快速的動態,而不需要從零開始生成所有內容。
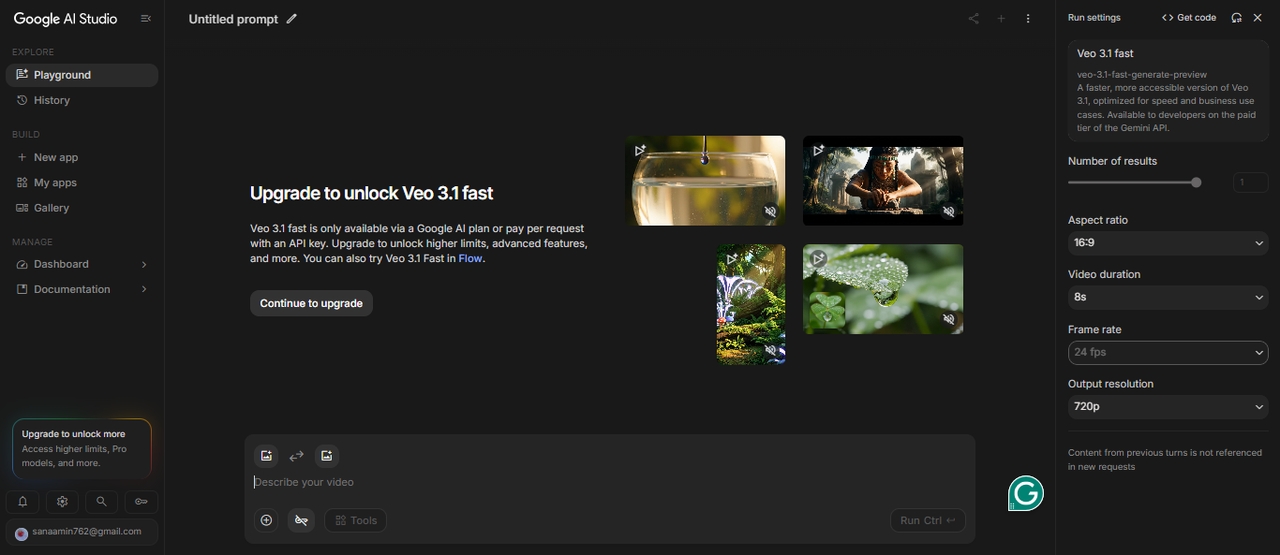
多模態影片模型
這些模型可以同時處理多種不同類型的輸入。您可以混合文字、圖像、音訊,甚至現有的影片剪輯來引導最終結果。
這讓您對影片的最終呈現效果有更多的控制權。您不只是在描述一個場景,而是在用多個輸入來塑造它。當您需要特定的細節、更流暢的敘事或符合明確方向的影片時,這種控制力會很有幫助。
我們如何測試每款模型
我是一名內容策略師,過去兩年來一直以測試 AI 創意工具為生,我用相同的五個提示詞運行了每款 AI 影片生成模型,這些提示詞包括產品演示、簡短的敘事場景、說話人頭像剪輯、動作序列和風格化的藝術作品。
對於每款模型,我針對每個提示詞至少生成了三個輸出,並在逼真度、動作準確性、提示詞遵循度以及適用的音訊品質方面進行評分。
8 AI video generation models, and what each one does best
After testing eight AI video generation models across product demos, narrative scenes, talking-head clips, action sequences, and stylized visuals, I found that no single model performed best in every category. Veo 3.1 stood out for native audio, Runway Gen-4.5 for creative control and scene consistency, and Seedance 2.5 for longer single-pass clips. Kling 3.0 was a strong option for motion-heavy scenes, while MiniMax H3 handled mixed inputs and synchronized audio. Wan 2.6, Mochi, and HunyuanVideo offered alternatives for users who prefer open-weight models and local workflows, although hardware requirements and setup can be limiting factors.
These results are based on my hands-on tests, not a universal ranking. The best choice depends on your video type, output requirements, budget, and whether you prefer a hosted service or a model you can run yourself.
Below, I break down the strengths, features, pros, and cons of each model to help you choose the right one for your project.
Below are the top closed-source models you should know right now.
| Feature | Veo 3.1 | Runway Gen-4.5 | Seedance 2.5 | Kling 3.0 | MiniMax H3 |
| Max Resolution | 1080p | 1080p | 1080p native | 4K / 60fps, first model to hit native 4K at 60fps | 2K at 24fps, 768p also available |
| Max Clip Length | 8 seconds natively, extendable via third-party tools | Up to 16 seconds on Gen-4 | Up to 30 seconds in a single continuous take | Up to 2 minutes, extendable to 3 minutes | 5–15 seconds, extendable to 30 with the built-in Extend tool |
| Frame Rate | 24–30fps | 24fps | Not yet published | 30fps | 24fps |
| Native Audio | ✅ Dialogue, SFX, ambient | ✅ Added Dec 2025 | ✅ 10+ languages | ✅ | ✅ Native stereo |
| Multimodal Input | ✅ Up to 3 image refs | ❌ | ✅ Up to 50 references, 30 images, 10 video, 10 audio | ✅ Text, image, audio, video | ✅ Text, image, video, and audio read as one context |
| Multi-Shot | ❌ | ✅ | ✅ Single continuous take, no stitching | ✅ Up to 6 shots | ❌ |
| Physics Engine | ✅ | ❌ | Not specified | ✅ | Not specified |
| Fast / Draft Mode | ✅ Veo 3 Fast | ✅ Gen-4 Turbo | Not yet published | ✅ Up to 20x faster | ✅ 768p lighter-weight option |
| Aspect Ratios | 16:9 and 9:16 | 16:9, 9:16, 1:1 | Not yet published | 16:9, 9:16, 1:1 | 21:9, 16:9, 4:3, 1:1, 3:4, 9:16 |
| Free Tier | ❌ | ❌ | Rolling out on Jimeng AI, Doubao, Dreamina | ✅ 66 daily credits | Via Hailuo AI app |
| Best For | Realism + audio | Cinematic control | Long single-take clips + references | 4K + long-form | Multimodal editing + consistency |
- Veo 3.1
Veo 3.1 is Google's flagship video generation model, and audio is where it separated itself from the rest of my testing. It generates dialogue, sound effects, and ambient audio in the same pass as the video, all from one prompt. It became the engine behind a wave of viral clips across social platforms after launching in October 2025, and its tie-in with Google Workspace made it an easy fit for the parts of my workflow already living in that ecosystem.
Features
- Native audio: dialogue, SFX, and ambient sound in one pass.
- 4K resolution: up to ultra-high definition output.
- Multi-reference: supports up to 3 reference images.
- Long duration: produce output up to one full minute.
- Prompt dialogue: write character speech directly in your prompt.
Pros
- Unmatched native audio quality.
- Excellent realism and lighting accuracy.
- Deep Google ecosystem integration.
- Strong prompt accuracy.
Cons
- Watermarked videos on lower plans.
- Less flexible for stylized or non-realistic content.
- Runway Gen-4.5
Runway has been a fixture in generative AI video models for years, and Gen-4.5, released in late 2025, is where I noticed the quality and multi-shot sequencing jump the furthest. Its chat interface let me refine a video by describing changes in conversation instead of rewriting the prompt from scratch. Out of everything I tested, this is the model I'd point a creative professional toward when scene and character consistency matter across multiple shots.
功能
- 動態筆刷: 精確繪製場景中應該移動的部分。
- 多鏡頭:將多個片段串聯成一個連貫的序列。
- Act-one: 面部表情與動作捕捉。
- 對話式編輯:透過自然對話優化輸出結果。
- 4K 輸出:超高解析度匯出。
優點
- 同級最佳的場景與角色一致性。
- 為專業人士提供強大的創意控制功能。
- 強大的社群與生態系統。
缺點
- 高階方案價格昂貴。
- 在製作快速社群內容方面,速度慢於部分競爭對手。
- 初學者的學習曲線較陡峭。
- Seedance 2.5
Seedance 2.5 是 ByteDance 繼 Seedance 2.0 之後的後續產品,後者在 2026 年初曾登頂 Artificial Analysis Video Arena 的文字生成影片和圖片生成影片排行榜。新版本將單次生成時長從 15 秒延長至整整 30 秒,提升至原生 1080p,並支援在單次生成中輸入多達 50 個多模態參考(結合圖片、影片和音訊),高於舊版本的 12 個。它還新增了 10 多種語言的原生音訊,我在它於 Jimeng AI、Doubao 和 Dreamina 陸續推出時進行了測試,並透過 BytePlus ModelArk 取得 API 存取權限。
功能
- 延長的單次生成:單個連續片段最長可達 30 秒,無需拼接。
- 原生 1080p:高於舊版本的 720p。
- 擴展的參考支援: 單次生成支援多達 50 個多模態參考(30 張圖片、10 部影片、10 個音訊)。
- 原生多語言音訊:支援 10 多種語言的對話與音效。
- 精確編輯:更換產品、延長鏡頭或進行針對性編輯,而無需重新生成整個片段。
- 3D 白模預視化:在進行完整生成之前,先規劃好鏡頭移動和畫面。
優點
- 長單鏡頭片段非常適合短劇和系列化內容。
- 在整個 30 秒的鏡頭中,鏡頭與鏡頭之間具有強大的相機連續性。
- 擴展的參考數量可以更好地控制角色和產品的一致性。
缺點
- ByteDance 尚未發布完整的技術報告,因此某些規格來自發布演示,而非獨立測試。
- 在測試時,完整的 API 訪問權限尚未在所有地方上線。
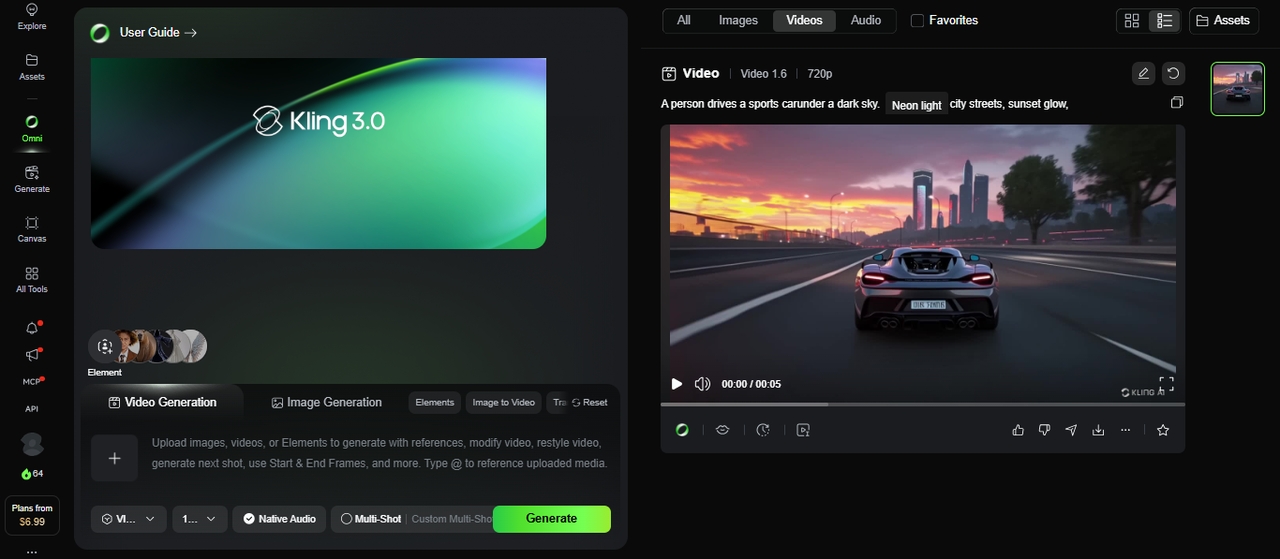
- Kling 3.0
Kling 3.0 於 2026 年 2 月 4 日推出,並在幾天內就被稱為今年 AI 影片生成領域的最大飛躍。它運行在 Omni One 架構上,該架構結合了 3D 時空聯合注意力(3D Spacetime Joint Attention)與思維鏈推理,這就是它在我的測試中如何讓重力、平衡、變形和慣性看起來真實而非橡膠般僵硬的原因。它接受跨文字、圖像、音訊和影片的多模態輸入,並生成英文、中文、日文、韓文和西班牙文的原生音訊,且能控制角色對話和說話順序。
功能特點
- Omni one 物理:真實的重力、碰撞和慣性模擬。
- 原生音訊: 旁白、對嘴、SFX 和音樂。
- 多鏡頭分鏡腳本: 最多 6 個鏡頭,具備導演級的相機控制。
- 草稿模式: 生成速度提升高達 20 倍,用於快速原型製作。
- 4K/60fps 輸出: 支援 16 位元 HDR 和 EXR 匯出。
- 七合一編輯器: 將物件添加、背景更換、風格轉換整合於單一工具中。
優點
- 目前最真實的人體物理和動作表現。
- 具備方言和口音控制的原生多語言音訊。
- 每月 7.99 美元的實惠入門價格,並提供完善的免費方案。
- 直接匯出至專業 VFX 工作流(Nuke、After Effects、DaVinci)。
缺點
- 渲染 15 秒的多鏡頭影片可能需要超過 5 分鐘。
- 4K 輸出目前僅限於較高階的方案。
- 高需求時期會延長渲染排隊時間。
- MiniMax H3
MiniMax H3,也被稱為 Hailuo 3.0,是 MiniMax 影片產品線中繼 Hailuo 02 之後的產品。它不將文字、圖像、影片和音訊參考視為獨立的輸入,而是將它們全部作為一個共享上下文一起讀取,然後在單個結果中返回同步的影片和音訊。MiniMax 表示計劃發布模型權重,不過我是透過 Hailuo AI 應用程式、MiniMax 開放平台 API 以及像 fal 這樣的託管合作夥伴來存取的。
功能特點
- 統一的多模態上下文:文字、圖像、影片和音訊參考在單次生成中協同解析。
- 原生立體聲音訊:對話、音樂、音效和環境音與影片同步生成,而非事後疊加。
- 最高支援 24fps 的 2K 解析度,同時也提供 768p 作為更輕量化的選擇。
- 生成 5 到 15 秒的影片,使用內建的 Extend Video 工具可延長至 30 秒。
- 定向編輯: 替換或移除角色和物體、更改光影或背景,或修改對話,而無需重新製作整個片段。
- 多種寬高比:21:9、16:9、4:3、1:1、3:4 和 9:16。
優點
- 強大的時間一致性;動作在整個片段中保持穩定,不會在半路漂移。
- 原生立體聲音訊在同一次生成過程中輸出,無需獨立的配音步驟。
- 廣泛的寬高比支援,適用於從電影寬螢幕到垂直社群內容的所有格式。
缺點
- MiniMax 尚未發布完整的技術報告,因此某些說法來自該公司,而非獨立的基準測試。
- 一旦權重發布,在本地運行開源權重版本將需要配備 24GB+ VRAM 的高階 GPU。
| 功能 | Wan 2.2 | Mochi 1 (Genmo) | HunyuanVideo (Tencent) |
| 參數 | 1.3B / 14B | 10B | 13B |
| 最大解析度 | 720p (14B 為 1080p) | 480p (640x480) | 720p (v1.5 為 1080p) |
| 最大片段長度 | 最長 10 秒 | 在 30fps 下最長 5.4 秒 | 最長 5 秒 (720p) |
| 影格率 | 16fps | 30fps | 24fps |
| 最低 VRAM | 8GB (1.3B 模型) | 全精度下 20GB+ | 14GB (v1.5) / 60–80GB (原始版) |
| 生成速度 | 4–5 秒片段需 1–2 分鐘 (8GB GPU) | 5.4 秒片段需 3–4 分鐘 | 5 秒片段需 6–10 分鐘 (16GB GPU) |
| 文字生成影片 | ✅ | ✅ | ✅ |
| 圖像生成影片 | ✅ | ❌ | ✅ |
| LoRA 微調 | ✅ | ✅ | ✅ (需要高算力) |
| ComfyUI 支援 | ✅ | ✅ | ✅ |
| Diffusers 支援 | ✅ | ❌ | ✅ |
| 雙語提示詞 | ✅ 英文 + 中文 | ❌ | ❌ |
| 授權許可 | Apache 2.0 | Apache 2.0 | Tencent 社區許可協議 |
| 家用 GPU 友善度 | ✅ 同級最佳 | ❌ | ⚠️ 僅限 v1.5 |
| 最適合 | 多功能性 + 易用性 | 寫實感 + 微調 | 電影級品質 + 人臉 |
- Wan 2.6
Wan 2.6 是 Alibaba 的影片生成模型系列,於 2025 年 12 月發布。它支援文字生成影片、圖像生成影片和參考生成影片。其主要優勢包括多鏡頭敘事、改進的提示詞遵循能力,以及與視覺畫面保持同步的音訊。參考生成影片模型還可以使用參考片段,在全新生成的場景中保留人物或物體的外觀與聲音。
對於想要嘗試 AI 生成場景、產品影片或對話驅動片段的創作者來說,Wan 2.6 仍然是一個可行的選擇。
功能特點
- MoE 架構: 針對不同雜訊階段的專業專家。
- 混合 T2V/I2V: 在單一統一模型中輸入文本和圖像。
- GGUF 量化:可在具有 4GB VRAM 的消費級 GPU 上運行。
- 電影級控制: 光照、對比度和色調標籤。
- 雙語支持: 英文和中文提示詞處理。
- 託管訪問:通過 Alibaba Cloud Model Studio 使用支持的 Wan 模型
優點
- 在單一模型家族中支持多種視頻生成工作流。
- 多鏡頭控制適用於短篇故事、廣告和產品展示。
- 參考至視頻有助於在生成的場景中保持角色一致性。
- 在支持的變體中提供同步音頻和對話功能。
缺點
- 片段較短,因此較長的項目可能需要多次生成和編輯。
- 託管訪問可能涉及 API 費用或特定服務的限制。
- Mochi (Genmo)
Mochi 1 是一款基於新型 AsymmDiT 架構構建的 100 億參數模型,在 Apache 2.0 許可下發布。在我的測試中,它在寫實的 30fps 運動方面表現最強,這使其非常適合紀錄片風格的鏡頭、自然環境以及需要顯得真實的人體運動。它是首批讓我開始認真對待本地視頻生成的開源模型之一。
功能特點
- AsymmDiT 骨幹網絡:專為視頻合成設計的架構。
- 30fps 輸出: 原生幀率下的流暢運動。
- LoRA 微調:在您自己的視頻數據集上進行自定義。
- Apache 2.0 許可證: 開放用於研究和商業用途。
- ComfyUI 集成:支持基於節點的工作流。
- T5-XXL 編碼: 強大的文本理解和提示詞遵循能力。
優點
- 在所有高質量開源模型中擁有最寬鬆的許可。
- 出色的寫實動態與自然運動。
- 強大的社群,活躍的微調分享。
缺點
- 解析度上限為 480p;高畫質輸出需要進行放大處理。
- 在全精度下需要 20GB+ 的顯示記憶體(VRAM)。
- HunyuanVideo (Tencent)
HunyuanVideo 是 Tencent 的旗艦開源影片模型,專為高畫質生成而設計,具有強大的運動一致性,且比我嘗試過的大多數開源替代方案擁有更乾淨的場景結構。其基於 Transformer 的架構可同時處理視覺和時間數據,每當我想要比託管工具獲得更多對生成過程的控制時,我都會依賴它。
特點
- 開源類別中規模最大的 1B 模型。
- 雙流融合:在合併前分別處理文本和影片。
- xDiT 並行性:多 GPU 序列並行,實現更快的推理。
- FP8 量化:減少記憶體佔用,且無重大畫質損失。
- Diffusers + comfyUI:即插即用的生態系統整合。
- 因果 3D VAE:用於連貫運動的時空壓縮。
優點
- 開源中最佳的電影級畫質和人臉逼真度。
- 用於風格和角色客製化的龐大 LoRA 生態系統。
- 強大的多人及複雜場景處理能力。
缺點
- 根據設定,一段 5 秒的片段可能需要超過 15 分鐘。
- 設定複雜度高;不適合初學者。
在 Framia Pro 上探索頂尖的 AI 影片模型
這是我遇到的實際問題:我不想為了 Veo 註冊 Google 帳號、為了 Gen-4.5 訂閱 Runway,以及為了 Kling 登入 Kuaishou,然後在每次推出新模型時都重複這種設定。這就是我將大部分測試轉移到 Framia Pro 的原因。
Framia Pro 將 Veo 3.1、Kling 3.0、Seedance 2.5 以及其他頂尖的影片和圖像模型整合到同一個工作區中。我可以從一個想法開始,並使用文字、圖像、音訊或這三者的結合將其轉化為影片,而無需切換分頁或為每個模型支付單獨的帳號費用。內建的創意代理也涵蓋了特定的使用場景,例如 音樂影片、廣告和故事創作,因此無論我製作什麼,都有一個起點。
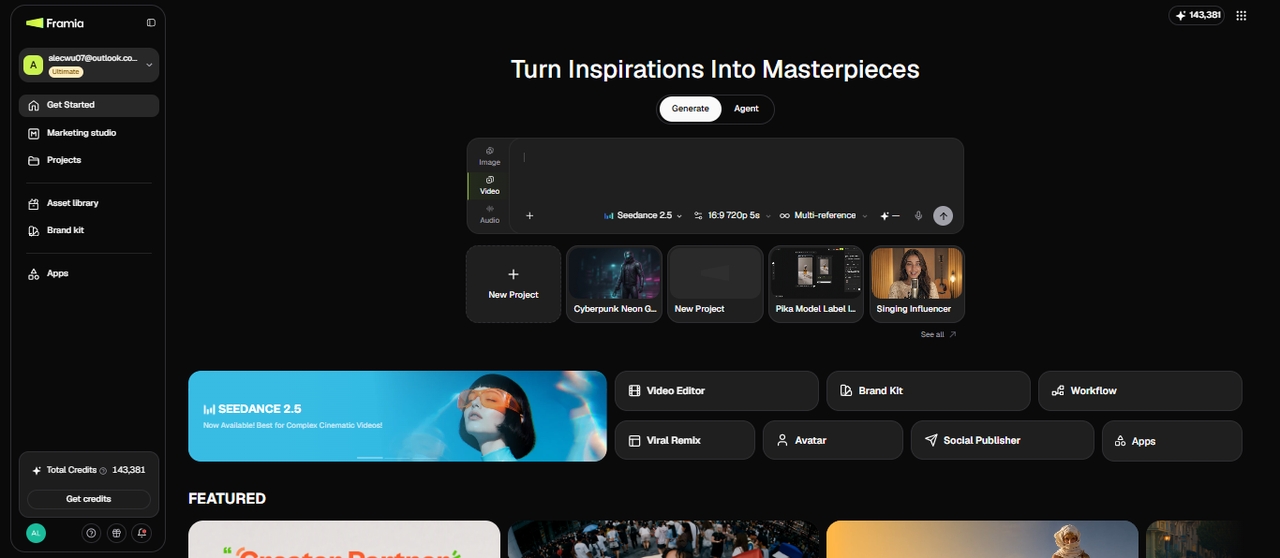
Framia Pro 帶來了什麼?
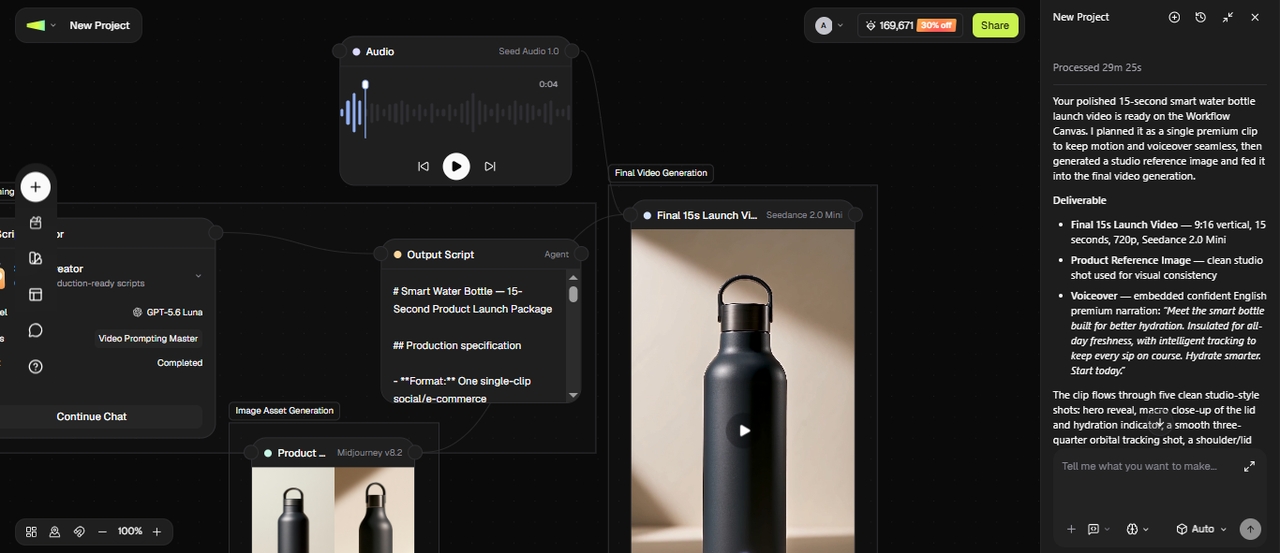
我嘗試在畫布上製作一個電子商務產品發布影片。我首先使用 Image 代理生成乾淨的產品照片,然後將這些照片輸入到 Video 節點中,使用 Kling 或 Seedance 將其轉換為示範短片,接著將結果引導至 Audio 節點以生成匹配的旁白,這一切都在同一個畫布中完成,而不是使用四個獨立的工具。
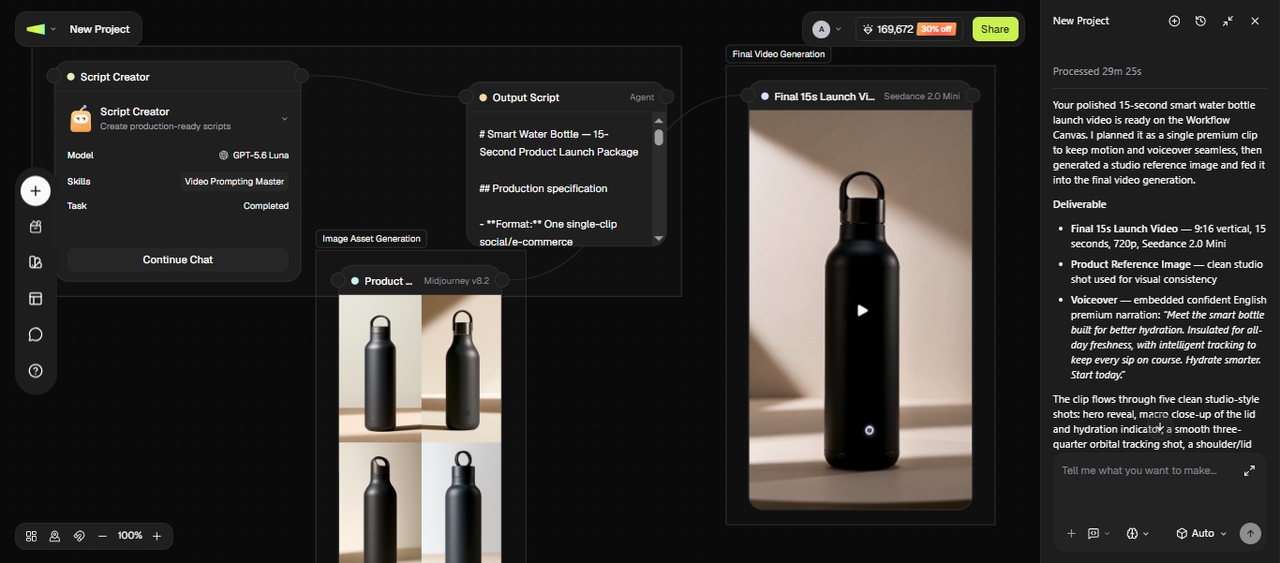
以下是沿途為我提供幫助的功能:
- 專屬的 Image、Audio 和 Video 代理: 我使用 Video 代理將提示詞、劇本或圖像轉換為上述模型中的完整短片,並在需要時單獨使用 Image 和 Audio 代理來製作縮圖、旁白和音樂。
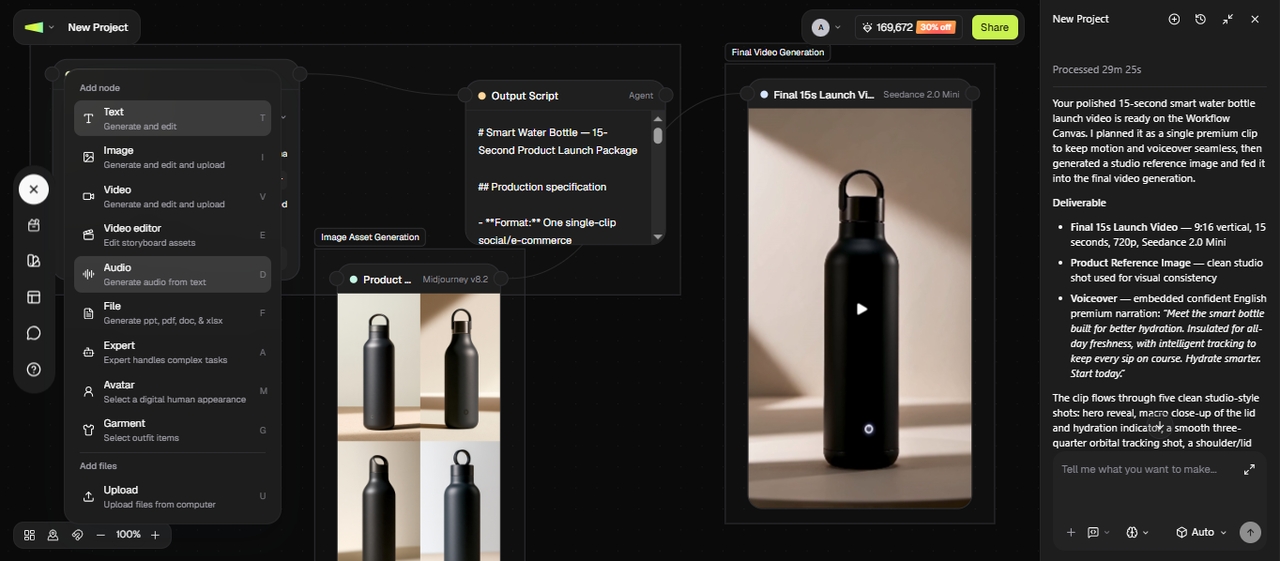
- 修改提示詞並重新生成: 我用純文字描述了我想要的修改,Framia Pro 就應用了它,不需要時間軸或手動編輯工具。我在沒有任何編輯經驗的情況下調整了場景、剪輯了部分內容並優化了視覺效果。
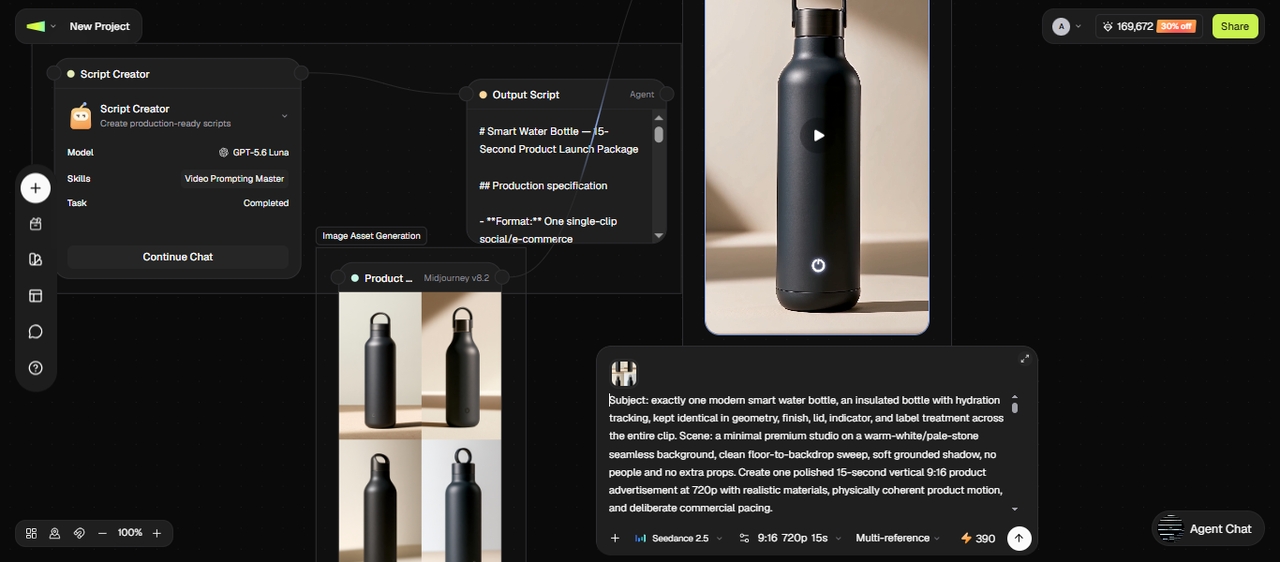
- 劇本、審查和重新定位的技能: 我將一個粗略的想法轉化為結構化的劇本,對完成的影片進行節奏和留存率審查,並將一部長影片剪輯成幾段適合不同平台的短片。
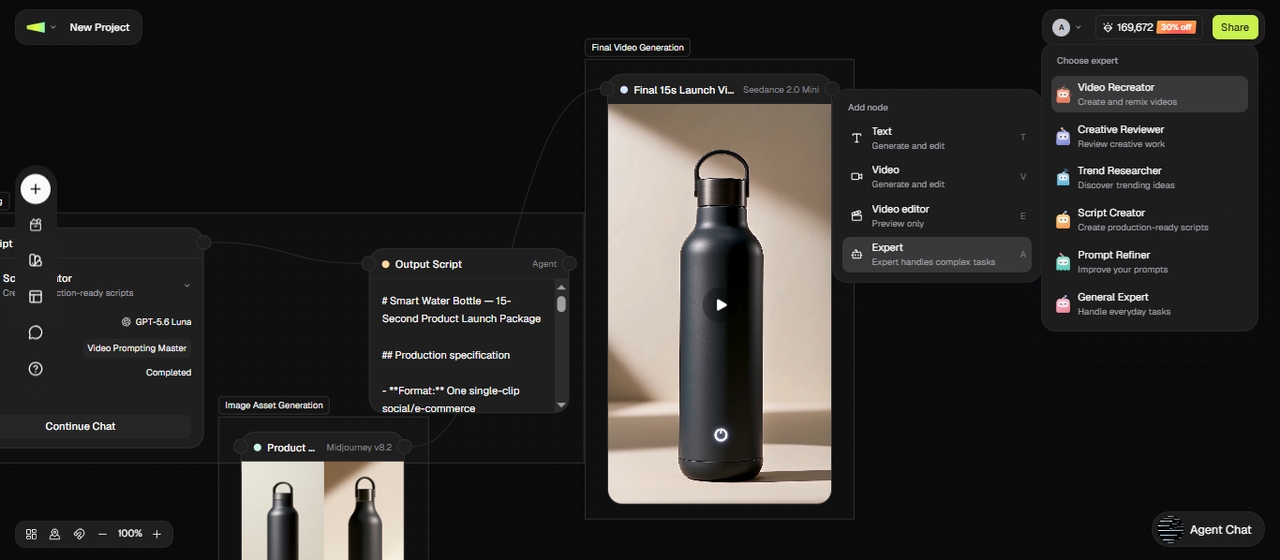
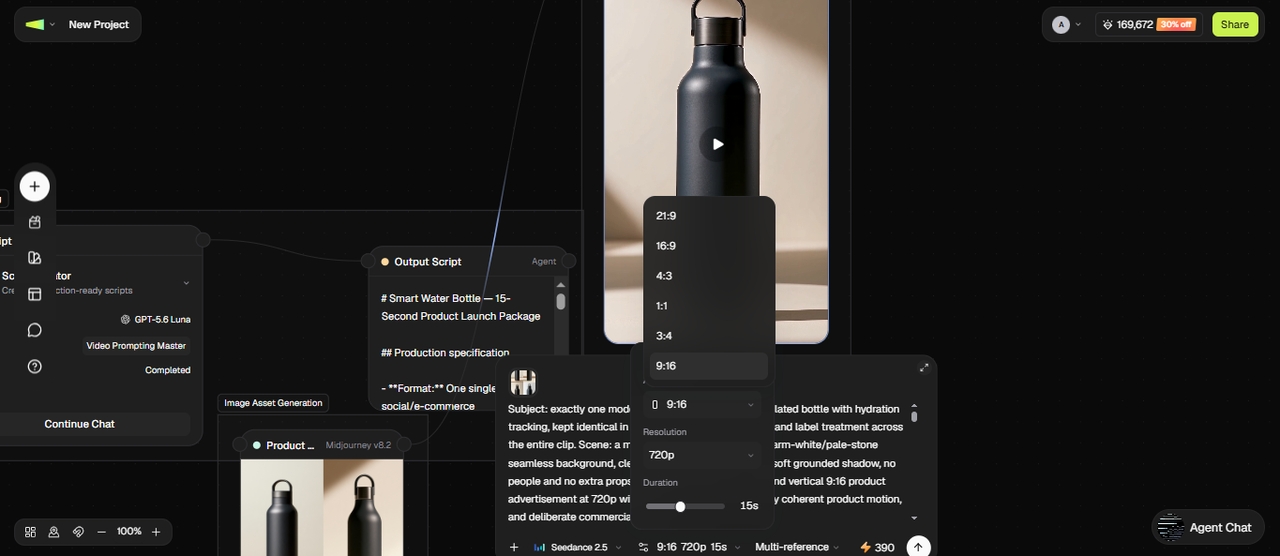
- 多種時長和長寬比:我為不同的專案創建了不同長度的短片,包括直式、正方形或寬螢幕,因此我的 TikTok、Instagram 和 YouTube 版本無需額外調整大小即可準備就緒。
- 將音訊與您的短片同步: Framia Pro 將聲音與視覺效果同步,使對話、音樂或音效與影片的時間點相匹配。它能將嘴型與語音匹配,並將音訊與場景切換對齊,從而減少編輯過程中的手動音訊調整。
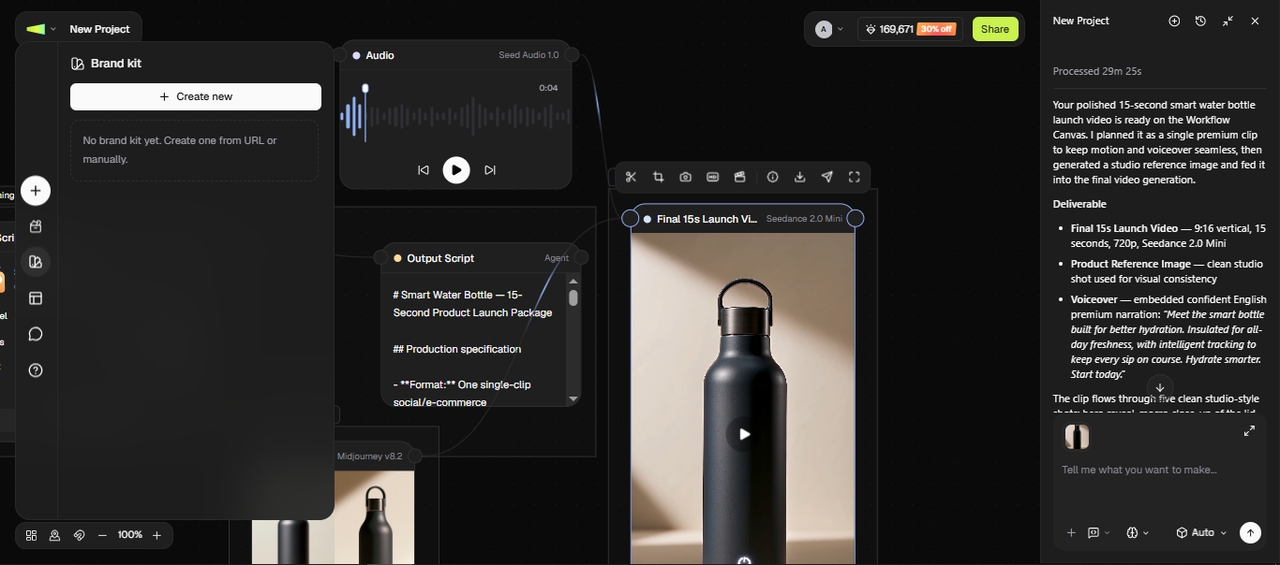
- 品牌套件: 我只需儲存一次我的顏色、字型和標誌,然後就可以將它們應用到我在工作區中從任何模型生成的每部影片中。
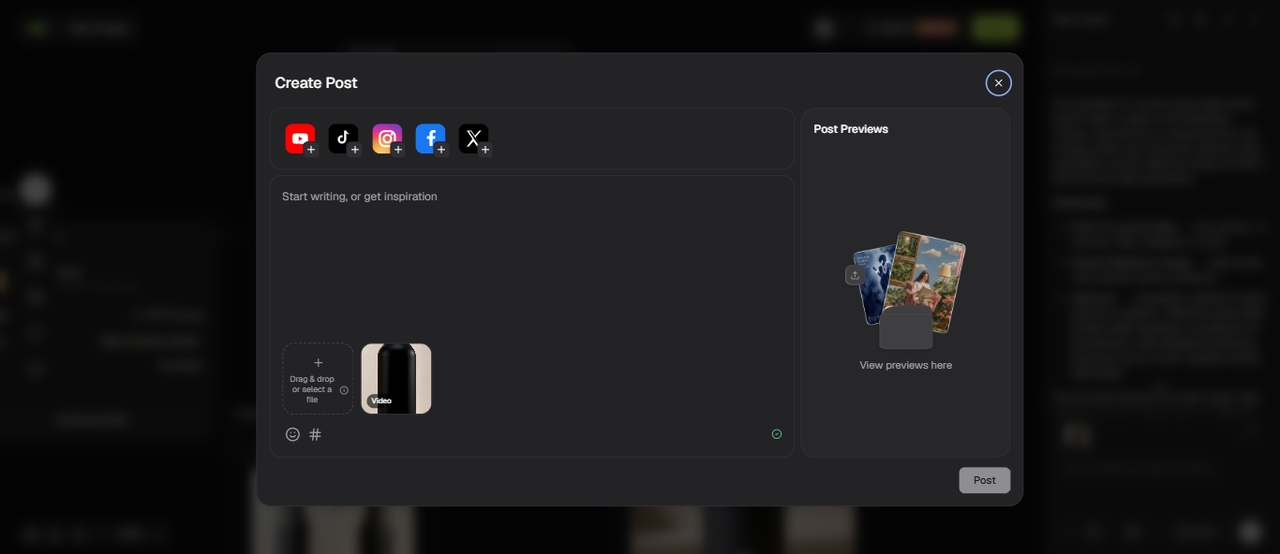
- 從發布器直接匯出: 我直接從 Framia Pro 將完成的影片發送到 TikTok,無需單獨的下載和上傳步驟。
結論
在這篇文章中,我們探討了什麼是 AI 影片生成模型,並回顧了 5 個閉源和 3 個開源工具,供您在專案中使用。在選擇模型之前,請先專注於您的目標。有些工具適合快速的社群短片,而有些則更適合說故事或具有聲音和細節的高品質場景。當您將模型與任務相匹配時,您的結果會更準確且更容易管理。如果您想在同一個地方存取多個頂尖的 AI 影片模型,請探索 Framia Pro 並根據您的專案需求在工具之間進行切換。
常見問題
目前最好的 影片生成 AI 模型 是哪些?
一些頂尖的 影片生成 AI 模型 包括 Veo、Runway、Seedance 2。5、Kling 和 MiniMax H3。每種模型都有不同的優勢,例如寫實度、動作、音訊或易用性。在 Framia Pro 上,您可以存取其中幾種模型,並根據您的專案進行切換。
Sora 的影片模型目前進展如何?
這則 Sora 影片模型的新聞 透露,該模型最近已於 2026 年停止作為消費級應用程式和 API 提供。OpenAI 決定將其關閉,以專注於機器人技術和先進研究等其他領域。
目前有開源的 AI 影片生成器可用嗎?
是的,目前有 Wan、Mochi 和 HunyuanVideo 等開源 AI 影片生成器。您可以本地運行它們並根據需要進行調整,不過設定需要技術知識。如果您更喜歡無需本地設定、即開即用的模型,Framia Pro 提供了更簡單的選擇。
AI 影片模型可以創建長影片嗎?
大多數 AI 影片模型仍專注於短片而非完整長度的影片。某些工具允許較長的場景,但通常需要結合多個片段。Framia Pro 支援不同的時長,因此您可以根據需要創建和管理片段。
您應該使用哪款 AI 影片模型?
您應該根據您的目標和內容風格來選擇模型。Veo 適用於寫實場景,Kling 擅長處理動作,而 Seedance 則透過多個輸入提供更多控制。Framia Pro 的 video agent 讓您可以在同一個地方測試這些模型,並挑選適合您工作流程的模型。
使用 AI 影片生成模型需要付費嗎?
大多數都需要,不過價格差異很大。有些按片段收費,有些則採用有額度限制的按月訂閱制。像 Wan 或 Mochi 這樣的開源模型可以免費運行,但您需要自己的 GPU 硬體。
我可以使用 AI 生成的影片進行商業專案嗎?
這取決於模型的授權許可和您的訂閱方案。像 Wan 2.2、Mochi 和 HunyuanVideo 等 Apache 2.0 模型允許商業用途。對於像 Veo、Runway 或 Kling 這樣的閉源工具,在付費或品牌作品中發布生成的影片之前,請先確認特定方案的商業使用條款。
哪些 AI 影片模型支援原生音訊?
目前有幾款模型是在生成影片的同時生成音訊,而不是事後添加。Veo 3.1、Kling 3.0、Seedance 2.5 和 MiniMax H3 都支援原生音訊,包括與螢幕畫面上發生的內容相結合的對話、音效和環境音。