分享


關鍵要點
- 開源圖像生成模型可以提供一種無需定期訂閱或支付單獨模型授權費用即可創建和編輯圖像的方法。
- Hugging Face 託管了將近 109,255 個 文字生成圖像模型,因此創作者在風格、速度和硬體需求方面擁有廣泛的選擇。
- Stable Diffusion 3.5、FLUX 和 Qwen-Image-2512 在一般創意工作、提示詞準確度和商業授權方面處於領先地位。
- ControlNet 1.1 和 Waifu Diffusion 涵蓋了專業需求,例如結構控制和動漫風格藝術。
- Z-Image-Turbo 和 GLM-Image 在速度和含有大量文字的圖像生成(例如海報和資訊圖表)方面脫穎而出。
- Framia Pro 將 Nano Banana Pro、Midjourney v7 和 Seedream 4.5 等封閉模型整合到同一個工作區中,適合希望獲得成果而無需管理本地設置的創作者。
開源圖像生成模型 為創作者、開發者和企業開闢了一個全新的世界。您現在可以將文字轉化為圖像、編輯照片、製作影片並創建 3D 物體,而無需在軟體上花費巨資。這個領域發展迅速,擁有將近 109,255 個 文字生成圖像模型 可用於 Hugging Face 。走向開源意味著無需訂閱、完全控制您的數據,並可根據需要自由調整。本指南涵蓋了目前最優秀的模型,以及您開始使用所需的一切資訊。
什麼是 開源圖像生成模型?
開源圖像生成模型 是從書面描述中創建圖像的軟體程式。您輸入想要看到的內容,例如山上的日落、產品模型、卡通人物,模型就會將其生成為圖像。
您可以將其想像為聘請了一位一生都在研究數百萬幅畫作、照片和插圖的藝術家。您描述您想要的內容,他們就會在幾秒鐘內為您畫出來。只不過這位藝術家從不睡覺、從不按專案收費,而且就住在您自己的電腦裡。
使它們成為「開源」的原因在於其程式碼是公開可用的。任何人都可以免費下載、使用、修改或在其基礎上進行構建。這與 Midjourney 或 Adobe Firefly 等付費工具不同,在那些工具中,您需要付費才能訪問軟體,並且無法控制其幕後的工作原理。
這些模型經過數百萬張圖像的訓練,這教會了它們理解文字與視覺效果之間的關係。隨著時間的推移,它們已經變得足夠優秀,可以產生專業品質的成果,而最優秀的模型現在甚至可以與昂貴的商業選擇相媲美。
為什麼選擇開源而非封閉式 圖像模型
付費的 圖像模型 雖然方便,但它們有著切實的限制。您需要按圖像付費、將數據交給第三方伺服器,並且對軟體的工作方式沒有發言權。開源模型解決了所有這些問題。以下是為什麼越來越多創作者和開發者正在進行轉變的原因。
- 完全控制輸出
使用封閉式工具時,平台會決定您可以生成和不能生成什麼。開源模型在您自己的設置上運行,因此由您來制定規則。您可以完全獲得您所要求的內容,而不會受到內容過濾器或平台限制的阻礙。
- 微調模型的能力
封閉式模型是被鎖定的,無法根據您的特定需求進行更改。然而,您可以根據自己的圖像、風格或品牌指南進一步訓練開源模型。這意味著輸出開始看起來和感覺起來像您自己的,而不是像其他所有使用相同工具的人一樣。
- 無單張圖像成本
大多數商業工具會對您生成的每張圖像收費,這會快速累積。但使用開源模型,您可以在自己的硬體上運行一切,並根據需要生成任意數量的圖像。唯一的成本只有電費和機器運作的費用。
- 隱私與離線使用
當您使用雲端工具時,您的提示詞和圖像會經過其他人的伺服器。開源模型可以完全離線運行,因此沒有任何內容會離開您的機器。這對於處理敏感專案或專有內容的企業來說非常重要。
- 龐大的社群支持
開源模型得到了全球數千名開發者、研究人員和創作者的支持。他們每天都會分享微調版本、教學、外掛程式和修復程式。如果您遇到問題,社群中很可能已經有人解決了。
我如何測試並挑選這些模型
我從事創意 AI 工具的工作,我厭倦了看到那些只會複製模型 GitHub 頁面規格表的「最佳」清單。因此,在對這裡的任何模型進行排名之前,我花了一週的時間實際親自運行每個模型,看看它在行銷截圖之外的表現如何。
我在家裡運行一台配備 RTX 4090 和 24GB VRAM 的備用桌上型電腦,所以這成了我的主要測試平台。對於需要更多記憶體的更大模型,例如 32B 的 FLUX.2 和 Qwen-Image-2512,我按小時租用了雲端 GPU,而不是僅憑規格表來猜測它們的輸出。
我建立了一組 20 個提示詞,並在每個模型中運行相同的清單,絕不刻意挑選。這些提示詞涵蓋了五個領域:寫實人像、純色背景上的產品照、帶有標題和小字的海報、動漫風格的角色,以及包含多個物體的繁忙場景。每個模型在每個提示詞上都有三次嘗試機會,我保留了三次中最好的一次,這也是大多數人實際使用這些工具的方式。
在評分方面,我針對四個項目對每個結果進行了 1 到 5 分的評分:輸出與提示詞的契合度、在完整解析度下細節的乾淨程度、在我的硬體上生成所需的時間,以及圖像內部的文字(當提示詞要求時)是否實際可讀。我一邊測試一邊將數據記錄在試算表中,而不是事後依賴記憶,因為在經過一整個下午的測試後,有幾個模型混在了一起。
有幾件事很快就脫穎而出。Z-Image-Turbo 在不到四分鐘內就完成了整批 20 個提示詞,而 32B 的 FLUX 2 在租用的 GPU 上花了接近 40 分鐘。GLM-Image 和 Qwen-Image-2512 是僅有的兩個在海報提示詞上始終能正確呈現小字且沒有亂碼的模型。Waifu Diffusion 在動漫提示詞上以絕對優勢勝出,但在寫實人像上表現得非常吃力,這符合我對在狹窄數據集上訓練的模型的預期。
我根據該測試對以下七個模型進行了排名,而不僅僅是根據紙面規格或社群炒作,並且我記錄了當我加載具有合適批次大小的完整管道時,模型的實際 VRAM 使用量何時高於其官方最小值。
前 7 名 開源圖像生成模型
不同的 開源 AI 圖像生成器 專注於不同的優勢,例如寫實度、速度、結構控制或文字準確性。以下是七個廣泛使用的模型,每個模型都有明確的用途。
| 模型 | 架構 | 最低 VRAM | 授權許可 | 關鍵優勢 | 最適合 |
| Stable Diffusion 3.5 | 潛在擴散 (DiT) | 8 GB+ | 商業 | 龐大的生態系統、LoRA 支援、活躍的社群 | 一般創意工作、初學者、基於外掛程式的工作流 |
| ControlNet 1.1 | 條件式 SD 附加組件 | 8 GB+ | Apache 2.0 | 姿勢控制、深度圖、邊緣引導 | 角色一致性、建築佈局、引導式生成 |
| FLUX.2 | 流匹配 Transformer (4B–32B) | 13 GB (4B) / 24 GB (32B) | BFL 商業 | 多圖參考支援與強大的提示詞遵循能力 | 高品質視覺效果、品牌資產、行銷內容 |
| GLM-Image | 混合 AR + DiT (9B + 7B) | ~16 GB | 研究 / 自訂 | 強大的文字渲染、支援中文排版、編輯與生成一體化工作流 | 海報、UI 樣機、雙語設計、資訊圖表 |
| Qwen-Image-2512 | 擴散 + 視覺語言模型 (20B) | ~16 GB | Apache 2.0 | 多語言文字、分層 RGBA 編輯、ControlNet 支援 | 商業工作流、進階編輯、多語言內容 |
| Waifu Diffusion | Stable Diffusion 微調(動漫數據集) | 6 GB+ | CreativeML OpenRAIL | 動漫風格、漫畫視覺效果、以角色為中心的輸出 | 遊戲、視覺小說、動漫風格藝術作品 |
| Z-Image-Turbo | 蒸餾擴散 Transformer (6B) | 16 GB | Apache 2.0 | 極低延遲、支援英文 + 中文、批次處理 | 即時應用程式、大規模管道、邊緣部署 |
- Stable Diffusion 3.5
Stable Diffusion 3.5 是一款多模態擴散 Transformer (MMDiT)文字生成圖像模型,由 Stability AI 開發。它提高了圖像品質、排版、提示詞理解和整體效能。該模型有三種尺寸,專為不同的硬體設定和使用場景而設計。這款最佳圖像生成模型 仍然是使用最廣泛的開源圖像生成模型之一,並得到了龐大的開發者與內容創作者的支援。
關鍵特性:
- 三種模型尺寸:Large(8B 參數)、Large Turbo 和 Medium(約 2.5B 參數),每種都適合不同的效能和硬體需求
- 高解析度輸出:Large 模型支援在約 100 萬像素解析度下生成高品質圖像
- 快速生成變體:Large Turbo 可以在極少的步驟內產生高品質的結果
- 微調支援:專為自訂而建置,具有改進的提示詞一致性
- 靈活的使用授權:對個人和較小型企業免費,對較大型組織提供企業授權
我的體驗:4.5/5
這是這五個提示詞類別中表現最一致的模型。Large 模型幾乎每次都能在第一或第二次嘗試中完美搞定產品照和繁忙場景提示詞,而且即使在完整解析度下,它在我的 4090 上也從未崩潰過。唯一扣分的地方是文字渲染,海報提示詞上的小字仍然顯得有些扭曲。
- ControlNet 1.1
ControlNet 是一種神經網路結構,透過添加額外條件來控制擴散模型。它將神經網路區塊的權重複製到一個鎖定複本和一個可訓練複本中。可訓練的複本學習您的條件,而鎖定的複本則保留原始模型。由研究員 lllyasviel 發布,它本身並不生成圖像。相反地,這款最佳圖像模型 建立在 Stable Diffusion 之上,讓您對生成的內容進行精確的結構控制。
關鍵特性:
- 多種控制條件類型:ControlNet 支援透過 Canny 邊緣檢測、Midas 深度估算、HED 軟邊緣檢測、M-LSD 線條檢測、法線貼圖、OpenPose 人體姿態檢測以及語義分割進行控制。
- 可組合的控制: ControlNet 支援同時組合多個 ControlNet。所有生產就緒的模型都經過了多個 ControlNet 組合的廣泛測試,並且透過 A1111 外掛程式提供官方的 Multi-ControlNet 支援。
- v1.1 中改進的穩健性:ControlNet 1.1 新增了新的軟邊緣處理、多個新的預處理器(如 Canny、Depth 和 Inpaint),並與 1.0 版本相比增強了模型的整體穩健性和圖像品質。
- 基於指令的編輯:ControlNet 1.1 包含一個在 Instruct Pix2Pix 數據集上訓練的模型,該模型同時使用指令提示詞和描述提示詞進行訓練。
我的體驗:4/5
我沒有針對相同的五個提示詞對 ControlNet 1.1 進行評分,因為它的官方權重是為 Stable Diffusion 1.5 而不是 SD 3.5 設計的。相反地,我將其姿態和深度控制與 SD 3.5 的運行分開進行評估。在十次重新生成中,姿態控制保持了角色的位置穩定。這表明 ControlNet 1.1 可以在相容的工作流程中提供有用的引導,但這些結果不應被視為與 SD 3.5 直接相容的證據。
- FLUX 系列
FLUX 系列由 Black Forest Labs 開發,專注於高畫質圖像生成,具有強大的提示詞對齊能力。它包含多個專為實驗和生產工作流程設計的模型。
主要特點:
- 多種變體:包括 FLUX.1 [schnell]、[dev] 以及用於編輯和控制條件的專業工具。
- 上下文內圖像編輯:允許使用文字指令更改圖像,而無需重新訓練。
- 專用編輯工具:包括支援圖像局部重繪、圖像外延繪製 (outpainting) 和結構引導。
- 開源權重可用性:支援本地部署和自定義。
- 靈活的部署選項:支援 API、本地設置和測試環境。
我的體驗:4.5/5
FLUX.2 在我測試的所有模型中提供了最清晰的精細細節,特別是在產品拍攝提示詞上,材質紋理看起來確實有光照效果,而不是像畫上去的。32B 變體在租用的 GPU 上花費的時間是我這批模型中最長的,完成完整的 20 個提示詞運行接近 40 分鐘,因此如果您趕時間,這不是首選。
- GLM-Image
GLM-Image 是一款採用混合自迴歸和擴散解碼器架構的圖像生成模型。它在文字渲染和知識密集型生成場景中展現出優勢,具有強大的高保真和細粒度細節生成能力。由 Zhipu AI 開發,它專為其他模型往往力有未逮的應用場景而構建,特別是當圖像需要包含可讀文字或資訊密集的版面配置時。
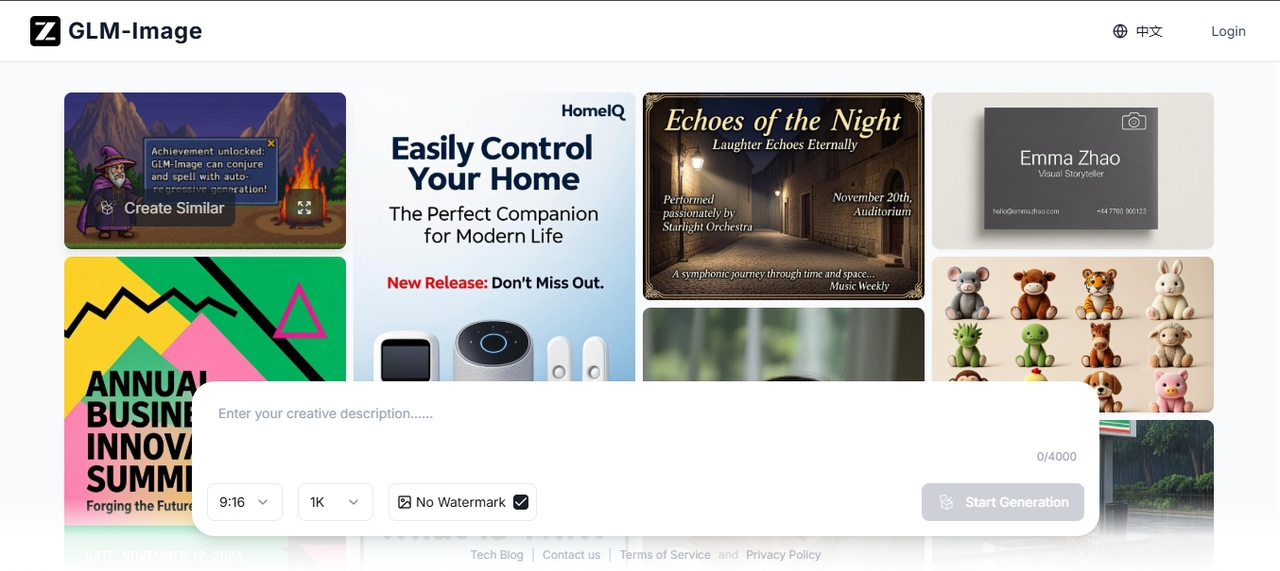
主要特點:
- 混合架構設計:結合了自迴歸編碼與擴散解碼。
- 準確的文字渲染:在圖像中生成清晰且可讀的文字。
- 支援複雜的版面配置:非常適合海報、資訊圖表和結構化視覺效果。
- 統一的生成與編輯:同時處理文字生成圖像 (text-to-image) 和圖像生成圖像 (image-to-image) 任務。
- 訓練後精煉: 使用強化學習來改善細節和對齊。
我的體驗:4/5
GLM-Image 是僅有的兩個能讓我海報提示詞上的小字完全清晰可讀的模型之一,而且它處理了資訊圖表風格的版面配置,字母之間沒有互相暈染。設定時間比大多數模型都要長,因為在商業使用前需要仔細閱讀授權條款,這降低了便利性方面的評分,而非輸出品質。
- Qwen-Image-2512
Qwen-Image-2512 是 Qwen-Image 文字生成圖像的 12 月更新版,最佳開源圖像生成模型,其特點是增強了人物真實感、更細緻的自然細節,以及改進的文字渲染準確性和品質。它直接針對注重品質、可靠性和授權清晰度的企業和商業使用場景。
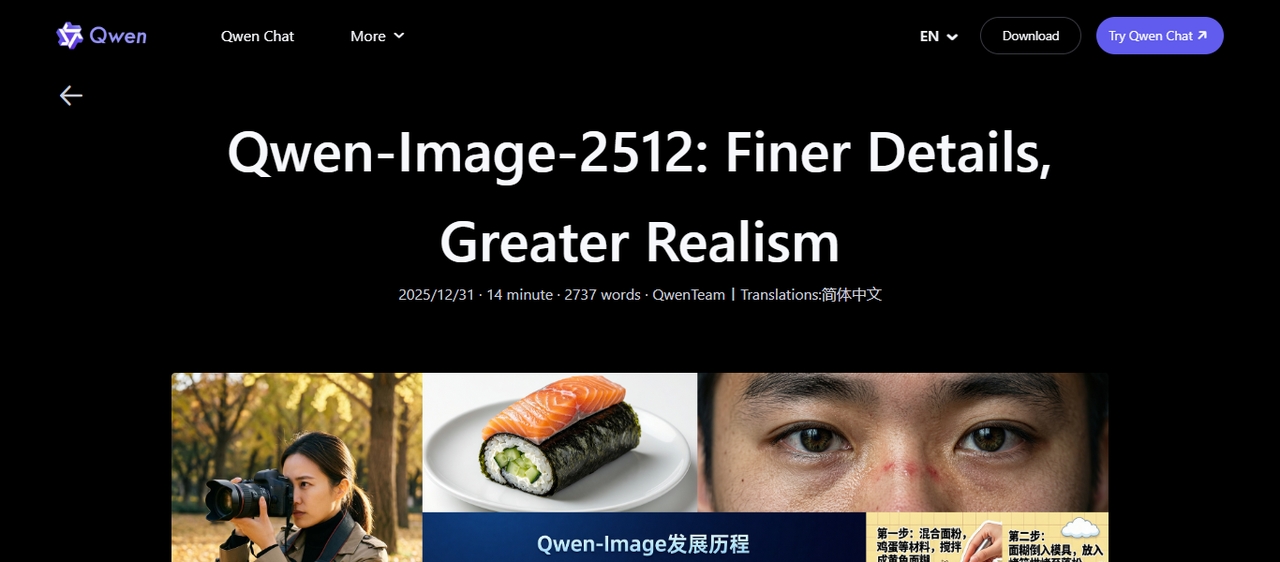
關鍵特性:
- 改進的視覺真實感: 減少生成圖像中的虛假感。
- 更好的文字準確性: 產生更清晰的內嵌文字和結構化版面。
- 詳細場景生成: 以更高的清晰度處理環境和物體。
- 開放商業授權: 在 Apache 2.0 許可下發布,可免費使用和修改。
- 完整的模型存取權: 可透過開放模型平台進行部署。
我的體驗:4.5/5
Qwen-Image-2512 是另一個在海報提示詞上正確讀取小字的模型,而且它的肖像結果在所有模型中看起來最自然,不像我從其他一些擴散模型中得到的那樣有蠟質感。結合 Apache 2.0 授權,這是我在需要快速推進且無需進行授權討論的客戶專案中會首選的模型。
- Waifu Diffusion
Waifu Diffusion 由 Hakurei 創建,專注於動漫風格的圖像生成。它專門在動漫資料集上進行訓練,這使其能夠產生一致的角色設計和風格化的視覺效果。它基於 Stable Diffusion 構建,並直接融入其生態系統,這使得已經熟悉這些工具的藝術家可以輕鬆使用。
關鍵特性:
- 專注於動漫的訓練: 該模型在大型動漫圖像資料集上進行訓練,這有助於它學習動漫藝術中常見的角色比例、面部表情和風格元素。
- 一致的角色品質: 它在不同的提示詞中保持穩定的面部特徵、髮型和服裝細節,這在多個場景中創建同一個角色時非常有用。
- 透過提示詞進行風格控制: 您可以使用動漫社群中常用的標籤和提示詞風格來引導輸出。
- 基於 SDXL 的變體: 基於 SDXL 構建的新版本在保持動漫風格不變的同時,提高了解析度、光影和更精細的細節。
- 開放獲取授權: 根據 CreativeML OpenRAIL-M 分發,允許在特定條件下使用和重新分發。
- 廣泛的社群支持: 提供大量的預訓練檢查點、LoRA 和風格包。
我的體驗:3.5/5
Waifu Diffusion 在我運行的所有三次嘗試中,都保持了角色的面部和服裝一致,從而在動漫提示詞中完全勝出。但當我將它指向我的寫實肖像提示詞時,無論我如何組織措辭,結果仍然呈現出接近動漫的外觀,這正是您對在狹窄資料集上訓練的模型所期望的。在一項工作上表現出色,但並非為其他工作而設計。
- Z-Image-Turbo
Z-Image-Turbo 是由 Tongyi-MAI 開發的。它專注於速度和效率,這使其適用於需要快速生成圖像的應用。它是緊湊型模型家族的一部分,旨在不依賴超大型架構的情況下提供強大的結果。
主要特點:
- 亞秒級生成速度:Z-Image-Turbo 證明了在不依賴龐大模型尺寸的情況下,也能實現頂級性能。
- 雙語文本渲染:準確渲染複雜的中英文文本,並在海報設計中展現出強大的排版能力和良好的字體美感。
- 提示詞增強與推理: 內置的提示詞增強器賦予了該模型推理能力。
- 高效的單流架構: Z-Image-Turbo 使用可擴展的單流 DiT 架構,其中文本、視覺語義 token 和圖像 VAE token 在序列層級被拼接成一個統一的輸入流。
我的體驗:4/5
Z-Image-Turbo 在不到四分鐘的時間內就完成了我整個包含 20 個提示詞的批次,是這七個模型中迄今為止最快的。雙語文本渲染在我海報提示詞的英文和中文版本上都表現良好。在繁雜場景提示詞上的精細細節表現比 Stable Diffusion 3.5 和 FLUX.2 稍遜一籌,考慮到該模型體積小得多,這也是合乎常理的。
選擇模型前需要考慮的關鍵因素
在決定使用某個模型之前,有幾個實用的事項值得檢查。以下是需要關注的內容及其重要性。
- 圖像品質
圖像品質取決於輸出結果與您要求的內容相比有多逼真、細緻和準確。有些模型能產生栩栩如生的效果,而有些則更偏向風格化。正確的選擇取決於您項目的實際需求。
- 速度(推理時間)
推理時間是模型生成一張圖像所需的時間。如果您正在批量生成數百張圖像或構建實時工具,速度就非常重要。一個能產生極佳效果但速度較慢的模型並不總是實用的。
- VRAM 需求
VRAM 是您的顯示卡用來運行模型所需的記憶體。較大的模型需要更多 VRAM,有時需要 16 GB 或更多。如果您的硬體不符合要求,模型根本無法運行,或者運行速度太慢而失去實用價值。
- 文本渲染能力
有些模型能很好地處理圖像中的文本,有些則完全出錯。如果您的輸出包含招牌、海報、標籤或任何書寫內容,這將成為一個關鍵因素。像 GLM-Image 和 Qwen-Image-2512 這樣的模型在構建時就特別考慮到了這一點。
- 授權許可(商業 vs 受限)
有些模型對個人或研究用途免費,但商業工作需要付費授權。其他如 Z-Image-Turbo 和 Qwen-Image-2512 則在 Apache 2.0 下完全開源。在客戶項目或產品中使用模型之前,請務必檢查授權許可。
- 生態系統與社群
強大的社群意味著更多的教學、預建的微調模型、插件,以及在出錯時能更快獲得修復。例如,Stable Diffusion 擁有數以千計的社群創建資源。一個較新或較小眾的模型可能令人印象深刻,但能提供給您的支援卻非常有限。
綜合權衡這六個因素,開源看起來就不那麼像免費的午餐了。一個在圖像品質和文本渲染方面表現出色的模型,可能需要您沒有的 16GB+ VRAM,加上在生成任何可用內容之前,需要花費實際時間來調試本地設置。如果您真正想要的是無需自己託管模型即可獲得頂級性能,或者訪問這些開源選項完全無法企及的封閉模型,那麼這正是 Framia Pro 的用武之地。
Framia Pro:您與非開源模型協作的選擇
Framia Pro 是一個圍繞工作流畫布構建的 AI 創意平台,您可以在其中將來自 Seedream 5.0 Pro、Nano Banana Pro、Kling、Seedance 2.5 和 Veo 3.1 等合作夥伴的封閉模型連接到同一個工作空間中,而不是選擇單一引擎並受其限制。您只需描述您想要的東西,Framia Pro 就會處理腳本、視覺效果以及跨連接節點的組裝,您可以在過程中的任何時間點進行編輯。它將圖像生成、影片和完整的 Marketing Studio 整合到同一個地方,因此需要非開源模型結果的創作者無需拼湊多個訂閱即可實現這一目標。
我花了幾個小時在 Framia Pro 中與上述七個模型進行對比,以了解封閉模型體驗的實際比較情況,並在下方記錄了它適合與不適合的地方。
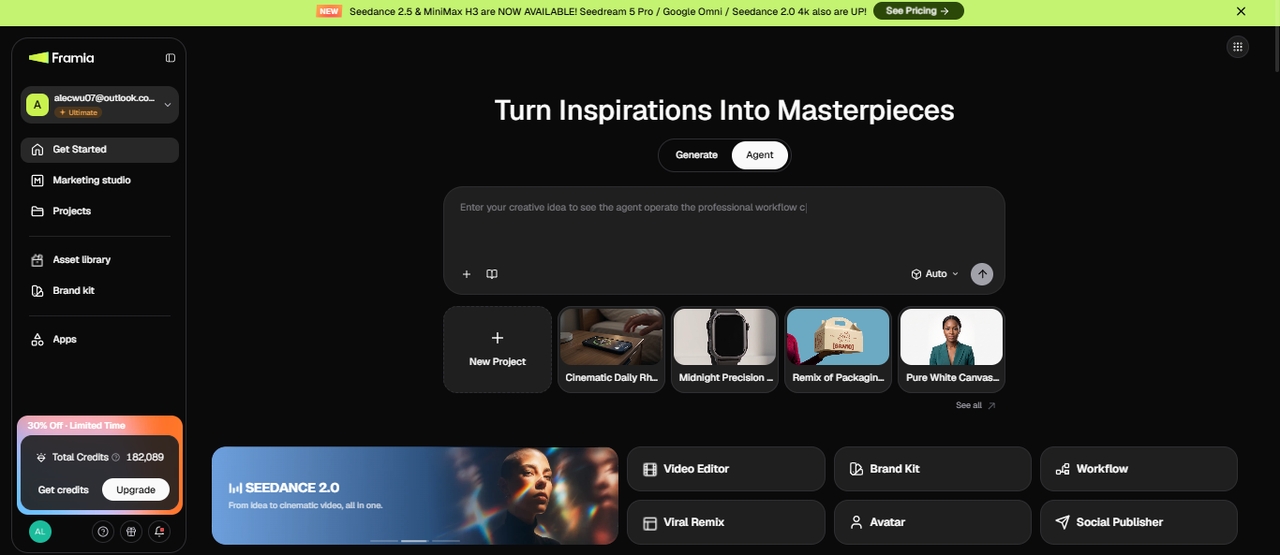
Framia Pro 圖像生成器的功能
Framia Pro 提供了一個單一的工作空間,您可以在其中使用不同的最佳圖像生成模型來創建和編輯圖像。每個功能都旨在讓您控制圖像的生成和精細化方式。
- 連接每個步驟的工作流畫布
Framia Pro 的畫布將您的項目佈局為連接的節點(腳本、圖像、影片和音訊),您可以隨著項目的進展拖動、添加或刪除這些節點。您無需生成一張圖像然後為下一個資產重新開始,而是可以構建出一個完整的序列,並僅重新運行需要更改的節點。
- 單一工作空間中的多個 AI 模型
Framia Pro 讓您可以在單一平台內訪問用於圖像的 Nano Banana Pro、Qwen Image、Midjourney v7、Flux Max 和 Seedream 4.5,以及用於影片的 Kling、Veo 3.1 和 Seedance。您可以根據想要的結果切換模型,並在不打開單獨工具的情況下並排比較輸出。
- 用於保持視覺一致性的 Brand Kit
Framia Pro 的 Brand Kit 生成器可根據單一簡報構建出標誌、調色盤、排版和社群模板,然後使您隨後生成的每張圖像都鎖定在這些品牌指南中。這對於在各個活動中製作大量視覺效果的行銷團隊和企業來說非常重要。
- 可供重混的熱門模板
Framia Pro 保留了一個熱門、易於病毒式傳播的模板庫,您可以選擇這些模板並使用自己的提示詞進行重混,而無需從空白畫布開始構建概念。這更針對快速周轉的社群內容,而不是本指南所關注的風格,但如果您也製作影片,這值得了解。
- 通過簡單的對話指令編輯圖像
您可以用簡單的語言描述更改,例如更換背景或調整標誌大小,Framia Pro 會直接將其應用於圖像。這種基於對話的編輯省去了手動遮罩或為了一個小修改而重新進行整個生成的步驟。
結論
在這篇文章中,我們探索了前 7 個開源圖像生成模型,並展示了不同工具如何處理圖像創建、性能和靈活性。每個模型在視覺質量、速度、硬體需求以及對各種風格的支持等領域都提供其自身的優勢。Framia Pro 將多個模型整合在同一個地方,為您提供更多在單一工作流中生成和編輯圖像的選擇,而無需在單獨的工具之間切換。立即嘗試!
常見問題
哪一個開源 AI 圖像生成器最常被使用?
由於其活躍的社群和廣泛的工具支持,Stable Diffusion 仍然是使用最廣泛的開源圖像生成器之一。在 Framia Pro 中,您可以在一個工作空間中訪問不同的圖像模型,這消除了為每個生成器設置單獨環境的需要,並允許在輸出之間進行更輕鬆的切換。
哪些圖像生成模型能產生更高的視覺質量?
較新的模型(例如基於 SDXL-based 和 Flux series 的模型)通常會生成更清晰的紋理、改進的光影和更好的構圖。Framia Pro 讓您可以訪問 Nano Banana Pro、Seedream 4.5、Flux Max、Qwen Image 和Midjourney v7模型,讓您立即創建圖像。
在有限的硬體上,哪種模型最適合圖像生成?
優化或輕量級版本的模型更適合顯存(VRAM)有限的系統。Framia Pro 在後端處理模型存取,因此您無需管理本地設置即可運行更大型的模型,從而減少了您對高端硬體的需求。
哪些被認為是最佳開源圖像生成模型?
像 Stable Diffusion、Waifu Diffusion 和基於 ControlNet 的設置等模型通常用於不同的任務,例如寫實、動漫藝術和結構控制。Framia Pro 將這些選項整合在一起,讓您可以在單個專案中選擇並測試多個模型。
哪些圖像模型在專業應用場景中更受青睞?
專業的工作流程通常需要穩定的輸出、一致的結果以及對編輯的支持。Framia Pro 通過提供基於對話的圖像編輯和批量生成來增加價值,這使您能夠在同一個地方微調圖像並生成多種變體,而無需切換工具。
哪一個是最佳的免費圖像生成模型?
Stable Diffusion 3.5 是最完整的免費選擇,因為 Medium 和 Large Turbo 變體可以在消費級硬體上運行,且其許可證涵蓋了小型企業的商業用途。Z-Image-Turbo 和 Qwen-Image-2512 在 Apache 2.0 許可下也是完全免費的,輸出速度更快,但目前圍繞它們建立的社群較小。
是否有可用的開源本地 AI 圖像生成器?
是的。Stable Diffusion 3.5、ControlNet 1.1、FLUX.2、Waifu Diffusion 和 Z-Image-Turbo 在下載後都可以在您自己的硬體上本地運行,無需雲端帳戶或訂閱。主要需求是足夠的顯存(VRAM),通常根據您選擇的模型,需要 6GB 到 24GB 不等。
我可以使用開源圖像模型進行商業專案嗎?
是的,但這取決於模型的許可證。有些模型允許商業用途,而其他模型則有限制。在將生成的圖像用於客戶工作、產品或付費推廣活動之前,請務必仔細閱讀許可條款。