Les modèles de génération de vidéos par IA évoluent rapidement, et de nouveaux outils continuent d'apparaître avec de meilleurs résultats, des clips plus longs et plus de contrôle. Choisir le bon n'est pas simple lorsque chaque modèle prétend offrir quelque chose de différent et que les options ne cessent de croître. Ce guide vous présente les meilleurs modèles d'IA vidéo à connaître dès maintenant. Vous verrez ce que chacun fait de bien, là où il a des lacunes, et lequel correspond à vos besoins de contenu. Lisez ce qui suit pour trouver un modèle qui correspond à votre flux de travail et vous fait gagner du temps sur la création de vidéos.
Que sont les modèles de génération de vidéos par IA ?
Les modèles de génération de vidéos par IA sont des systèmes d'intelligence artificielle qui créent du contenu vidéo automatiquement à partir d'une entrée donnée (le plus souvent une description textuelle, une image ou un clip vidéo existant). Ces modèles synthétisent un contenu visuel entièrement nouveau à partir de zéro, uniquement par le calcul. Ils y parviennent en s'entraînant sur d'immenses ensembles de données de millions de clips vidéo et de leurs descriptions, afin de pouvoir générer ultérieurement de nouvelles scènes qui respectent ces mêmes règles.
Le processus de génération proprement dit fonctionne grâce à une technique appelée diffusion. Le modèle commence par un bruit purement aléatoire, puis l'affine au cours de dizaines d'étapes et sculpte progressivement ce chaos pour en faire une vidéo. Cela fonctionne parce que, pendant l'entraînement, le modèle a appris à inverser un processus de destruction : on lui a montré de vraies vidéos progressivement corrompues en bruit, et il a appris à annuler chaque étape. Au moment de la génération, votre invite textuelle sert de guide tout au long de ce processus, orientant chaque étape d'affinement pour que le résultat final reflète ce que vous avez décrit.
La partie la plus difficile, cependant, n'est pas de générer une seule image. Il s'agit de maintenir la cohérence de centaines d'images entre elles au fil du temps. Les modèles de génération de vidéos gèrent cela en traitant des séquences d'images entières en même temps, ce qui permet à chaque image de faire référence aux autres pendant la génération. C'est ce qui rend la génération de vidéos beaucoup plus exigeante en termes de calcul que la génération d'images.
Quels sont les différents types de modèles vidéo par IA ?
Les outils vidéo d'IA ne fonctionnent pas tous de la même manière. Chaque type suit un chemin différent pour transformer votre idée en vidéo, et connaître la différence vous évite de choisir le mauvais outil.
Modèles d'IA de texte en vidéo
Vous commencez par des mots, et le modèle les transforme en une scène en mouvement. Vous écrivez une courte description de ce que vous voulez, et le système construit les visuels à partir de zéro.
Ce type fonctionne bien lorsque vous avez une idée en tête mais aucun visuel de prêt. Vous pouvez décrire un produit, une courte histoire ou même une scène pour une publicité, et obtenir une vidéo en retour. On a l'impression d'écrire un scénario et de le voir prendre vie en quelques minutes.
Modèles d'image en vidéo
Ici, vous avez déjà une image et vous souhaitez lui donner vie. Le modèle ajoute du mouvement, des déplacements de caméra ou de petits changements qui transforment une image statique en un court clip.
Cette approche convient aux démonstrations de produits et aux publications sur les réseaux sociaux où vous souhaitez un mouvement rapide sans tout créer à partir de zéro.
Modèles vidéo multimodaux
Ces modèles fonctionnent avec plus d'un type d'entrée en même temps. Vous pouvez mélanger du texte, des images, de l'audio et même des clips vidéo existants pour guider le résultat final.
Cela vous donne plus de contrôle sur le résultat de la vidéo. Vous ne vous contentez pas de décrire une scène, vous la façonnez avec plusieurs entrées. Ce contrôle est utile lorsque vous souhaitez des détails spécifiques, une narration plus fluide ou une vidéo qui suit une direction claire.
Top 5 des modèles de génération de vidéos par IA propriétaires en 2026
Les modèles d'IA de texte en vidéo ont atteint un point où vous pouvez créer des publicités, des courts-métrages et des clips de produits en quelques minutes au lieu de plusieurs jours. L'écart entre les modèles est cependant réel. Certains se concentrent sur la qualité cinématographique, d'autres sur la vitesse ou le contrôle du montage, et quelques-uns essaient de tout équilibrer.
Voici les meilleurs modèles propriétaires que vous devriez connaître dès maintenant.
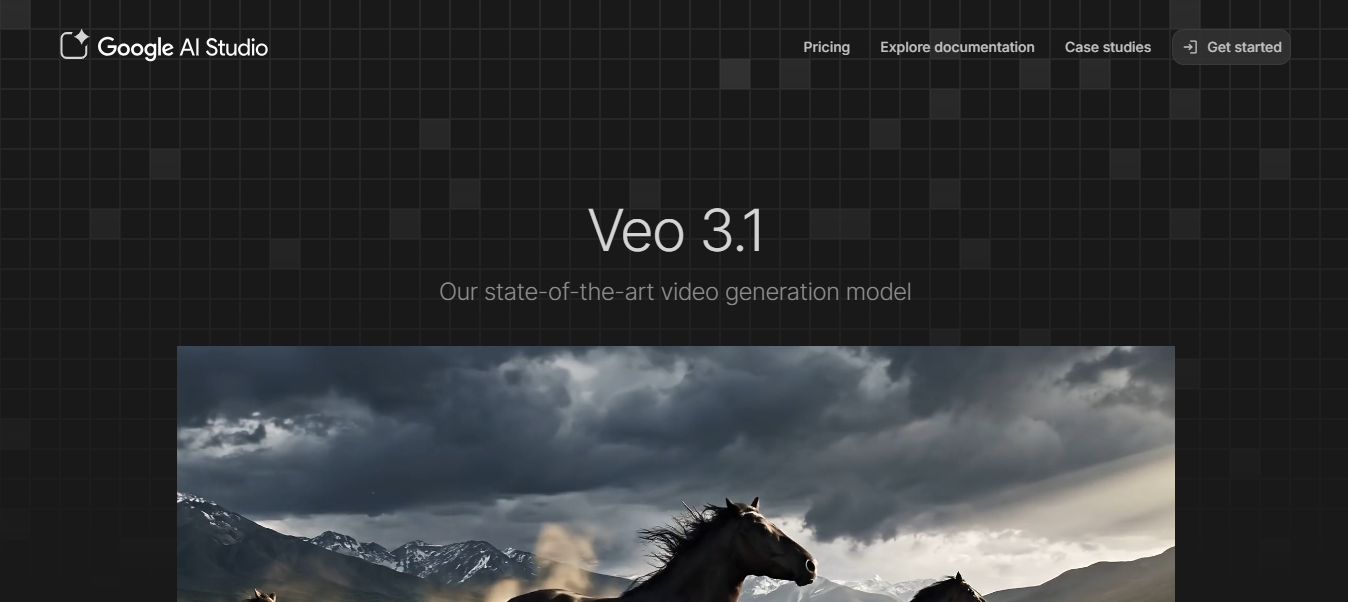
Veo 3.1
Veo 3.1 est le modèle phare de génération de vidéo de Google et l'un des outils les plus avancés techniquement disponibles à l'heure actuelle. Il crée des vidéos avec un audio parfaitement synchronisé qui comprend les dialogues des personnages, des effets sonores et un son ambiant, le tout généré à partir d'une seule invite. Il s'est fait connaître comme le moteur derrière des vidéos virales sur les plateformes sociales après son lancement en octobre 2025. Son intégration dans l'écosystème plus large de Google en fait un choix naturel pour les équipes travaillant déjà au sein de Google Workspace.
Fonctionnalités
- Audio natif : dialogues, effets sonores (SFX) et son ambiant en une seule passe.
- Résolution 4K : rendu jusqu'en ultra-haute définition.
- Multi-référence : prend en charge jusqu'à 3 images de référence.
- Longue durée : produit des résultats allant jusqu'à une minute complète.
- Dialogue par prompt : écrivez les répliques des personnages directement dans votre prompt.
Avantages
- Qualité audio native inégalée.
- Excellent réalisme et précision de l'éclairage.
- Intégration profonde dans l'écosystème Google.
- Grande précision par rapport au prompt.
Inconvénients
- Vidéos avec filigrane sur les forfaits inférieurs.
- Moins flexible pour le contenu stylisé ou non réaliste.
Runway Gen-4.5
Runway est l'un des noms les plus établis dans le domaine des modèles vidéo d'IA générative. Il a lancé Gen-4.5 fin 2025 avec des améliorations majeures de la qualité vidéo et du séquençage multi-prises. La plateforme comprend désormais une interface de chat où vous pouvez affiner vos vidéos par la conversation au lieu de réécrire des prompts à plusieurs reprises. Il est largement considéré comme l'outil de référence pour la cohérence cinématographique et le contrôle créatif.
Fonctionnalités
- Pinceaux de mouvement : peignez précisément les parties d'une scène qui doivent bouger.
- Multi-prises : enchaînez plusieurs clips en une seule séquence cohérente.
- Act-one : capture des expressions faciales et du mouvement.
- Édition par chat : affinez les résultats grâce à une conversation naturelle.
- Sortie 4K : exportation en ultra-haute résolution.
Avantages
- La meilleure cohérence de scène et de personnage de sa catégorie.
- Des contrôles créatifs puissants pour les professionnels.
- Une communauté et un écosystème solides.
Inconvénients
- Coûteux aux niveaux supérieurs.
- Plus lent que certains concurrents pour le contenu social rapide.
- Courbe d'apprentissage plus raide pour les débutants.
Seedance 2.0
Seedance 2.0 est le dernier modèle d'IA vidéo de ByteDance, sorti début 2026, et il a rapidement attiré l'attention pour ses vidéos réalistes de qualité cinématographique. De nombreuses personnes de l'industrie cinématographique ont même commencé à discuter de sa proximité avec une qualité de production réelle. Il fonctionne avec du texte, des images, de l'audio et de la vidéo en même temps, ce qui vous donne plus de contrôle sur l'apparence et le son de la vidéo finale. Vous pouvez y accéder via Framia Pro, CapCut, Dreamina et Pippit, bien qu'il ne soit pas encore disponible dans toutes les régions.
Fonctionnalités
- Entrée multimodale : combinez texte, images, vidéo et audio en un seul passage.
- Audio natif : dialogues, effets sonores (SFX) et sons d'ambiance générés simultanément.
- Système de référence @ : étiquetez des personnages, styles ou sons spécifiques sur les ressources téléchargées.
- Multi-prises : plusieurs prises avec des coupures et des transitions naturelles au sein d'une seule génération.
- Moteur physique : collisions réalistes, mouvements de tissus et séquences à forte action.
- Sortie 2K : résolution native jusqu'à 2048x1080.
Avantages
- Le système d'entrée multimodale le plus performant disponible.
- Un clip de 10 secondes en 2K est rendu en environ 30 secondes sur les abonnements payants.
- Cohérence exceptionnelle des personnages et des scènes d'une image à l'autre.
- Version gratuite solide via Dreamina pour évaluation.
Inconvénients
- Le déploiement est encore limité à certains marchés.
- Temps de configuration plus long.
Kling 3.0
Kling 3.0 a été lancé le 4 février 2026 et, en quelques jours, a été qualifié de bond en avant le plus important de l'année dans la génération de vidéos par IA. Il est construit sur l'architecture Omni One, qui utilise l'attention conjointe spatio-temporelle 3D (3D Spacetime Joint Attention) et le raisonnement par chaîne de pensée (Chain-of-Thought) pour générer des vidéos de qualité cinéma respectant la physique, où les personnages et les objets se déplacent avec une gravité, un équilibre, une déformation et une inertie réels. Le modèle prend en charge une entrée multimodale complète englobant le texte, les images, l'audio et la vidéo, et peut générer de l'audio natif dans plusieurs langues, notamment l'anglais, le chinois, le japonais, le coréen et l'espagnol, avec un contrôle précis du dialogue des personnages et de l'ordre de parole.
Fonctionnalités
- Physique Omni One : simulation réelle de la gravité, des collisions et de l'inertie.
- Audio natif : voix off, synchronisation labiale, SFX et musique.
- Storyboard multi-plans : jusqu'à 6 plans avec un contrôle de caméra digne d'un réalisateur.
- Mode brouillon : générez jusqu'à 20 fois plus vite pour un prototypage rapide.
- Sortie 4K/60 ips : avec exportation HDR 16 bits et EXR.
- Éditeur 7-en-1 : ajout d'objets, remplacement d'arrière-plan, transfert de style dans un seul outil.
Avantages
- La physique et les mouvements humains les plus réalistes disponibles.
- Audio multilingue natif avec contrôle des dialectes et des accents.
- Entrée abordable à 7,99 $/mois avec une offre gratuite solide.
- S'exporte directement dans les pipelines VFX professionnels (Nuke, After Effects, DaVinci).
Inconvénients
- Le rendu d'un multi-plans de 15 secondes peut prendre plus de 5 minutes.
- La sortie 4K est actuellement limitée aux abonnements de niveau supérieur.
- Les périodes de forte demande prolongent les files d'attente de rendu.
Hailuo 02
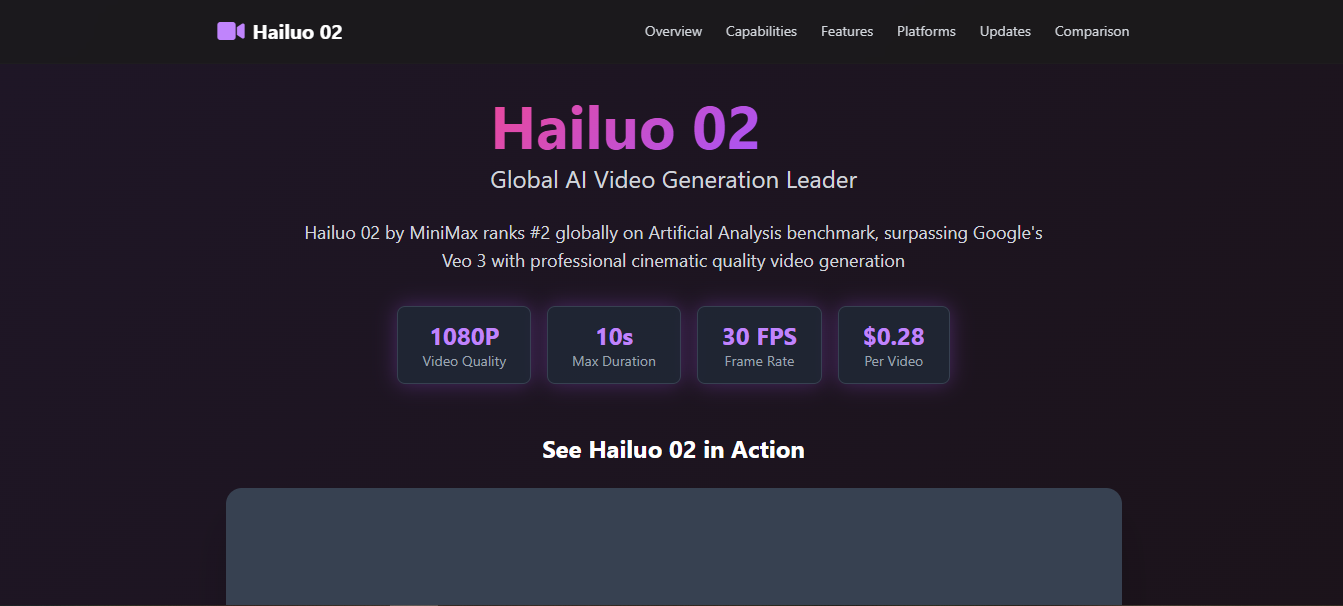
Hailuo 02 est le modèle vidéo phare de MiniMax et l'une des plus grandes surprises dans le domaine de la vidéo IA depuis sa sortie. Il se classe au 2e rang mondial sur le benchmark Artificial Analysis avec un score de 92,1 et bat les 87,3 de Google Veo 3 tout en coûtant 30 % de moins, à 0,28 $ par clip HD de 10 secondes. Il est construit sur une nouvelle architecture appelée Noise-aware Compute Redistribution (NCR), qui multiplie par 2,5 l'efficacité de l'entraînement et de l'inférence. Cela permet à MiniMax d'étendre le modèle à trois fois plus de paramètres et de l'entraîner sur un ensemble de données quatre fois plus grand que son prédécesseur.
Fonctionnalités
- Architecture NCR : entraînement et inférence 2,5 fois plus rapides avec une consommation d'énergie réduite de 22 %.
- Moteur physique : gère de manière fluide la physique complexe comme les débris volants, les objets rebondissants et les tremblements de caméra.
- 1080p natif : sortie Full HD sans mise à l'échelle.
- Balises de caméra de réalisateur : commandes en langage naturel pour le dolly-zoom, l'orbite et le tremblement caméra à l'épaule.
- T2V et I2V : text-to-video et image-to-video sur une seule plateforme.
- Optimiseur de prompt : réécrit les prompts bruts en instructions cinématographiques structurées.
Avantages
- Génère un clip 1080p en moins de 62 secondes, plus rapide que la plupart des concurrents à qualité comparable.
- Meilleure simulation physique de sa catégorie, y compris la gymnastique et la dynamique des fluides.
- Modèle de qualité professionnelle le plus abordable à 0,28 $ par clip.
- Résultats cohérents sur des prompts répétés.
Inconvénients
- Pas de séquençage long format ou multi-prises intégré.
- Filigranes appliqués sur les exportations de la version gratuite.
Top 3 des générateurs de vidéos IA open source en 2026
Les générateurs de vidéos open source attirent sérieusement l'attention maintenant. Vous bénéficiez de plus de contrôle, de plus de liberté pour exécuter des modèles localement, et d'aucune limite stricte comme avec les outils fermés. Le compromis est cependant clair. Vous avez souvent besoin d'un matériel puissant et d'un peu de configuration avant que tout ne fonctionne correctement.
Voici trois modèles open source qui se démarquent :
Wan 2.2
Wan 2.2 est l'un des générateurs de vidéos open source les plus discutés en ce moment. Il provient d'Alibaba et se concentre sur la qualité cinématographique avec des mouvements fluides et une grande précision de prompt. Vous pouvez l'utiliser pour des tâches de text-to-video et d'image-to-video, ce qui le rend flexible pour différents flux de travail. Il fonctionne également sur des GPU grand public, ce qui le rend plus accessible que de nombreux modèles haut de gamme.
Fonctionnalités
- Architecture MoE : experts spécialisés pour différentes étapes de bruit.
- T2V/I2V hybride : entrée de texte et d'image dans un modèle unifié.
- Quantification GGUF : fonctionne sur des GPU grand public avec 4 Go de VRAM.
- Contrôles cinématographiques : étiquettes d'éclairage, de contraste et de ton de couleur.
- Support bilingue : gestion des prompts en anglais et en chinois.
- Licence Apache 2.0 : utilisation commerciale complète autorisée.
Avantages
- Le modèle open-source de haute qualité le plus accessible disponible.
- Un contrôle fort de la stylisation et du rendu du texte à l'écran.
- La variante 1.3B permet une véritable génération de vidéo sur 8 Go de VRAM.
- Le meilleur rapport qualité-ressources pour la plupart des utilisateurs.
Inconvénients
- Les détails de texture fine restent en retrait par rapport à HunyuanVideo dans les scènes complexes.
- L'extension multi-GPU est moins documentée que pour les modèles concurrents.
Mochi (Genmo)
Mochi 1 est un modèle à 10 milliards de paramètres basé sur une nouvelle architecture AsymmDiT, publié sous licence Apache 2.0. Il excelle dans le mouvement photoréaliste à 30 images par seconde pour des sujets réalistes, ce qui le rend particulièrement performant pour le contenu de style documentaire, les environnements naturels et les mouvements humains crédibles. C'était l'un des premiers modèles open-source à inciter les gens à prendre au sérieux la génération de vidéos locale.
Caractéristiques
- Backbone AsymmDiT : architecture spécialement conçue pour la synthèse vidéo.
- Sortie 30 ips : mouvement fluide à la fréquence d'images native.
- Fine-tuning LoRA : personnalisez sur vos propres ensembles de données vidéo.
- Licence Apache 2.0 : ouverte à la recherche et à l'utilisation commerciale.
- Intégration ComfyUI : prise en charge des flux de travail basés sur des nœuds.
- Encodage T5-XXL : forte compréhension du texte et respect des prompts.
Avantages
- La licence la plus permissive de tous les modèles ouverts de haute qualité.
- Excellent mouvement photoréaliste et mouvement naturel.
- Une communauté forte avec un partage actif de fine-tunes.
Inconvénients
- Limité à une résolution de 480p ; nécessite un upscaling pour une sortie HD.
- Nécessite 20 Go+ de VRAM en pleine précision.
HunyuanVideo (Tencent)
HunyuanVideo est le modèle vidéo open-source phare de Tencent et l'une des options les plus avancées disponibles actuellement. Il se concentre sur la génération de vidéos de haute qualité avec une forte cohérence des mouvements et une meilleure structure de scène par rapport à de nombreux autres modèles ouverts. Le modèle est construit à l'aide d'une approche basée sur les transformers, conçue pour gérer à la fois les données visuelles et temporelles. Il est souvent utilisé par les développeurs et les équipes de recherche qui souhaitent un meilleur contrôle sur les flux de travail de génération vidéo.
Fonctionnalités
- Fusion à double flux : traitement séparé du texte et de la vidéo avant la fusion.
- Parallélisme xDiT : parallélisme de séquence multi-GPU pour une inférence plus rapide.
- Quantification FP8 : empreinte mémoire réduite sans perte de qualité majeure.
- Diffusers + comfyUI : intégration d'écosystème plug-and-play.
- VAE 3D causal : compression spatio-temporelle pour un mouvement cohérent.
Avantages
- Meilleure qualité cinématographique et réalisme des visages en open-source.
- Écosystème LoRA massif pour la personnalisation des styles et des personnages.
- Excellente gestion des scènes complexes et multi-personnes.
Inconvénients
- Un clip de 5 secondes peut prendre plus de 15 minutes selon les paramètres.
- Complexité de configuration élevée ; ne convient pas aux débutants
Fonctionnalités clés à comparer dans les modèles vidéo
Avant de vous engager sur une plateforme, voici les six éléments auxquels il convient de prêter attention.
- Qualité vidéo (résolution, réalisme)
Il s'agit simplement de la qualité du rendu visuel lorsque vous le visionnez. Est-il net et crédible, ou semble-t-il évident que quelque chose ne va pas ? Les meilleurs outils produisent des vidéos qui pourraient vous tromper au premier coup d'œil. Les moins bons se trahissent immédiatement par un éclairage plat ou des visages étranges.
- Précision du mouvement
La précision du mouvement évalue la façon dont les objets et les personnages se déplacent dans la vidéo. Les bons modèles maintiennent un mouvement fluide sans sauts étranges ni distorsions. Cela est particulièrement important dans les scènes de marche, de gestes ou d'action rapide.
- Compréhension des prompts
Vous devriez choisir un modèle qui suit votre prompt vidéo de près. Un modèle performant comprend les détails de votre texte et les transforme en visuels correspondants. Si un modèle manque des instructions, vous aurez besoin de plus de tentatives pour obtenir le résultat souhaité.
- Limites de durée des clips
Vérifiez toujours la durée de vidéo qu'un modèle peut générer en une seule fois. Certains modèles ne prennent en charge que des clips courts, tandis que d'autres permettent des séquences plus longues. La prise en charge de clips plus longs est utile lorsque vous travaillez sur de la narration ou des scènes complètes sans avoir à les diviser en plusieurs parties.
- Prise en charge audio
Vous devriez travailler avec un modèle capable de générer de l'audio si votre projet nécessite du son. Cela peut inclure de la voix, du bruit de fond ou des effets de base qui correspondent aux visuels. Les modèles avec prise en charge audio réduisent le besoin d'outils de montage sonore séparés.
Explorez les meilleurs modèles vidéo d'IA sur Framia Pro
Framia Pro rassemble des modèles puissants de génération de vidéos et d'images en un seul endroit. Sur Framia, vous pouvez accéder à plusieurs moteurs vidéo avancés tels que Veo 3.1, Seedance 2.0, Kling 3.0 et plus encore à partir d'un tableau de bord unique. La plateforme vous permet de partir d'une idée et de la transformer rapidement en contenu vidéo à l'aide de texte, d'images, d'audio ou de combinaisons d'entrées. Framia prend également en charge différents agents créatifs pour des cas d'utilisation spécifiques comme les clips musicaux, les publicités ou la narration, ce qui en fait un choix flexible pour les créateurs de tous niveaux.
Qu'apporte Framia Pro ?
- Modifier des vidéos par chat
Vous pouvez décrire les modifications que vous souhaitez en texte brut, et le système les applique à votre vidéo. Plutôt que d'utiliser des lignes de temps ou des outils manuels, vous guidez les modifications en saisissant des instructions. Cela facilite l'ajustement des scènes, la coupe de parties ou le perfectionnement des visuels sans expérience approfondie du montage.
- Travailler avec différentes durées et formats d'image
Vous pouvez créer des vidéos de différentes longueurs selon vos besoins, des clips courts aux scènes plus longues. La plateforme prend également en charge plusieurs formats d'image tels que le format vertical, carré et grand écran. Cela vous permet de préparer du contenu pour des plateformes comme TikTok, Instagram ou YouTube sans étapes de redimensionnement supplémentaires.
- Synchroniser l'audio avec vos clips
Framia Pro synchronise le son avec les visuels, de sorte que les dialogues, la musique ou les effets correspondent au timing de la vidéo. Il fait correspondre le mouvement des lèvres avec la parole et maintient l'audio synchronisé avec les changements de scène. Cela réduit le besoin d'ajustements audio manuels pendant le montage.
- Prise en charge de l'édition de storyboard
Vous pouvez organiser votre vidéo en scènes avant la génération finale. Chaque partie du storyboard représente un segment de votre vidéo, que vous pouvez ajuster, réordonner ou affiner. Cela vous donne plus de contrôle sur la structure de votre vidéo et permet de planifier le flux des scènes avant le rendu.
Comment utiliser les modèles vidéo d'IA sur Framia Pro ?
Vous pouvez suivre ces trois étapes rapides pour utiliser différents modèles d'IA sur le générateur de vidéo IA de Framia Pro pour créer des vidéos :
Étape 1 : Inscrivez-vous et définissez votre idée
- Créez votre compte Framia Pro et ouvrez l'espace de travail vidéo.
- Écrivez une description claire de la scène dans la boîte de prompt afin que le modèle comprenne ce que vous voulez.
- Ajoutez une image de référence si vous souhaitez un meilleur contrôle sur le style ou les personnages, ce qui fonctionne bien avec des modèles comme Kling 3.0 et Seedance 2.0.
Étape 2 : Choisissez le bon modèle d'IA et générez
- Cliquez sur « Select Models » et ouvrez l'onglet « Video » pour choisir le modèle qui correspond à votre objectif.
- Définissez la durée et le format d'image de votre vidéo en fonction de l'endroit où vous prévoyez de la publier.
- Ensuite, cliquez sur « Generate » pour créer votre clip.
Étape 3 : Examiner, affiner et exporter
- Regardez la vidéo générée et vérifiez si le mouvement, les détails et la scène correspondent à votre idée.
- Ajoutez des prompts de suivi pour ajuster des parties de la vidéo, telles que le mouvement, l'éclairage ou le style, selon le modèle que vous avez utilisé.
- Une fois que tout semble correct, cliquez sur « Download » pour enregistrer la vidéo finale sur votre appareil.
Conclusion
Dans cet article, nous avons exploré ce que sont les modèles de génération vidéo IA et passé en revue 5 outils propriétaires et 3 outils open-source que vous pouvez utiliser pour votre projet. Vous devriez vous concentrer sur votre objectif avant de choisir un modèle. Certains outils fonctionnent bien pour des clips rapides pour les réseaux sociaux, tandis que d'autres conviennent à la narration ou à des scènes de haute qualité avec du son et des détails. Lorsque vous utilisez un modèle adapté à votre tâche, vos résultats deviennent plus précis et plus faciles à gérer. Si vous souhaitez accéder à plusieurs des meilleurs modèles vidéo IA en un seul endroit, vous pouvez explorer Framia Pro et basculer entre les outils en fonction des besoins de votre projet.
FAQ
Quels sont les meilleurs modèles d'IA pour la génération de vidéos actuellement ?.
Certains des meilleurs modèles d'IA pour la génération de vidéos incluent Veo, Runway, Seedance 2.0, Kling et Pika. Chacun se concentre sur des forces différentes telles que le réalisme, le mouvement ou la facilité d'utilisation. Sur Framia Pro, vous pouvez accéder à plusieurs de ces modèles et basculer en fonction de votre projet.
Que se passe-t-il avec le modèle vidéo Sora ?
Les actualités du modèle vidéo Sora ont révélé qu'il a récemment été abandonné en tant qu'application grand public et API en 2026. OpenAI a décidé de l'arrêter pour se concentrer sur d'autres domaines tels que la robotique et la recherche avancée.
Existe-t-il des générateurs vidéo IA open-source disponibles ?
Oui, des générateurs vidéo IA open-source tels que Wan, Mochi et HunyuanVideo sont disponibles. Vous pouvez les exécuter localement et les ajuster en fonction de vos besoins, bien que la configuration nécessite des connaissances techniques. Framia Pro offre une option plus simple si vous préférez des modèles prêts à l'emploi sans configuration locale.
Les modèles vidéo IA peuvent-ils créer de longues vidéos ?
La plupart des modèles vidéo IA se concentrent encore sur des clips courts plutôt que sur des vidéos complètes. Certains outils permettent des scènes plus longues, mais ils nécessitent souvent de combiner plusieurs clips. Framia Pro prend en charge différentes durées, vous permettant ainsi de créer et de gérer des clips en fonction de vos besoins.
Quel modèle vidéo IA devriez-vous utiliser ?
Vous devriez choisir un modèle en fonction de votre objectif et du style de votre contenu. Veo fonctionne bien pour les scènes réalistes, Kling gère le mouvement, et Seedance offre plus de contrôle avec des entrées multiples. L'agent vidéo de Framia Pro vous permet de tester ces modèles en un seul endroit et de choisir ce qui convient à votre flux de travail.