I modelli di generazione di immagini open source hanno aperto un mondo completamente nuovo per creatori, sviluppatori e aziende. Ora puoi trasformare il testo in immagini, modificare foto, produrre video e creare oggetti 3D, senza spendere una fortuna in software. Questo settore è cresciuto rapidamente, con oltre 90.000 modelli text-to-image disponibili solo su Hugging Face. Scegliere l'open source significa nessun abbonamento, pieno controllo sui propri dati e la libertà di personalizzare le cose in base alle proprie esigenze. Questa guida copre i migliori modelli in circolazione e tutto il resto di cui hai bisogno per iniziare subito.
Cosa sono i modelli di generazione di immagini open source?
I modelli di generazione di immagini open source sono programmi software che creano immagini a partire da descrizioni scritte. Digiti ciò che vuoi vedere, ad esempio un tramonto sulle montagne, il mockup di un prodotto, un personaggio dei cartoni animati, e il modello lo produce sotto forma di immagine.
Pensa a questo come all'assunzione di un artista che ha studiato milioni di dipinti, foto e illustrazioni per tutta la vita. Descrivi ciò che desideri e lui lo disegna per te in pochi secondi. Con la differenza che questo artista non dorme mai, non fa pagare a progetto e vive sul tuo computer.
Ciò che li rende "open source" è che il codice è pubblicamente disponibile. Chiunque può scaricarli, usarli, modificarli o costruirci sopra gratuitamente. Questo è diverso dagli strumenti a pagamento come Midjourney o Adobe Firefly, dove paghi per accedere al software e non hai alcun controllo su come funziona dietro le quinte.
Questi modelli sono addestrati su milioni di immagini, che insegnano loro a comprendere la relazione tra parole ed elementi visivi. Nel tempo, sono diventati abbastanza bravi da produrre risultati di qualità professionale, e i migliori ora rivaleggiano con costose opzioni commerciali.
Perché scegliere l'open source rispetto ai modelli di immagini chiusi?
I modelli di immagini a pagamento sono convenienti, ma presentano limiti reali. Paghi per immagine, affidi i tuoi dati a server di terze parti e non hai voce in capitolo su come funziona il software. I modelli open source risolvono tutto questo. Ecco perché sempre più creatori e sviluppatori stanno effettuando il passaggio.
- Pieno controllo sui risultati
Con gli strumenti chiusi, la piattaforma decide cosa puoi e non puoi generare. I modelli open source vengono eseguiti sulla tua configurazione, quindi sei tu a stabilire le regole. Ottieni esattamente ciò che chiedi, senza che filtri sui contenuti o restrizioni della piattaforma si mettano di mezzo.
- Capacità di perfezionare i modelli
I modelli chiusi sono bloccati e non possono essere modificati per adattarsi alle tue esigenze specifiche. Tuttavia, puoi addestrare ulteriormente i modelli open source sulle tue immagini, stili o linee guida del brand. Ciò significa che il risultato inizia ad avere un aspetto e uno stile unici, diversi da quelli di chiunque altro utilizzi lo stesso strumento.
- Nessun costo per immagine
La maggior parte degli strumenti commerciali ti fa pagare per ogni immagine generata, il che si somma rapidamente. Ma con i modelli open source, esegui tutto sul tuo hardware e generi tutte le immagini che desideri. L'unico costo è l'elettricità e le macchine che fanno il lavoro.
- Privacy e utilizzo offline
Quando utilizzi uno strumento basato su cloud, i tuoi prompt e le tue immagini passano attraverso i server di qualcun altro. I modelli open source possono essere eseguiti interamente offline, quindi nulla lascia la tua macchina. Questo è molto importante per le aziende che gestiscono progetti sensibili o contenuti proprietari.
- Grande supporto della community
I modelli open source sono supportati da migliaia di sviluppatori, ricercatori e creatori in tutto il mondo. Condividono quotidianamente versioni perfezionate, tutorial, plugin e correzioni. Se riscontri un problema, è probabile che qualcuno nella community lo abbia già risolto.
I migliori 7 modelli di generazione di immagini open source
Diversi generatori di immagini AI open source si concentrano su punti di forza diversi come il realismo, la velocità, il controllo della struttura o la precisione del testo. Di seguito sono riportati sette modelli ampiamente utilizzati, ciascuno con uno scopo chiaro.
| Modello | Architettura | VRAM minima | Licenza | Punti di forza chiave | Ideale per |
| Stable Diffusion 3.5 | Latent diffusion (DiT) | 8 GB+ | Commerciale | Grande ecosistema, supporto LoRA, community attiva | Lavoro creativo generale, principianti, flussi di lavoro basati su plugin |
| ControlNet 1.1 | Componente aggiuntivo SD condizionato | 8 GB+ | Apache 2.0 | Controllo della posa, mappe di profondità, guida dei bordi | Coerenza dei personaggi, layout architettonici, generazione guidata |
| FLUX.2 | Flow matching transformer (4B–32B) | 13 GB (4B) / 24 GB (32B) | BFL Commerciale | Riferimento multi-immagine, forte precisione del prompt, output molto veloce | Elementi visivi di alta qualità, asset di brand, contenuti di marketing |
| GLM-Image | AR ibrido + DiT (9B + 7B) | ~16 GB | Ricerca / Personalizzata | Forte rendering del testo, supporta la tipografia cinese, modifica + generazione in un unico flusso | Poster, mockup di UI, design bilingue, infografiche |
| Qwen-Image-2512 | Diffusione + modello linguistico visivo (20B) | ~16 GB | Apache 2.0 | Testo multilingue, editing RGBA a livelli, supporto ControlNet | Flussi di lavoro commerciali, editing avanzato, contenuti multilingue |
| Waifu Diffusion | Stable Diffusion perfezionato (dataset anime) | 6 GB+ | CreativeML OpenRAIL | Stile anime, elementi visivi manga, risultati incentrati sui personaggi | Giochi, visual novel, opere d'arte in stile anime |
| Z-Image-Turbo | Distilled diffusion transformer (6B) | 16 GB | Apache 2.0 | Latenza molto bassa, supporta inglese + cinese, elaborazione batch | App in tempo reale, pipeline su larga scala, implementazione edge |
- Stable Diffusion 3.5
Stable Diffusion 3.5 è un modello text-to-image Multimodal Diffusion Transformer (MMDiT) sviluppato da Stability AI. Migliora la qualità dell'immagine, la tipografia, la comprensione dei prompt e le prestazioni generali. Il modello è disponibile in tre dimensioni, progettate per diverse configurazioni hardware e casi d'uso. Questo modello, eccellente per la generazione di immagini, rimane uno dei modelli di generazione di immagini aperti più utilizzati, supportato da una vasta community di sviluppatori e creatori di contenuti.
Caratteristiche principali:
- Tre dimensioni del modello: Large (8B parametri), Large Turbo e Medium (~2.5B parametri), ciascuno adatto a diverse esigenze di prestazioni e hardware
- Output ad alta risoluzione: Il modello Large supporta la generazione di immagini di alta qualità a una risoluzione di circa 1 megapixel
- Variante a generazione rapida: Large Turbo produce risultati di qualità in un numero ridotto di passaggi
- Supporto per il fine-tuning: Sviluppato per la personalizzazione con una migliore coerenza dei prompt
- Licenza d'uso flessibile: Gratuito per privati e aziende più piccole, con licenze enterprise per organizzazioni più grandi
- ControlNet 1.1
ControlNet è una struttura di rete neurale che controlla i modelli di diffusione aggiungendo condizioni extra. Copia i pesi dei blocchi della rete neurale in una copia bloccata e in una copia addestrabile. Quella addestrabile apprende la tua condizione, mentre quella bloccata preserva il modello originale. Rilasciato dal ricercatore lllyasviel, non genera immagini da solo. Invece, questo miglior modello di immagine si posiziona sopra Stable Diffusion e ti offre un controllo strutturale preciso su ciò che viene generato.
Caratteristiche principali:
- Molteplici tipi di condizionamento: ControlNet supporta il controllo tramite rilevamento dei bordi canny, stima della profondità Midas, rilevamento dei bordi morbidi HED, rilevamento delle linee M-LSD, mappe normali, rilevamento della posa umana OpenPose e segmentazione semantica.
- Controlli componibili: ControlNet supporta la combinazione di più ControlNet contemporaneamente. Tutti i modelli pronti per la produzione sono ampiamente testati con più ControlNet combinate, e il supporto ufficiale Multi-ControlNet è disponibile tramite il plugin A1111.
- Migliore robustezza nella v1.1: ControlNet 1.1 aggiunge una nuova elaborazione dei bordi morbidi, molteplici nuovi preprocessori come Canny, Depth e Inpaint, e rafforza la robustezza complessiva e la qualità dell'immagine del modello rispetto alla versione 1.0.
- Editing basato su istruzioni: ControlNet 1.1 include un modello addestrato sul dataset Instruct Pix2Pix, addestrato sia con prompt di istruzioni che con prompt di descrizione.
- Serie FLUX
La serie FLUX è sviluppata da Black Forest Labs e si concentra sulla generazione di immagini di alta qualità con un forte allineamento ai prompt. Include molteplici modelli progettati sia per la sperimentazione che per i flussi di lavoro di produzione.
Caratteristiche principali:
- Molteplici varianti: Include FLUX.1 [schnell], [dev] e strumenti specializzati per l'editing e il condizionamento.
- Editing di immagini in-context: Consente modifiche alle immagini utilizzando istruzioni testuali senza riaddestramento.
- Strumenti di editing dedicati: Include il supporto per inpainting delle immagini, outpainting e guida strutturale.
- Disponibilità open-weight: Consente la distribuzione locale e la personalizzazione.
- Opzioni di distribuzione flessibili: Supporta API, configurazioni locali e ambienti di test.
- GLM-Image
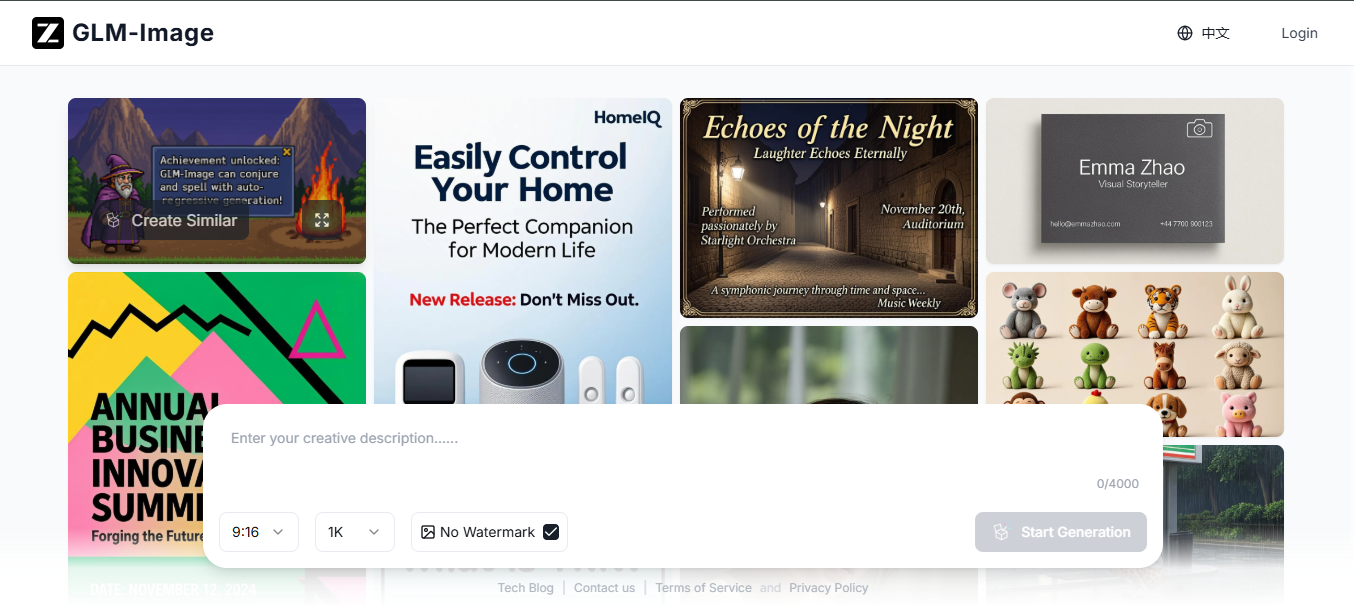
GLM-Image è un modello di generazione di immagini che adotta un'architettura ibrida autoregressiva e con decodificatore a diffusione. Mostra vantaggi nel rendering del testo e in scenari di generazione ad alta intensità di conoscenza, con forti capacità nella generazione di dettagli ad alta fedeltà e a grana fine. Sviluppato da Zhipu AI, è concepito per casi d'uso in cui altri modelli tendono a fallire, in particolare quando le immagini devono includere testo leggibile o layout densi di informazioni.
Caratteristiche chiave:
- Design dell'architettura ibrida: Combina la codifica autoregressiva con la decodifica a diffusione.
- Rendering accurato del testo: Produce testo chiaro e leggibile all'interno delle immagini.
- Supporto per layout complessi: Funziona bene per poster, infografiche e elementi visivi strutturati.
- Generazione e modifica unificate: Gestisce sia compiti text-to-image che image-to-image.
- Perfezionamento post-addestramento: Utilizza l'apprendimento per rinforzo per migliorare i dettagli e l'allineamento.
- Qwen-Image-2512
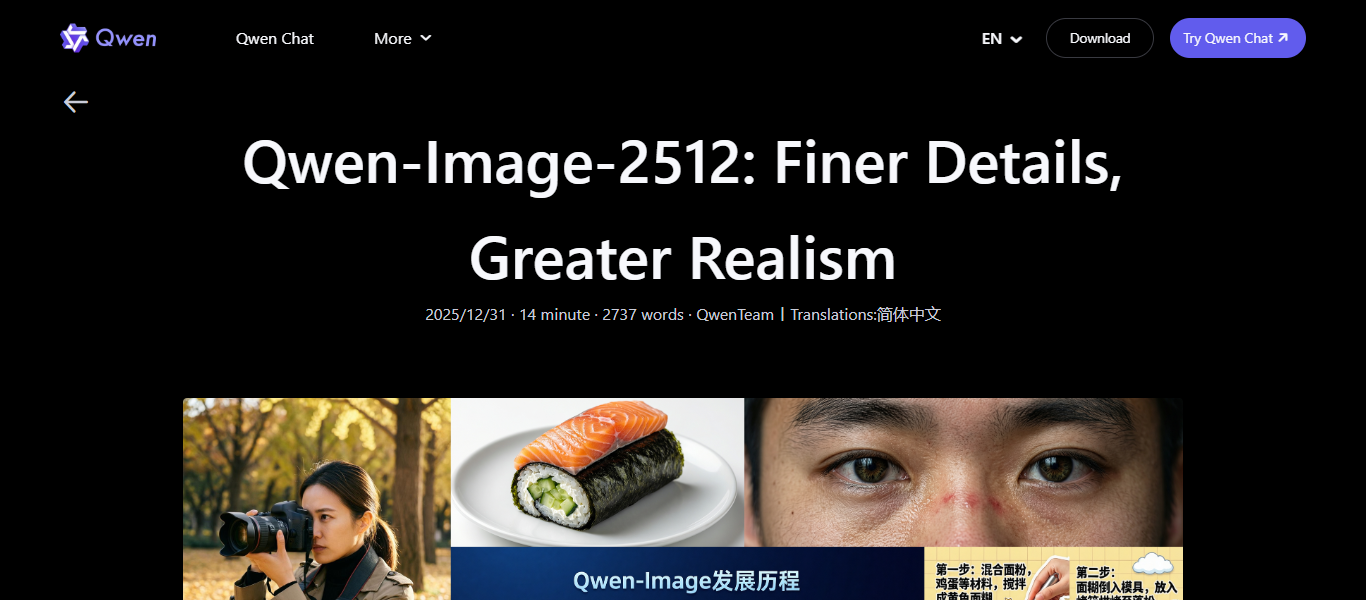
Qwen-Image-2512 è l'aggiornamento di dicembre del modello text-to-image di Qwen-Image miglior modello di generazione di immagini open source, che presenta un realismo umano potenziato, dettagli naturali più fini e una migliore accuratezza e qualità del rendering del testo. Si rivolge direttamente a casi d'uso aziendali e commerciali in cui la qualità, l'affidabilità e la chiarezza delle licenze sono importanti.
Caratteristica chiave:
- Realismo visivo migliorato: Riduce l'aspetto artificiale nelle immagini generate.
- Migliore accuratezza del testo: Produce testo incorporato più chiaro e layout strutturati.
- Generazione di scene dettagliate: Gestisce ambienti e oggetti con maggiore chiarezza.
- Licenza commerciale aperta: Rilasciato sotto licenza Apache 2.0 per l'uso e la modifica gratuiti.
- Accesso completo al modello: Disponibile attraverso piattaforme di modelli aperti per l'implementazione.
- Waifu Diffusion
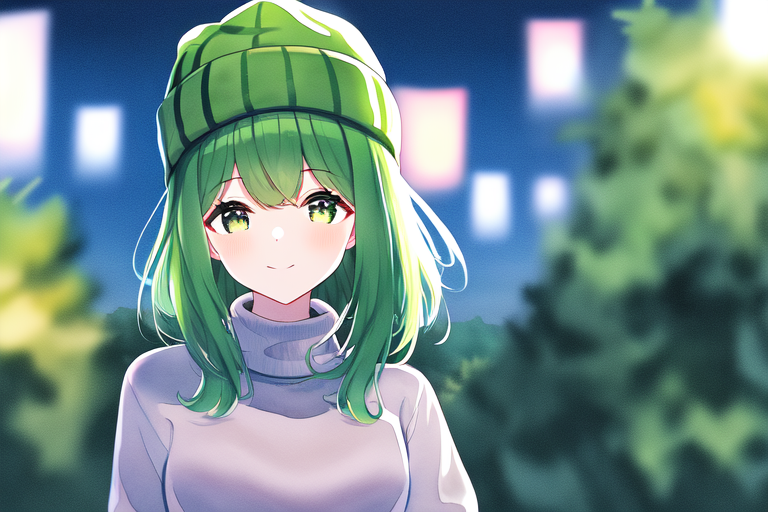
Waifu Diffusion è creato da Hakurei e si concentra sulla generazione di immagini in stile anime. È addestrato specificamente su dataset di anime, il che gli consente di produrre design di personaggi coerenti ed elementi visivi stilizzati. Si basa su Stable Diffusion e si inserisce direttamente nel suo ecosistema, il che lo rende facile da usare per gli artisti che hanno già familiarità con questi strumenti.
Caratteristiche chiave:
- Addestramento focalizzato sugli anime: Il modello è addestrato su un ampio dataset di immagini anime, il che lo aiuta ad apprendere le proporzioni dei personaggi, le espressioni facciali e gli elementi stilistici comuni nell'arte degli anime.
- Qualità costante dei personaggi: Mantiene caratteristiche facciali, acconciature e dettagli dell'abbigliamento stabili tra diversi prompt, il che è utile quando si crea lo stesso personaggio in più scene.
- Controllo dello stile tramite prompt: È possibile guidare l'output utilizzando tag e stili di prompt comunemente usati nelle community di anime.
- Variante basata su SDXL: La versione più recente basata su SDXL migliora la risoluzione, l'illuminazione e i dettagli più fini, mantenendo intatto lo stile anime.
- Licenza ad accesso aperto: Distribuito sotto CreativeML OpenRAIL-M, che consente l'uso e la ridistribuzione a determinate condizioni.
- Ampio supporto della community: È disponibile un gran numero di checkpoint pre-addestrati, LoRA e pacchetti di stili.
- Z-Image-Turbo
Z-Image-Turbo è sviluppato da Tongyi-MAI. Si concentra su velocità ed efficienza, il che lo rende adatto per applicazioni che richiedono una generazione rapida di immagini. Fa parte di una famiglia di modelli compatti progettati per fornire risultati solidi senza fare affidamento su architetture molto grandi.
Caratteristiche chiave:
- Velocità di generazione inferiore al secondo: Z-Image-Turbo dimostra che prestazioni di alto livello sono raggiungibili senza fare affidamento su dimensioni di modello enormi.
- Rendering del testo bilingue: Esegue accuratamente il rendering di testi complessi in cinese e inglese e, nel design di poster, dimostra forti capacità compositive e un buon senso della tipografia.
- Miglioramento del prompt e ragionamento: Un ottimizzatore di prompt integrato dota il modello di capacità di ragionamento.
- Architettura a flusso singolo efficiente: Z-Image-Turbo utilizza un'architettura DiT a flusso singolo scalabile (Scalable Single-Stream DiT) in cui testo, token semantici visivi e token VAE dell'immagine sono concatenati a livello di sequenza in un flusso di input unificato.
Fattori chiave da considerare prima di scegliere un modello
Prima di impegnarsi con uno, ci sono alcune cose pratiche che vale la pena verificare. Ecco cosa guardare e perché è importante.
- Qualità dell'immagine
La qualità dell'immagine si riduce a quanto l'output appaia realistico, dettagliato e accurato rispetto a ciò che è stato richiesto. Alcuni modelli producono risultati realistici, mentre altri tendono a essere più stilizzati. La scelta giusta dipende da ciò di cui il tuo progetto ha effettivamente bisogno.
- Velocità (tempo di inferenza)
Il tempo di inferenza è il tempo impiegato dal modello per produrre una singola immagine. Se stai generando centinaia di immagini in batch o costruendo uno strumento in tempo reale, la velocità conta molto. Un modello più lento che produce ottimi risultati potrebbe non essere sempre pratico.
- Requisiti di VRAM
La VRAM è la memoria che la tua scheda grafica utilizza per eseguire il modello. I modelli più grandi ne richiedono di più, a volte 16 GB o più. Se il tuo hardware non soddisfa questo requisito, il modello semplicemente non funzionerà o funzionerà troppo lentamente per essere utile.
- Capacità di rendering del testo
Alcuni modelli gestiscono bene il testo all'interno delle immagini, altri lo sbagliano completamente. Se i tuoi output includono insegne, poster, etichette o qualsiasi contenuto scritto, questo diventa un fattore critico. Modelli come GLM-Image e Qwen-Image-2512 sono stati creati specificamente con questo obiettivo.
- Licenza (commerciale vs limitata)
Alcuni modelli sono gratuiti per uso personale o di ricerca, ma richiedono una licenza a pagamento per il lavoro commerciale. Altri come Z-Image-Turbo e Qwen-Image-2512 sono completamente aperti sotto Apache 2.0. Controlla sempre la licenza prima di utilizzare un modello in un progetto o prodotto di un cliente.
- Ecosistema e comunità
Una forte comunità significa più tutorial, fine-tune preconfigurati, plugin e correzioni più rapide quando le cose vanno male. Stable Diffusion, ad esempio, ha migliaia di risorse create dalla comunità. Un modello più recente o di nicchia potrebbe essere impressionante ma lasciarti con pochissimo supporto intorno ad esso.
Framia Pro: La tua opzione per lavorare con modelli non aperti
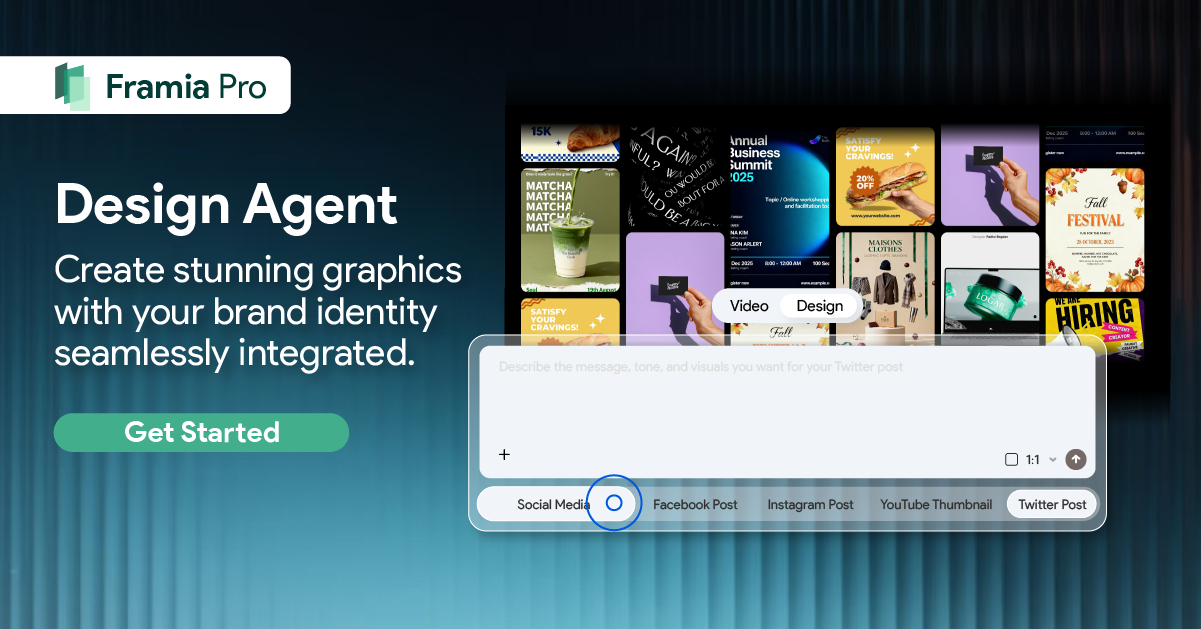
Framia Pro è una piattaforma creativa di IA che ti consente di generare immagini e video utilizzando potenti modelli chiusi di partner come Google Gemini e altri motori avanzati. Riunisce molteplici modelli proprietari in un unico spazio di lavoro in modo da poter creare elementi visivi, modificare i design delle immagini, e produrre contenuti senza cambiare strumenti o gestire configurazioni complesse. Questo rende più facile per i creatori che hanno bisogno di risultati da modelli che non sono open source.
Funzionalità del generatore di immagini Framia Pro
Framia Pro fornisce un unico spazio di lavoro in cui puoi creare e modificare immagini utilizzando diversi modelli di immagine avanzati. Ogni funzionalità è progettata per darti il controllo su come le immagini vengono generate e perfezionate.
- Molteplici modelli di immagine tra cui scegliere
Framia Pro offre l'accesso a Nano Banana Pro, Qwen Image, MidJourney v7, Flux Max e Seedream 4.5 all'interno di un'unica piattaforma. Puoi passare da un modello all'altro in base al tipo di risultato desiderato, come elementi visivi realistici, opere d'arte stilizzate o concept design. Questa configurazione elimina la necessità di utilizzare strumenti separati per ciascun modello e consente il confronto diretto dei risultati.
- Supporta qualsiasi input
La piattaforma accetta diversi tipi di input che includono prompt di testo, immagini di riferimento e input combinati. Puoi descrivere una scena in un linguaggio semplice o caricare un'immagine per guidare il risultato. In questo modo, puoi controllare la composizione, il layout e i dettagli del soggetto senza rigide regole di formattazione.
- Modifica le immagini tramite chat
Framia Pro ti consente di modificare le immagini attraverso un'interfaccia basata sulla chat. Puoi descrivere le modifiche in frasi semplici, come regolare l'illuminazione, rimuovere oggetti o cambiare gli sfondi. Il sistema interpreta le tue istruzioni e applica le modifiche direttamente all'immagine.
- Funziona con molteplici stili
Puoi generare immagini in diversi stili visivi, che spaziano da scene realistiche a illustrazioni, anime e design astratti. Puoi gestire lo stile tramite i prompt e la selezione del modello. Questa funzionalità supporta progetti che richiedono un tono o un tema visivo specifico, come contenuti di marketing, concept art o elementi visivi per i social media.
- Genera e elabora immagini in batch
Framia Pro supporta l'elaborazione in batch, che consente di generare o modificare più immagini in un'unica sessione. Puoi inviare diversi prompt contemporaneamente e ricevere i risultati senza ripetere gli stessi passaggi. Questo è utile per creare variazioni di un design, producendo ampi set di risorse, o per testare rapidamente idee diverse.
Come generare foto con i modelli di immagine su Framia?
Con questi passaggi, puoi generare e perfezionare immagini, opere d'arte e banner utilizzando Nano Banana Pro all'interno di Framia Pro.
Passaggio 1: Inserisci il tuo prompt
- Apri Framia Pro e inizia con un prompt di testo chiaro che descriva la scena che desideri creare.
- Aggiungi dettagli specifici come soggetto, sfondo, colori, atmosfera e oggetti per guidare il risultato verso la tua idea.
- Fai clic sull'opzione "Plan" per impostare il layout della scena, la direzione dell'illuminazione e la composizione generale prima che inizi la generazione.
- Attiva l'opzione "Web" se desideri che il modello utilizzi i dati in tempo reale di Google Search per ottenere risultati di immagini più sensibili al contesto.
Passo 2: Genera l'immagine
- Seleziona qualsiasi modello Pro tra i modelli di immagine disponibili all'interno della piattaforma.
- Carica più immagini per guidare la struttura, lo stile o la coerenza del soggetto.
- Scegli un rapporto d'aspetto adatto al tuo caso d'uso, come quadrato, verticale, orizzontale o output con risoluzione fino a 4K.
- Clicca su "Genera" per creare l'immagine in base al tuo prompt e ai tuoi riferimenti.
Passo 3: Modifica ed esporta sul tuo dispositivo
- Visualizza l'anteprima dell'immagine generata e controlla la composizione, l'illuminazione e il posizionamento degli oggetti
- Usa comandi basati sulla chat per modificare elementi come la sostituzione di oggetti, la regolazione dell'illuminazione o il cambio dello sfondo
- Richiedi modifiche mirate descrivendo i cambiamenti in testo semplice invece di utilizzare strumenti manuali
- Clicca su "Scarica" per esportare l'immagine finale sul tuo dispositivo nella risoluzione e nel formato selezionati
Conclusione
In questo articolo, abbiamo esplorato i 7 migliori modelli di generazione di immagini open source per mostrare come diversi strumenti gestiscono la creazione di immagini, le prestazioni e la flessibilità. Ogni modello offre i propri punti di forza in aree quali la qualità visiva, la velocità, i requisiti hardware e il supporto per vari stili. Framia Pro unisce più modelli in un unico posto per offrirti più opzioni per generare e modificare immagini in un unico flusso di lavoro senza dover passare da uno strumento all'altro.
FAQ
- Qual è il generatore di immagini AI open source più utilizzato
Stable Diffusion rimane uno dei generatori di immagini open source più utilizzati grazie alla sua comunità attiva e all'ampio supporto di strumenti. In Framia Pro, puoi accedere a diversi modelli di immagine in un unico spazio di lavoro, il che elimina la necessità di configurare ambienti separati per ciascun generatore e consente di passare più facilmente da un output all'altro.
- Quali modelli di generazione di immagini producono una qualità visiva superiore
I modelli più recenti, come quelli basati su SDXL e la serie Flux, generano spesso texture più nitide, un'illuminazione migliore e una composizione superiore. Framia Pro ti dà accesso ai modelli Nano Banana Pro, Seedream 4.5, Flux Max, Qwen Image e Midjourney v7 per consentirti di creare immagini all'istante.
- Quale modello funziona meglio per la generazione di immagini su hardware limitato
Le versioni ottimizzate o leggere dei modelli sono più adatte per sistemi con VRAM limitata. Framia Pro gestisce l'accesso ai modelli sul backend, consentendoti di eseguire modelli più pesanti senza dover gestire una configurazione locale, il che riduce la necessità di hardware di fascia alta da parte tua.
- Quali sono considerati i migliori modelli di generazione di immagini open source
Modelli come Stable Diffusion, Waifu Diffusion e configurazioni basate su ControlNet sono comunemente usati per diversi compiti come il realismo, l'arte anime e il controllo strutturale. Framia Pro unisce queste opzioni, consentendoti di selezionare e testare più modelli all'interno di un singolo progetto.
- Quali modelli di immagine sono preferiti per i casi d'uso professionali
I flussi di lavoro professionali richiedono spesso output stabili, risultati coerenti e supporto per la modifica. Framia Pro aggiunge valore offrendo la modifica delle immagini basata sulla chat e la generazione in batch, consentendoti di perfezionare le immagini e produrre più variazioni in un unico posto senza dover cambiare strumento.