Teilen


Wichtigste Erkenntnisse
- Open-Source-Bildgenerierungsmodelle können eine Möglichkeit bieten, Bilder ohne wiederkehrende Abonnements oder separate Modell-Lizenzgebühren zu erstellen und zu bearbeiten.
- Hugging Face hostet fast 109.255 Text-zu-Bild-Modelle, sodass Kreative eine breite Palette an Optionen für Stil, Geschwindigkeit und Hardwareanforderungen haben.
- Stable Diffusion 3.5, FLUX und Qwen-Image-2512 sind führend in den Bereichen allgemeine kreative Arbeit, Prompt-Genauigkeit und kommerzielle Lizenzierung.
- ControlNet 1.1 und Waifu Diffusion decken spezialisierte Anforderungen ab, wie strukturelle Kontrolle und Kunst im Anime-Stil.
- Z-Image-Turbo und GLM-Image zeichnen sich durch Geschwindigkeit und textlastige Bildgenerierung aus, wie beispielsweise für Poster und Infografiken.
- Framia Pro bringt geschlossene Modelle wie Nano Banana Pro, Midjourney v7 und Seedream 4.5 in einem Arbeitsbereich für Kreative zusammen, die Ergebnisse erzielen möchten, ohne lokale Setups verwalten zu müssen.
Open-Source-Bildgenerierungsmodelle haben eine völlig neue Welt für Kreative, Entwickler und Unternehmen eröffnet. Sie können jetzt Text in Bilder verwandeln, Fotos bearbeiten, Videos produzieren und 3D-Objekte erstellen, ohne ein Vermögen für Software auszugeben. Der Bereich ist rasant gewachsen, mit fast 109.255 Text-zu-Bild-Modellen verfügbar sind, die allein auf Hugging Face zu finden sind. Open Source zu nutzen bedeutet keine Abonnements, die volle Kontrolle über Ihre Daten und die Freiheit, Dinge ganz nach Ihren Bedürfnissen anzupassen. Dieser Leitfaden stellt die besten Modelle vor und bietet alles, was Sie für einen erfolgreichen Start benötigen.
Was sind Open-Source-Bildgenerierungsmodelle?
Open-Source-Bildgenerierungsmodelle sind Softwareprogramme, die Bilder aus schriftlichen Beschreibungen erstellen. Sie geben ein, was Sie sehen möchten – sagen wir einen Sonnenuntergang über den Bergen, ein Produkt-Mockup, eine Cartoon-Figur – und das Modell erzeugt es als Bild.
Stellen Sie sich vor, Sie würden einen Künstler engagieren, der sein ganzes Leben lang Millionen von Gemälden, Fotos und Illustrationen studiert hat. Sie beschreiben, was Sie wollen, und er zeichnet es in Sekundenschnelle für Sie. Nur dass dieser Künstler niemals schläft, niemals pro Projekt abrechnet und auf Ihrem eigenen Computer lebt.
Was sie zu „Open Source“ macht, ist, dass der Code öffentlich zugänglich ist. Jeder kann sie kostenlos herunterladen, nutzen, modifizieren oder darauf aufbauen. Dies unterscheidet sich von kostenpflichtigen Tools wie Midjourney oder Adobe Firefly, bei denen Sie für den Zugriff auf die Software bezahlen und keine Kontrolle darüber haben, wie sie im Hintergrund funktioniert.
Diese Modelle werden mit Millionen von Bildern trainiert, wodurch sie lernen, die Beziehung zwischen Worten und visuellen Elementen zu verstehen. Im Laufe der Zeit sind sie so gut geworden, dass sie Ergebnisse in professioneller Qualität liefern, und die besten von ihnen können es mittlerweile mit teuren kommerziellen Optionen aufnehmen.
Warum Open Source gegenüber geschlossenen Bildmodellen
Kostenpflichtige Bildmodelle sind praktisch, bringen aber echte Einschränkungen mit sich. Sie zahlen pro Bild, übergeben Ihre Daten an Server von Drittanbietern und haben kein Mitspracherecht bei der Funktionsweise der Software. Open-Source-Modelle lösen all das. Hier erfahren Sie, warum immer mehr Kreative und Entwickler den Wechsel wagen.
- Volle Kontrolle über die Ergebnisse
Bei geschlossenen Tools entscheidet die Plattform, was Sie generieren können und was nicht. Open-Source-Modelle laufen auf Ihrem eigenen Setup, Sie bestimmen also die Regeln. Sie erhalten genau das, was Sie verlangen, ohne dass Inhaltsfilter oder Plattformbeschränkungen im Weg stehen.
- Möglichkeit zur Feinabstimmung von Modellen
Geschlossene Modelle sind gesperrt und können nicht an Ihre spezifischen Bedürfnisse angepasst werden. Sie können Open-Source-Modelle jedoch mit Ihren eigenen Bildern, Stilen oder Markenrichtlinien weiter trainieren. Das bedeutet, dass die Ergebnisse anfangen, wie Ihre eigenen auszusehen und sich so anzufühlen, und nicht wie die aller anderen, die dasselbe Tool verwenden.
- Keine Kosten pro Bild
Die meisten kommerziellen Tools berechnen Ihnen jedes generierte Bild, was sich schnell summiert. Bei Open-Source-Modellen hingegen lassen Sie alles auf Ihrer eigenen Hardware laufen und generieren so viele Bilder, wie Sie möchten. Die einzigen Kosten sind Strom und die Arbeit der Maschinen.
- Datenschutz und Offline-Nutzung
Wenn Sie ein cloudbasiertes Tool verwenden, werden Ihre Prompts und Bilder über die Server anderer Unternehmen geleitet. Open-Source-Modelle können komplett offline laufen, sodass nichts Ihren Rechner verlässt. Dies ist besonders wichtig für Unternehmen, die mit sensiblen Projekten oder geschützten Inhalten arbeiten.
- Große Community-Unterstützung
Hinter Open-Source-Modellen stehen Tausende von Entwicklern, Forschern und Kreativen auf der ganzen Welt. Sie teilen täglich feinabgestimmte Versionen, Tutorials, Plugins und Fehlerbehebungen. Wenn Sie auf ein Problem stoßen, hat es wahrscheinlich schon jemand in der Community gelöst.
Wie ich diese Modelle getestet und ausgewählt habe
Ich arbeite mit kreativen KI-Tools und war es leid, „Bestenlisten“ zu sehen, die einfach nur Datenblätter von der GitHub-Seite eines Modells kopieren. Bevor ich hier also irgendetwas bewertet habe, habe ich eine Woche damit verbracht, jedes Modell selbst laufen zu lassen, um zu sehen, wie es sich außerhalb eines Marketing-Screenshots schlägt.
Ich betreibe zu Hause einen Ersatz-Desktop mit einer RTX 4090 und 24 GB VRAM, was mein Haupttest-Setup wurde. Für die größeren Modelle, die mehr Speicher benötigten, wie FLUX.2 mit 32B und Qwen-Image-2512, habe ich eine Cloud-GPU stundenweise gemietet, anstatt ihre Leistung nur anhand von Datenblättern zu erraten.
Ich habe ein Set aus 20 Prompts erstellt und dieselbe Liste durch jedes Modell laufen lassen, ohne Rosinenpickerei. Die Prompts deckten fünf Bereiche ab: ein fotorealistisches Porträt, eine Produktaufnahme auf neutralem Hintergrund, ein Poster mit einer Überschrift und Kleingedrucktem, einen Charakter im Anime-Stil und eine detailreiche Szene mit mehreren Objekten. Jedes Modell erhielt drei Versuche pro Prompt, und ich habe das beste der drei Ergebnisse behalten, so wie die meisten Menschen diese Tools tatsächlich nutzen.
Für die Bewertung habe ich jedes Ergebnis auf einer Skala von 1 bis 5 in vier Punkten benotet: wie genau das Ergebnis mit dem Prompt übereinstimmte, wie sauber die feinen Details in voller Auflösung aussahen, wie lange die Generierung auf meiner Hardware dauerte und ob Text im Bild (wenn im Prompt gefordert) tatsächlich lesbar war. Ich habe die Zahlen direkt in einer Tabelle protokolliert, anstatt mich hinterher auf mein Gedächtnis zu verlassen, da nach einem ganzen Nachmittag des Testens einige Modelle ineinander übergingen.
Einige Dinge fielen schnell auf. Z-Image-Turbo schloss seinen Batch von 20 Prompts in insgesamt unter vier Minuten ab, während FLUX 2 mit 32B auf der gemieteten GPU fast 40 Minuten benötigte. GLM-Image und Qwen-Image-2512 waren die einzigen beiden, die kleinen Text auf dem Poster-Prompt durchgehend korrekt und ohne Buchstabensalat darstellten. Waifu Diffusion gewann den Anime-Prompt mit großem Vorsprung, tat sich aber beim fotorealistischen Porträt sehr schwer, was genau dem entspricht, was ich von einem auf einen engen Datensatz trainierten Modell erwarten würde.
Ich habe die sieben unten aufgeführten Modelle basierend auf diesen Tests bewertet, nicht nur nach theoretischen Spezifikationen oder Community-Hype, und ich habe angemerkt, wo der tatsächliche VRAM-Bedarf eines Modells über dem offiziellen Minimum lag, sobald ich eine vollständige Pipeline mit einer anständigen Batch-Größe geladen habe.
Top 7 Open-Source-Bildgenerierungsmodelle
Verschiedene Open-Source-KI-Bildgeneratoren konzentrieren sich auf unterschiedliche Stärken wie Realismus, Geschwindigkeit, Strukturkontrolle oder Textgenauigkeit. Unten sind sieben weit verbreitete Modelle aufgeführt, jedes mit einem klaren Zweck.
| Modell | Architektur | Min. VRAM | Lizenz | Hauptstärken | Bestens geeignet für |
| Stable Diffusion 3.5 | Latente Diffusion (DiT) | 8 GB+ | Kommerziell | Großes Ökosystem, LoRA-Unterstützung, aktive Community | Allgemeine kreative Arbeit, Anfänger, Plugin-basierte Workflows |
| ControlNet 1.1 | Konditioniertes SD-Add-on | 8 GB+ | Apache 2.0 | Posenkontrolle, Tiefenkarten, Kantenführung | Charakterkonsistenz, Architekturlayouts, geführte Generierung |
| FLUX.2 | Flow-Matching-Transformer (4B–32B) | 13 GB (4B) / 24 GB (32B) | BFL Kommerziell | Unterstützung für Multi-Bild-Referenzen und starke Prompt-Treue | Hochwertige visuelle Inhalte, Marken-Assets, Marketing-Inhalte |
| GLM-Image | Hybrid AR + DiT (9B + 7B) | ~16 GB | Forschung / Benutzerdefiniert | Starke Textdarstellung, unterstützt chinesische Typografie, Bearbeiten + Generieren in einem Fluss | Poster, UI-Mockups, zweisprachige Designs, Infografiken |
| Qwen-Image-2512 | Diffusion + Vision-Language-Modell (20B) | ~16 GB | Apache 2.0 | Mehrsprachiger Text, ebenenbasierte RGBA-Bearbeitung, ControlNet-Unterstützung | Kommerzielle Workflows, fortgeschrittene Bearbeitung, mehrsprachige Inhalte |
| Waifu Diffusion | Stable Diffusion feinabgestimmt (Anime-Datensatz) | 6 GB+ | CreativeML OpenRAIL | Anime-Stil, Manga-Visuals, charakterfokussierte Ergebnisse | Spiele, Visual Novels, Kunstwerke im Anime-Stil |
| Z-Image-Turbo | Destillierter Diffusions-Transformer (6B) | 16 GB | Apache 2.0 | Sehr geringe Latenz, unterstützt Englisch + Chinesisch, Batch-Verarbeitung | Echtzeit-Apps, groß angelegte Pipelines, Edge-Bereitstellung |
- Stable Diffusion 3.5
Stable Diffusion 3.5 ist ein Multimodal Diffusion Transformer (MMDiT) Text-zu-Bild-Modell, das von Stability AI entwickelt wurde. Es verbessert die Bildqualität, Typografie, das Prompt-Verständnis und die Gesamtleistung. Das Modell ist in drei Größen erhältlich, die für unterschiedliche Hardware-Setups und Anwendungsfälle konzipiert sind. Dieses beste Modell zur Bildgenerierung bleibt eines der am weitesten verbreiteten offenen Bildgenerierungsmodelle, unterstützt von einer großen Community von Entwicklern und Content Creators.
Hauptmerkmale:
- Drei Modellgrößen: Large (8B Parameter), Large Turbo und Medium (~2.5B Parameter), jeweils geeignet für unterschiedliche Leistungs- und Hardwareanforderungen
- Hochauflösende Ausgabe: Das Large-Modell unterstützt eine hochwertige Bildgenerierung mit einer Auflösung von rund 1 Megapixel
- Schnelle Generierungsvariante: Large Turbo liefert Qualitätsergebnisse in wenigen Schritten
- Unterstützung für Feinabstimmung: Entwickelt für Anpassungen mit verbesserter Prompt-Konsistenz
- Flexible Nutzungslizenz: Kostenlos für Einzelpersonen und kleinere Unternehmen, mit Enterprise-Lizenzierung für größere Organisationen
Meine Erfahrung: 4.5/5
Dies war mein konsistentestes Modell über alle fünf Prompt-Kategorien hinweg. Das Large-Modell traf die Produktaufnahme und den Prompt für die detailreiche Szene fast jedes Mal beim ersten oder zweiten Versuch auf den Punkt, und es stürzte auf meiner 4090 selbst bei voller Auflösung nie ab. Der einzige Punktabzug war die Textdarstellung, bei der das Kleingedruckte auf dem Poster-Prompt immer noch leicht verzerrt herauskam.
- ControlNet 1.1
ControlNet ist eine neuronale Netzwerkstruktur, die Diffusionsmodelle durch das Hinzufügen zusätzlicher Bedingungen steuert. Sie kopiert die Gewichte neuronaler Netzwerkblöcke in eine gesperrte und eine trainierbare Kopie. Die trainierbare Kopie lernt Ihre Bedingung, während die gesperrte das ursprüngliche Modell bewahrt. Veröffentlicht vom Forscher lllyasviel, generiert es keine eigenen Bilder. Stattdessen setzt dieses beste Bildmodell auf Stable Diffusion auf und bietet Ihnen eine präzise strukturelle Kontrolle über das, was generiert wird.
Hauptmerkmale:
- Mehrere Konditionierungsarten: ControlNet unterstützt die Steuerung über Canny-Kantenerkennung, Midas-Tiefenschätzung, HED-Soft-Edge-Erkennung, M-LSD-Linienerkennung, Normal Maps, OpenPose-Menschenposenerkennung und semantische Segmentierung.
- Kombinierbare Steuerungen: ControlNet unterstützt die gleichzeitige Kombination mehrerer ControlNets. Alle produktionsreifen Modelle sind umfassend mit mehreren kombinierten ControlNets getestet, und offizielle Multi-ControlNet-Unterstützung ist über das A1111-Plugin verfügbar.
- Verbesserte Robustheit in v1.1: ControlNet 1.1 fügt eine neue Soft-Edge-Verarbeitung sowie mehrere neue Präprozessoren wie Canny, Depth und Inpaint hinzu und stärkt die allgemeine Robustheit und Bildqualität des Modells im Vergleich zu Version 1.0.
- Anweisungsbasierte Bearbeitung: ControlNet 1.1 enthält ein Modell, das auf dem Instruct Pix2Pix-Datensatz trainiert wurde, sowohl mit Anweisungs-Prompts als auch mit Beschreibungs-Prompts.
Meine Erfahrung: 4/5
Ich habe ControlNet 1.1 nicht anhand derselben fünf Prompts bewertet, da seine offiziellen Gewichte für Stable Diffusion 1.5 und nicht für SD 3.5 ausgelegt sind. Stattdessen habe ich seine Posen- und Tiefensteuerungen unabhängig von den SD 3.5-Durchläufen bewertet. Über zehn Regenerationen hinweg hielt die Posensteuerung die Position des Charakters stabil. Dies deutet darauf hin, dass ControlNet 1.1 in einem kompatiblen Workflow nützliche Orientierung bieten kann, aber diese Ergebnisse sollten nicht als Beweis für eine direkte Kompatibilität mit SD 3.5 gewertet werden.
- FLUX-Serie
Die FLUX-Serie wird von Black Forest Labs entwickelt und konzentriert sich auf hochwertige Bildgenerierung mit starker Prompt-Ausrichtung. Sie umfasst mehrere Modelle, die sowohl für Experimente als auch für Produktions-Workflows konzipiert sind.
Hauptmerkmale:
- Mehrere Varianten: Umfasst FLUX.1 [schnell], [dev] sowie spezialisierte Werkzeuge für Bearbeitung und Konditionierung.
- In-Context-Bildbearbeitung: Ermöglicht Bildänderungen mithilfe von Textanweisungen ohne erneutes Training.
- Spezielle Bearbeitungswerkzeuge: Beinhaltet Unterstützung für Bild-Inpainting, Outpainting und strukturelle Führung.
- Verfügbarkeit offener Gewichte: Ermöglicht lokale Bereitstellung und Anpassung.
- Flexible Bereitstellungsoptionen: Unterstützt APIs, lokale Setups und Testumgebungen.
Meine Erfahrung: 4.5/5
FLUX.2 lieferte mir die schärfsten feinen Details aller von mir getesteten Modelle, insbesondere beim Produktfoto-Prompt, bei dem die Materialtextur tatsächlich beleuchtet und nicht wie aufgemalt aussah. Die 32B-Variante dauerte auf der gemieteten GPU am längsten von allen Modellen in meinem Batch, fast 40 Minuten für den gesamten Durchlauf mit 20 Prompts, also ist es nicht das Modell, zu dem man greifen sollte, wenn man es eilig hat.
- GLM-Image
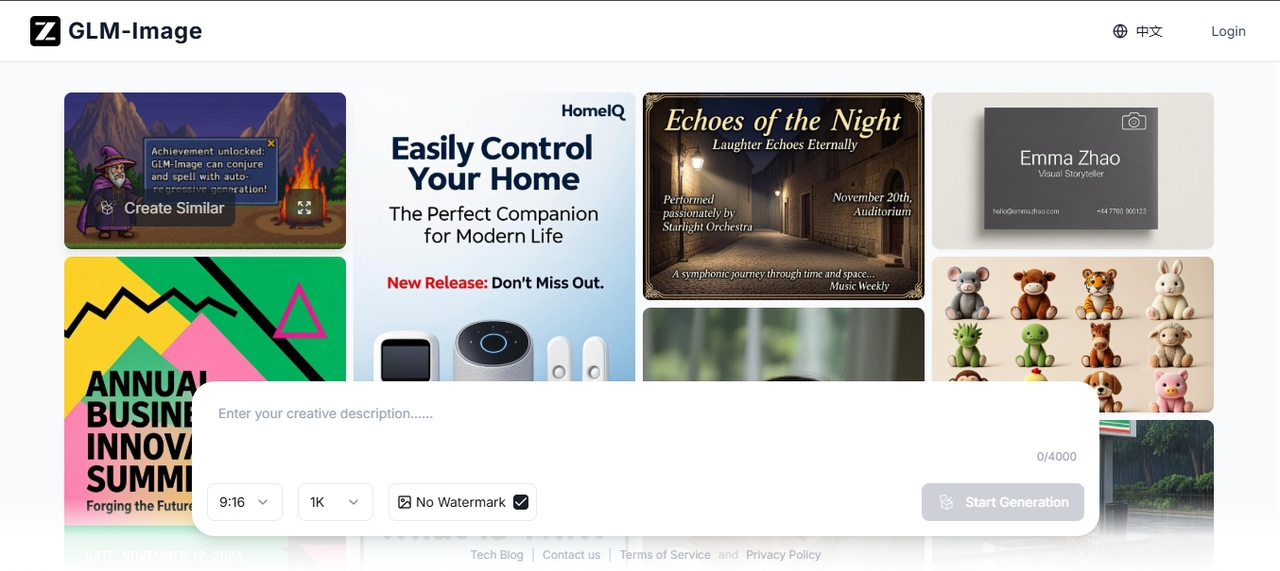
GLM-Image ist ein Bildgenerierungsmodell, das eine hybride autoregressive und Diffusions-Decoder-Architektur nutzt. Es zeigt Vorteile beim Text-Rendering und in wissensintensiven Generierungsszenarien, mit starken Fähigkeiten bei der Generierung von High-Fidelity- und feinkörnigen Details. Entwickelt von Zhipu AI, wurde es für Anwendungsfälle entwickelt, in denen andere Modelle oft an ihre Grenzen stoßen, insbesondere wenn Bilder lesbaren Text oder informationsdichte Layouts enthalten müssen.
Hauptmerkmale:
- Hybrides Architekturdesign: Kombiniert autoregressive Kodierung mit Diffusions-Dekodierung.
- Präzises Text-Rendering: Erzeugt klaren und lesbaren Text in Bildern.
- Unterstützung für komplexe Layouts: Funktioniert gut für Poster, Infografiken und strukturierte visuelle Darstellungen.
- Einheitliche Generierung und Bearbeitung: Bewältigt sowohl Text-to-Image- als auch Image-to-Image-Aufgaben.
- Feinabstimmung nach dem Training: Nutzt Reinforcement Learning, um Details und Ausrichtung zu verbessern.
Meine Erfahrung: 4/5
GLM-Image war eines von nur zwei Modellen, bei denen das Kleingedruckte auf meinem Poster-Prompt vollständig lesbar war, und es kam mit dem Layout im Infografik-Stil zurecht, ohne dass die Buchstaben ineinander verliefen. Die Einrichtung dauerte länger als bei den meisten anderen, da die Lizenzbedingungen vor der kommerziellen Nutzung genauer gelesen werden müssen, was einen Punkt Abzug bei der Benutzerfreundlichkeit und nicht bei der Ausgabequalität bedeutete.
- Qwen-Image-2512
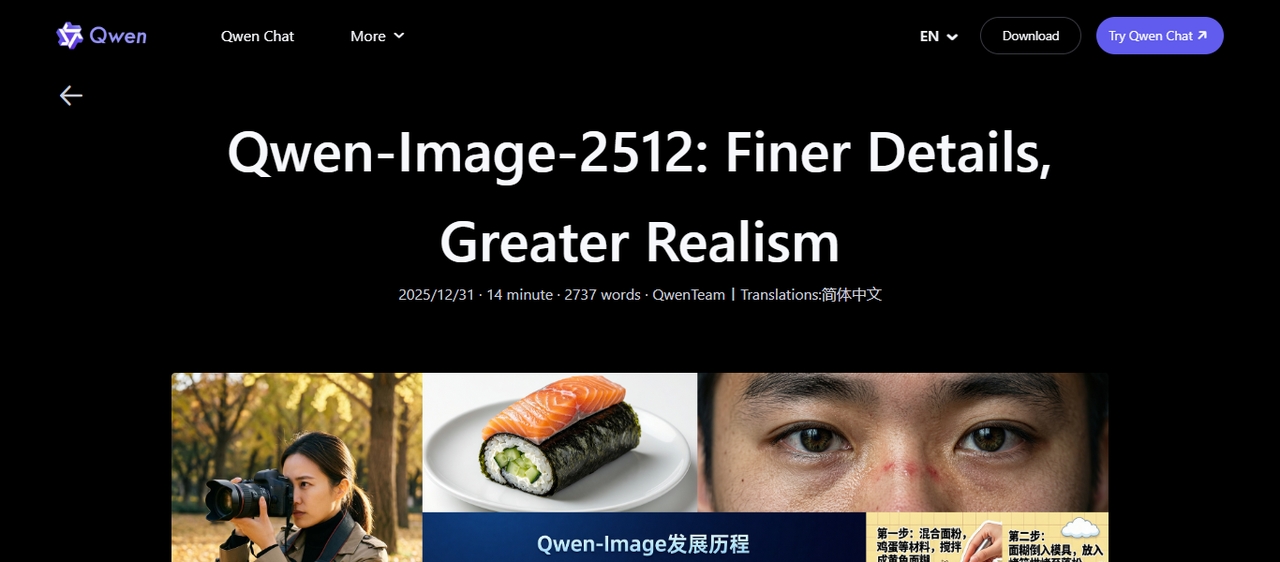
Qwen-Image-2512 ist das Dezember-Update von Qwen-Images Text-zu-Bild-bestem Open-Source-Bildgenerierungsmodell, das sich durch verbesserten menschlichen Realismus, feinere natürliche Details sowie eine verbesserte Genauigkeit und Qualität der Textdarstellung auszeichnet. Es richtet sich gezielt an Unternehmens- und kommerzielle Anwendungsfälle, bei denen es auf Qualität, Zuverlässigkeit und Lizenzklarheit ankommt.
Hauptmerkmal:
- Verbesserter visueller Realismus: Reduziert das künstliche Erscheinungsbild in generierten Bildern.
- Bessere Textgenauigkeit: Erzeugt klareren eingebetteten Text und strukturierte Layouts.
- Detaillierte Szenengenerierung: Verarbeitet Umgebungen und Objekte mit höherer Klarheit.
- Offene kommerzielle Lizenz: Veröffentlicht unter Apache 2.0 zur freien Nutzung und Modifikation.
- Vollständiger Modellzugriff: Verfügbar über offene Modellplattformen für die Bereitstellung.
Meine Erfahrung: 4,5/5
Qwen-Image-2512 war das andere Modell, das kleinen Text auf dem Poster-Prompt korrekt gelesen hat, und seine Porträtergebnisse sahen von allen am natürlichsten aus, weniger wachsartig als das, was ich von einigen der anderen Diffusionsmodelle erhalten habe. In Kombination mit der Apache 2.0-Lizenz ist dies das Modell, zu dem ich bei einem Kundenprojekt, bei dem ich schnell und ohne Lizenzgespräche vorankommen muss, zuerst greifen würde.
- Waifu Diffusion
Waifu Diffusion wurde von Hakurei entwickelt und konzentriert sich auf die Generierung von Bildern im Anime-Stil. Es wurde speziell auf Anime-Datensätzen trainiert, was es ihm ermöglicht, konsistente Charakterdesigns und stilisierte Grafiken zu erstellen. Es baut auf Stable Diffusion auf und fügt sich direkt in dessen Ökosystem ein, was die Nutzung für Künstler, die bereits mit diesen Tools vertraut sind, einfach macht.
Hauptmerkmale:
- Auf Anime ausgerichtetes Training: Das Modell ist auf einem großen Datensatz von Anime-Bildern trainiert, was ihm hilft, Charakterproportionen, Gesichtsausdrücke und stilistische Elemente zu lernen, die in der Anime-Kunst üblich sind.
- Konsistente Charakterqualität: Es behält stabile Gesichtszüge, Frisuren und Kleidungsdetails über verschiedene Prompts hinweg bei, was nützlich ist, wenn derselbe Charakter in mehreren Szenen erstellt wird.
- Stilsteuerung durch Prompts: Sie können die Ausgabe mithilfe von Tags und Prompt-Stilen steuern, die in Anime-Communitys üblich sind.
- SDXL-basierte Variante: Die neuere, auf SDXL basierende Version verbessert Auflösung, Beleuchtung und feinere Details, während der Anime-Stil erhalten bleibt.
- Open-Access-Lizenz: Verteilt unter CreativeML OpenRAIL-M, was die Nutzung und Weiterverbreitung unter bestimmten Bedingungen erlaubt.
- Breite Community-Unterstützung: Eine große Anzahl von vorab trainierten Checkpoints, LoRAs und Stil-Paketen ist verfügbar.
Meine Erfahrung: 3,5/5
Waifu Diffusion hat den Anime-Prompt eindeutig gewonnen, da das Gesicht und das Outfit des Charakters bei allen drei von mir durchgeführten Versuchen konsistent blieben. Aber als ich es auf meinen fotorealistischen Porträt-Prompt ansetzte, kam das Ergebnis immer noch mit einem anime-ähnlichen Look heraus, egal wie ich es formulierte, was genau das ist, was man von einem Modell erwartet, das auf einem so spezialisierten Datensatz trainiert wurde. Großartig in einer Aufgabe, aber nicht für den Rest gebaut.
- Z-Image-Turbo
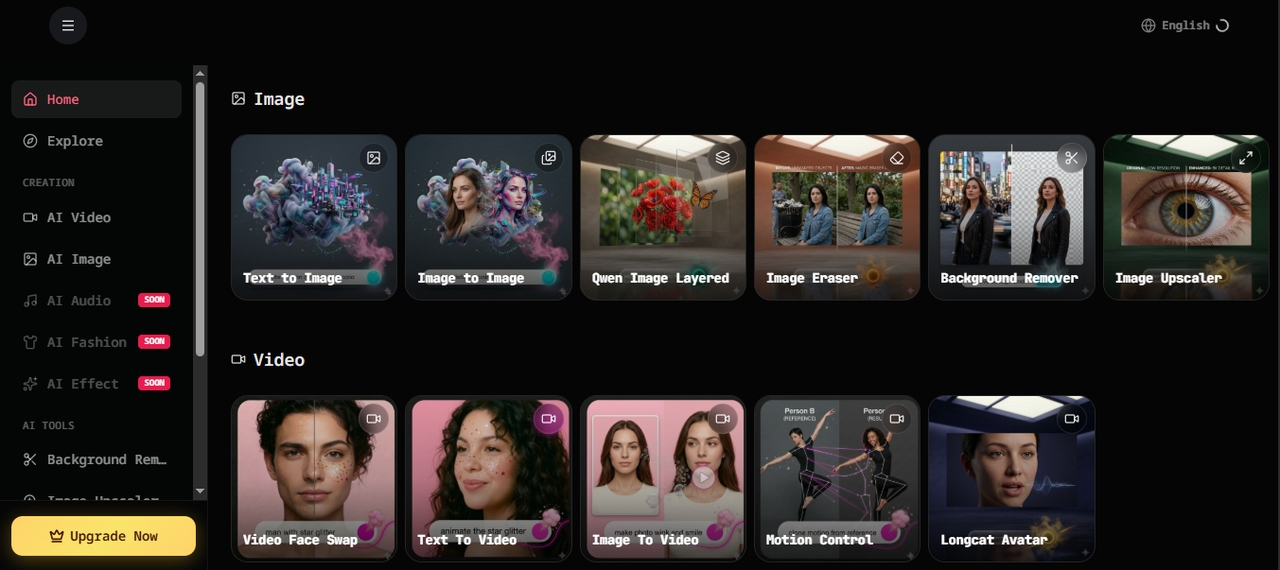
Z-Image-Turbo wird von Tongyi-MAI entwickelt. Es konzentriert sich auf Geschwindigkeit und Effizienz, was es für Anwendungen geeignet macht, die eine schnelle Bildgenerierung erfordern. Es ist Teil einer kompakten Modellfamilie, die darauf ausgelegt ist, starke Ergebnisse zu liefern, ohne auf sehr große Architekturen angewiesen zu sein.
Hauptmerkmale:
- Generierungsgeschwindigkeit im Subsekundenbereich: Z-Image-Turbo beweist, dass Spitzenleistungen erzielt werden können, ohne auf enorme Modellgrößen angewiesen zu sein.
- Zweisprachige Textdarstellung: Rendert komplexen chinesischen und englischen Text präzise und zeigt im Plakatdesign starke kompositorische Fähigkeiten sowie ein gutes Gespür für Typografie.
- Prompt-Verbesserung und logisches Denken: Ein integrierter Prompt-Enhancer verleiht dem Modell Fähigkeiten zum logischen Denken.
- Effiziente Single-Stream-Architektur: Z-Image-Turbo verwendet eine Scalable Single-Stream DiT-Architektur, bei der Text, visuelle semantische Token und Bild-VAE-Token auf Sequenzebene zu einem einheitlichen Eingabestream verkettet werden.
Meine Erfahrung: 4/5
Z-Image-Turbo hat meinen gesamten Batch von 20 Prompts in weniger als vier Minuten abgearbeitet, mit Abstand am schnellsten von den sieben. Die zweisprachige Textdarstellung hielt sowohl bei der englischen als auch bei der chinesischen Version meines Poster-Prompts gut stand. Feine Details bei dem Prompt für eine belebte Szene lagen einen Schritt hinter Stable Diffusion 3.5 und FLUX.2 zurück, was angesichts der viel geringeren Größe des Modells nachvollziehbar ist.
Wichtige Faktoren, die vor der Auswahl eines Modells zu berücksichtigen sind
Bevor Sie sich für eines entscheiden, sollten Sie einige praktische Dinge überprüfen. Hier ist, worauf Sie achten sollten und warum es wichtig ist.
- Bildqualität
Die Bildqualität hängt davon ab, wie realistisch, detailliert und genau das Ergebnis im Vergleich zu Ihren Anforderungen aussieht. Einige Modelle liefern lebensechte Ergebnisse, während andere eher stilisiert sind. Die richtige Wahl hängt davon ab, was Ihr Projekt tatsächlich benötigt.
- Geschwindigkeit (Inferenzzeit)
Die Inferenzzeit ist die Zeit, die das Modell benötigt, um ein Bild zu erstellen. Wenn Sie Hunderte von Bildern in einem Batch generieren oder ein Echtzeit-Tool entwickeln, spielt die Geschwindigkeit eine große Rolle. Ein langsameres Modell, das hervorragende Ergebnisse liefert, ist möglicherweise nicht immer praktisch.
- VRAM-Anforderungen
VRAM ist der Speicher, den Ihre Grafikkarte zur Ausführung des Modells verwendet. Größere Modelle benötigen mehr davon, manchmal 16 GB oder mehr. Wenn Ihre Hardware die Anforderungen nicht erfüllt, läuft das Modell schlichtweg nicht oder zu langsam, um nützlich zu sein.
- Textdarstellungsfähigkeit
Einige Modelle können Text in Bildern gut darstellen, andere liegen völlig daneben. Wenn Ihre Ergebnisse Schilder, Poster, Etiketten oder andere schriftliche Inhalte enthalten, wird dies zu einem entscheidenden Faktor. Modelle wie GLM-Image und Qwen-Image-2512 wurden speziell im Hinblick darauf entwickelt.
- Lizenzierung (kommerziell vs. eingeschränkt)
Einige Modelle sind für die persönliche Nutzung oder Forschungszwecke kostenlos, erfordern jedoch eine kostenpflichtige Lizenz für kommerzielle Arbeiten. Andere wie Z-Image-Turbo und Qwen-Image-2512 sind unter Apache 2.0 vollständig quelloffen. Überprüfen Sie immer die Lizenz, bevor Sie ein Modell in einem Kundenprojekt oder -produkt verwenden.
- Ökosystem und Community
Eine starke Community bedeutet mehr Tutorials, vorgefertigte Fine-Tunes, Plugins und schnellere Fehlerbehebungen, wenn etwas schiefgeht. Stable Diffusion verfügt beispielsweise über Tausende von der Community erstellte Ressourcen. Ein neueres oder nischigeres Modell mag zwar beeindruckend sein, bietet Ihnen jedoch möglicherweise nur sehr wenig Support.
Wägt man diese sechs Faktoren ab, sieht Open-Source plötzlich nicht mehr ganz so kostenlos aus. Ein Modell, das bei Bildqualität und Textdarstellung glänzt, benötigt möglicherweise mehr als 16 GB VRAM, die Sie nicht haben, sowie viel Zeit für das Debuggen eines lokalen Setups, bevor es überhaupt etwas Brauchbares produziert. Wenn Sie eigentlich diese Spitzenleistung wünschen, ohne selbst ein Modell zu hosten, oder Zugriff auf geschlossene Modelle suchen, an die diese Open-Source-Optionen überhaupt nicht herankommen, kommt Framia Pro ins Spiel.
Framia Pro: Ihre Option für die Arbeit mit nicht-offenen Modellen
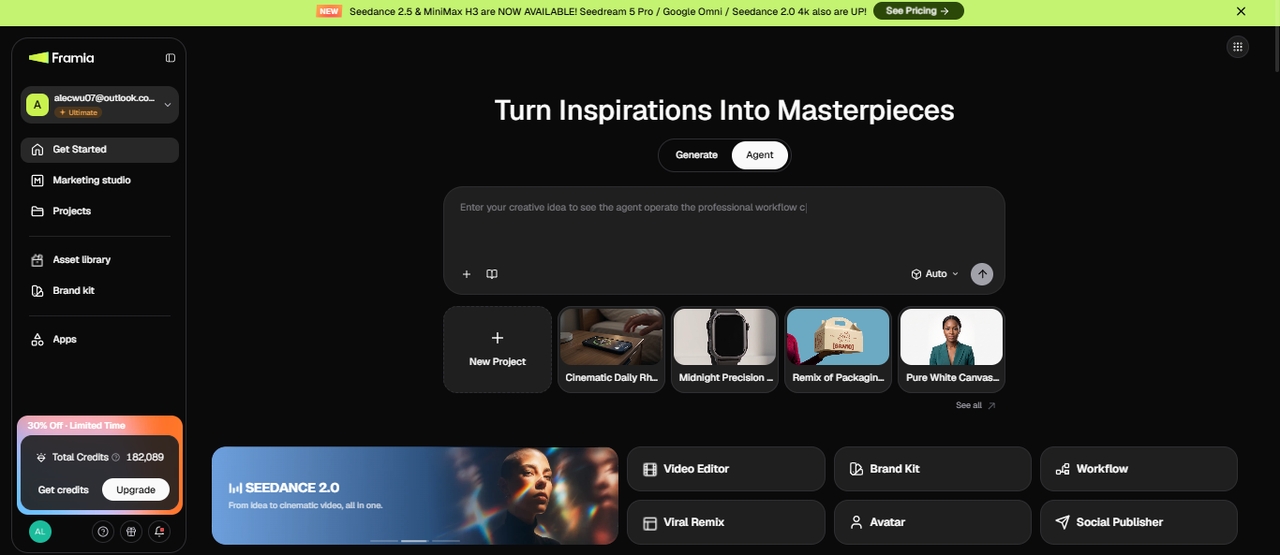
Framia Pro ist eine kreative KI-Plattform, die um eine Workflow-Arbeitsfläche herum aufgebaut ist, auf der Sie geschlossene Modelle von Partnern wie Seedream 5.0 Pro, Nano Banana Pro, Kling, Seedance 2.5 und Veo 3.1 in einem einzigen Arbeitsbereich verbinden, anstatt sich für eine einzige Engine zu entscheiden und mit deren Einschränkungen zu leben. Sie beschreiben, was Sie möchten, und Framia Pro kümmert sich um das Skript, die visuellen Elemente und die Zusammenstellung über verbundene Knotenpunkte hinweg, die Sie an jedem Punkt des Prozesses bearbeiten können. Es vereint Bildgenerierung, Video und ein vollständiges Marketing Studio an einem Ort, sodass Kreative, die Ergebnisse von Modellen benötigen, die nicht Open Source sind, nicht mehrere Abonnements abschließen müssen, um ans Ziel zu gelangen.
Ich habe einige Stunden in Framia Pro zusammen mit den sieben oben genannten Modellen verbracht, um zu sehen, wie sich die Erfahrung mit geschlossenen Modellen tatsächlich im Vergleich schlägt, und ich habe unten notiert, wo es passt und wo nicht.
Funktionen des Framia Pro Bildgenerators
Framia Pro bietet einen einzigen Arbeitsbereich, in dem Sie Bilder mit verschiedenen besten Bildgenerierungsmodellen erstellen und bearbeiten können. Jede Funktion ist so konzipiert, dass Sie die Kontrolle darüber haben, wie Bilder generiert und verfeinert werden.
- Workflow-Arbeitsfläche, die jeden Schritt verbindet
Die Arbeitsfläche von Framia Pro stellt Ihr Projekt als verbundene Knotenpunkte dar – Skript, Bild, Video und Audio –, die Sie im Verlauf des Projekts verschieben, hinzufügen oder entfernen können. Anstatt ein einzelnes Bild zu generieren und für das nächste Asset von vorne zu beginnen, erstellen Sie eine vollständige Sequenz und führen nur den Knotenpunkt erneut aus, der eine Änderung erfordert.
- Mehrere KI-Modelle in einem Arbeitsbereich
Framia Pro bietet Ihnen Zugriff auf Nano Banana Pro, Qwen Image, Midjourney v7, Flux Max und Seedream 4.5 für Bilder sowie Kling, Veo 3.1 und Seedance für Videos – alles auf einer einzigen Plattform. Sie können die Modelle je nach gewünschtem Ergebnis wechseln und die Ausgaben nebeneinander vergleichen, ohne separate Tools öffnen zu müssen.
- Brand Kit für konsistente visuelle Inhalte
Der Brand Kit-Generator von Framia Pro erstellt Logos, Farbpaletten, Typografie und Social-Media-Vorlagen aus einem einzigen Briefing und sorgt dafür, dass jedes danach generierte Bild an diese Markenrichtlinien gebunden bleibt. Dies ist besonders wichtig für Marketingteams und Unternehmen, die ein hohes Volumen an visuellen Inhalten für Kampagnen produzieren.
- Angesagte Vorlagen zum Remixen
Framia Pro bietet eine Galerie mit angesagten, viralen Vorlagen, die Sie auswählen und mit Ihrem eigenen Prompt remixen können, anstatt ein Konzept auf einer leeren Arbeitsfläche zu erstellen. Dies ist eher auf schnelllebige Social-Media-Inhalte ausgerichtet als auf die Stile, auf die sich dieser Leitfaden konzentriert, aber es ist gut zu wissen, wenn Sie auch Videos produzieren.
- Bilder durch einfache Chat-Befehle bearbeiten
Sie können eine Änderung in natürlicher Sprache beschreiben, wie das Austauschen eines Hintergrunds oder das Ändern der Größe eines Logos, und Framia Pro wendet diese direkt auf das Bild an. Diese chatbasierte Bearbeitung erspart manuelles Maskieren oder das erneute Generieren des gesamten Bildes für eine kleine Korrektur.
Fazit
In diesem Artikel haben wir die 7 besten Open-Source-Bildgenerierungsmodelle untersucht und gezeigt, wie verschiedene Tools die Bildgenerierung, Leistung und Flexibilität handhaben. Jedes Modell bietet eigene Stärken in Bereichen wie visueller Qualität, Geschwindigkeit, Hardwareanforderungen und Unterstützung für verschiedene Stile. Framia Pro führt mehrere Modelle an einem Ort zusammen, um Ihnen mehr Optionen für das Generieren und Bearbeiten von Bildern in einem einzigen Workflow zu bieten, ohne zwischen separaten Tools wechseln zu müssen. Probieren Sie es jetzt aus!
FAQs
Welcher Open-Source-KI-Bildgenerator wird am häufigsten verwendet?
Stable Diffusion bleibt aufgrund seiner aktiven Community und der breiten Tool-Unterstützung einer der am häufigsten verwendeten Open-Source-Bildgeneratoren. In Framia Pro können Sie auf verschiedene Bildmodelle in einem einzigen Arbeitsbereich zugreifen. Dadurch entfällt die Notwendigkeit, separate Umgebungen für jeden Generator einzurichten, und es wird ein einfacherer Wechsel zwischen den Ausgaben ermöglicht.
Welche Bildgenerierungsmodelle liefern eine höhere visuelle Qualität?
Neuere Modelle, wie die auf SDXL basierenden und die Flux-Serie, generieren oft klarere Texturen, eine verbesserte Beleuchtung und eine bessere Komposition. Framia Pro bietet Ihnen Zugriff auf Nano Banana Pro, Seedream 4.5, Flux Max, Qwen Image und Midjourney v7 -Modelle, mit denen Sie Bilder sofort erstellen können.
Welches Modell eignet sich am besten für die Bildgenerierung auf eingeschränkter Hardware?
Optimierte oder leichtgewichtige Versionen von Modellen eignen sich besser für Systeme mit begrenztem VRAM. Framia Pro übernimmt den Modellzugriff im Backend, sodass Sie schwerere Modelle ausführen können, ohne ein lokales Setup verwalten zu müssen, was den Bedarf an High-End-Hardware auf Ihrer Seite reduziert.
Welche gelten als die besten Open-Source-Bildgenerierungsmodelle?
Modelle wie Stable Diffusion, Waifu Diffusion und ControlNet-basierte Setups werden häufig für verschiedene Aufgaben wie Realismus, Anime-Kunst, und strukturelle Kontrolle verwendet. Framia Pro führt diese Optionen zusammen, sodass Sie mehrere Modelle innerhalb eines einzigen Projekts auswählen und testen können.
Welche Bildmodelle werden für professionelle Anwendungsfälle bevorzugt?
Professionelle Workflows erfordern oft stabile Ausgaben, konsistente Ergebnisse und Unterstützung bei der Bearbeitung. Framia Pro bietet einen Mehrwert durch chatbasierte Bildbearbeitung und Batch-Generierung, wodurch Sie Bilder verfeinern und mehrere Variationen an einem Ort erstellen können, ohne die Tools wechseln zu müssen.
Welches ist das beste kostenlose Bildgenerierungsmodell?
Stable Diffusion 3.5 ist die vollständigste kostenlose Option, da die Varianten Medium und Large Turbo auf handelsüblicher Hardware laufen und die Lizenz die kommerzielle Nutzung für kleinere Unternehmen abdeckt. Z-Image-Turbo und Qwen-Image-2512 are also fully free under Apache 2.0, with faster output but a smaller community built around them so far.
Gibt es einen lokalen Open-Source-KI-Bildgenerator?
Ja. Stable Diffusion 3.5, ControlNet 1.1, FLUX.2, Waifu Diffusion und Z-Image-Turbo laufen nach dem Herunterladen alle lokal auf Ihrer eigenen Hardware, ohne dass ein Cloud-Konto oder ein Abonnement erforderlich ist. Die Hauptanforderung ist ausreichend VRAM, im Allgemeinen 6 GB bis 24 GB, je nach gewähltem Modell.
Kann ich Open-Source-Bildmodelle für kommerzielle Projekte verwenden?
Ja, aber das hängt von der Lizenz des Modells ab. Einige Modelle erlauben die kommerzielle Nutzung, während andere Einschränkungen haben. Überprüfen Sie immer die Lizenzbedingungen, bevor Sie generierte Bilder für Kundenarbeiten, Produkte oder bezahlte Kampagnen verwenden.