I modelli di generazione video AI si stanno muovendo rapidamente e continuano a comparire nuovi strumenti con risultati migliori, clip più lunghe e maggiore controllo. Scegliere quello giusto non è semplice quando ogni modello promette qualcosa di diverso e le opzioni continuano a crescere. Questa guida ti accompagna attraverso i migliori modelli AI di video che dovresti conoscere in questo momento. Vedrai cosa fa bene ciascuno di essi, dove pecca e quale si adatta alle tue esigenze di contenuto. Leggi fino in fondo per trovare un modello che si adatti al tuo flusso di lavoro e ti faccia risparmiare tempo nella creazione di video.
Cosa sono i modelli di generazione video AI?
I modelli di generazione video AI sono sistemi di intelligenza artificiale che creano contenuti video automaticamente a partire da un determinato input (più comunemente una descrizione testuale, un'immagine o una clip video esistente). Questi modelli sintetizzano contenuti visivi completamente nuovi da zero esclusivamente attraverso il calcolo. Raggiungono questo obiettivo addestrandosi su enormi dataset di milioni di clip video e delle loro descrizioni, in modo da poter successivamente generare nuove scene che seguono quelle stesse regole.
Il processo di generazione vero e proprio funziona attraverso una tecnica chiamata diffusione. Il modello inizia con un rumore casuale puro e lo perfeziona nel corso di decine di passaggi, scolpendo gradualmente quel caos in un video. Questo funziona perché durante l'addestramento il modello ha imparato a invertire un processo di distruzione: gli sono stati mostrati video reali progressivamente corrotti in rumore, e ha imparato ad annullare ogni passaggio. Al momento della generazione, il tuo prompt di testo funge da guida durante tutto questo processo, orientando ogni passaggio di perfezionamento in modo che il risultato finale rifletta ciò che hai descritto.
La parte più difficile, tuttavia, non è generare un singolo fotogramma. È mantenere centinaia di fotogrammi coerenti tra loro nel tempo. I modelli di generazione video gestiscono questo aspetto elaborando intere sequenze di fotogrammi contemporaneamente, il che consente a ciascun fotogramma di fare riferimento agli altri durante la generazione. Questo è ciò che rende la generazione video molto più esigente dal punto di vista computazionale rispetto alla generazione di immagini.
Quali sono i diversi tipi di modelli AI di video?
Gli strumenti video AI non funzionano tutti allo stesso modo. Ogni tipo segue un percorso diverso per trasformare la tua idea in un video, e conoscere la differenza ti evita di scegliere lo strumento sbagliato.
Modelli AI text-to-video
Inizi con le parole e il modello le trasforma in una scena in movimento. Scrivi una breve descrizione di ciò che desideri e il sistema crea gli elementi visivi da zero.
Questo tipo funziona bene quando hai un'idea in testa ma non hai elementi visivi pronti. Puoi descrivere un prodotto, una breve storia o persino una scena per un annuncio pubblicitario e ottenere un video in cambio. Sembra quasi di scrivere una sceneggiatura e vederla prendere vita in pochi minuti.
Modelli image-to-video
Qui hai già un'immagine e vuoi farla prendere vita. Il modello aggiunge movimento, movimenti di macchina o piccoli cambiamenti che trasformano una immagine statica in una breve clip.
Questo approccio si adatta a demo di prodotti e post sui social in cui desideri un movimento rapido senza dover creare tutto da zero.
Modelli video multimodali
Questi modelli funzionano con più di un tipo di input contemporaneamente. Puoi combinare testo, immagini, audio e persino clip video esistenti per guidare il risultato finale.
Questo ti offre un maggiore controllo sul risultato finale del video. Non ti limiti a descrivere una scena, la modelli con molteplici input. Questo controllo è utile quando desideri dettagli specifici, una narrazione più fluida o un video che segua una direzione chiara.
I 5 migliori modelli closed-source di generazione video AI nel 2026
I modelli AI text-to-video hanno raggiunto un punto in cui è possibile creare annunci pubblicitari, cortometraggi e clip di prodotti in pochi minuti anziché in giorni. Tuttavia, il divario tra i modelli è reale. Alcuni si concentrano sulla qualità cinematografica, altri sulla velocità o sul controllo dell'editing e alcuni cercano di bilanciare tutto.
Di seguito sono riportati i migliori modelli closed-source che dovresti conoscere in questo momento.
Veo 3.1
Veo 3.1 è il modello di punta di Google per la generazione video ed è uno degli strumenti tecnicamente più avanzati disponibili in questo momento. Crea video con audio perfettamente sincronizzato che include dialoghi dei personaggi, effetti sonori e audio ambientale, il tutto generato da un singolo prompt. È diventato ampiamente noto come il motore alla base di video virali sulle piattaforme social dopo il suo lancio nell'ottobre 2025. La sua integrazione con il più ampio ecosistema di Google lo rende una scelta naturale per i team che già lavorano all'interno di Google Workspace.
Caratteristiche
- Audio nativo: dialoghi, SFX e suono ambientale in un unico passaggio.
- Risoluzione 4K: fino a un output in ultra-alta definizione.
- Multi-riferimento: supporta fino a 3 immagini di riferimento.
- Lunga durata: produce output fino a un minuto intero.
- Dialogo nel prompt: scrivi i dialoghi dei personaggi direttamente nel tuo prompt.
Pro
- Qualità audio nativa senza eguali.
- Eccellente realismo e precisione dell'illuminazione.
- Profonda integrazione con l'ecosistema Google.
- Forte precisione nell'aderenza al prompt.
Contro
- Video con filigrana nei piani inferiori.
- Meno flessibile per contenuti stilizzati o non realistici.
Runway Gen-4.5
Runway è uno dei nomi più affermati nei modelli video di IA generativa. Ha lanciato Gen-4.5 alla fine del 2025 con importanti aggiornamenti nella qualità video e nel sequenziamento multi-shot. La piattaforma ora include un'interfaccia di chat in cui è possibile perfezionare i video attraverso la conversazione invece di riscrivere ripetutamente i prompt. È ampiamente considerata lo strumento di riferimento per la coerenza cinematografica e il controllo creativo.
Funzionalità
- Pennelli di movimento: dipingi esattamente quali parti di una scena devono muoversi.
- Multi-shot: unisci più clip in un'unica sequenza coesa.
- Act-one: cattura delle espressioni facciali e del movimento.
- Modifica via chat: perfeziona i risultati attraverso una conversazione naturale.
- Output 4K: esportazione ad altissima risoluzione.
Pro
- La migliore coerenza di scene e personaggi della categoria.
- Potenti controlli creativi per i professionisti.
- Forte community ed ecosistema.
Contro
- Costoso nei livelli più alti.
- Più lento di alcuni concorrenti per contenuti social rapidi.
- Curva di apprendimento più ripida per i principianti.
Seedance 2.0
Seedance 2.0 è l'ultimo modello video AI di ByteDance, video model, rilasciato all'inizio del 2026, che ha rapidamente attirato l'attenzione per i suoi video realistici e di qualità cinematografica. Molte persone nell'industria cinematografica hanno persino iniziato a discutere di quanto si avvicini alla reale qualità di produzione. Funziona con testo, immagini, audio e video contemporaneamente, offrendo un maggiore controllo sull'aspetto e sul suono del video finale. È possibile accedervi tramite Framia Pro, CapCut, Dreamina e Pippit, anche se non è ancora disponibile in tutte le regioni.
Caratteristiche
- Input multimodale: combina testo, immagini, video e audio in un unico passaggio.
- Audio nativo: dialoghi, SFX e suoni ambientali generati simultaneamente.
- Sistema di riferimento @: tagga personaggi, stili o suoni specifici sugli asset caricati.
- Multi-shot: inquadrature multiple con tagli e transizioni naturali all'interno di una singola generazione.
- Motore fisico: collisioni realistiche, movimento dei tessuti e sequenze ad alta azione.
- Output 2K: risoluzione nativa fino a 2048x1080.
Pro
- Il sistema di input multimodale più capace disponibile.
- Una clip di 10 secondi in 2K viene renderizzata in circa 30 secondi nei piani a pagamento.
- Eccezionale coerenza dei personaggi e delle scene tra i fotogrammi.
- Ottimo piano gratuito tramite Dreamina per la valutazione.
Contro
- Il rilascio è ancora limitato a mercati selezionati.
- Tempo di configurazione più lungo.
Kling 3.0
Kling 3.0 è stato lanciato il 4 febbraio 2026 e in pochi giorni è stato definito il salto più importante dell'anno nella generazione di video AI. È basato sull'architettura Omni One, che utilizza la 3D Spacetime Joint Attention e il ragionamento Chain-of-Thought per generare video di livello cinematografico e fisicamente accurati, in cui personaggi e oggetti si muovono con gravità, equilibrio, deformazione e inerzia reali. Il modello supporta un input multimodale completo che spazia tra testo, immagini, audio e video, e può generare audio nativo in più lingue tra cui inglese, cinese, giapponese, coreano e spagnolo, con un controllo preciso sul dialogo dei personaggi e sull'ordine di parola.
Caratteristiche
- Fisica Omni One: simulazione reale di gravità, collisione e inerzia.
- Audio nativo: voiceover, lip-sync, SFX e musica.
- Storyboard multi-inquadratura: fino a 6 inquadrature con controllo della telecamera a livello di regista.
- Modalità bozza: genera fino a 20 volte più velocemente per una prototipazione rapida.
- Output 4K/60fps: con esportazione HDR a 16 bit ed EXR.
- Editor 7-in-1: aggiunta di oggetti, sostituzione dello sfondo, trasferimento di stile in un unico strumento.
Pro
- La fisica e il movimento umano più realistici disponibili.
- Audio multilingue nativo con controllo di dialetti e accenti.
- Ingresso conveniente a 7,99 $/mese con un solido piano gratuito.
- Esporta direttamente nelle pipeline VFX professionali (Nuke, After Effects, DaVinci).
Contro
- Un rendering multi-inquadratura di 15 secondi può richiedere più di 5 minuti.
- Output 4K attualmente limitato ai piani di livello superiore.
- I periodi di alta richiesta prolungano le code di rendering.
Hailuo 02
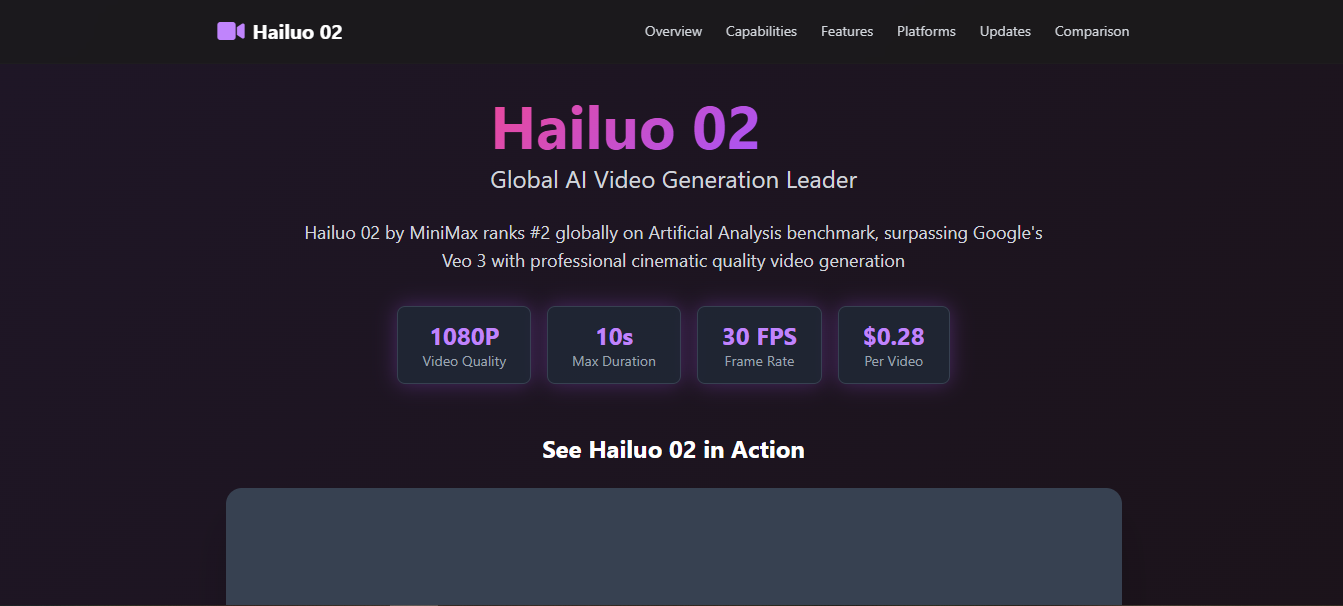
Hailuo 02 è il modello video di punta di MiniMax e una delle più grandi sorprese nel panorama dei video AI dal suo rilascio. Si posiziona al secondo posto a livello globale nel benchmark di Artificial Analysis con un punteggio di 92,1 e batte l'87,3 di Google Veo 3, costando il 30% in meno a 0,28 $ per clip HD di 10 secondi. È basato su una nuova architettura chiamata Noise-aware Compute Redistribution (NCR), che aumenta l'efficienza di addestramento e inferenza di 2,5 volte. Ciò consente a MiniMax di espandere il modello a un numero di parametri tre volte superiore e di addestrarlo su un dataset quattro volte più grande rispetto al suo predecessore.
Caratteristiche
- Architettura NCR: addestramento e inferenza 2,5 volte più veloci con il 22% in meno di consumo energetico.
- Motore fisico: gestisce in modo fluido dinamiche fisiche complesse come detriti volanti, oggetti che rimbalzano e tremolii della telecamera.
- 1080p nativo: output full HD senza upscaling.
- Tag telecamera del regista: comandi in linguaggio naturale per dolly-zoom, orbita e vibrazione della telecamera a mano.
- T2V e I2V: text-to-video e image-to-video in un'unica piattaforma.
- Ottimizzatore di prompt: riscrive prompt approssimativi in istruzioni cinematografiche strutturate.
Pro
- Genera una clip a 1080p in meno di 62 secondi, più velocemente della maggior parte dei concorrenti a parità di qualità.
- La migliore simulazione fisica della categoria, incluse ginnastica e dinamica dei fluidi.
- Il modello di livello professionale più conveniente a 0,28 $ per clip.
- Output coerente tra prompt ripetuti.
Contro
- Nessuna sequenza a lungo formato o multi-inquadratura integrata.
- Filigrane applicate sulle esportazioni del piano gratuito.
I 3 migliori generatori video AI open source nel 2026
I generatori video open source stanno attirando seria attenzione ora. Ottieni più controllo, più libertà di eseguire i modelli localmente e nessun limite rigido come con gli strumenti chiusi. Il compromesso è tuttavia chiaro. Spesso è necessario un hardware potente e un po' di configurazione prima che tutto funzioni senza problemi.
Ecco tre modelli open source che si distinguono:
Wan 2.2
Wan 2.2 è uno dei più discussi generatori video open source in questo momento. Proviene da Alibaba e si concentra sulla qualità cinematografica con movimenti fluidi e una forte precisione dei prompt. Puoi usarlo sia per attività text-to-video e image-to-video, il che lo rende flessibile per diversi flussi di lavoro. Funziona anche su GPU consumer, il che lo rende più accessibile rispetto a molti modelli di fascia alta.
Caratteristiche
- Architettura MoE: esperti specializzati per diverse fasi di rumore.
- T2V/I2V ibrido: input di testo e immagini in un unico modello unificato.
- Quantizzazione GGUF: funziona su GPU consumer con 4 GB di VRAM.
- Controlli cinematografici: etichette per illuminazione, contrasto e tonalità di colore.
- Supporto bilingue: gestione di prompt in inglese e cinese.
- Licenza Apache 2.0: consentito il pieno uso commerciale.
Pro
- Il modello open-source di alta qualità più accessibile disponibile.
- Forte controllo della stilizzazione e rendering del testo sullo schermo.
- La variante da 1.3B consente una reale generazione video su 8GB di VRAM.
- Miglior rapporto qualità-risorse per la maggior parte degli utenti.
Contro
- Il dettaglio delle texture fini è ancora inferiore a HunyuanVideo nelle scene complesse.
- Lo scale-out multi-GPU è meno documentato rispetto ai modelli concorrenti.
Mochi (Genmo)
Mochi 1 è un modello da 10 miliardi di parametri basato su una nuova architettura AsymmDiT, rilasciato sotto licenza Apache 2.0. Eccelle nel movimento fotorealistico a 30fps per soggetti realistici, il che lo rende particolarmente forte per contenuti in stile documentario, ambienti naturali e movimenti umani credibili. È stato uno dei primi modelli open-source che ha spinto le persone a prendere sul serio la generazione video locale.
Caratteristiche
- Backbone AsymmDiT: architettura creata appositamente per la sintesi video.
- Output a 30fps: movimento fluido alla frequenza di fotogrammi nativa.
- Fine-tuning LoRA: personalizza sui tuoi dataset video.
- Licenza Apache 2.0: aperto per la ricerca e l'uso commerciale.
- Integrazione con ComfyUI: supporto per workflow basati su nodi.
- Codifica T5-XXL: forte comprensione del testo e aderenza al prompt.
Pro
- La licenza più permissiva tra tutti i modelli aperti di alta qualità.
- Eccellente movimento fotorealistico e movimento naturale.
- Forte community con condivisione attiva di fine-tune.
Contro
- Limitato alla risoluzione 480p; richiede l'upscaling per l'output HD.
- Richiede oltre 20 GB di VRAM a piena precisione.
HunyuanVideo (Tencent)
HunyuanVideo è il modello video open-source di punta di Tencent e una delle opzioni più avanzate attualmente disponibili. Si concentra sulla generazione di video di alta qualità con una forte coerenza del movimento e una migliore struttura della scena rispetto a molti altri modelli aperti. Il modello è costruito utilizzando un approccio basato su transformer, progettato per gestire sia dati visivi che temporali. Viene spesso utilizzato da sviluppatori e team di ricerca che desiderano un maggiore controllo sui flussi di lavoro di generazione video.
Caratteristiche
- Fusione dual-stream: elaborazione separata di testo e video prima della fusione.
- Parallelismo xDiT: parallelismo di sequenza multi-GPU per un'inferenza più rapida.
- Quantizzazione FP8: impronta di memoria ridotta senza una significativa perdita di qualità.
- Diffusers + comfyUI: integrazione plug-and-play nell'ecosistema.
- Causal 3D VAE: compressione spazio-temporale per un movimento coerente.
Pro
- Migliore qualità cinematografica e realismo dei volti nell'open-source.
- Enorme ecosistema LoRA per la personalizzazione di stili e personaggi.
- Ottima gestione di scene complesse e con più persone.
Contro
- Una clip di 5 secondi può richiedere più di 15 minuti a seconda delle impostazioni.
- Elevata complessità di configurazione; non adatto ai principianti
Caratteristiche chiave da confrontare nei modelli video
Prima di impegnarsi con una piattaforma, queste sono le sei cose a cui vale la pena prestare attenzione.
- Qualità video (risoluzione, realismo)
Questo indica semplicemente la qualità del filmato quando lo si riguarda. Sembra nitido e credibile, o si nota chiaramente qualcosa che "non va"? I migliori strumenti producono video in grado di ingannare a prima vista. I peggiori si rivelano immediatamente a causa di un'illuminazione piatta o di volti dall'aspetto strano.
- Accuratezza del movimento
L'accuratezza del movimento verifica la qualità del movimento di oggetti e personaggi nel video. I buoni modelli mantengono il movimento fluido, senza strani salti o distorsioni. Questo aspetto è fondamentale nelle scene con camminate, gesti o azioni rapide.
- Comprensione del prompt
Dovresti scegliere un modello che segua da vicino il tuo prompt video. Un modello forte comprende i dettagli nel tuo testo e li trasforma in elementi visivi corrispondenti. Se un modello non segue le istruzioni, avrai bisogno di più tentativi per ottenere il risultato desiderato.
- Limiti di lunghezza della clip
Controlla sempre per quanto tempo un modello può generare video in una sola sessione. Alcuni modelli supportano solo clip brevi, mentre altri consentono sequenze più lunghe. Il supporto per clip più lunghe è utile quando lavori sullo storytelling o su scene complete senza doverle dividere in parti.
- Supporto audio
Dovresti lavorare con un modello in grado di generare audio se il tuo progetto richiede il suono. Questo può includere voce, rumore di fondo o effetti di base che corrispondono alle immagini. I modelli con supporto audio riducono la necessità di strumenti di editing audio separati.
Esplora i migliori modelli video AI su Framia Pro
Framia Pro unisce potenti modelli di generazione di video e immagini in un unico posto. Su Framia, puoi accedere a molteplici motori video avanzati come Veo 3.1, Seedance 2.0, Kling 3.0 e altri ancora da un'unica dashboard. La piattaforma ti consente di iniziare con un'idea e trasformarla rapidamente in contenuto video utilizzando testo, immagini, audio o combinazioni di input. Framia supporta anche diversi agenti creativi per casi d'uso specifici come video musicali, annunci pubblicitari o storytelling, il che la rende una scelta flessibile per i creatori di tutti i livelli.
Cosa offre Framia Pro?
- Modifica i video tramite chat
Puoi descrivere le modifiche desiderate in testo semplice e il sistema le applicherà al tuo video. Invece di utilizzare timeline o strumenti manuali, guidi le modifiche digitando istruzioni. Ciò rende più semplice regolare le scene, tagliare parti o perfezionare gli elementi visivi senza una profonda esperienza di editing.
- Lavora con diverse durate e proporzioni
Puoi creare video di diverse lunghezze in base alle tue esigenze, da brevi clip a scene più lunghe. La piattaforma supporta anche molteplici proporzioni come verticale, quadrato e widescreen. Questo ti consente di preparare contenuti per piattaforme come TikTok, Instagram o YouTube senza passaggi aggiuntivi di ridimensionamento.
- Sincronizza l'audio con le tue clip
Framia Pro sincronizza il suono con le immagini, in modo che dialoghi, musica o effetti corrispondano alla tempistica del video. Sincronizza il movimento delle labbra con il parlato e mantiene l'audio sincronizzato con i cambi di scena. Ciò riduce la necessità di regolazioni audio manuali durante il montaggio.
- Supporto per l'editing dello storyboard
Puoi organizzare il tuo video in scene prima della generazione finale. Ogni parte dello storyboard rappresenta un segmento del tuo video, che puoi regolare, riordinare o perfezionare. Questo ti offre un maggiore controllo sulla struttura del tuo video e ti consente di pianificare il flusso delle scene prima del rendering.
Come utilizzare i modelli video AI su Framia Pro?
Puoi seguire questi tre rapidi passaggi per utilizzare diversi modelli AI sul generatore video AI di Framia Pro per creare video:
Passaggio 1: Registrati e imposta la tua idea
- Crea il tuo account Framia Pro e apri l'area di lavoro video.
- Scrivi una descrizione chiara della scena nella casella del prompt in modo che il modello capisca cosa desideri.
- Aggiungi un'immagine di riferimento se desideri un controllo migliore sullo stile o sui personaggi, il che funziona bene con modelli come Kling 3.0 e Seedance 2.0.
Passaggio 2: Scegli il modello AI giusto e genera
- Fai clic su "Select Models" e apri la scheda "Video" per scegliere il modello adatto al tuo obiettivo.
- Imposta la durata del video e le proporzioni in base a dove intendi pubblicarlo.
- Quindi, fai clic su "Genera" per creare la tua clip.
Passo 3: Rivedi, perfeziona ed esporta
- Guarda il video generato e controlla se il movimento, i dettagli e la scena corrispondono alla tua idea.
- Aggiungi prompt di follow-up per regolare parti del video, come il movimento, l'illuminazione o lo stile, a seconda del modello che hai utilizzato.
- Una volta che tutto sembra a posto, fai clic su "Download" per salvare il video finale sul tuo dispositivo.
Conclusione
In questo articolo abbiamo esplorato cosa sono i modelli di generazione video AI e abbiamo esaminato 5 strumenti closed-source e 3 open-source che puoi utilizzare per il tuo progetto. Dovresti concentrarti sul tuo obiettivo prima di scegliere un modello. Alcuni strumenti funzionano bene per brevi clip social, mentre altri si adattano allo storytelling o a scene di alta qualità con audio e dettagli. Quando utilizzi un modello adatto al tuo compito, i tuoi risultati diventano più precisi e facili da gestire. Se desideri accedere a più modelli video AI di punta in un unico posto, puoi esplorare Framia Pro e passare da uno strumento all'altro in base alle esigenze del tuo progetto.
FAQ
Quali sono i migliori modelli AI per la generazione di video in questo momento?.
Alcuni dei migliori modelli AI per la generazione di video includono Veo, Runway, Seedance 2.0, Kling e Pika. Ognuno si concentra su punti di forza diversi come il realismo, il movimento o la facilità d'uso. Su Framia Pro, puoi accedere a diversi di questi modelli e passare dall'uno all'altro in base al tuo progetto.
Cosa sta succedendo al modello video Sora?
Le notizie sul modello video Sora hanno rivelato che è stato recentemente dismesso come app consumer e API nel 2026. OpenAI ha deciso di chiuderlo per concentrarsi su altre aree come la robotica e la ricerca avanzata.
Sono disponibili generatori di video AI open source?
Sì, sono disponibili generatori di video AI open source come Wan, Mochi e HunyuanVideo. Puoi eseguirli in locale e regolarli in base alle tue esigenze, anche se la configurazione richiede conoscenze tecniche. Framia Pro offre un'opzione più semplice se preferisci modelli pronti all'uso senza configurazione locale.
I modelli video AI possono creare video lunghi?
La maggior parte dei modelli video AI si concentra ancora su brevi clip invece che su video completi. Alcuni strumenti consentono scene più lunghe, ma spesso richiedono la combinazione di più clip. Framia Pro supporta diverse durate, in modo da poter creare e gestire le clip in base alle proprie esigenze.
Quale modello video AI dovresti usare?
Dovresti scegliere un modello in base al tuo obiettivo e allo stile dei contenuti. Veo funziona bene per scene realistiche, Kling gestisce il movimento e Seedance offre un maggiore controllo con input multipli. Il video agent di Framia Pro ti consente di testare questi modelli in un unico posto e scegliere quello che si adatta al tuo flusso di lavoro.