共有


- AI動画生成モデルは、テキストプロンプト、画像、または既存の私が保存した色、クリップを、ランダムなノイズをあなたの説明に一致するまで段階的に洗練させる拡散プロセスを通じて、新しい映像に変換します。
- 現在、5つのクローズドソースモデルが業界をリードしており、それぞれ異なる強みを持っています。Veo 3.1(ネイティブオーディオ)、Runway Gen-4.5(クリエイティブコントロール)、Seedance 2.5(長尺のワンテイククリップ)、Kling 3.0(物理的に正確なモーション)、そしてMiniMax H3(統合されたマルチモーダル入力)です。
- Wan 2.2、Mochi、HunyuanVideoは、より高いコントロール性と使用制限なしの環境を提供しますが、より強力なハードウェアと多少のセットアップ時間が必要になります。
- Framia Proは、これらのモデルのいくつかを1つのダッシュボードに統合しているため、個別のログインやサブスクリプションをやりくりすることなく、モデル間を切り替えることができます。
AI動画生成モデルとは何ですか?
AI動画生成モデルは、カメラや撮影クルーを必要とせず、プロンプト、画像、または既存のクリップから動画を構築するシステムです。
これらは、説明文とペアになった何百万もの動画クリップという巨大なデータセットから学習し、「雪の中を走る犬」のようなフレーズと、それが実際に画面上でどのように見えるかを結びつける視覚的なパターンを習得します。
その背景にある技術は拡散(diffusion)と呼ばれます。 モデルはランダムなノイズから開始し、動画が現れるまで数十ステップにわたってノイズを除去していきます。トレーニング中、モデルは実際の動画がノイズへと劣化していく様子を観察し、そのプロセスを逆転させる方法を学習しました。生成時には、あなたのプロンプトが各クリーンアップステップを、記述されたシーンへと導きます。
難しいのは単一のフレームではありません。何百ものフレーム間で一貫性を保ち続けることです。 顔、服装、あるいは影は、単に単体で正しく見えるだけでなく、クリップ全体を通して安定していなければなりません。
動画モデルは、フレームシーケンス全体をまとめて処理するため、各フレームが他のフレームを参照できます。これが、動画生成が単一の画像の生成よりもはるかに多くの計算量を必要とする理由です。
さまざまな種類のAI動画モデルにはどのようなものがありますか?
テストを始める前に、すべてのAI動画生成ツールが同じスタートラインから始まるわけではないため、自分が実際にどのタイプのツールを使用しているのかを整理する必要がありました。
テキストto動画AIモデル
テキストto動画モデルは、書かれた説明文をゼロから動くシーンへと変換します。あなたが望むものを書くと、モデルがビジュアルを構築します。これは、製品コンセプト、短いストーリーの展開、または特定のシーンなど、アイデアはあるものの、開始するための映像や参照画像がない場合に最適です。
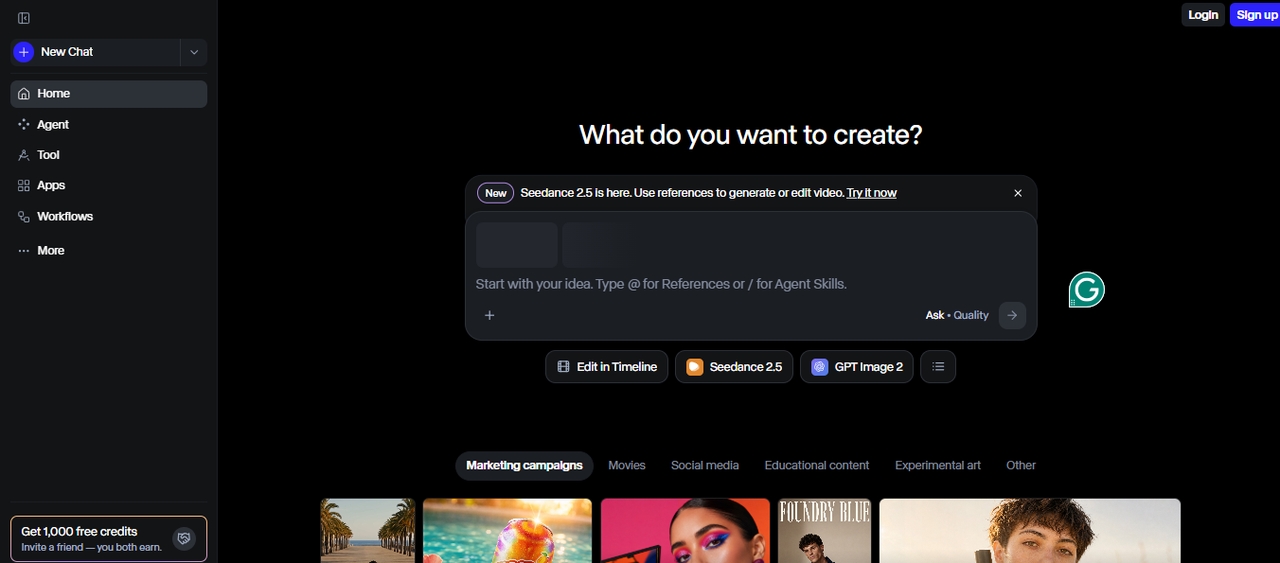
画像to動画モデル
画像to動画モデルは、すでに手元にある画像から開始し、動き、カメラワーク、または小さな変化を加えて命を吹き込みます。これは、すべてをゼロから生成することなく、素早い動きを加えたい製品デモやソーシャルメディアの投稿に適しています。
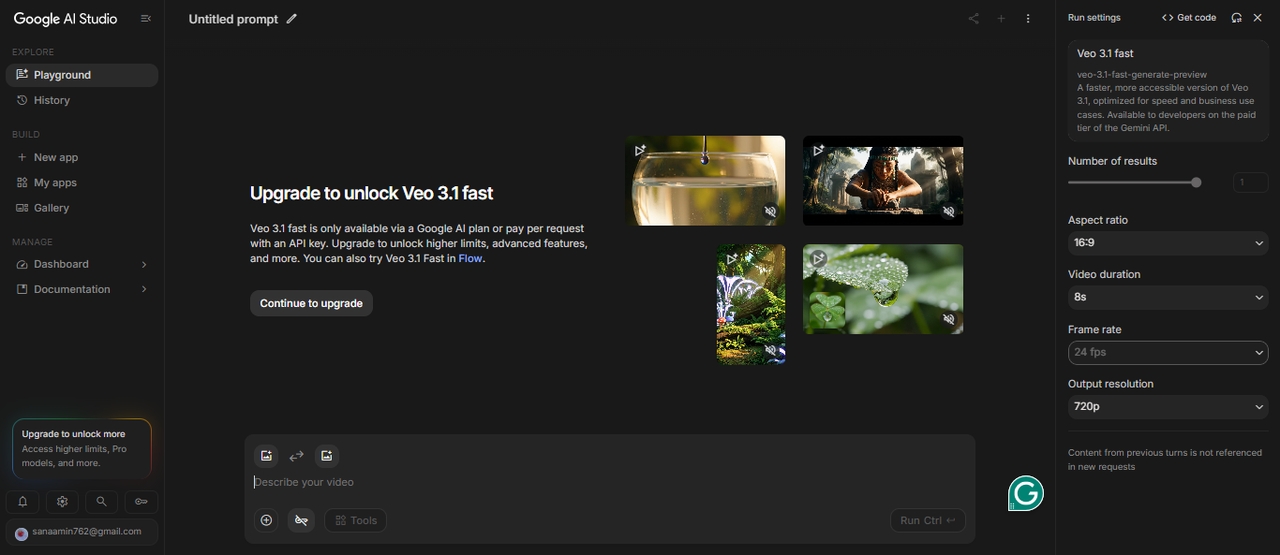
マルチモーダル動画モデル
これらのモデルは、同時に複数のタイプの入力を処理できます。テキスト、画像、オーディオ、さらには既存の動画クリップを組み合わせて、最終的な結果をガイドすることができます。
これにより、動画の仕上がりをより細かくコントロールできるようになります。単にシーンを説明するだけでなく、複数の入力を使ってシーンを形作ることができます。このコントロール性は、特定のディテール、よりスムーズなストーリーテリング、または明確な方向性に沿った動画を求めるときに役立ちます。
各モデルのテスト方法
私は、過去2年間、仕事としてAIクリエイティブツールのテストを行ってきたコンテンツストラテジストです。今回、それぞれのAI動画生成モデルに対して、製品デモ、短いナラティブシーン、トーキングヘッド(人物の語り)クリップ、アクションシーケンス、および様式化されたアート作品を含む、同じ5つのプロンプトを実行しました。
すべてのモデルについて、プロンプトごとに少なくとも3つの出力を生成し、リアリズム、モーションの正確さ、プロンプトへの追従性、および該当する場合はオーディオの品質に基づいてスコアを付けました。
8つのAI動画生成モデルと、それぞれの得意分野
製品デモ、ナラティブシーン、トーキングヘッドクリップ、アクションシーケンス、スタイライズドビジュアルにわたり、8つのAI動画生成モデルをテストした結果、すべてのカテゴリで最も優れたパフォーマンスを発揮する単一のモデルは存在しないことがわかりました。Veo 3.1はネイティブオーディオで際立っており、Runway Gen-4.5はクリエイティブなコントロールとシーンの一貫性、Seedance 2.5はより長いシングルパスクリップで優れていました。Kling 3.0は動きの激しいシーンで強力な選択肢であり、MiniMax H3は混合入力と同期オーディオをうまく処理しました。Wan 2.6、Mochi、HunyuanVideoは、オープンウェイトモデルやローカルワークフローを好むユーザーに代替手段を提供しますが、ハードウェア要件やセットアップが制限要因となる場合があります。
これらの結果は、普遍的なランキングではなく、私の実践的なテストに基づいています。最適な選択は、動画のタイプ、出力要件、予算、そしてホスト型サービスを好むか、自分で実行できるモデルを好むかによって異なります。
以下では、プロジェクトに最適なモデルを選択できるよう、各モデルの強み、機能、メリット、デメリットを詳しく解説します。
以下は、今知っておくべき主要なクローズドソースモデルです。
| 機能 | Veo 3.1 | Runway Gen-4.5 | Seedance 2.5 | Kling 3.0 | MiniMax H3 |
| 最大解像度 | 1080p | 1080p | ネイティブ1080p | 4K / 60fps、ネイティブ4K/60fpsを達成した初のモデル | 2K/24fps、768pも利用可能 |
| 最大クリップ長 | ネイティブで8秒、サードパーティ製ツールで延長可能 | Gen-4で最大16秒 | 1回の連続テイクで最大30秒 | 最大2分、3分まで延長可能 | 5〜15秒、内蔵の延長ツールで30秒まで延長可能 |
| フレームレート | 24–30fps | 24fps | 未公開 | 30fps | 24fps |
| ネイティブオーディオ | ✅ 対話、効果音、環境音 | ✅ 2025年12月追加 | ✅ 10言語以上 | ✅ | ✅ ネイティブステレオ |
| マルチモーダル入力 | ✅ 最大3つの画像参照 | ❌ | ✅ 最大50の参照(画像30、動画10、音声10) | ✅ テキスト、画像、音声、動画 | ✅ テキスト、画像、動画、音声を1つのコンテキストとして読み込み |
| マルチショット | ❌ | ✅ | ✅ 1回の連続テイク、つなぎ合わせなし | ✅ 最大6ショット | ❌ |
| 物理エンジン | ✅ | ❌ | 未指定 | ✅ | 未指定 |
| 高速 / ドラフトモード | ✅ Veo 3 Fast | ✅ Gen-4 Turbo | 未公開 | ✅ 最大20倍高速 | ✅ 768pの軽量オプション |
| アスペクト比 | 16:9 および 9:16 | 16:9, 9:16, 1:1 | 未公開 | 16:9, 9:16, 1:1 | 21:9, 16:9, 4:3, 1:1, 3:4, 9:16 |
| 無料プラン | ❌ | ❌ | Jimeng AI、Doubao、Dreaminaで順次展開中 | ✅ 毎日66クレジット | Hailuo AIアプリ経由 |
| 最適な用途 | リアリズム + オーディオ | シネマティックなコントロール | 長尺のシングルテイククリップ + 参照 | 4K + 長尺 | マルチモーダル編集 + 一貫性 |
- Veo 3.1
Veo 3.1はGoogleのフラッグシップ動画生成モデルであり、オーディオ機能において私のテストした他のモデルと一線を画していました。1つのプロンプトから、動画と同じパスで対話、効果音、環境音を生成します。2025年10月のリリース後、ソーシャルプラットフォームでバイラルクリップの波を生み出す原動力となり、Google Workspaceとの連携により、すでにそのエコシステムに組み込まれている私のワークフローの一部に簡単に適合しました。
機能
- ネイティブオーディオ: 1つのパスで対話、効果音、環境音を生成。
- 4K解像度:最大で超高精細な出力に対応。
- マルチ参照:最大3つの参照画像をサポート。
- 長尺対応:最大1分間の動画を出力可能。
- プロンプト対話:プロンプトにキャラクターのセリフを直接記述可能。
メリット
- 比類のないネイティブオーディオ品質。
- 優れたリアリズムと正確なライティング。
- Googleエコシステムとの深い統合。
- 強力なプロンプトの正確性。
デメリット
- 下位プランでは動画にウォーターマークが入る。
- スタイライズされたコンテンツや非現実的なコンテンツに対する柔軟性が低い。
- Runway Gen-4.5
Runwayは長年にわたり生成AI動画モデルの定番であり、2025年後半にリリースされたGen-4.5は、品質とマルチショットシーケンスが最も大きく飛躍したと感じたモデルです。そのチャットインターフェースにより、プロンプトを一から書き直すことなく、会話で変更を説明するだけで動画を微調整できました。テストしたすべてのモデルの中で、複数のショットにわたるシーンやキャラクターの一貫性が重要となる場合、クリエイティブプロフェッショナルに最もお勧めしたいモデルです。
機能
- モーションブラシ: シーンのどの部分を動かすかを正確にペイントします。
- マルチショット:複数のクリップをつなぎ合わせて、1つのまとまりのあるシーケンスにします。
- Act-one: 表情とモーションのキャプチャ。
- チャット編集:自然な会話を通じて出力を微調整します。
- 4K出力:超高解像度エクスポート。
メリット
- クラス最高のシーンとキャラクターの一貫性。
- プロフェッショナルのための強力なクリエイティブコントロール。
- 強力なコミュニティとエコシステム。
デメリット
- 上位プランでは高価。
- 迅速なソーシャルコンテンツ作成において、一部の競合他社よりも遅い。
- 初心者にとっては学習曲線がやや急。
- Seedance 2.5
Seedance 2.5は、2026年初頭にテキストからビデオ、および画像からビデオの両方でArtificial Analysis Video Arena の首位に立っていたSeedance 2.0に続く、ByteDanceの後継モデルです。この新バージョンでは、1回の生成時間が15秒から丸々30秒に延長され、ネイティブ1080pに対応し、1回の生成で最大50個のマルチモーダルリファレンス(画像、ビデオ、オーディオの組み合わせ。前バージョンの12個から増加)を受け付けることができます。また、10以上の言語でネイティブオーディオが追加されており、Jimeng AI、Doubao、Dreaminaに展開されている最中にテストを行いました。APIアクセスはBytePlus ModelArkを通じて提供されます。
機能
- 延長された1回での生成:1つの連続したクリップで最大30秒、つなぎ合わせは不要です。
- ネイティブ1080p:前バージョンの720pから向上。
- 拡張されたリファレンスサポート: 1回の生成で最大50個のマルチモーダルリファレンス(画像30枚、ビデオ10本、オーディオ10個)に対応。
- ネイティブの多言語オーディオ:10以上の言語での対話とサウンド。
- 精密な編集:クリップ全体を再生成することなく、製品を入れ替えたり、ショットを延長したり、特定の編集を行ったりできます。
- 3Dホワイトモデルのプリビジュアライゼーション:完全な生成を行う前に、カメラの動きやショットを大まかに構成(ブロッキング)できます。
メリット
- 長尺のワンテイククリップは、ショートドラマや連続もののコンテンツに適しています。
- 30秒のテイク全体を通して、ショット間のカメラの連続性が強力です。
- 参照数が拡張されたことで、キャラクターや製品の一貫性をより細かくコントロールできます。
デメリット
- ByteDanceはまだ完全な技術レポートを公開していないため、一部の仕様は独立したテストではなく、ローンチ時のデモに基づいています。
- テスト時点では、完全なAPIアクセスがすべての場所で利用可能だったわけではありません。
- Kling 3.0
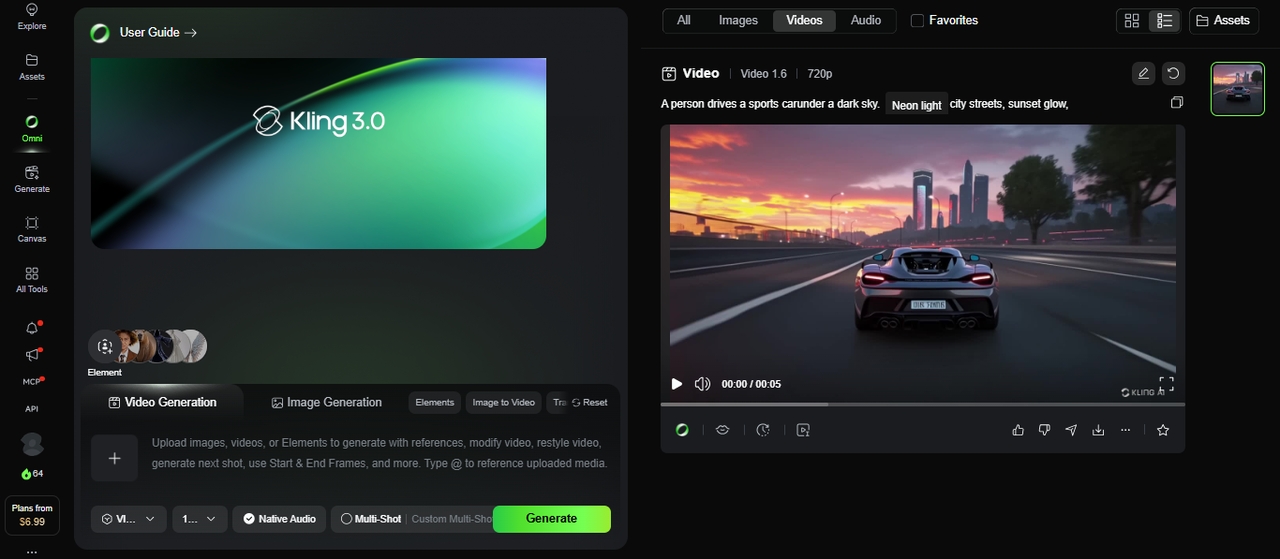
Kling 3.0は2026年2月4日にローンチされ、数日のうちに今年最大のAI動画生成の飛躍と称されるようになりました。これは、3D Spacetime Joint Attentionとchain-of-thought(思考の連鎖)推論を組み合わせたOmni Oneアーキテクチャ上で動作しており、私のテストでは、重力、バランス、変形、慣性がゴムのようにならず、リアルに見えるようになりました。テキスト、画像、音声、動画にわたるマルチモーダルな入力を受け付け、英語、中国語、日本語、韓国語、スペイン語のネイティブ音声を生成し、キャラクターの対話や発言順序をコントロールできます。
機能
- Omni one物理演算: リアルな重力、衝突、慣性のシミュレーション。
- ネイティブオーディオ: ナレーション、リップシンク、SFX、音楽。
- マルチショットストーリーボード: 監督レベルのカメラコントロールを備えた最大6ショット。
- ドラフトモード: 迅速なプロトタイピングのために最大20倍高速に生成。
- 4K/60fps出力: 16ビットHDRおよびEXRエクスポートに対応。
- 7-in-1エディタ: オブジェクト追加、背景入れ替え、スタイル転送を1つのツールで。
メリット
- 現在利用可能な中で最もリアルな人間の物理挙動と動き。
- 方言やアクセントのコントロールが可能なネイティブの多言語オーディオ。
- 月額7.99ドルからの手頃なエントリー価格と、充実した無料プラン。
- プロフェッショナルなVFXパイプライン(Nuke、After Effects、DaVinci)に直接エクスポート可能。
デメリット
- 15秒のマルチショットレンダリングに5分以上かかる場合があります。
- 4K出力は現在、上位プランに限定されています。
- 需要の高い時期はレンダリングキューを延長します。
- MiniMax H3
Hailuo 3.0としても知られるMiniMax H3は、MiniMaxのビデオラインナップにおいてHailuo 02に続くものです。テキスト、画像、ビデオ、オーディオの参照を個別の入力として扱う代わりに、これらすべてを1つの共有コンテキストとしてまとめて読み込み、同期されたビデオとオーディオを1つの結果として返します。MiniMaxはモデルの重みをリリースする計画があると述べていますが、私はHailuo AIアプリ、MiniMax Open Platform API、およびfalなどのホスティングパートナーを通じてアクセスしました。
特徴
- 統合されたマルチモーダルコンテキスト: テキスト、画像、ビデオ、オーディオの参照が1回の生成でまとめて解決されます。
- ネイティブステレオオーディオ: 対話、音楽、効果音、環境音が後から重ねられるのではなく、ビデオと同時に生成されます。
- 最大2K解像度、24fpsに対応し、より軽量なオプションとして768pも利用可能です。
- 5〜15秒の生成が可能で、内蔵のExtend Videoツールを使用して最大30秒まで延長できます。
- ターゲットを絞った編集: クリップ全体をやり直すことなく、キャラクターやオブジェクトの入れ替えや削除、照明や背景の変更、対話の修正を行うことができます。
- 複数のアスペクト比: 21:9、16:9、4:3、1:1、3:4、および9:16。
メリット
- 強力な時間的一貫性。動きが途中でブレることなく、クリップ全体を通して安定しています。
- ネイティブステレオオーディオが同じ生成パスから出力され、個別のサウンド処理ステップは不要です。
- 幅広いアスペクト比のサポートにより、映画のようなワイドスクリーンから縦型のSNSコンテンツまで、あらゆるものに適合します。
デメリット
- MiniMaxはまだ完全な技術レポートを公開していないため、一部の主張は独立したベンチマークではなく、同社からの情報に基づいています。
- 重みがリリースされた後、オープンウェイト版をローカルで実行するには、24GB以上のVRAMを搭載したハイエンドGPUが必要です。
| 機能 | Wan 2.2 | Mochi 1 (Genmo) | HunyuanVideo (Tencent) |
| パラメータ数 | 1.3B / 14B | 10B | 13B |
| 最大解像度 | 720p (14Bでは1080p) | 480p (640x480) | 720p (v1.5では1080p) |
| 最大クリップ長 | 最大10秒 | 30fpsで最大5.4秒 | 最大5秒 (720p) |
| フレームレート | 16fps | 30fps | 24fps |
| 最小VRAM | 8GB (1.3Bモデル) | フル精度で20GB以上 | 14GB (v1.5) / 60–80GB (オリジナル) |
| 生成速度 | 4〜5秒のクリップで1〜2分 (8GB GPU) | 5.4秒のクリップで3〜4分 | 5秒のクリップで6〜10分 (16GB GPU) |
| Text-to-Video | ✅ | ✅ | ✅ |
| Image-to-Video | ✅ | ❌ | ✅ |
| LoRAファインチューニング | ✅ | ✅ | ✅ (高い計算能力が必要) |
| ComfyUIサポート | ✅ | ✅ | ✅ |
| Diffusersサポート | ✅ | ❌ | ✅ |
| バイリンガルプロンプト | ✅ 英語 + 中国語 | ❌ | ❌ |
| ライセンス | Apache 2.0 | Apache 2.0 | Tencent Community License |
| コンシューマーGPU対応 | ✅ クラス最高 | ❌ | ⚠️ v1.5のみ |
| 最適な用途 | 汎用性 + アクセシビリティ | フォトリアリズム + ファインチューニング | シネマティックな品質 + 顔 |
- Wan 2.6
Wan 2.6は、2025年12月にリリースされたAlibabaのビデオ生成モデルシリーズです。テキストからビデオ、画像からビデオ、および参照からビデオへの生成をサポートしています。主な強みには、マルチショットのストーリーテリング、向上したプロンプト追従性、そしてビジュアルと同期し続けるオーディオが含まれます。参照からビデオへのモデルは、参照クリップを使用して、新しく生成されたシーンで人物やオブジェクトの外見と声を維持することもできます。
Wan 2.6は、AI生成シーン、製品ビデオ、または対話主導のクリップを実験したいクリエイターにとって、引き続き選択肢の1つです。
特徴
- MoEアーキテクチャ: さまざまなノイズステージに特化したエキスパート。
- Hybrid T2V/I2V: テキストと画像の入力を1つの統合モデルに。
- GGUF量子化: 4GBのVRAMを搭載したコンシューマー向けGPUで動作します。
- シネマティックコントロール: ライティング、コントラスト、色調のラベル。
- バイリンガル対応: 英語と中国語のプロンプト処理。
- ホスト型アクセス: Alibaba Cloud Model Studioを通じて、サポートされているWanモデルを使用できます。
メリット
- 1つのモデルファミリー内で複数の動画生成ワークフローをサポートします。
- マルチショットコントロールは、ショートストーリー、広告、製品紹介に適しています。
- Reference-to-videoは、生成されたシーン全体でキャラクターのアイデンティティを維持するのに役立ちます。
- サポートされているバリアントで、同期されたオーディオと対話機能を提供します。
デメリット
- クリップが短いため、より長いプロジェクトでは複数回の生成と編集が必要になる場合があります。
- ホスト型アクセスには、API料金やサービス固有の制限が適用される場合があります。
- Mochi (Genmo)
Mochi 1は、Apache 2.0ライセンスの下でリリースされた、新しいAsymmDiTアーキテクチャ上に構築された100億パラメータのモデルです。私のテストでは、フォトリアルな30fpsの動きにおいて最も強力であり、ドキュメンタリースタイルの映像、自然環境、そしてリアルに見せる必要がある人間の動きに適しています。これは、私がローカルでの動画生成を本格的に検討するきっかけとなった、最初のオープンソースモデルの1つでした。
特徴
- AsymmDiTバックボーン: 動画合成専用に構築されたアーキテクチャ。
- 30fps出力: ネイティブフレームレートでのスムーズな動き。
- LoRAファインチューニング: 独自の動画データセットでカスタマイズ可能。
- Apache 2.0ライセンス: 研究および商業利用に開放。
- ComfyUI統合: ノードベースのワークフローのサポート。
- T5-XXLエンコーディング: 強力なテキスト理解とプロンプトへの追従性。
メリット
- 高品質なオープンモデルの中で最も寛容なライセンス。
- 優れたフォトリアリスティックな動きと自然な動作。
- 活発なファインチューニングの共有が行われている強力なコミュニティ。
デメリット
- 解像度が480pに制限されており、HD出力にはアップスケーリングが必要。
- フル精度では20GB以上のVRAMが必要。
- HunyuanVideo (Tencent)
HunyuanVideoはTencentのフラッグシップオープンソース動画モデルであり、私が試したほとんどのオープンな代替モデルよりも強力なモーションの一貫性とクリーンなシーン構造を備えた、高品質な生成のために構築されています。そのトランスフォーマーベースのアーキテクチャは視覚データと時間データを一緒に処理し、ホスト型ツールが提供する以上の生成プロセスの制御を求めるときはいつでも、私はこれに頼りました。
特徴
- オープンソースカテゴリで最大規模の1B。
- デュアルストリームフュージョン:マージする前にテキストとビデオの処理を分離。
- xDiT並列処理: 推論を高速化するためのマルチGPUシーケンス並列処理。
- FP8量子化:大きな品質低下なしにメモリ使用量を削減。
- Diffusers + comfyUI:プラグアンドプレイのエコシステム統合。
- Causal 3D VAE:一貫した動きのための時空間圧縮。
メリット
- オープンソースにおける最高のシネマティック品質と顔のリアリズム。
- スタイルやキャラクターのカスタマイズのための大規模なLoRAエコシステム。
- 強力な複数人数および複雑なシーンの処理。
デメリット
- 設定によっては、5秒のクリップに15分以上かかる場合があります。
- セットアップの難易度が高く、初心者には不向き。
Framia ProでトップクラスのAI動画モデルを探索する
私が直面した実際の問題は次のとおりです。VeoのためにGoogleアカウント、Gen-4.5のためにRunwayのサブスクリプション、KlingのためにKuaishouのログインを用意し、新しいモデルがリリースされるたびにそのセットアップを繰り返したくありませんでした。それが、このテストの大部分をFramia Proに移行した理由です。
Framia Proは、Veo 3.1、Kling 3.0、Seedance 2.5、およびその他のトップクラスの動画・画像モデルを1つのワークスペースに統合します。タブを切り替えたり、モデルごとに個別の有料アカウントを用意したりすることなく、アイデアから始めて、テキスト、画像、音声、またはこれら3つの組み合わせを使用して動画に変換できます。組み込みのクリエイティブエージェントは、例えばミュージックビデオ、広告、ストーリーテリングなどの特定のユースケースもカバーしているため、何を作るにしてもスタートラインが用意されています。
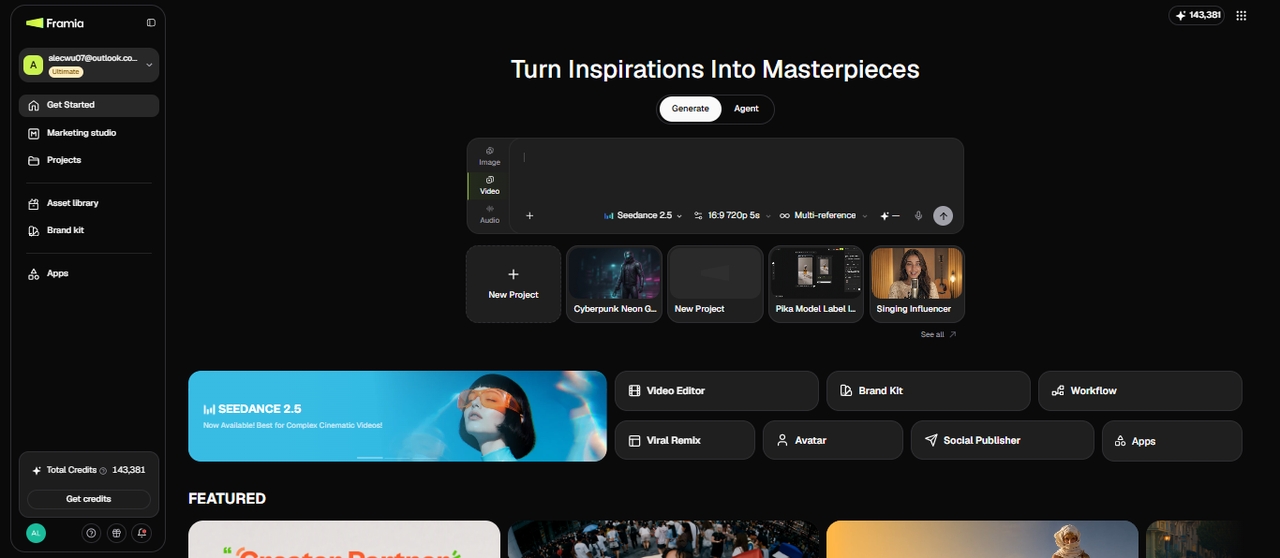
Framia Proは何を提供しますか?
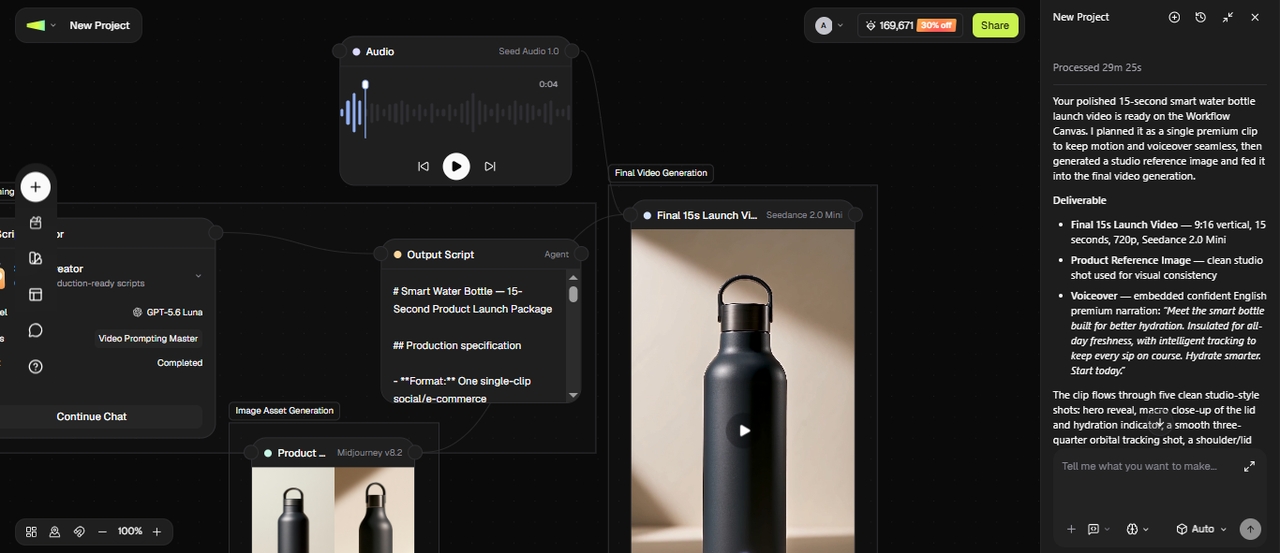
私はキャンバス上でEコマースの製品ローンチ動画を作成してみました。まず、クリーンな製品カットを生成するためにImageエージェントから始め、それらをVideoノードに送ってKlingまたはSeedanceでデモクリップに変換し、その結果をAudioノードにルーティングして一致するナレーションを付けました。これらすべてを、4つの別々のツールを使う代わりに、1つのキャンバス内で行いました。
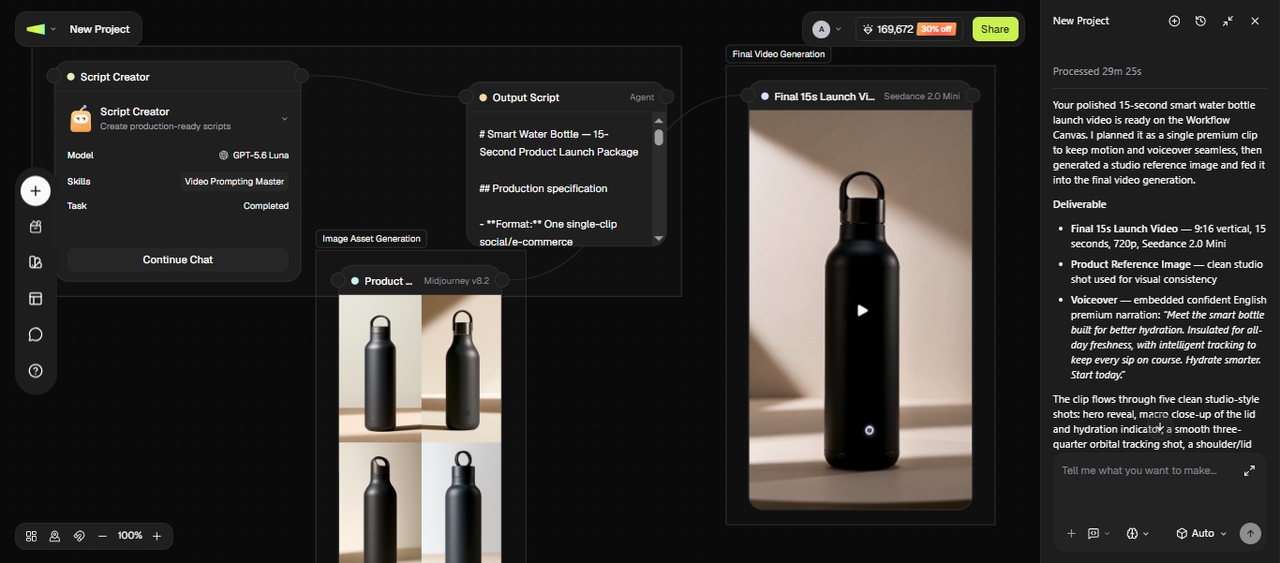
以下は、その過程で役立った機能です:
- 専用のImage、Audio、およびVideoエージェント: 私はVideoエージェントを使用して、プロンプト、スクリプト、または画像を上記のモデル全体の完全なクリップに変換し、サムネイル、ナレーション、音楽が個別に必要な場合はいつでもImageおよびAudioエージェントを使用しました。
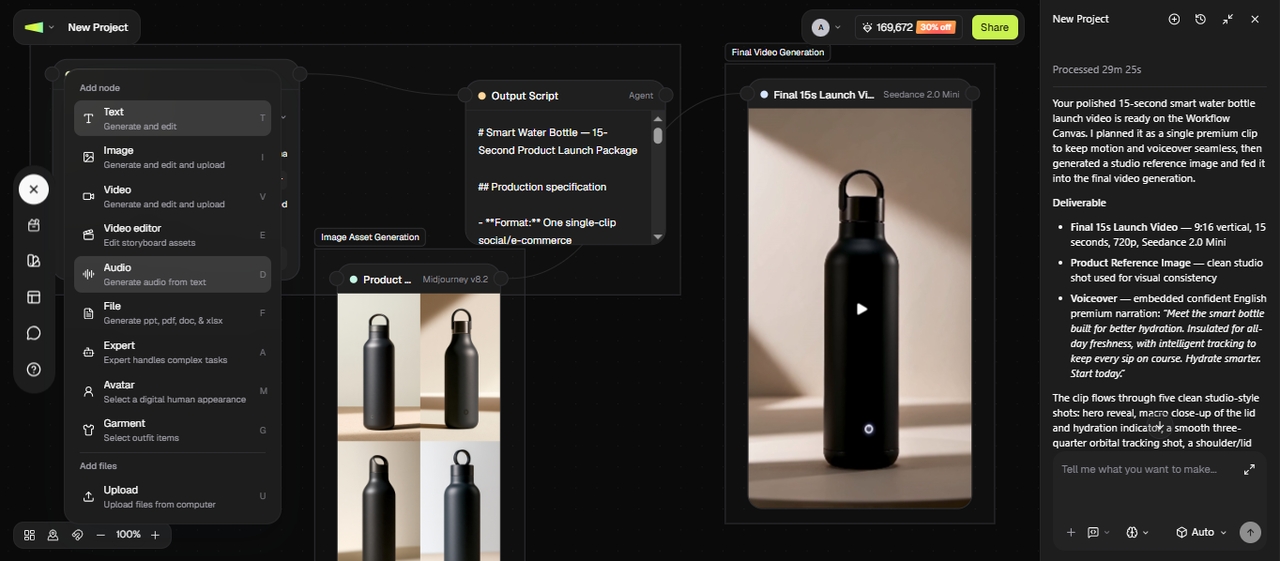
- プロンプトの修正と再生成: 私は希望する変更をプレーンテキストで説明するだけで、Framia Proがタイムラインや手動の編集ツールを必要とせずにそれを適用してくれました。事前の編集経験がなくても、シーンの調整、パーツのカット、ビジュアルの洗練を行うことができました。
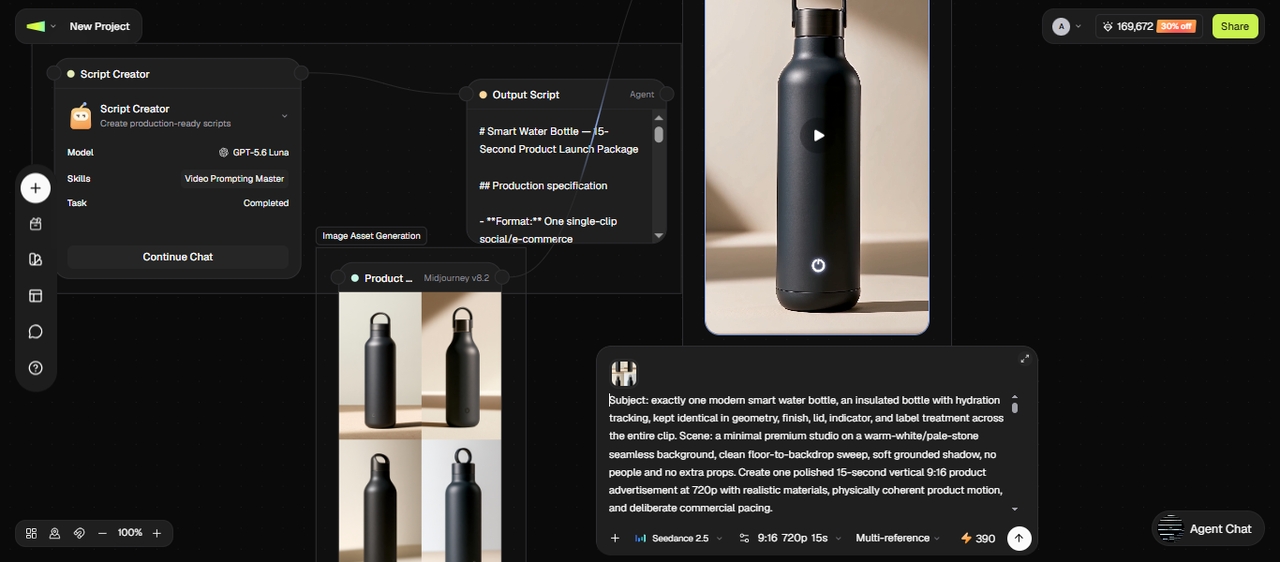
- スクリプト、レビュー、および再利用のためのスキル: 大まかなアイデアを構造化されたスクリプトに変換し、完成した動画のペースと維持率のレビューを行い、1本の長い動画をプラットフォームに対応した複数の短いクリップにカットしました。
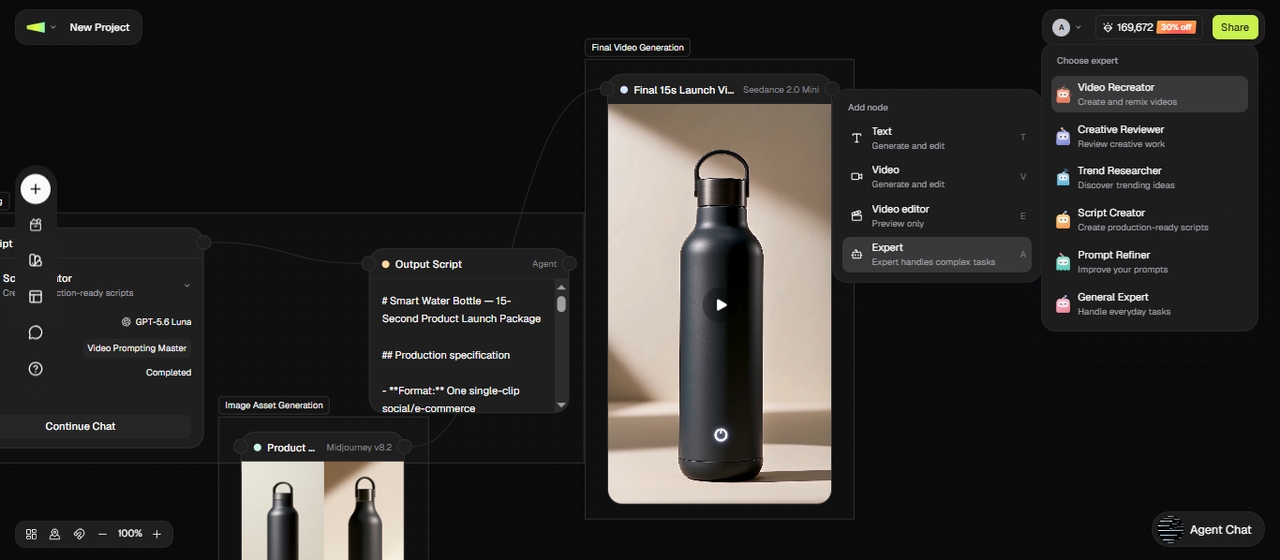
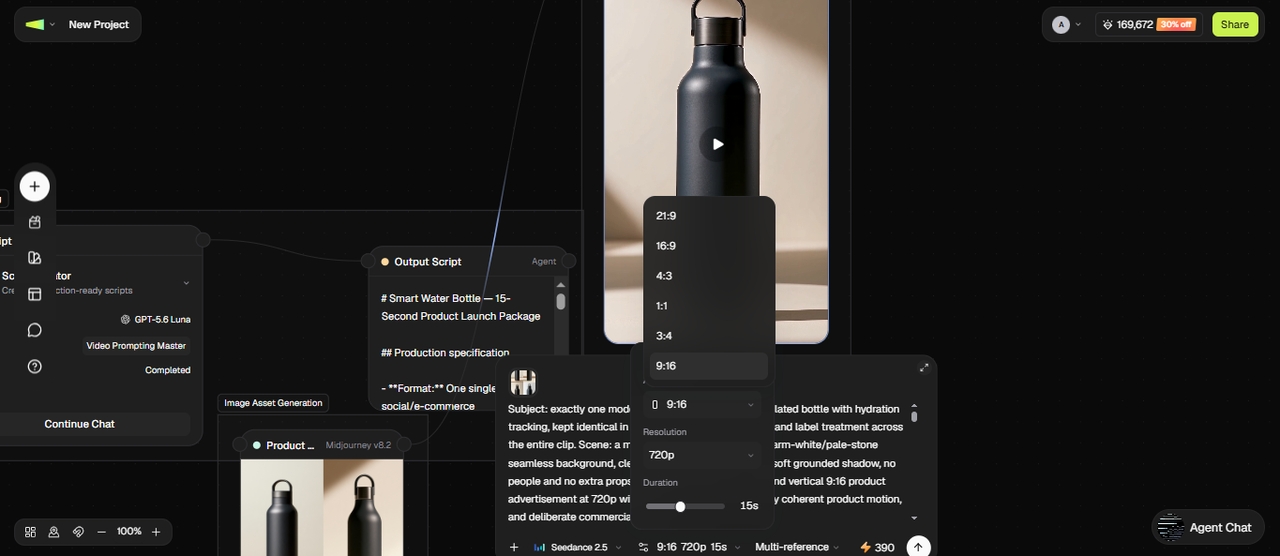
- 複数の長さとアスペクト比: さまざまなプロジェクト向けに、縦型、スクエア、またはワイドスクリーンで異なる長さのクリップを作成したため、TikTok、Instagram、YouTube用のバージョンを追加のサイズ調整なしで用意できました。
- クリップとオーディオの同期: Framia Pro は音声をビジュアルと同期させるため、対話、音楽、またはエフェクトが動画のタイミングと一致します。リップシンク(唇の動きと音声の連動)を行い、シーンの切り替えに合わせてオーディオを配置するため、編集時の手動によるオーディオ調整を削減できます。
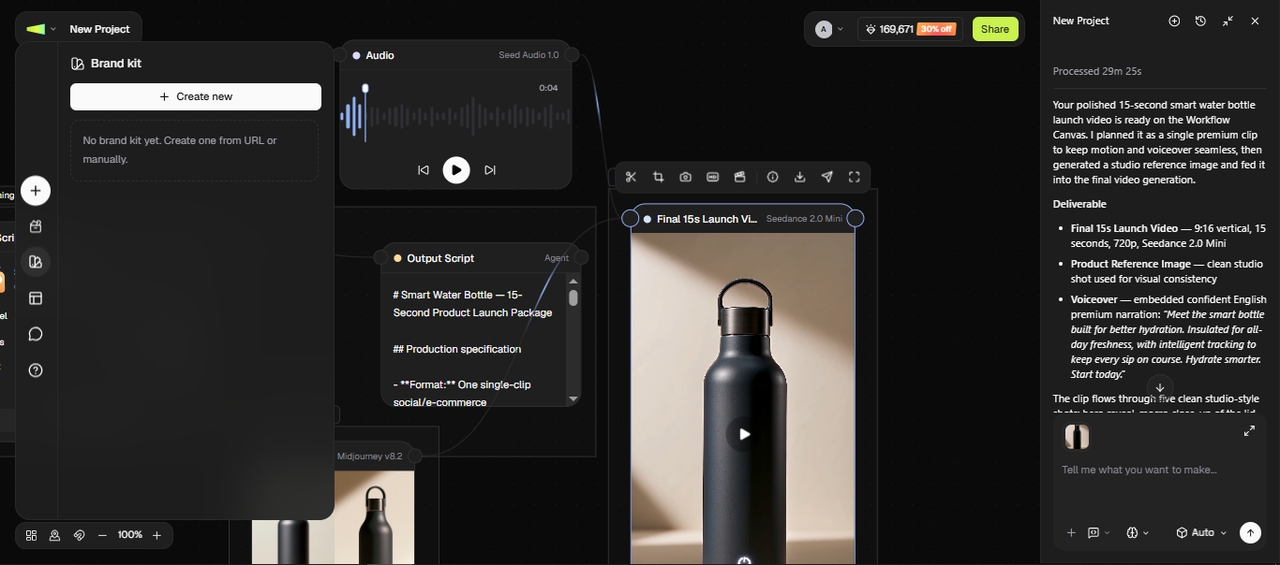
- Brand Kit: 色、フォント、ロゴを一度保存するだけで、ワークスペース内のどのモデルから生成されたすべての動画にもそれらを適用できました。
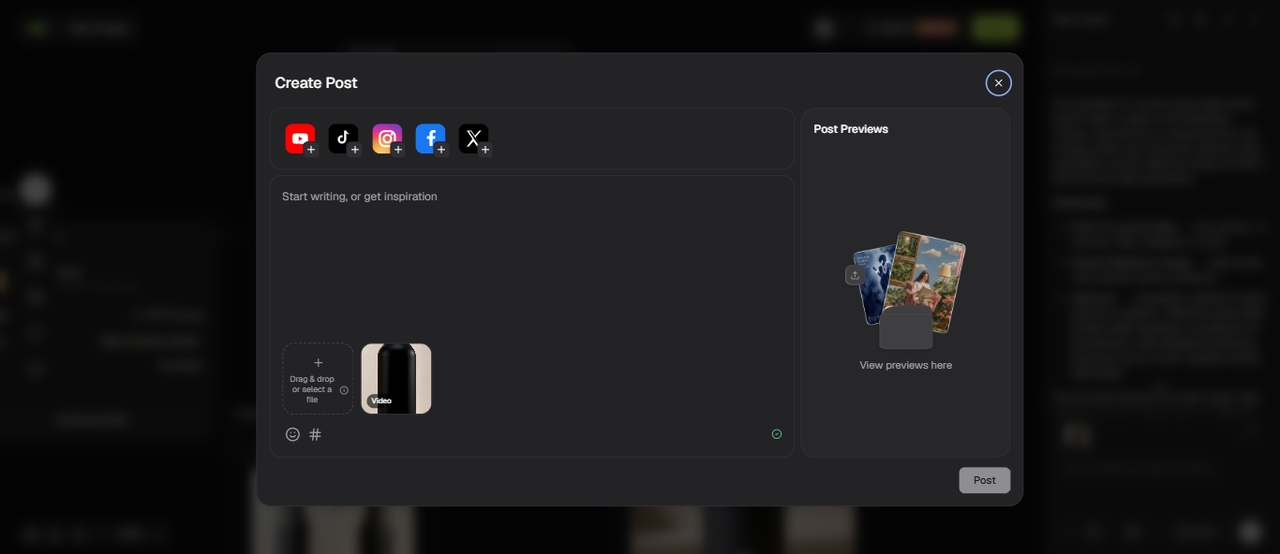
- Publisherからの直接エクスポート: 完成した動画をFramia Proから直接TikTokに送信したため、個別にダウンロードしてアップロードする手順は不要でした。
結論
この記事では、AI動画生成モデルとは何かを探り、プロジェクトに使用できる5つのクローズドソースツールと3つのオープンソースツールをレビューしました。モデルを選択する前に、目標に焦点を当ててください。一部のツールは素早いソーシャルクリップに適していますが、他のツールはストーリーテリングや、音響や詳細を備えた高品質なシーンに適しています。タスクにモデルを一致させると、結果はより正確になり、管理しやすくなります。複数のトップクラスのAI動画モデルに1か所からアクセスしたい場合は、Framia Proを探索し、プロジェクトのニーズに基づいてツールを切り替えてみてください。
よくある質問
現在、最も優れた動画生成AIモデルはどれですか?
トップクラスの動画生成AIモデルには、Veo、Runway、Seedance 2.5、Kling、およびMiniMax H3が含まれます。それぞれが、リアリズム、モーション、オーディオ、使いやすさなど、異なる強みを持っています。Framia Proでは、これらのモデルのいくつかにアクセスし、プロジェクトに基づいて切り替えることができます。
Soraの動画モデルはどうなっていますか?
そのSora video model newsにより、同モデルが2026年に消費者向けアプリおよびAPIとしての提供を最近終了したことが明らかになりました。OpenAIは、ロボティクスや高度な研究など他の分野に注力するため、提供を終了することを決定しました。
オープンソースのAIビデオ生成ツールはありますか?
はい、Wan、Mochi、HunyuanVideoなどのオープンソースAIビデオ生成ツールが利用可能です。セットアップには技術的な知識が必要ですが、ローカルで実行し、ニーズに合わせて調整することができます。ローカルでのセットアップなしですぐに使えるモデルをご希望の場合は、Framia Proがより簡単な選択肢を提供します。
AIビデオモデルで長い動画を作成することはできますか?
ほとんどのAIビデオモデルは、依然としてフルレングスの動画ではなく、短いクリップに焦点を当てています。一部のツールではより長いシーンが可能ですが、多くの場合、複数のクリップを組み合わせる必要があります。Framia Proはさまざまな長さに対応しているため、ニーズに合わせてクリップを作成および管理できます。
どのAIビデオモデルを使用すべきですか?
目的やコンテンツのスタイルに基づいてモデルを選択する必要があります。Veoはリアルなシーンに適しており、Klingは動きの処理に優れ、Seedanceは複数の入力により詳細なコントロールが可能です。Framia Proのビデオエージェントを使用すると、これらのモデルを1か所でテストし、ワークフローに最適なものを選択できます。
AIビデオ生成モデルの使用には費用がかかりますか?
ほとんどのモデルは有料ですが、価格設定は大きく異なります。クリップごとに課金されるものもあれば、クレジット制限付きの月額サブスクリプションで運営されているものもあります。WanやMochiのようなオープンソースモデルは無料で実行できますが、独自のGPUハードウェアが必要になります。
AIが生成した動画を商用プロジェクトに使用できますか?
モデルのライセンスやサブスクリプションのプランによって異なります。Wan 2.2、Mochi、HunyuanVideoなどのApache 2.0モデルは商用利用が可能です。Veo、Runway、Klingなどのクローズドソースツールの場合は、有料作品やブランド作品で生成された動画を公開する前に、特定のプランの商用利用規約を確認してください。
ネイティブオーディオをサポートしているAIビデオモデルはどれですか?
現在のいくつかのモデルは、後から追加するのではなく、ビデオと同じパスでオーディオを生成します。Veo 3.1、Kling 3.0、Seedance 2.5、MiniMax H3はすべて、会話、効果音、画面上の出来事に連動した環境音を含むネイティブオーディオをサポートしています。