
 共有


Midjourneyをよく使う人なら、美しい画像を生成するのがどれほど簡単か、すでにご存知でしょう。より難しいのは、その後に何が起こるかです。
この画像は動画の最初のフレームになれるでしょうか?同じキャラクターが別のシーンに再び登場できるでしょうか?1つのビジュアルの方向性を、YouTubeのサムネイル、TikTokのカバー、あるいは完全なAI動画ワークフローに変換できるでしょうか?
そこが、私にとってMidjourney V8.2がより興味深く感じられる理由です。私はこれを、単なる画像生成ツールのアップデートとは捉えていません。私はこれを、制作のためのより優れた出発点として捉えています。よりクリーンなキーフレーム、より強力なキャラクターリファレンス、そしてSeedance、Kling、Runway、あるいはFramiaといったツールに渡しやすくなったビジュアルです。
一緒に試してみませんか?Framiaワークスペースを開き、Midjourney V8.2を選択して、ご自身のアイデアで以下のワークフローを試してみてください。
このガイドでは、基本的な「プロンプトの入力方法」の紹介は省略します。代わりに、私が実際に使用する4つの実践的なワークフローに焦点を当てます。動画の最初のフレームの生成、キャラクターの一貫性の維持、アニメーション前のシーンアセットの構築、そして1つのヒーロー画像をソーシャルフォーマットに適応させることです。
Midjourney V8.2とは?(基本を超えて)
Midjourneyは、テキストプロンプト、画像リファレンス、スタイル指示から高品質なビジュアルを作成するために使用されるAI画像生成ツールです。Midjourney V8.2はその基盤の上に構築されており、より信頼性の高いビジュアル出力を必要とするクリエイター向けに、より強力な美学、より優れた画質、そして向上したパーソナライズ機能を提供します。
コアなアップグレード:よりシャープな美学とコントロール
Midjourney V8.2の最も重要な機能の中には、より強力な美学、より優れた画質、そして向上したパーソナライズ機能があります。単にシャープな画像を追い求めるだけでなく、制作アセット全体で一貫したビジュアルの方向性が必要な場合に、V8.2はより有用です。
V8.1と比較してどうでしょうか?V8.1は驚異的なフォトリアリズムを導入したものの、時折「プラスチックのようなAI感」に悩まされ、複雑なプロンプトへの追従に苦戦することがありました。V8.2はこれを修正します。V8.1と比較して、V8.2は「生成の失敗」率を大幅に削減します。映画フィルムの粒子や生地の織り目のようなマイクロテクスチャをV8.1よりもはるかに良く理解し、何十回も再生成することなく、レイアウトの指示に厳密に従います。
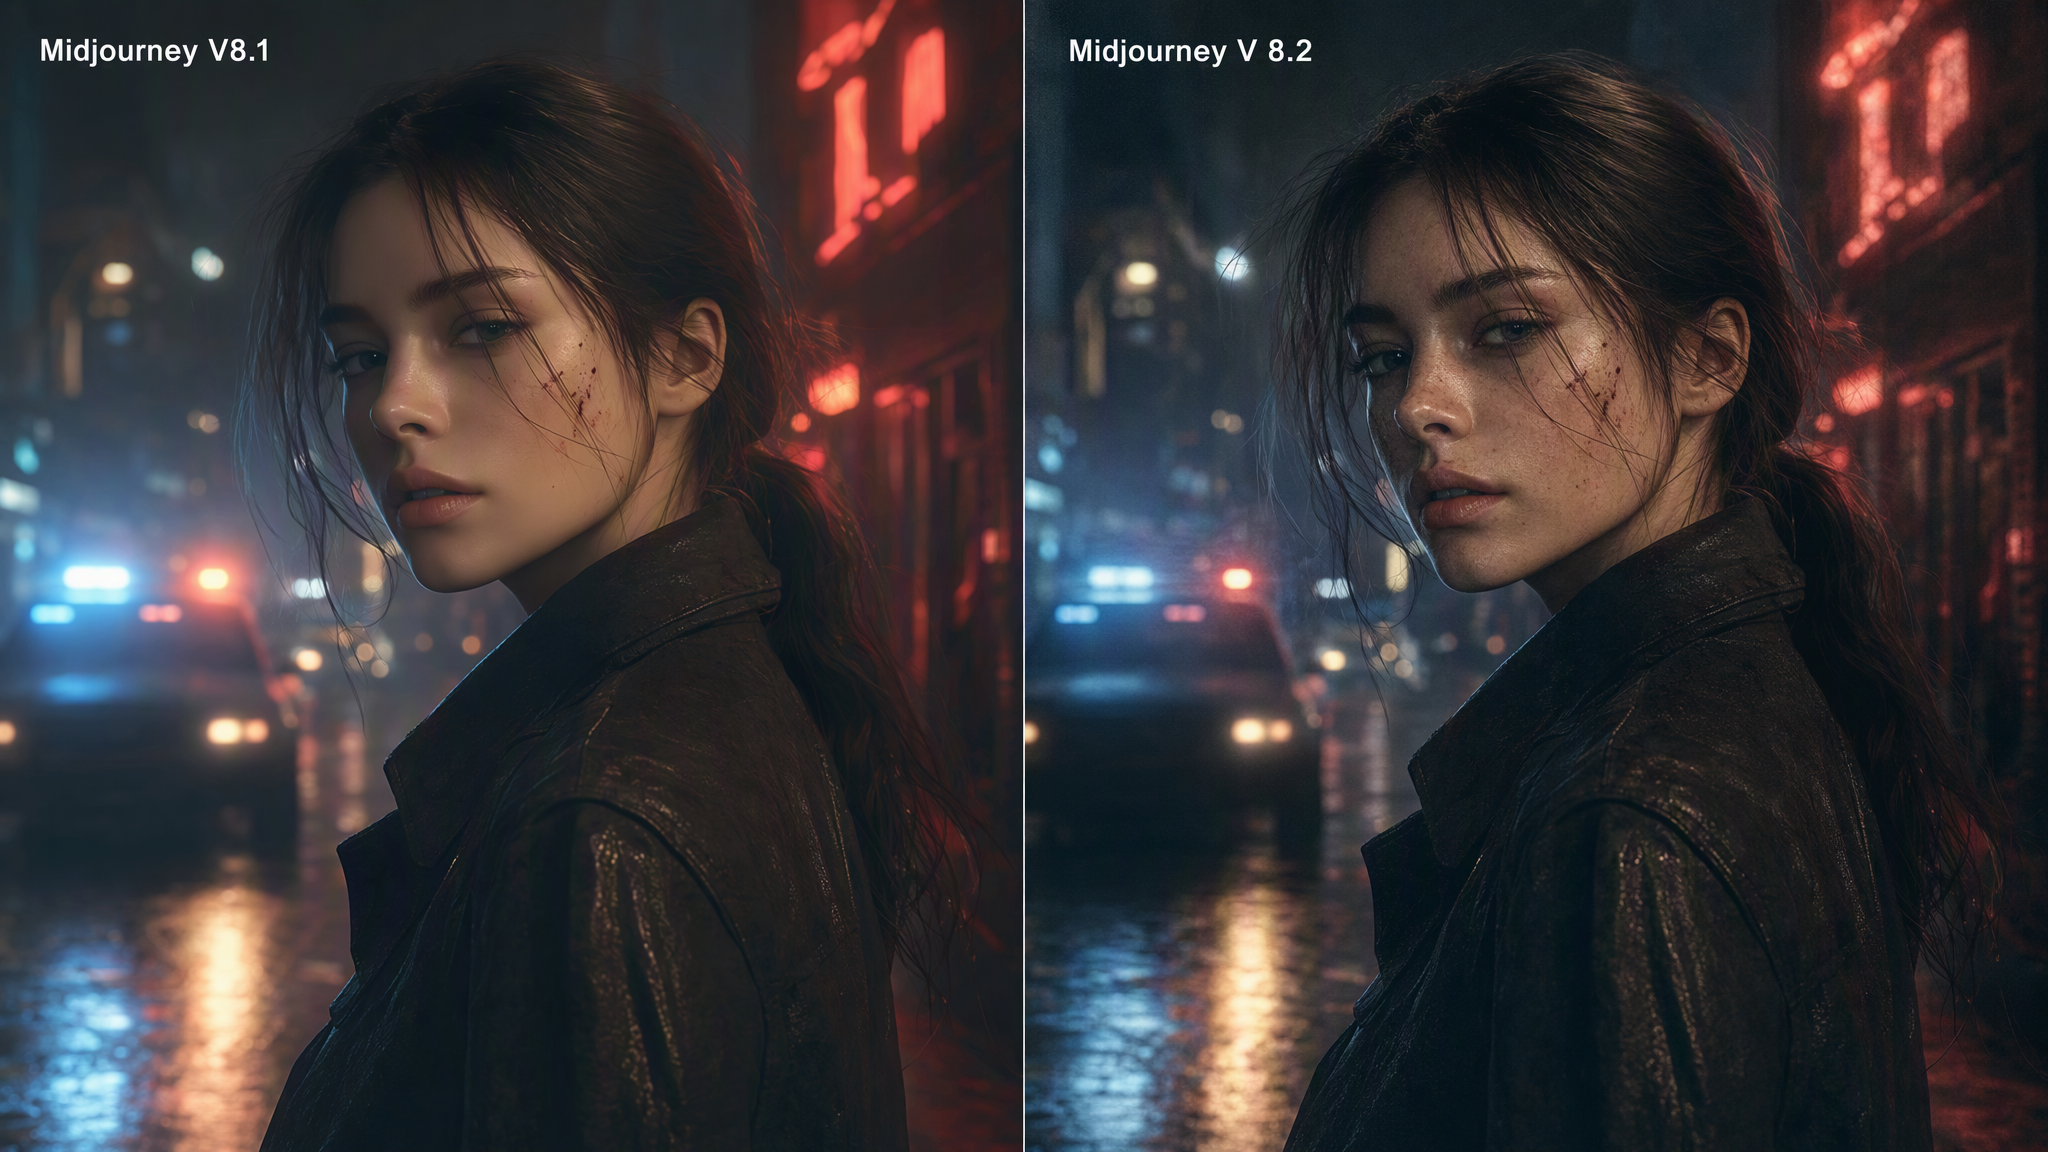
実際の制作ワークフローにおいてV8.2が重要である理由
プロフェッショナルな現場において、画像が最終製品になることはほとんどありません。それはアセットです。ランディングページのヒーロー背景を生成する場合でも、Seedance、Runway、Klingなどの動画モデルに画像を投入する場合でも、出力の品質は入力の品質に完全に依存します。シャープで解剖学的に正確、かつ高度に様式化された画像を生成するV8.2の能力は、下流のAIタスクにとって究極の基盤となります。
ハック1:動画を生成する前に最初のフレームを構築する
モデルを切り替える前に画像を確認する
顔が崩れたり、衣装が変わったり、背景が歪んだりする場合は、まず最初のフレームを確認します。被写体は鮮明ですか?手や小道具は正しく見えますか?意図した動きのためのスペースはありますか?
だからこそ、私は動きを生成する前に、Midjourney V8.2を使用してキャラクター、設定、照明を確立します。これらの決定を分けることで、ソース画像のレビューが容易になります。
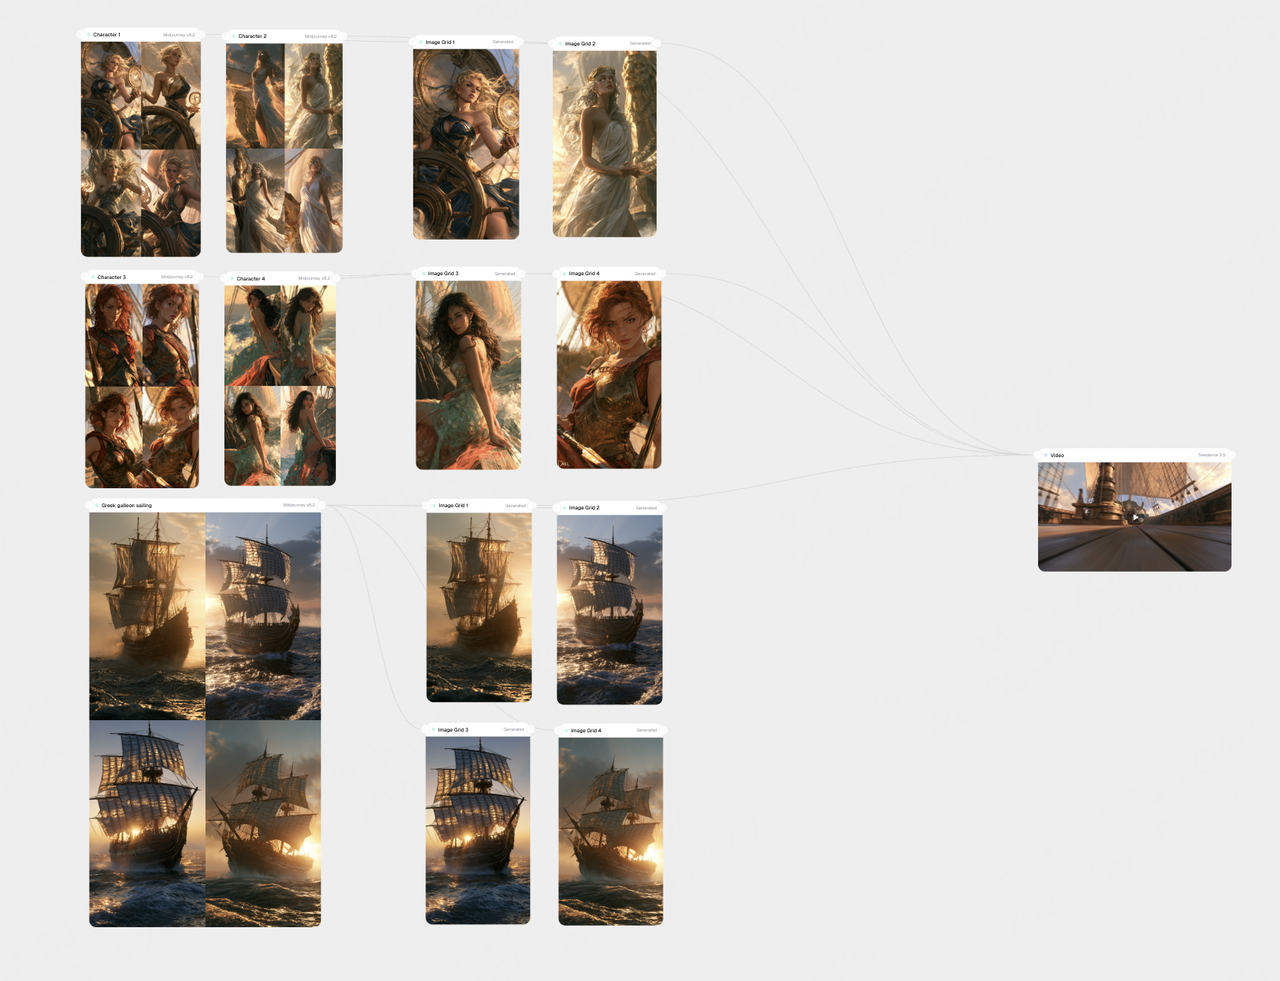
船のトランジションの例は、このアプローチに従っています:
| 次元 | 説明 |
| 目標 | 複数キャラクターが登場する船のシーンのために、判別しやすい最初のフレームを用意する。 |
| プロセス | V8.2でキャラクター、船、シーンのオプションを生成し、選択した画像をSeedance 2.5に接続する。 |
| メリット | 目に見える問題を動画生成に持ち込む前に、外観、デッキの構造、照明を確認する。 |
| 例 | 複数のキャラクター、詳細な衣装、複雑なデッキがある場合、被写体の重なり、パースペクティブ、トランジションのためのスペースを確認する。 |
プロンプトでこれら4つの事項を明確にする
私は「映画のような」や「非常に詳細な」という表現を超えて、ショットの構造を描写します。
| 要素 | 指定および確認すべきこと |
| 被写体 | 人数、位置、開始ポーズ。顔、手、小道具を検査する。 |
| 空間 | 奥行き、シーンの構造、動きの方向におけるスペース。 |
| 照明 | 主光源の方向とパレット。被写体と設定全体で一貫していること。 |
| スタイル | キャラクターと背景全体で一致する素材とリアリズム。 |
私のアドバイスは、複雑なカメラワークを追加する前に、シンプルなアクションをテストすることです。明確な最初のフレームは不確実性をある程度軽減しますが、動きの複雑さやモデルの能力は依然として安定性に影響を与えます。
ハック 2:カットを増やす前にキャラクターを定義する
戦闘シーンの前にリファレンスを作成する
ドラマチックなアクションを計画する前に、次の画像でもキャラクターが同一人物に見えるかどうかを確認します。カット間で顔、髪型、または服装が変わってしまうと、いくら美しいフレームであっても使用するのが難しくなります。
2人の剣士の例では、V8.2がキャラクターのリファレンスを提供します。アクション、設定、カメラアングルを変更する間、以下の詳細を固定したままにします。
| 固定する詳細 | 長髪の剣士 | 短髪の剣士 |
| 髪型 | 長い黒髪 | 短い黒髪 |
| 服装 | 重ね着した青黒い着物 | オフホワイトのトップスと暗い色の袴 |
| 佇まい | 静かで控えめ | 直立して落ち着いている |
| 顔と小道具 | 選択したリファレンスに一致させる | リファレンスに一致させつつ、区別できるようにする |
| ビジュアルスタイル | 共通のシネマティックなリアリズム | 共通のシネマティックなリアリズム |
シーケンスを構築する前にいくつかのカットをテストする
3つのステップでリファレンスを展開します:
- キャラクターを確認する: 正面、横顔、全身のビューを生成し、顔、髪型、服装を比較します。
- 設定を一致させる: 雨の寺院、濡れた石、ブルーグレーの照明の一貫性を保ちます。
- アクションをテストする: 共同の戦闘カットを試みる前に、刀を抜く動作や振り向く動作から始めます。
ここでのV8.2の役割は、キャラクターデザインとリファレンスの作成であり、自動的なアイデンティティのロックではありません。絵コンテを広げる前に、2、3のカットが連続しているように感じられるようにすることをお勧めします。
ハック 3:複数被写体のアクションの前にシーンキットを用意する
キャラクター、動物、設定を分離する
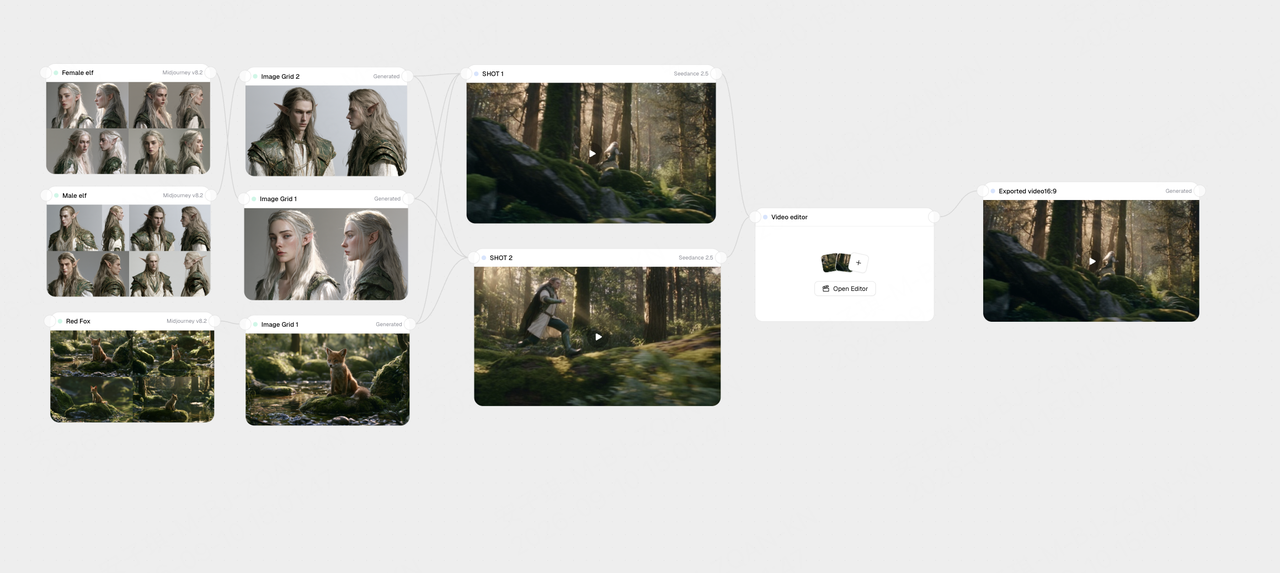
「森の中でキツネを追いかける2人のエルフ」には、キャラクターデザイン、動物の比率、シーンのレイアウト、動きなど、いくつかの決定事項が含まれています。
まずMidjourney V8.2を使用して静的アセットを確立します。森での追跡の例は4つの部分に分解されます:
| アセット | 確立するもの |
| 女性のエルフ | 髪型、尖った耳、服装、そしてシルエット。 |
| 男性のエルフ | 明確なキャラクターの特徴を持ちつつ、一致したスタイル。 |
| 赤ギツネ | 毛並みの色、体の比率、そして尻尾の形。 |
| 森 | 走る経路、木々の配置、そして光の方向。 |
ビデオを生成する前に、アセットを並べて比較します。それらは同じ映画に属しているように見えますか?森は追跡に使用できるスペースを提供していますか?
追跡を短いカットに分割する
ビデオモデルがすべてのアセットを自動的に組み立てることを期待するのではなく、カットごとにシーン画像または最初のフレームを用意します。
| ショット | アクション |
| キツネ | 明確な方向に向かって小道を走っている。 |
| エルフ | 一致するライティングと画面の方向で追従している。 |
| 共有フレーム | 彼らの相対的な位置関係を確立する必要があるときに、3人全員を表示する。 |
私のアドバイスは、1つの被写体と1つのアクションから始めることです。短いショットにすることで、チェイス全体を再構築することなく、失敗した瞬間を簡単に修正できます。
ハック4:スタイルの前にサムネイルのレイアウトを計画する
まずヘッドラインをどこに配置するかを決める
スタイルを選ぶ前に、私はこう問いかけます。視聴者が最初に気づくべきものは何か?ヘッドラインはどこに配置されるか?スマートフォンのサイズでも読めるか?
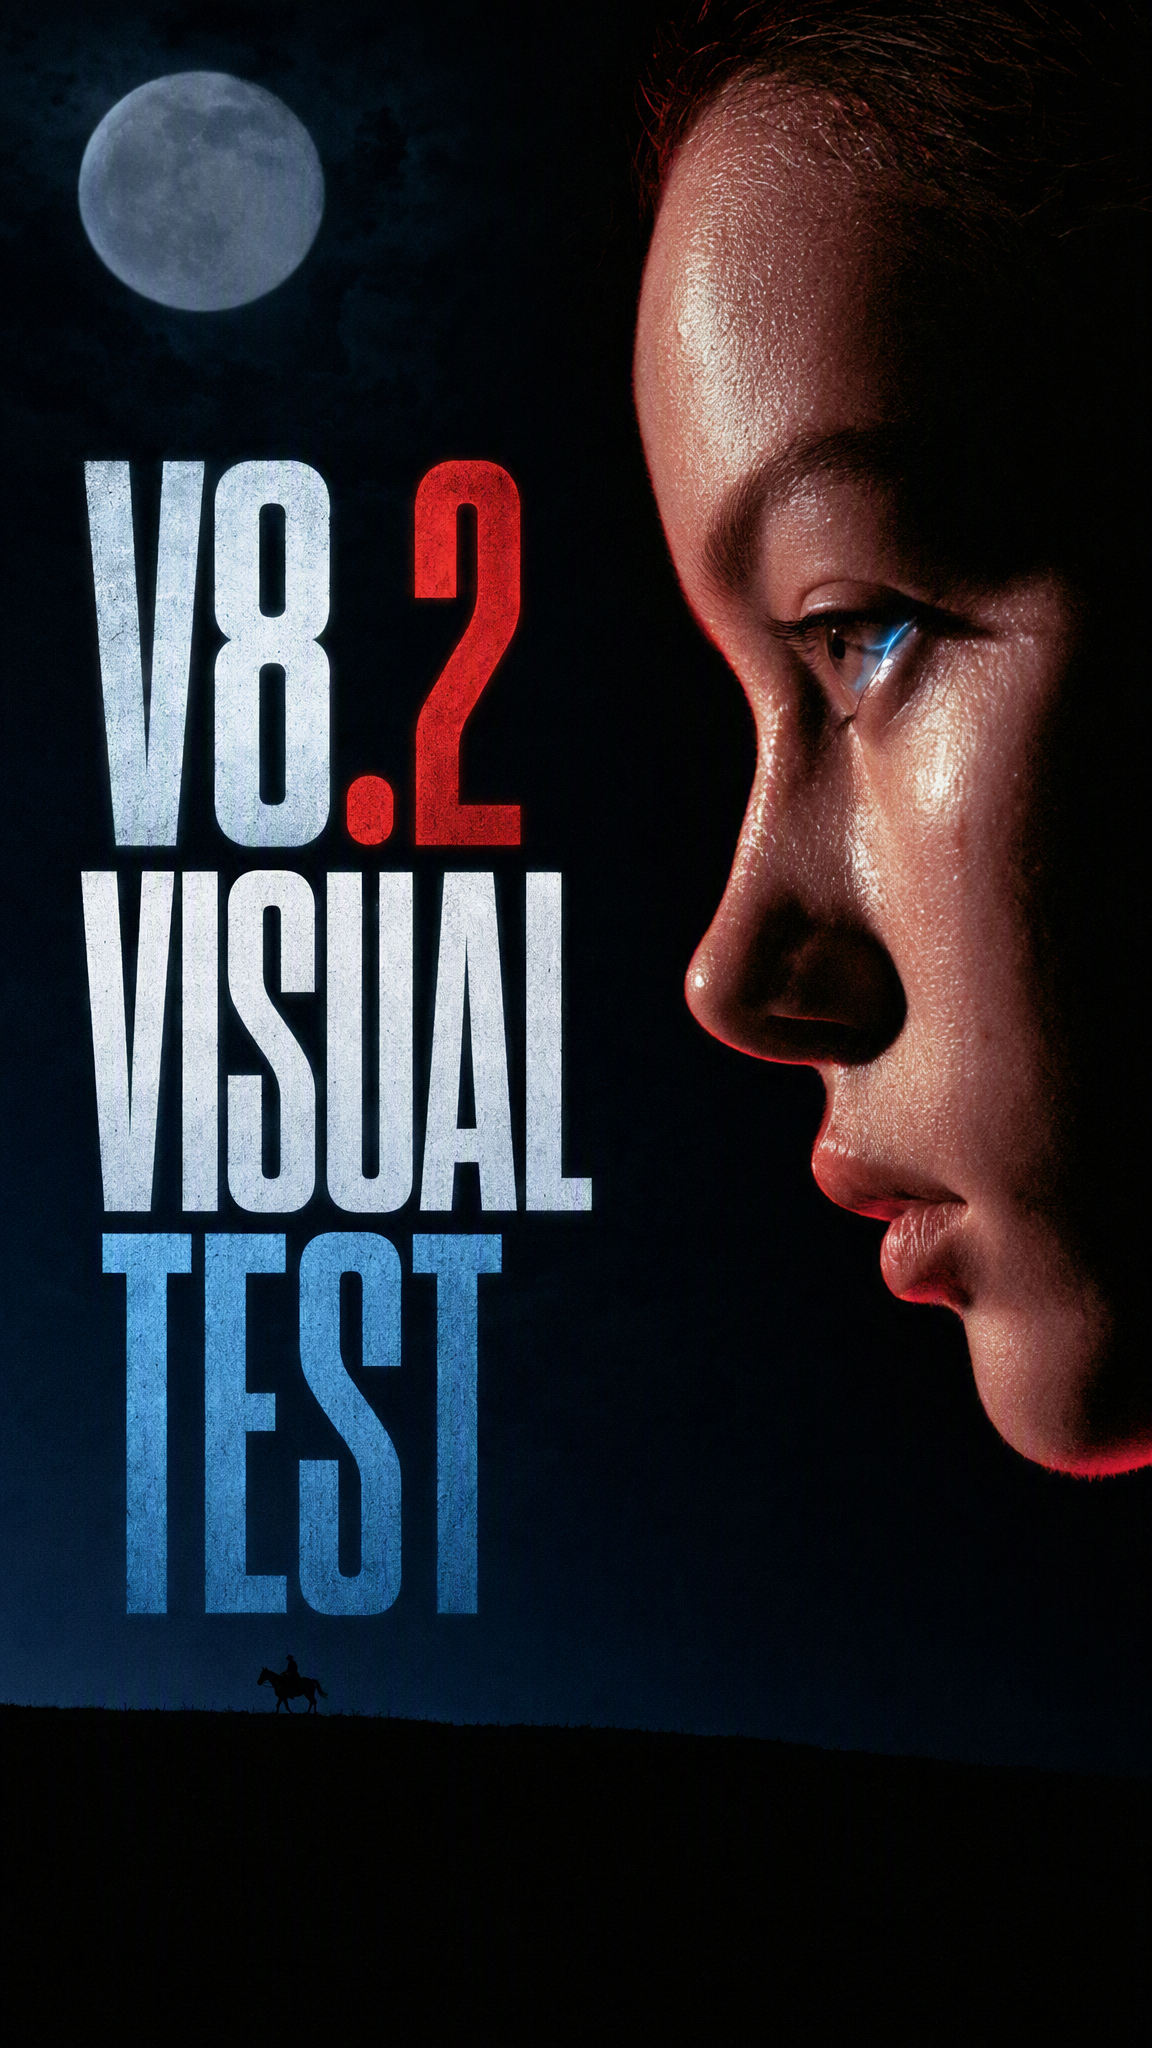
ヒーロービジュアルでは、顔と赤青のライティングを右側に配置し、左側にテキスト用の暗い領域を残します。美的なディテールを追加する前に、Midjourney V8.2でそのレイアウトを指定します。
| 要素 | 確認すべきこと |
| 被写体 | 気が散るような背景のない、1つの明確な焦点。 |
| 表情とコントラスト | コンテンツに関連する感情と、明確な被写体の分離。 |
| ヘッドラインのスペース | 顔を覆わない、計画されたテキスト領域。 |
| 縮小サイズでの視認性 | 被写体が認識でき、タイトルが読める縮小プレビュー。 |
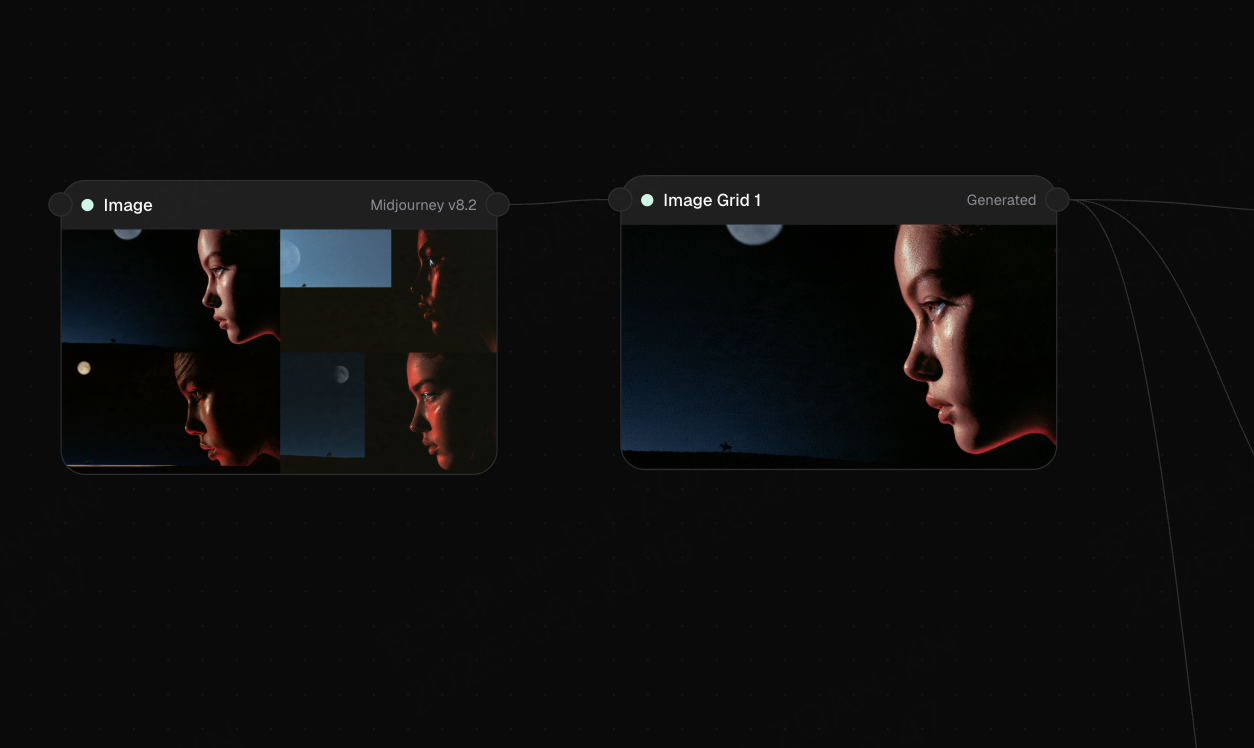
文言、タイポグラフィ、配置をコントロールするために、レイアウト中に最終的なヘッドラインを追加します。
プラットフォームごとにビジュアルを再構成する
サイズ変更を完成したデザインとして扱うのではなく、被写体、ライティング、パレットを維持します。
| プラットフォーム | 主な調整 |
| YouTube | 16:9を使用し、顔と短いヘッドラインを強調し、サムネイルの視認性を確認する。 |
| X | 投稿プレビューに合わせてクロップを調整する。投稿のテキストを不必要に繰り返さないようにする。 |
| TikTok / Shorts | 縦方向に再構成し、顔やヘッドラインがインターフェースのオーバーレイと重ならないようにする。 |
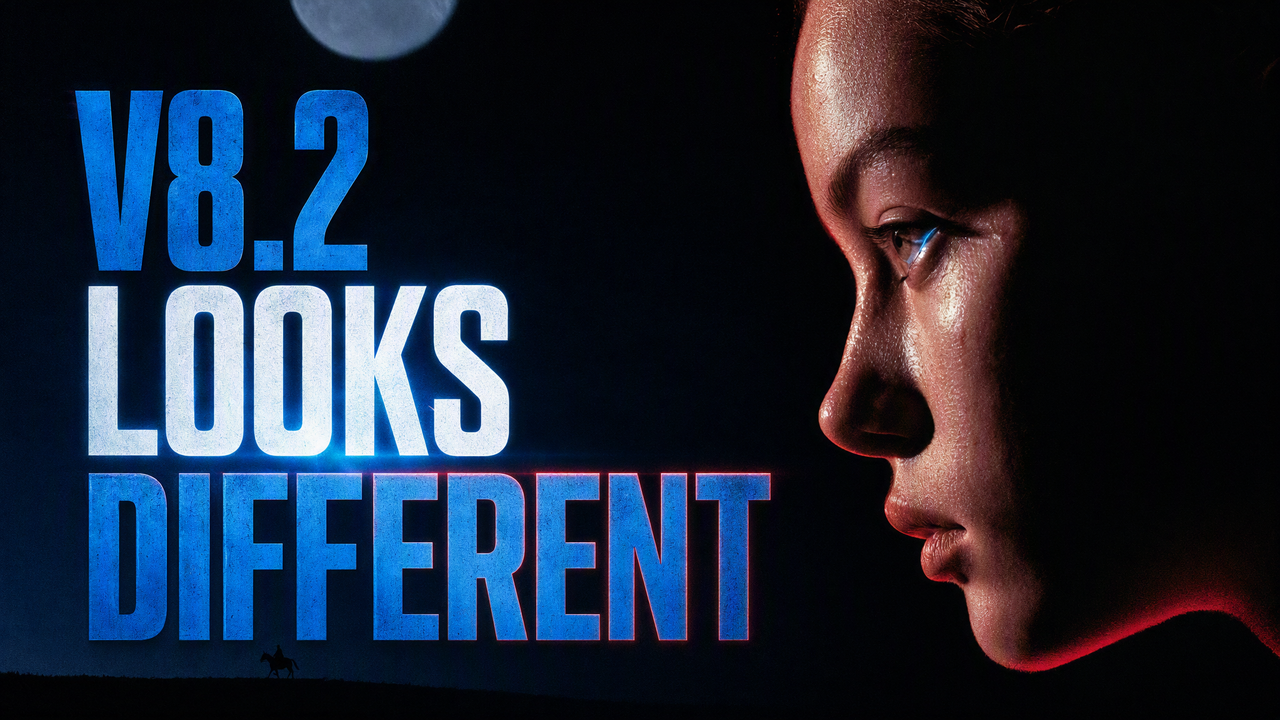
縦方向のクロップで重要な情報が失われる場合は、無理に合わせるのではなく再構成します。まずメインの公開フォーマットを完成させ、その後で他のフォーマットに適応させます。
マルチモデルAIワークフローのために Framia 内で Midjourney V8.2 を使用する
Midjourney を直接使用するか、ワークフロー内で使用するか?
画像だけが必要な場合は、Midjourney を直接使用することを検討します。それらの画像にアニメーション、編集、フォーマット適応も必要な場合は、それらの後続ステップも決定に含めます。
| 比較 | Midjourney を直接使用 | Framia 内で使用 |
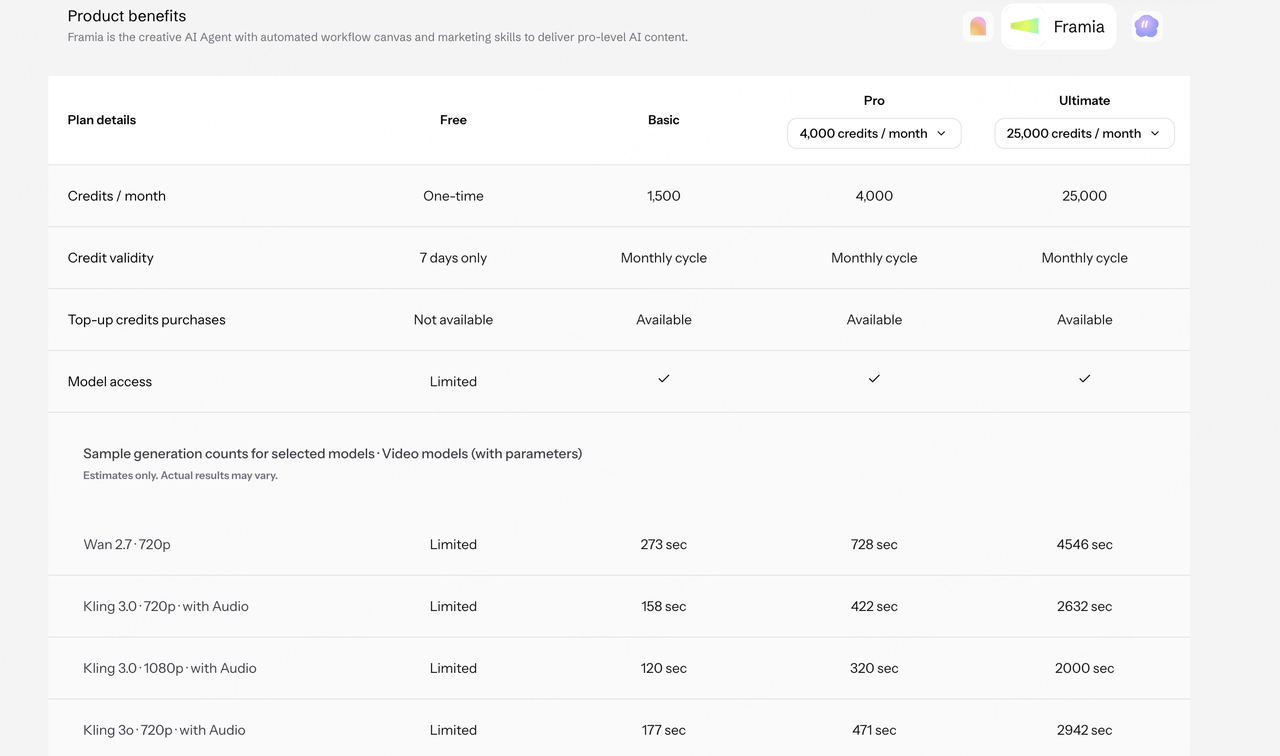
| 課金 | プラン固有の生成枠とモードを備えたサブスクリプション。 | サブスクリプションプランでクレジットが提供され、使用量はモデルとタスクの設定によって異なります。 |
| 月額料金の参考* | Basic \(10; Standard\)30; Pro \(60; Mega\)120. | 下書きでは Basic が \(20、Pro が \)40、Ultimate が $190 となっています。現在の価格と対応するクレジット枠は確認が必要です。 |
| V8.2 タスクあたりのコスト | 月額料金だけでなく、プラン、生成モード、使用状況によって異なります。 | 製品内で V8.2 タスクに表示されるクレジット消費量を確認してください。 |
| 他の動画モデルの使用 | Seedance や Kling などの外部モデルに移行するには、アセットの転送とそれらのコストの考慮が必要です。 | この例では、V8.2 画像を Seedance 2.5 に接続し、その後に編集を行います。 |
| 最適な用途 | 既存のポストプロダクション環境がある、画像中心の作業。 | 画像生成、動画作成、編集を1つのワークフローに整理する。 |
価格は下書きから維持されており、公開前に確認が必要です。以下を参照してください:Midjourney の公式プラン比較。価格、枠、V8.2 のクレジット使用量については、Framia の現在のインターフェースを確認してください。
月額料金だけで比較するべきではありません。より有用な指標は、再試行、動画生成、編集を含む、同じコンテンツを完成させるための総コストです。
V8.2 画像から Framia での完成した動画まで
これまでのハックでは、最初のフレーム、キャラクター、シーンの準備方法について説明しました。この例では、よりシンプルなこと、つまりFramiaでどこから始めるべきか、そして画像がどのようにビデオプロジェクトに適合するかに焦点を当てます。
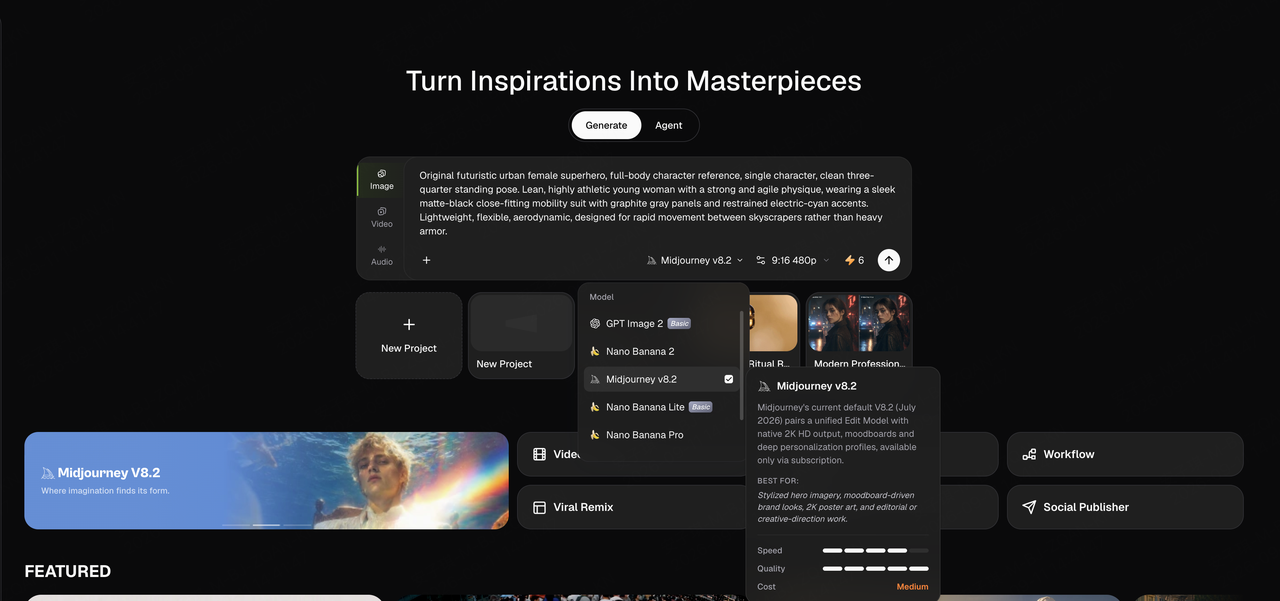
1. Midjourney V8.2を選択し、開始画像を生成する
Framiaの生成(Generate)ページで、画像(Image)を選択し、Midjourney v8.2を選択し、プロンプトを入力し、アスペクト比を設定してから生成します。ここに表示されているプロンプトは、未来的な都市の女性スーパーヒーローの全身キャラクターリファレンスを説明しています。
2. プロジェクトキャンバスで続行する
開始画像と下流のビデオステップを一緒にプロジェクトキャンバスに表示します。生成テクニックを繰り返すのではなく、このビューを使用して、どの画像がビデオワークフローに供給され、その出力がどこに表示されるかを示します。
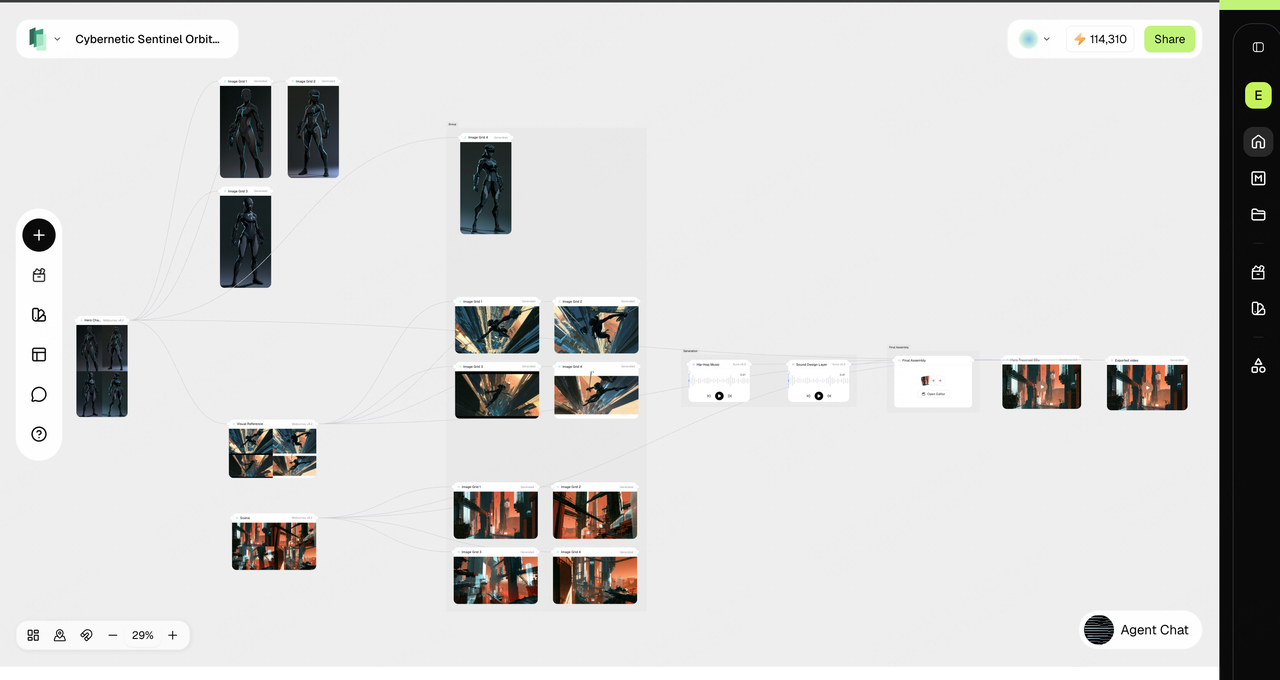
- 完成したビデオを見る
このプロジェクトの最終ビデオを以下に示します。開始画像と比較して、キャラクターデザイン、ビジュアルスタイル、構図がどのように動きに引き継がれているかを確認してください。
あなた自身のシーンで試してみてください。まずFramiaワークスペースでV8.2画像を生成し、それを短いビデオの開始点として使用します。
各ワークフローに最適なMidjourney V8.2プロンプトテンプレート
これらのテンプレートを開始点として使用し、括弧内の詳細を置き換え、結果を確認した後に洗練させることをお勧めします。最初の4つは画像プロンプトで、最後は下流のビデオテスト用のブリーフです。
| ワークフロー | プロンプトテンプレート | 使用方法 |
| ビデオの最初のフレーム | [設定]における[被写体]のシネマティックスチル、[開始ポーズ]、[ショットサイズとカメラアングル]、動きのための[方向]に向かって開いたスペース、明確な被写体のシルエット、[照明の方向]、[ビジュアルスタイル]。 | アクションの前の瞬間を説明します。動きの指示はビデオプロンプトに入力してください。 |
| キャラクターリファレンス | [キャラクタータイプ]の[全身 / ポートレート]リファレンス画像、[見た目の年齢と顔の形]、[ヘアスタイル]、[固定の衣装]を着用、[特徴的な小道具]を所持、自然な立ちポーズ、ニュートラルな背景、[ビジュアルスタイル]。 | アイデンティティの詳細を固定したまま、後のショットのためにポーズ、設定、カメラアングルを変更します。 |
| シーンキット | [シーンタイプ]用の[キャラクター / 動物 / 環境]、[外観または空間的特徴]、[素材とパレット]、[照明の方向]、[構図]、[共有ビジュアルスタイル]。 | 同じスタイル、パレット、照明の説明を維持しながら、一度に1つのアセットタイプを生成します。 |
| ソーシャルサムネイルまたはカバー | [プラットフォーム]用のキービジュアル、[フレーム内の位置]に配置された[被写体]、[表情またはフォーカルポイント]、強い被写体と背景のコントラスト、[エリア]内のクリーンな見出しスペース、シンプルな背景、テキストなし。 | ターゲットのアスペクト比は別途設定し、レイアウト時に見出しを追加します。 |
| マルチモデルビデオテスト | [モデルA / モデルB]で同じ最初のフレームを使用して、[被写体のアクション]と[カメラの動き]をテストします。サポートされている場合は、長さ、アスペクト比、解像度を一致させます。キャラクターの外観、動きの連続性、背景の安定性を比較し、設定と使用状況を記録します。 | これはテスト用のブリーフであり、Midjourneyの画像プロンプトではありません。関連するビデオツールで実行してください。 |
アスペクト比、画像リファレンス、モデルパラメータは個別に設定します。プロンプトの説明は出力をガイドしますが、レビューの代わりにはならず、キャラクターのアイデンティティを自動的にロックすることもありません。
結論
私はMidjourney V8.2を開始点として捉えています。ビデオやソーシャルコンテンツに移行する前に、最初のフレーム、キャラクター、設定を確立します。プロジェクトでビデオの生成や編集も必要な場合、Framiaの例は、それらの段階がどのように1つのプロジェクトに適合するかを示しています。私のアドバイスは、1つの画像を短いショットにし、結果と使用状況を確認してから、完全な作品に向けて構築していくことです。
Midjourney V8.2に関するよくある質問
Midjourney V8.2の画像をAIビデオの最初のフレームとして使用できますか?
はい。特に被写体、照明、構図が明確な場合、強力なMidjourney V8.2画像はSeedance、Kling、またはRunwayの最初のフレームとして機能します。
Midjourneyの画像から開始した後にAIビデオが変形するのはなぜですか?
ほとんどの変形は、不安定な解剖学的構造、混雑した背景、曖昧な動きの方向、または細かすぎるディテールなど、不明確な入力から生じます。
Midjourneyを単独で使用するのではなく、Framia内でMidjourney V8.2を使用するのはなぜですか?
Midjourney V8.2はソース画像の生成に優れています。Framiaは、同じ画像をSeedance、Kling、またはRunwayでテストし、出力を比較し、結果を確認し、アセットを1か所でエクスポートするというワークフローを継続したい場合に便利です。
Midjourney V8.2はどのような用途に最適ですか?
まずMidjourney V8.2で鮮明なソース画像を生成し、それをSeedance、Kling、Runwayなどの動画モデルで最初のフレーム、キャラクターリファレンス、またはシーンアセットとして使用します。これにより、テキスト単体よりも強力な視覚的ベースを動画モデルに提供できます。
AI動画ワークフローでMidjourney V8.2を使用する方法は?
まずMidjourney V8.2で鮮明なソース画像を生成し、それをSeedance、Kling、Runwayなどの動画モデルで最初のフレーム、キャラクターリファレンス、またはシーンアセットとして使用します。これにより、テキスト単体よりも強力な視覚的ベースを動画モデルに提供できます。





