Teilen


- KI-Videogenerierungsmodelle verwandeln einen Text-Prompt, ein Bild oder einen vorhandenen Ich habe meine Farben gespeichert,Clip durch einen Diffusionsprozess, der zufälliges Rauschen Schritt für Schritt verfeinert, bis es Ihrer Beschreibung entspricht, in neues Bildmaterial.
- Fünf Closed-Source-Modelle führen derzeit das Feld an, jedes mit einer anderen Stärke: Veo 3.1 (natives Audio), Runway Gen-4.5 (kreative Kontrolle), Seedance 2.5 (lange Single-Take-Clips), Kling 3.0 (physikalisch genaue Bewegung) und MiniMax H3 (einheitliche multimodale Eingabe).
- Wan 2.2, Mochi und HunyuanVideo bieten Ihnen mehr Kontrolle und keine Nutzungslimits, aber Sie benötigen stärkere Hardware und etwas Einrichtungszeit.
- Framia Pro bringt mehrere dieser Modelle in einem Dashboard zusammen, sodass Sie zwischen ihnen wechseln können, ohne mit separaten Logins und Abonnements jonglieren zu müssen.
Was sind KI-Videogenerierungsmodelle?
KI-Videogenerierungsmodelle sind Systeme, die Videos aus einem Prompt, einem Bild oder einem vorhandenen Clip erstellen, ohne dass eine Kamera oder ein Team beteiligt ist.
Sie lernen aus riesigen Datensätzen, Millionen von Videoclips gepaart mit Beschreibungen, und erfassen die visuellen Muster, die eine Phrase wie „ein Hund, der durch den Schnee rennt“ mit dem verbinden, was tatsächlich auf dem Bildschirm zu sehen ist.
Die Technik dahinter nennt sich Diffusion. Das Modell beginnt mit zufälligem Rauschen und bereinigt es über Dutzende von Schritten, bis ein Video entsteht. Während des Trainings hat es beobachtet, wie echte Videos in Rauschen zerfallen, und gelernt, diesen Prozess umzukehren. Bei der Generierung steuert Ihr Prompt jeden Bereinigungsschritt hin zu der von Ihnen beschriebenen Szene.
Der schwierige Teil ist nicht ein einzelnes Bild. Es geht darum, Hunderte von Bildern konsistent miteinander zu halten. Ein Gesicht, ein Outfit oder ein Schatten muss über den gesamten Clip hinweg stabil bleiben und darf nicht nur isoliert betrachtet richtig aussehen.
Videomodelle verarbeiten ganze Bildsequenzen zusammen, sodass sich jedes Bild auf die anderen beziehen kann. Aus diesem Grund erfordert die Videogenerierung weitaus mehr Rechenleistung als ein einzelnes Bild.
Welche verschiedenen Arten von KI-Videomodellen gibt es?
Bevor ich mit dem Testen begann, musste ich herausfinden, welche Art von Tool ich eigentlich verwendete, da nicht jeder KI-Videogenerator am selben Punkt ansetzt.
Text-zu-Video-KI-Modelle
Text-zu-Video-Modelle verwandeln eine schriftliche Beschreibung von Grund auf in eine bewegte Szene. Sie schreiben, was Sie möchten, und das Modell erstellt das Bildmaterial. Dies eignet sich am besten, wenn Sie eine Idee, aber kein Ausgangsmaterial oder Referenzbild haben, wie z. B. ein Produktkonzept, ein kurzes Story-Element oder eine Szene.
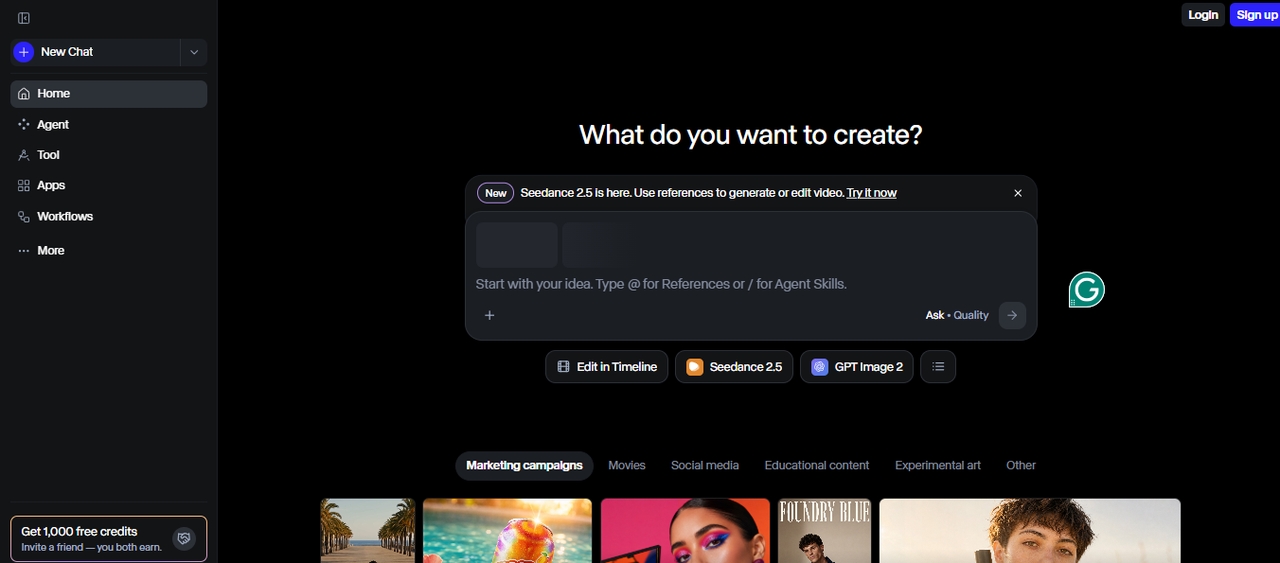
Bild-zu-Video-Modelle
Bild-zu-Video-Modelle gehen von einem Bild aus, das Sie bereits haben, und fügen Bewegung, Kamerabewegungen oder kleine Änderungen hinzu, um es zum Leben zu erwecken. Dies eignet sich für Produktdemos und Social-Media-Beiträge, bei denen Sie schnelle Bewegungen wünschen, ohne alles von Grund auf neu zu generieren.
Multimodale Videomodelle
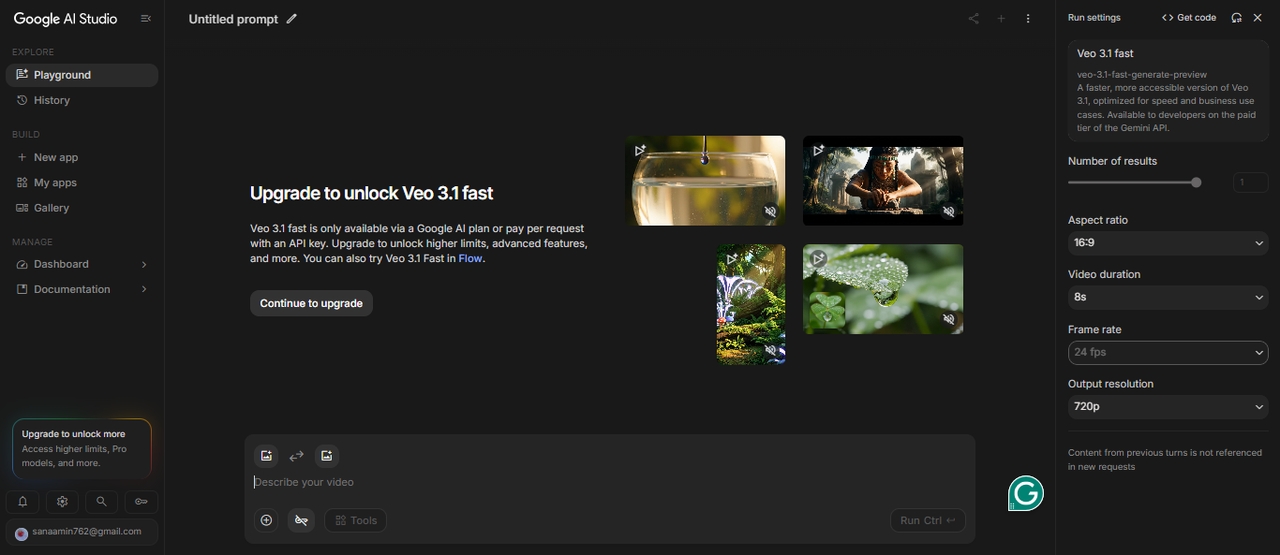
Diese Modelle arbeiten mit mehr als einer Art von Eingabe gleichzeitig. Sie können Text, Bilder, Audio und sogar vorhandene Videoclips mischen, um das Endergebnis zu steuern.
Dies gibt Ihnen mehr Kontrolle darüber, wie das Video am Ende aussieht. Sie beschreiben nicht nur eine Szene, sondern gestalten sie mit mehreren Eingaben. Diese Kontrolle hilft, wenn Sie bestimmte Details, ein flüssigeres Storytelling oder ein Video wünschen, das einer klaren Richtung folgt.
Wie wir jedes Modell getestet haben
Ich bin Content-Stratege und habe die letzten zwei Jahre damit verbracht, meinen Lebensunterhalt mit dem Testen von kreativen KI-Tools zu verdienen, und ich habe jedes KI-Videogenerierungsmodell mit denselben fünf Prompts getestet, die eine Produktdemo, eine kurze narrative Szene, einen Talking-Head-Clip, eine Actionsequenz und ein stilisiertes Kunstwerk umfassen.
Für jedes Modell habe ich mindestens drei Ergebnisse pro Prompt generiert und diese in den Bereichen Realismus, Bewegungsgenauigkeit, Prompt-Treue und Audioqualität (sofern zutreffend) bewertet.
8 KI-Videogenerierungsmodelle, und was jedes am besten kann
Nach dem Testen von acht KI-Videogenerierungsmodellen in den Bereichen Produktdemos, narrative Szenen, Talking-Head-Clips, Actionsequenzen und stilisierte Visuals habe ich festgestellt, dass kein einzelnes Modell in jeder Kategorie am besten abgeschnitten hat. Veo 3.1 stach durch natives Audio hervor, Runway Gen-4.5 durch kreative Kontrolle und Szenenkonsistenz und Seedance 2.5 durch längere Single-Pass-Clips. Kling 3.0 war eine starke Option für bewegungsintensive Szenen, während MiniMax H3 mit gemischten Eingaben und synchronisiertem Audio umging. Wan 2.6, Mochi und HunyuanVideo boten Alternativen für Benutzer, die Open-Weight-Modelle und lokale Workflows bevorzugen, obwohl Hardwareanforderungen und Einrichtung limitierende Faktoren sein können.
Diese Ergebnisse basieren auf meinen praktischen Tests, nicht auf einer universellen Rangliste. Die beste Wahl hängt von Ihrem Videotyp, den Ausgabeanforderungen, dem Budget und davon ab, ob Sie einen gehosteten Dienst oder ein Modell bevorzugen, das Sie selbst ausführen können.
Im Folgenden schlüssele ich die Stärken, Funktionen, Vor- und Nachteile jedes Modells auf, um Ihnen bei der Auswahl des richtigen Modells für Ihr Projekt zu helfen.
Unten finden Sie die besten Closed-Source-Modelle, die Sie jetzt kennen sollten.
| Funktion | Veo 3.1 | Runway Gen-4.5 | Seedance 2.5 | Kling 3.0 | MiniMax H3 |
| Max. Auflösung | 1080p | 1080p | 1080p nativ | 4K / 60fps, erstes Modell, das natives 4K bei 60fps erreicht | 2K bei 24fps, 768p ebenfalls verfügbar |
| Max. Cliplänge | 8 Sekunden nativ, erweiterbar über Drittanbieter-Tools | Bis zu 16 Sekunden auf Gen-4 | Bis zu 30 Sekunden in einer einzigen kontinuierlichen Aufnahme | Bis zu 2 Minuten, erweiterbar auf 3 Minuten | 5–15 Sekunden, erweiterbar auf 30 mit dem integrierten Extend-Tool |
| Bildrate | 24–30fps | 24fps | Noch nicht veröffentlicht | 30fps | 24fps |
| Natives Audio | ✅ Dialog, SFX, Atmosphäre | ✅ Hinzugefügt Dez. 2025 | ✅ 10+ Sprachen | ✅ | ✅ Natives Stereo |
| Multimodale Eingabe | ✅ Bis zu 3 Bildreferenzen | ❌ | ✅ Bis zu 50 Referenzen, 30 Bilder, 10 Videos, 10 Audio | ✅ Text, Bild, Audio, Video | ✅ Text, Bild, Video und Audio werden als ein Kontext gelesen |
| Multi-Shot | ❌ | ✅ | ✅ Einzelne kontinuierliche Aufnahme, kein Zusammenfügen | ✅ Bis zu 6 Einstellungen | ❌ |
| Physik-Engine | ✅ | ❌ | Nicht angegeben | ✅ | Nicht angegeben |
| Schnell- / Entwurfsmodus | ✅ Veo 3 Fast | ✅ Gen-4 Turbo | Noch nicht veröffentlicht | ✅ Bis zu 20x schneller | ✅ Leichtere 768p-Option |
| Seitenverhältnisse | 16:9 und 9:16 | 16:9, 9:16, 1:1 | Noch nicht veröffentlicht | 16:9, 9:16, 1:1 | 21:9, 16:9, 4:3, 1:1, 3:4, 9:16 |
| Kostenlose Version | ❌ | ❌ | Wird auf Jimeng AI, Doubao, Dreamina eingeführt | ✅ 66 tägliche Credits | Über die Hailuo AI App |
| Am besten für | Realismus + Audio | Kinematografische Kontrolle | Lange Single-Take-Clips + Referenzen | 4K + Langformat | Multimodale Bearbeitung + Konsistenz |
- Veo 3.1
Veo 3.1 ist Googles Flaggschiff-Videogenerierungsmodell, und beim Audio hat es sich im Rest meiner Tests am meisten abgehoben. Es generiert Dialoge, Soundeffekte und Umgebungsgeräusche im selben Durchgang wie das Video, alles aus einem einzigen Prompt. Nach dem Start im Oktober 2025 wurde es zum Motor hinter einer Welle viraler Clips auf sozialen Plattformen, und seine Anbindung an Google Workspace machte es zu einer einfachen Ergänzung für die Teile meines Workflows, die bereits in diesem Ökosystem angesiedelt sind.
Funktionen
- Natives Audio: Dialog, SFX und Umgebungsgeräusche in einem Durchgang.
- 4K-Auflösung: bis zu Ultra-High-Definition-Ausgabe.
- Multi-Referenz: unterstützt bis zu 3 Referenzbilder.
- Lange Dauer: Erstellung von Ausgaben von bis zu einer vollen Minute.
- Prompt-Dialog: Schreiben Sie die Sprache der Charaktere direkt in Ihren Prompt.
Vorteile
- Unübertroffene native Audioqualität.
- Hervorragender Realismus und präzise Beleuchtung.
- Tiefe Integration in das Google-Ökosystem.
- Hohe Prompt-Genauigkeit.
Nachteile
- Videos mit Wasserzeichen in günstigeren Tarifen.
- Weniger flexibel für stilisierten oder nicht-realistischen Inhalt.
- Runway Gen-4.5
Runway ist seit Jahren eine feste Größe bei generativen KI-Videomodellen, und bei Gen-4.5, das Ende 2025 veröffentlicht wurde, ist mir der größte Sprung bei Qualität und Multi-Shot-Sequenzierung aufgefallen. Die Chat-Schnittstelle ermöglichte es mir, ein Video zu verfeinern, indem ich Änderungen im Gespräch beschrieb, anstatt den Prompt von Grund auf neu zu schreiben. Von allem, was ich getestet habe, ist dies das Modell, das ich einem kreativen Profi empfehlen würde, wenn es auf Szenen- und Charakterkonsistenz über mehrere Einstellungen hinweg ankommt.
Funktionen
- Motion Brushes: zeichnen Sie genau ein, welche Teile einer Szene sich bewegen sollen.
- Multi-Shot: verknüpfen Sie mehrere Clips zu einer zusammenhängenden Sequenz.
- Act-One: Mimik- und Bewegungserfassung.
- Chat-Bearbeitung: verfeinern Sie Ergebnisse durch natürliche Konversation.
- 4K-Ausgabe: Export in ultrahoher Auflösung.
Vorteile
- Klassenbeste Konsistenz von Szenen und Charakteren.
- Leistungsstarke kreative Steuerungsmöglichkeiten für Profis.
- Starke Community und starkes Ökosystem.
Nachteile
- Teuer in den höheren Tarifen.
- Langsamer als einige Konkurrenten bei der schnellen Erstellung von Social-Media-Inhalten.
- Steilere Lernkurve für Anfänger.
- Seedance 2.5
Seedance 2.5 ist der Nachfolger von ByteDance zu Seedance 2.0, das zuvor die Artificial Analysis Video Arena sowohl für Text-to-Video als auch für Image-to-Video Anfang 2026 angeführt hatte. Die neue Version verlängert die Single-Pass-Generierung von 15 Sekunden auf volle 30 Sekunden, wechselt zu nativem 1080p und akzeptiert bis zu 50 multimodale Referenzen (eine Mischung aus Bildern, Videos und Audio) in einer Generierung, verglichen mit 12 in der Vorgängerversion. Zudem bietet sie natives Audio in mehr als 10 Sprachen. Ich habe sie getestet, während sie auf Jimeng AI, Doubao und Dreamina eingeführt wurde, wobei der API-Zugriff über BytePlus ModelArk erfolgt.
Funktionen
- Erweiterte Single-Pass-Generierung: bis zu 30 Sekunden in einem kontinuierlichen Clip, kein Zusammenfügen erforderlich.
- Natives 1080p: eine Steigerung gegenüber 720p in der Vorgängerversion.
- Erweiterte Referenzunterstützung: bis zu 50 multimodale Referenzen (30 Bilder, 10 Videos, 10 Audiodateien) in einer Generierung.
- Natives mehrsprachiges Audio: Dialoge und Ton in über 10 Sprachen.
- Präzise Bearbeitung: tauschen Sie ein Produkt aus, verlängern Sie eine Aufnahme oder nehmen Sie eine gezielte Bearbeitung vor, ohne den gesamten Clip neu generieren zu müssen.
- 3D-Weißmodell-Prävisualisierung: planen Sie Kamerabewegungen und Einstellungen grob, bevor Sie eine vollständige Generierung starten.
Vorteile
- Lange Single-Take-Clips eignen sich gut für Kurz-Dramen und serielle Inhalte.
- Starke Kamera-Kontinuität von Einstellung zu Einstellung über eine gesamte 30-sekündige Aufnahme.
- Eine erweiterte Anzahl an Referenzen bietet mehr Kontrolle über die Konsistenz von Charakteren und Produkten.
Nachteile
- ByteDance hat noch keinen vollständigen technischen Bericht veröffentlicht, daher stammen einige Spezifikationen aus Launch-Demos und nicht aus unabhängigen Tests.
- Der vollständige API-Zugriff war zum Zeitpunkt des Tests noch nicht überall freigeschaltet.
- Kling 3.0
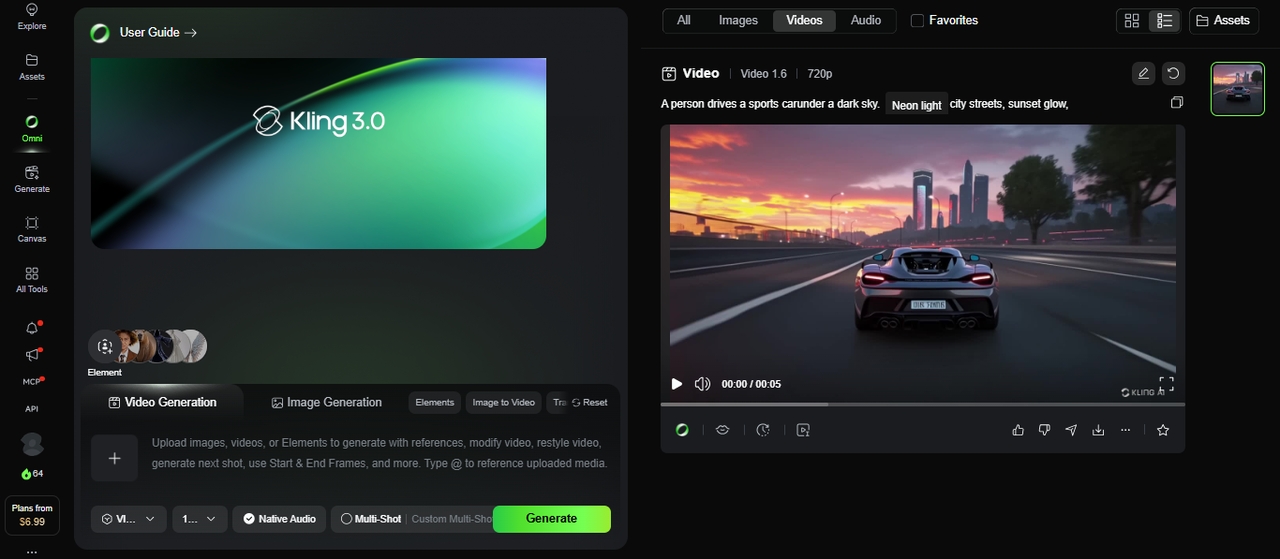
Kling 3.0 wurde am 4. Februar 2026 veröffentlicht und bereits nach wenigen Tagen als der größte Sprung in der KI-Videogenerierung des Jahres bezeichnet. Es basiert auf einer Omni One-Architektur, die 3D Spacetime Joint Attention mit Chain-of-Thought-Reasoning kombiniert. Dadurch wirkten Schwerkraft, Gleichgewicht, Verformung und Trägheit in meinen Tests realistisch statt gummiartig. Es verarbeitet multimodale Eingaben aus Text, Bildern, Audio und Video und generiert nativen Ton in Englisch, Chinesisch, Japanisch, Koreanisch und Spanisch, mit Kontrolle über den Charakterdialog und die Sprechreihenfolge.
Funktionen
- Omni One-Physik: echte Simulation von Schwerkraft, Kollision und Trägheit.
- Natives Audio: Voiceover, Lippensynchronisation, SFX und Musik.
- Multi-Shot-Storyboard: bis zu 6 Einstellungen mit Kamerakontrolle auf Regieniveau.
- Entwurfsmodus: bis zu 20-mal schnellere Generierung für schnelles Prototyping.
- 4K/60fps-Ausgabe: mit 16-Bit-HDR- und EXR-Export.
- 7-in-1-Editor: Hinzufügen von Objekten, Hintergrundwechsel, Stilübertragung in einem Tool.
Vorteile
- Die realistischste menschliche Physik und Bewegung, die derzeit verfügbar ist.
- Natives mehrsprachiges Audio mit Dialekt- und Akzentsteuerung.
- Günstiger Einstieg ab 7,99 $/Monat mit einem soliden kostenlosen Tarif.
- Exportiert direkt in professionelle VFX-Pipelines (Nuke, After Effects, DaVinci).
Nachteile
- Das Rendern eines 15-sekündigen Multi-Shot-Videos kann über 5 Minuten dauern.
- Die 4K-Ausgabe ist derzeit auf höherwertige Tarife beschränkt.
- Zeiten hoher Nachfrage verlängern die Render-Warteschlangen.
- MiniMax H3
MiniMax H3, auch bekannt als Hailuo 3.0, folgt auf Hailuo 02 im Video-Line-up von MiniMax. Anstatt Text-, Bild-, Video- und Audio-Referenzen als separate Eingaben zu behandeln, liest es alle zusammen als einen gemeinsamen Kontext und liefert dann synchronisierte Video- und Audio-Ergebnisse in einem einzigen Resultat. MiniMax hat angekündigt, die Modellgewichte veröffentlichen zu wollen, obwohl ich über die Hailuo AI-App, die MiniMax Open Platform API und Hosting-Partner wie fal darauf zugegriffen habe.
Funktionen
- Einheitlicher multimodaler Kontext: Text-, Bild-, Video- und Audio-Referenzen werden zusammen in einer einzigen Generierung aufgelöst.
- Natives Stereo-Audio: Dialoge, Musik, Effekte und Atmosphäre werden zusammen mit dem Video generiert, nicht erst nachträglich darübergelegt.
- Bis zu 2K-Auflösung bei 24fps, wobei 768p auch als ressourcenschonendere Option verfügbar ist.
- Generierungen von 5 bis 15 Sekunden, verlängerbar auf bis zu 30 Sekunden mit dem integrierten „Extend Video“-Tool.
- Gezielte Bearbeitung: Austauschen oder Entfernen von Charakteren und Objekten, Ändern von Beleuchtung oder Hintergründen oder Überarbeiten von Dialogen, ohne den gesamten Clip neu erstellen zu müssen.
- Mehrere Seitenverhältnisse: 21:9, 16:9, 4:3, 1:1, 3:4 und 9:16.
Vorteile
- Starke zeitliche Konsistenz; Bewegungen bleiben über den gesamten Clip hinweg stabil, anstatt zwischendurch abzuweichen.
- Natives Stereo-Audio entsteht im selben Generierungsdurchlauf, ohne separaten Tonschritt.
- Die Unterstützung breiter Seitenverhältnisse eignet sich für alles, von kinoreifem Breitbild bis hin zu vertikalen Social-Media-Inhalten.
Nachteile
- MiniMax hat noch keinen vollständigen technischen Bericht veröffentlicht, daher stammen einige Behauptungen eher vom Unternehmen selbst als aus unabhängigen Benchmarks.
- Das lokale Ausführen der Open-Weight-Version erfordert nach der Veröffentlichung der Gewichte eine High-End-GPU mit mindestens 24 GB VRAM.
| Funktion | Wan 2.2 | Mochi 1 (Genmo) | HunyuanVideo (Tencent) |
| Parameter | 1,3B / 14B | 10B | 13B |
| Maximale Auflösung | 720p (1080p bei 14B) | 480p (640x480) | 720p (1080p mit v1.5) |
| Maximale Cliplänge | Bis zu 10 Sekunden | Bis zu 5,4 Sekunden bei 30fps | Bis zu 5 Sekunden (720p) |
| Bildrate | 16fps | 30fps | 24fps |
| Min. VRAM | 8 GB (1,3B-Modell) | 20 GB+ bei voller Präzision | 14 GB (v1.5) / 60–80 GB (Original) |
| Generierungsgeschwindigkeit | 1–2 Min. für einen 4–5 Sek. Clip (8-GB-GPU) | 3–4 Min. für einen 5,4 Sek. Clip | 6–10 Min. für einen 5 Sek. Clip (16-GB-GPU) |
| Text-to-Video | ✅ | ✅ | ✅ |
| Image-to-Video | ✅ | ❌ | ✅ |
| LoRA-Feintuning | ✅ | ✅ | ✅ (hoher Rechenaufwand erforderlich) |
| ComfyUI-Unterstützung | ✅ | ✅ | ✅ |
| Diffusers-Unterstützung | ✅ | ❌ | ✅ |
| Bilinguale Prompts | ✅ Englisch + Chinesisch | ❌ | ❌ |
| Lizenz | Apache 2.0 | Apache 2.0 | Tencent Community License |
| Consumer-GPU-freundlich | ✅ Klassenbester | ❌ | ⚠️ nur v1.5 |
| Am besten geeignet für | Vielseitigkeit + Zugänglichkeit | Fotorealismus + Feintuning | Kinoqualität + Gesichter |
- Wan 2.6
Wan 2.6 ist die im Dezember 2025 veröffentlichte Videogenerierungs-Modellreihe von Alibaba. Sie unterstützt Text-to-Video-, Image-to-Video- und Reference-to-Video-Generierung. Zu ihren Hauptstärken gehören Multi-Shot-Storytelling, verbessertes Prompt-Following und Audio, das mit den visuellen Inhalten synchron bleibt. Das Reference-to-Video-Modell kann auch einen Referenzclip verwenden, um das Aussehen und die Stimme einer Person oder eines Objekts in neu generierten Szenen beizubehalten.
Wan 2.6 bleibt eine Option für Kreative, die mit KI-generierten Szenen, Produktvideos oder dialoggesteuerten Clips experimentieren möchten.
Funktionen
- MoE-Architektur: spezialisierte Experten für verschiedene Rauschstufen.
- Hybrides T2V/I2V: Text- und Bildeingabe in einem einheitlichen Modell.
- GGUF-Quantisierung: läuft auf Consumer-GPUs mit 4 GB VRAM.
- Kinematische Steuerung: Labels für Beleuchtung, Kontrast und Farbton.
- Zweisprachige Unterstützung: Verarbeitung von englischen und chinesischen Prompts.
- Gehosteter Zugriff: Nutzen Sie unterstützte Wan-Modelle über das Alibaba Cloud Model Studio
Vorteile
- Unterstützt mehrere Workflows zur Videogenerierung innerhalb einer Modellfamilie.
- Multi-Shot-Steuerungen eignen sich für Kurzgeschichten, Werbung und Produktpräsentationen.
- Reference-to-Video kann helfen, die Charakteridentität über generierte Szenen hinweg beizubehalten.
- Bietet synchronisierte Audio- und Dialogfunktionen in unterstützten Varianten.
Nachteile
- Clips sind kurz, sodass längere Projekte möglicherweise mehrere Generierungen und Bearbeitung erfordern.
- Gehosteter Zugriff kann API-Gebühren oder dienstspezifische Einschränkungen beinhalten.
- Mochi (Genmo)
Mochi 1 ist ein Modell mit 10 Milliarden Parametern, das auf einer neuartigen AsymmDiT-Architektur basiert und unter Apache 2.0 veröffentlicht wurde. In meinen Tests war es am stärksten bei fotorealistischen Bewegungen mit 30 fps, wodurch es sich hervorragend für Aufnahmen im Dokumentarstil, natürliche Umgebungen und menschliche Bewegungen eignet, die real wirken müssen. Es war eines der ersten Open-Source-Modelle, das mich dazu gebracht hat, die lokale Videogenerierung ernst zu nehmen.
Funktionen
- AsymmDiT-Backbone: speziell entwickelte Architektur für die Videosynthese.
- 30-fps-Ausgabe: flüssige Bewegung bei nativer Bildrate.
- LoRA-Feintuning: Anpassung an eigene Videodatensätze.
- Apache-2.0-Lizenz: offen für Forschung und kommerzielle Nutzung.
- ComfyUI-Integration: Unterstützung für knotenbasierte Workflows.
- T5-XXL-Codierung: starkes Textverständnis und präzise Prompt-Befolgung.
Vorteile
- Die freizügigste Lizenzierung aller qualitativ hochwertigen Open-Source-Modelle.
- Hervorragende fotorealistische Bewegung und natürliche Bewegung.
- Starke Community mit aktivem Teilen von Fine-Tunes.
Nachteile
- Begrenzt auf 480p-Auflösung; erfordert Upscaling für HD-Ausgabe.
- Benötigt 20 GB+ VRAM bei voller Präzision.
- HunyuanVideo (Tencent)
HunyuanVideo ist das Flaggschiff-Open-Source-Videomodell von Tencent, das für eine qualitativ hochwertige Generierung mit starker Bewegungskonsistenz und einer saubereren Szenenstruktur als die meisten anderen von mir getesteten Open-Source-Alternativen entwickelt wurde. Seine Transformer-basierte Architektur verarbeitet visuelle und zeitliche Daten zusammen, und ich habe mich immer dann darauf verlassen, wenn ich mehr Kontrolle über den Generierungsprozess haben wollte, als mir ein gehostetes Tool bieten würde.
Funktionen
- Größter Maßstab von 1B in der Open-Source-Kategorie.
- Dual-Stream-Fusion: getrennte Text- und Videoverarbeitung vor dem Zusammenführen.
- xDiT-Parallelität: Multi-GPU-Sequenzparallelität für schnellere Inferenz.
- FP8-Quantisierung: reduzierter Speicherbedarf ohne nennenswerten Qualitätsverlust.
- Diffusers + comfyUI: Plug-and-Play-Ökosystem-Integration.
- Kausales 3D-VAE: räumlich-zeitliche Kompression für kohärente Bewegung.
Vorteile
- Beste filmische Qualität und Gesichtsrealismus im Open-Source-Bereich.
- Riesiges LoRA-Ökosystem für Stil- und Charakteranpassung.
- Starke Handhabung von mehreren Personen und komplexen Szenen.
Nachteile
- Ein 5-Sekunden-Clip kann je nach Einstellungen über 15 Minuten dauern.
- Hohe Einrichtungskomplexität; nicht für Anfänger geeignet.
Entdecken Sie die besten KI-Videomodelle auf Framia Pro
Hier ist das eigentliche Problem, auf das ich gestoßen bin: Ich wollte kein Google-Konto für Veo, kein Runway-Abonnement für Gen-4.5 und kein Kuaishou-Login für Kling, und diese Einrichtung dann jedes Mal wiederholen, wenn ein neues Modell auf den Markt kam. Das ist der Grund, warum ich den Großteil dieser Tests auf Framia Pro verlagert habe.
Framia Pro bringt Veo 3.1, Kling 3.0, Seedance 2.5 und andere Top-Video- und Bildmodelle in einem Arbeitsbereich zusammen. Ich konnte mit einer Idee beginnen und sie mithilfe von Text, Bildern, Audio oder einer Mischung aus allen dreien in ein Video verwandeln, ohne Tabs zu wechseln oder für jedes Modell ein separates Konto zu bezahlen. Integrierte kreative Agenten decken auch spezifische Anwendungsfälle ab, wie zum Beispiel Musikvideos, Werbung und Storytelling, sodass ich immer einen Ausgangspunkt hatte, egal was ich gerade erstellte.
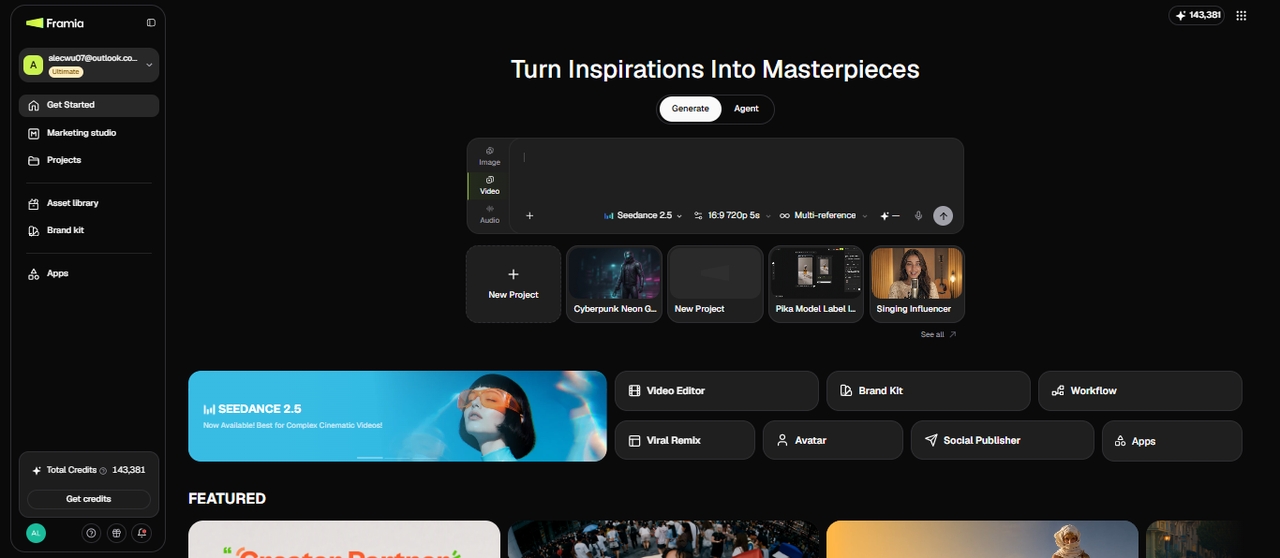
Was bietet Framia Pro?
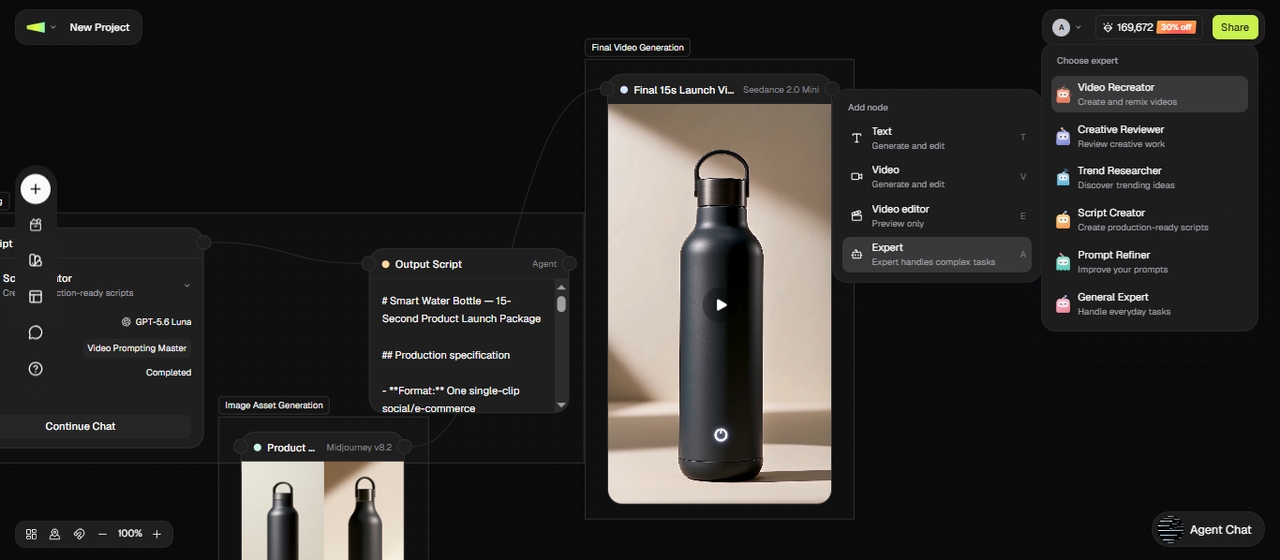
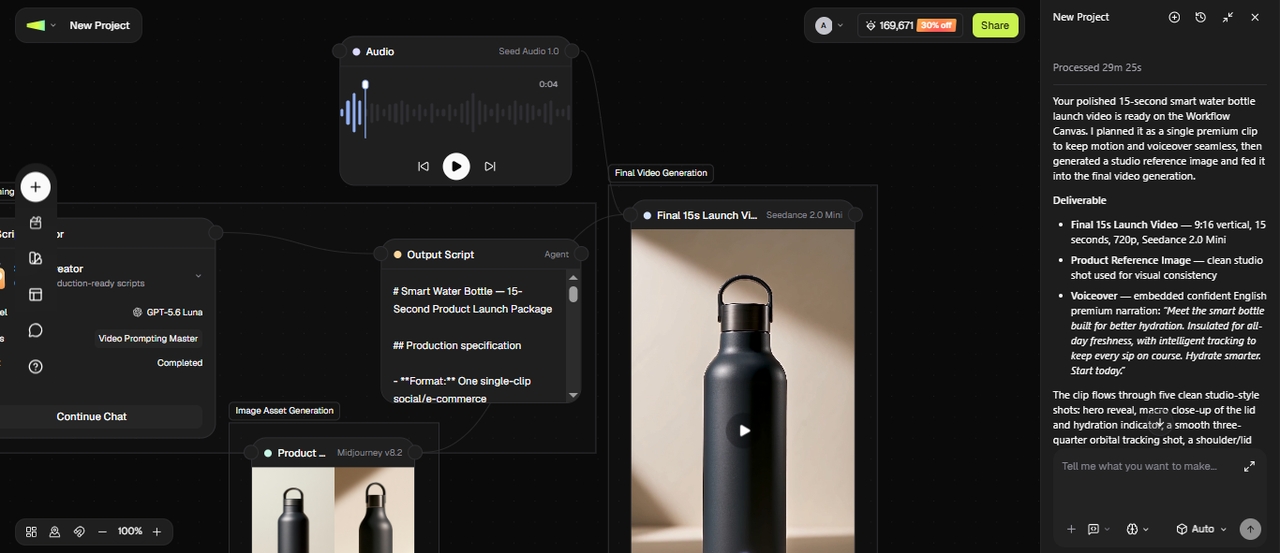
Ich habe versucht, ein E-Commerce-Produkteinführungsvideo auf dem Canvas zu erstellen. Ich begann mit einem Image-Agenten, um saubere Produktaufnahmen zu generieren, leitete diese in einen Video-Node weiter, der sie mit Kling oder Seedance in einen Demo-Clip verwandelte, und leitete das Ergebnis dann durch einen Audio-Node für ein passendes Voiceover – alles auf einem einzigen Canvas anstelle von vier separaten Tools.
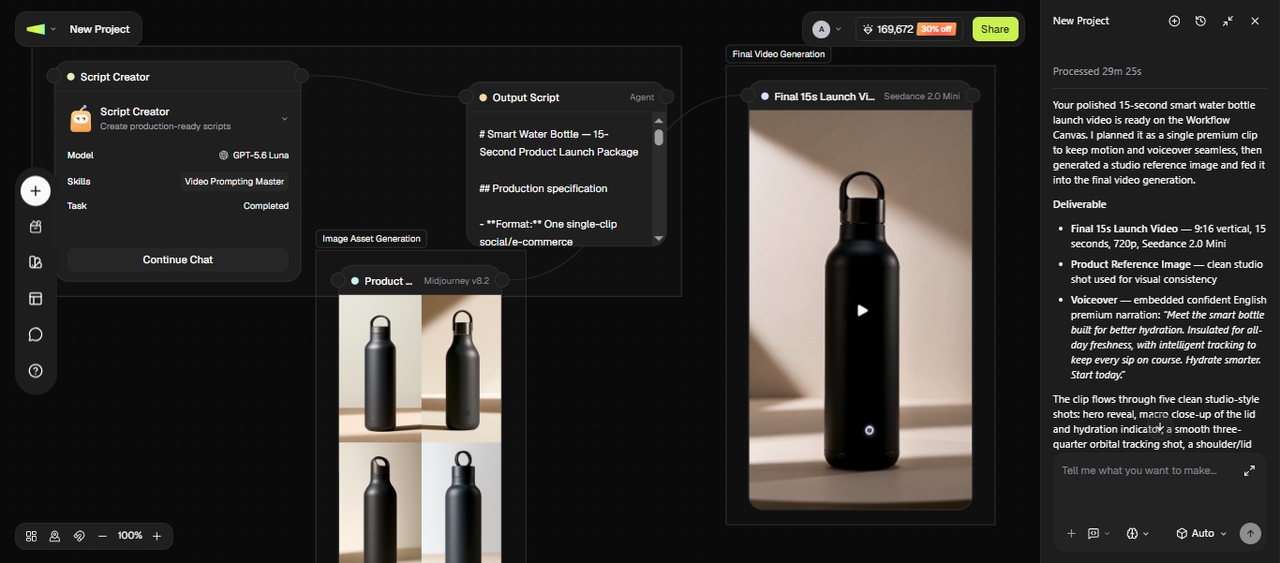
Hier sind die Funktionen, die mir auf dem Weg geholfen haben:
- Spezielle Image-, Audio- und Video-Agenten: Ich habe den Video-Agenten verwendet, um Prompts, Skripte oder Bilder in vollständige Clips über die oben genannten Modelle hinweg zu verwandeln, und die Image- und Audio-Agenten für Thumbnails, Voiceovers und Musik, wann immer ich diese separat benötigte.
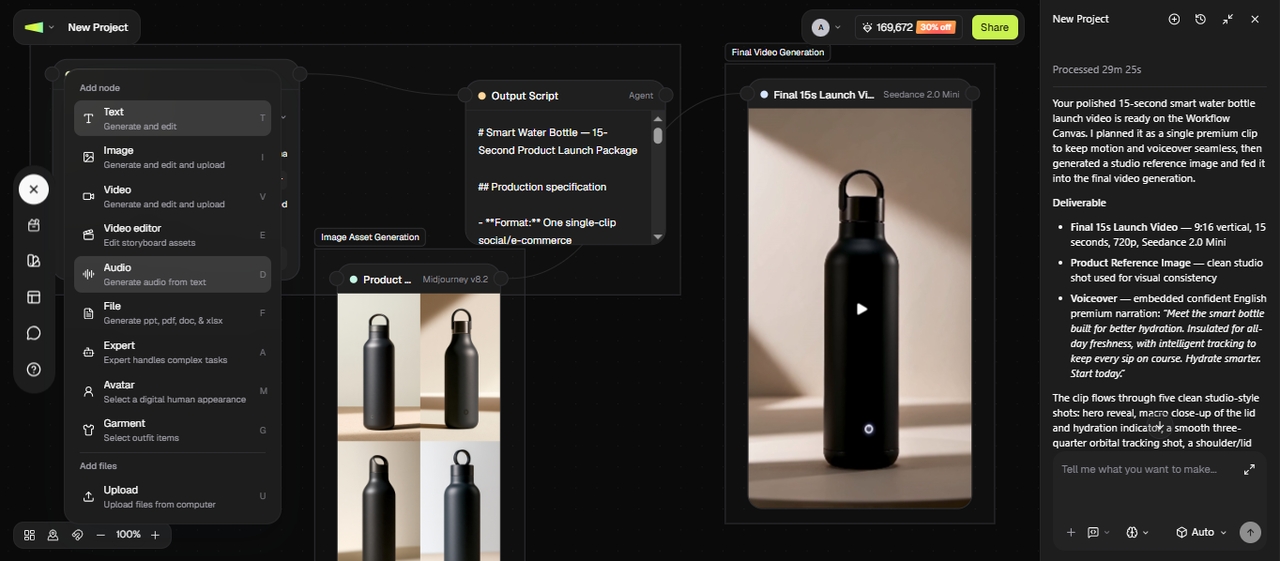
- Den Prompt ändern und neu generieren: Ich habe die gewünschte Änderung in einfachem Text beschrieben, und Framia Pro hat sie angewendet, ohne dass eine Timeline oder manuelle Bearbeitungswerkzeuge erforderlich waren. Ich habe Szenen angepasst, Teile geschnitten und visuelle Elemente verfeinert, ohne jegliche vorherige Bearbeitungserfahrung.
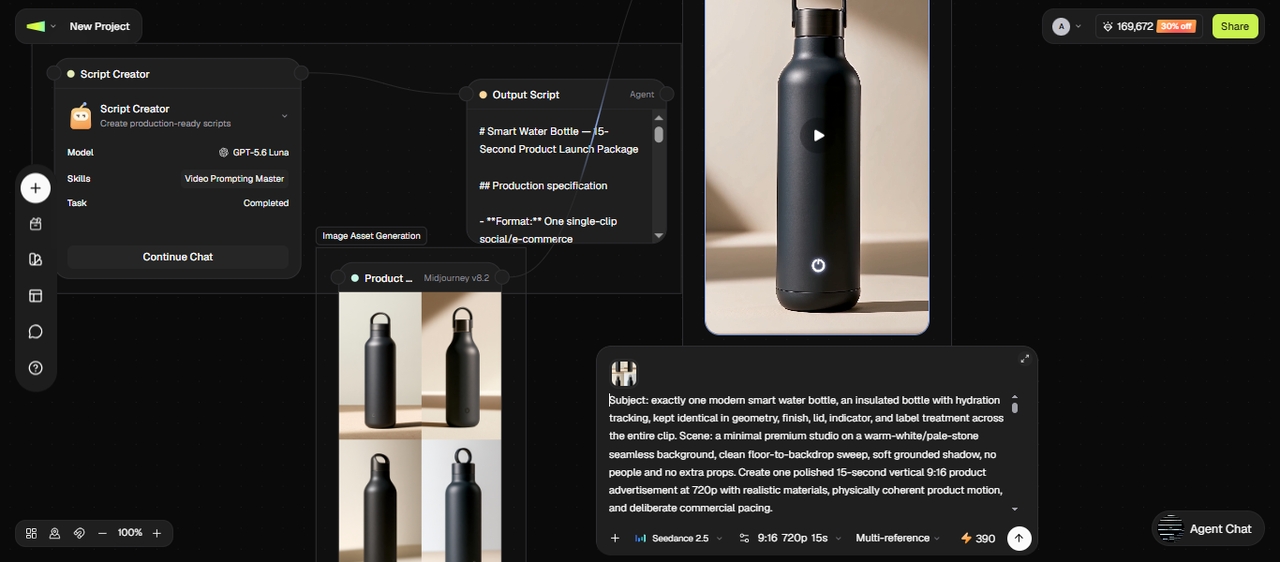
- Skills für Skripte, Review und Wiederverwendung: Ich habe eine grobe Idee in ein strukturiertes Skript verwandelt, ein fertiges Video einer Pacing- und Retention-Prüfung unterzogen und ein langes Video in mehrere kürzere, plattformfertige Clips geschnitten.
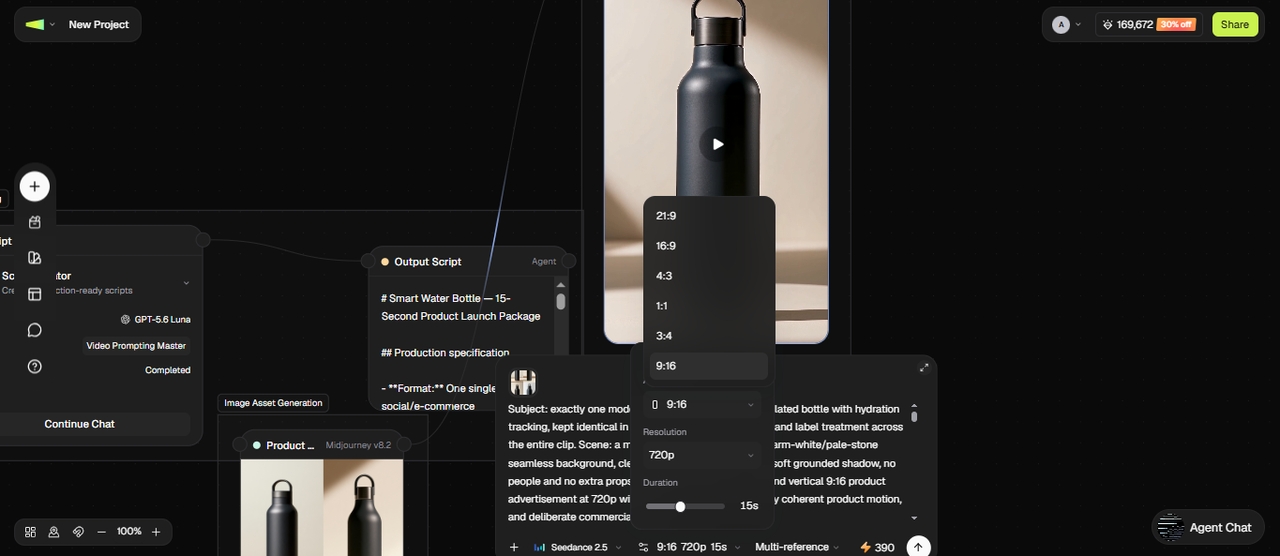
- Mehrere Längen und Seitenverhältnisse: Ich habe Clips in verschiedenen Längen für unterschiedliche Projekte erstellt, im Hochformat, quadratisch oder im Breitbildformat, sodass meine TikTok-, Instagram- und YouTube-Versionen ohne zusätzliches Anpassen der Größe bereit waren.
- Audio mit Ihren Clips synchronisieren: Framia Pro synchronisiert Ton mit Bild, sodass Dialoge, Musik oder Effekte auf das Timing des Videos abgestimmt sind. Es passt die Lippenbewegung an die Sprache an und richtet das Audio an Szenenwechseln aus, was manuelle Audioanpassungen bei der Bearbeitung reduziert.
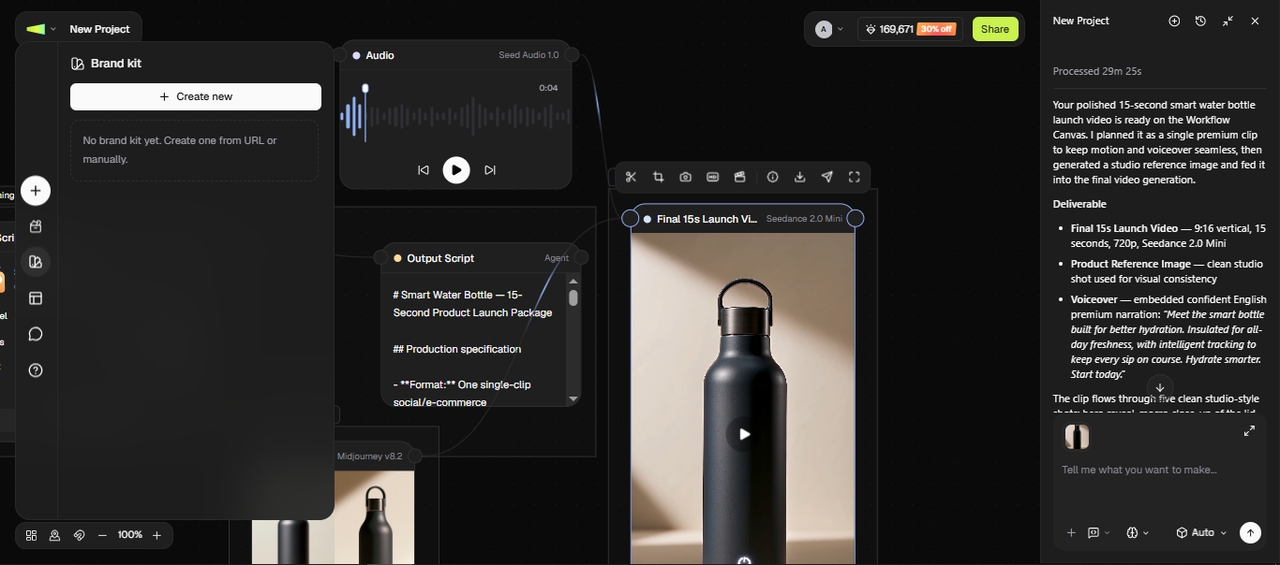
- Brand Kit: Ich habe meine Farben, Schriftarten und mein Logo einmal gespeichert und sie dann auf jedes Video angewendet, das ich mit einem beliebigen Modell im Workspace generiert habe.
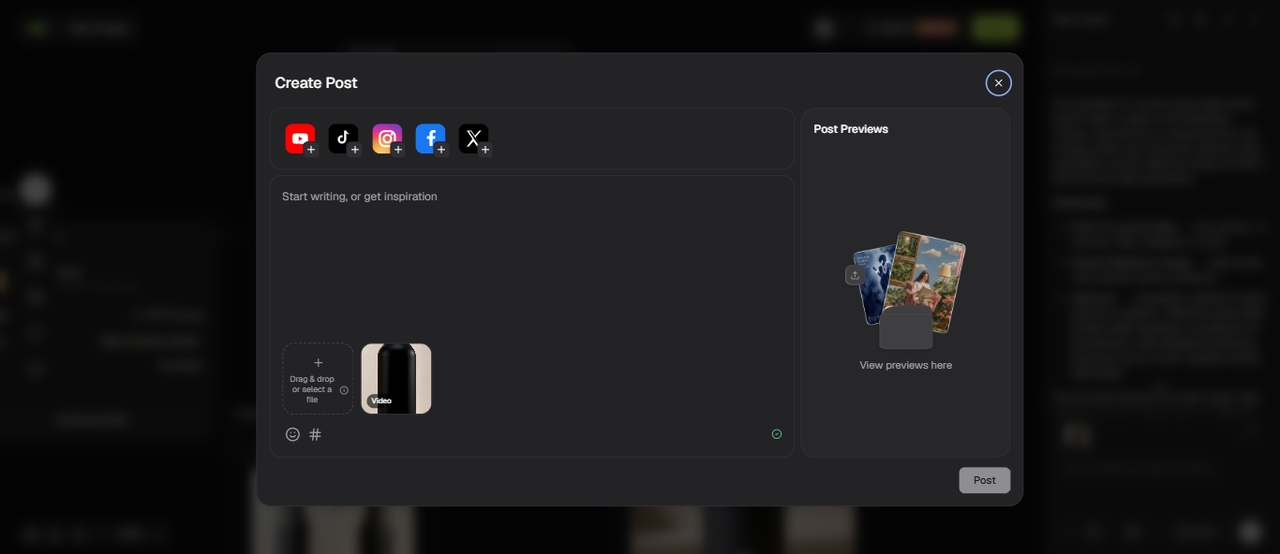
- Direkter Export aus dem Publisher: Ich habe ein fertiges Video direkt aus Framia Pro an TikTok gesendet, ohne separaten Download- und Upload-Schritt.
Fazit
In diesem Artikel haben wir untersucht, was KI-Videogenerierungsmodelle sind, und 5 Closed-Source- sowie 3 Open-Source-Tools vorgestellt, die Sie für Ihr Projekt verwenden können. Konzentrieren Sie sich auf Ihr Ziel, bevor Sie ein Modell auswählen. Einige Tools eignen sich für schnelle Social-Media-Clips, während andere besser für Storytelling oder qualitativ hochwertige Szenen mit Ton und Details funktionieren. Wenn Sie das Modell auf die Aufgabe abstimmen, sind Ihre Ergebnisse präziser und einfacher zu verwalten. Wenn Sie Zugriff auf mehrere führende KI-Videomodelle an einem Ort haben möchten, erkunden Sie Framia Pro und wechseln Sie je nach den Anforderungen Ihres Projekts zwischen den Tools.
Häufig gestellte Fragen
Welches sind die besten KI-Modelle zur Videogenerierung im Moment?
Einige der führenden KI-Modelle zur Videogenerierung sind Veo, Runway, Seedance 2.5, Kling und MiniMax H3. Jedes Modell hat andere Stärken, wie Realismus, Bewegung, Audio oder Benutzerfreundlichkeit. Auf Framia Pro können Sie auf mehrere dieser Modelle zugreifen und je nach Projekt wechseln.
Was passiert mit dem Videomodell von Sora?
Die Sora-Videomodell-News haben enthüllt, dass es vor Kurzem im Jahr 2026 als Verbraucher-App und API eingestellt wurde. OpenAI hat beschlossen, es einzustellen, um sich auf andere Bereiche wie Robotik und fortgeschrittene Forschung zu konzentrieren.
Gibt es Open-Source-KI-Videogeneratoren?
Ja, Open-Source-KI-Videogeneratoren wie Wan, Mochi und HunyuanVideo sind verfügbar. Sie können sie lokal ausführen und an Ihre Bedürfnisse anpassen, obwohl die Einrichtung technisches Wissen erfordert. Framia Pro bietet eine einfachere Option, wenn Sie gebrauchsfertige Modelle ohne lokale Einrichtung bevorzugen.
Können KI-Videomodelle lange Videos erstellen?
Die meisten KI-Videomodelle konzentrieren sich immer noch auf kurze Clips anstelle von Videos in voller Länge. Einige Tools ermöglichen längere Szenen, erfordern jedoch oft das Kombinieren mehrerer Clips. Framia Pro unterstützt verschiedene Längen, sodass Sie Clips ganz nach Ihren Bedürfnissen erstellen und verwalten können.
Welches KI-Videomodell sollten Sie verwenden?
Sie sollten ein Modell basierend auf Ihrem Ziel und Inhaltsstil auswählen. Veo eignet sich gut für realistische Szenen, Kling bewältigt Bewegungen und Seedance bietet mehr Kontrolle mit mehreren Eingaben. Der Video-Agent von Framia Pro ermöglicht es Ihnen, diese Modelle an einem Ort zu testen und das auszuwählen, was zu Ihrem Arbeitsablauf passt.
Kostet die Nutzung von KI-Videogenerierungsmodellen Geld?
Die meisten tun das, obwohl die Preise stark variieren. Einige berechnen pro Clip, während andere mit monatlichen Abonnements mit Kreditlimits arbeiten. Open-Source-Modelle wie Wan oder Mochi können kostenlos ausgeführt werden, aber Sie benötigen Ihre eigene GPU-Hardware.
Kann ich KI-generierte Videos für kommerzielle Projekte verwenden?
Das hängt von der Lizenz des Modells und Ihrer Abonnementstufe ab. Apache 2.0-Modelle wie Wan 2.2, Mochi und HunyuanVideo erlauben die kommerzielle Nutzung. Überprüfen Sie bei Closed-Source-Tools wie Veo, Runway oder Kling die kommerziellen Nutzungsbedingungen des jeweiligen Tarifs, bevor Sie generierte Videos in kostenpflichtigen oder markengebundenen Arbeiten veröffentlichen.
Welche KI-Videomodelle unterstützen natives Audio?
Mehrere aktuelle Modelle generieren Audio im selben Durchgang wie das Video, anstatt es nachträglich hinzuzufügen. Veo 3.1, Kling 3.0, Seedance 2.5 und MiniMax H3 unterstützen alle natives Audio, einschließlich Dialogen, Soundeffekten und Umgebungsgeräuschen, die an das Geschehen auf dem Bildschirm gekoppelt sind.